 阅读时间大约10分钟(3646字)
10小时前 Isaac Sim/Lab、MuJoCo、Genesis、mjlab:机器人仿真走到哪一步了?
来源:豆包
作者:Yuanxq 出品:具身智能研究室机器人仿真把试错搬进仿真环境,用于训练policy、生成数据和验证系统。GPU并行、视...
作者:Yuanxq 出品:具身智能研究室
机器人仿真把试错搬进仿真环境,用于训练 policy、生成数据和验证系统。GPU 并行、视觉与软体仿真扩展了它的用途,最终效果仍要在真机上检验。
理解 Isaac Sim/Lab、MuJoCo、Genesis等工具,先分清三个层次:
物理引擎计算运动与接触,仿真平台组织场景与传感器,学习框架连接任务与算法。
以抓取为例,物体会不会滑落、相机能看到什么、policy 怎样学习,分别涉及这三层工作。
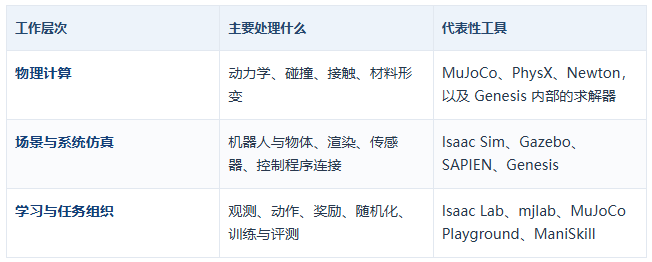
同一个项目可以覆盖多个层次,表格展示的是主要职责。PhysX 这样的底层引擎,也可以出现在不同平台的背后。
Isaac Sim 和 Isaac Lab,恰好能把这层关系讲清楚。
Isaac Sim 是机器人仿真平台,提供场景构建、物理、渲染、传感器和机器人软件连接等能力。只检查相机、控制程序或场景交互,也可以使用它,无须先训练一个 policy。
Isaac Lab 则围绕机器人学习组织环境和工作流。在广泛使用的 2.x 路线中,它使用 Isaac Sim 的仿真能力,再把观测、奖励、动作和环境重置接入训练。两者经常一起使用,分别解决“世界怎样运行”和“机器人怎样在其中学习”的问题。
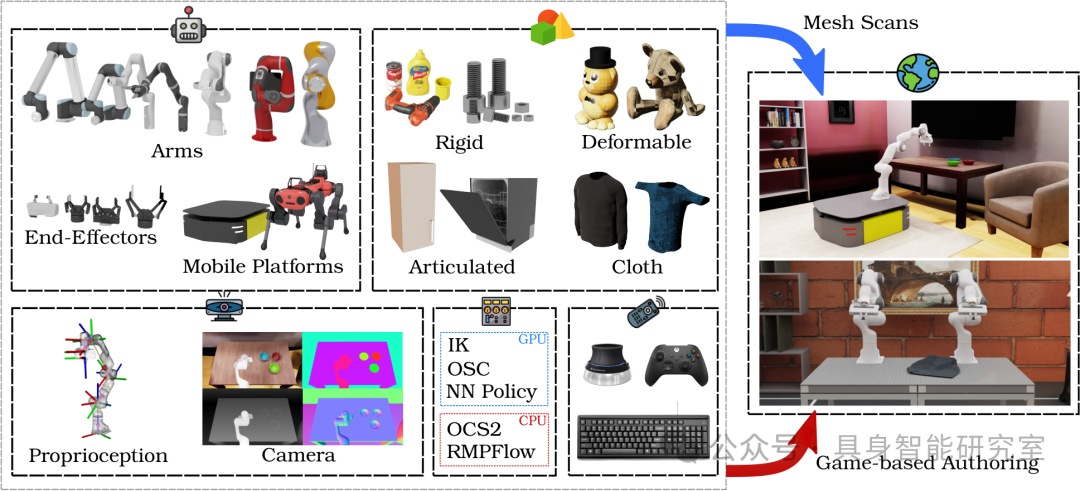
图 1|机器人、物体、相机、控制与场景构建如何进入学习工作流。
不同项目会把重点放在不同地方。比如 Gazebo 通过插件组织物理、传感器和系统功能,并可与 ROS 2 交换数据。机器人团队可以在仿真中联调模型、传感器和控制软件。这类系统验证,与大规模 policy 训练一样,都是仿真的实际用途。
这几年,一个明显的变化是:仿真需要跟上学习算法的试错量。
检查一个控制器时,运行少量环境就可能足够。训练 policy 时,则需要反复尝试动作,根据结果更新 policy。大量虚拟机器人可以同时练习,加快经验收集。
并行环境增加的是采样量,经验覆盖还取决于任务分布和随机化设置。
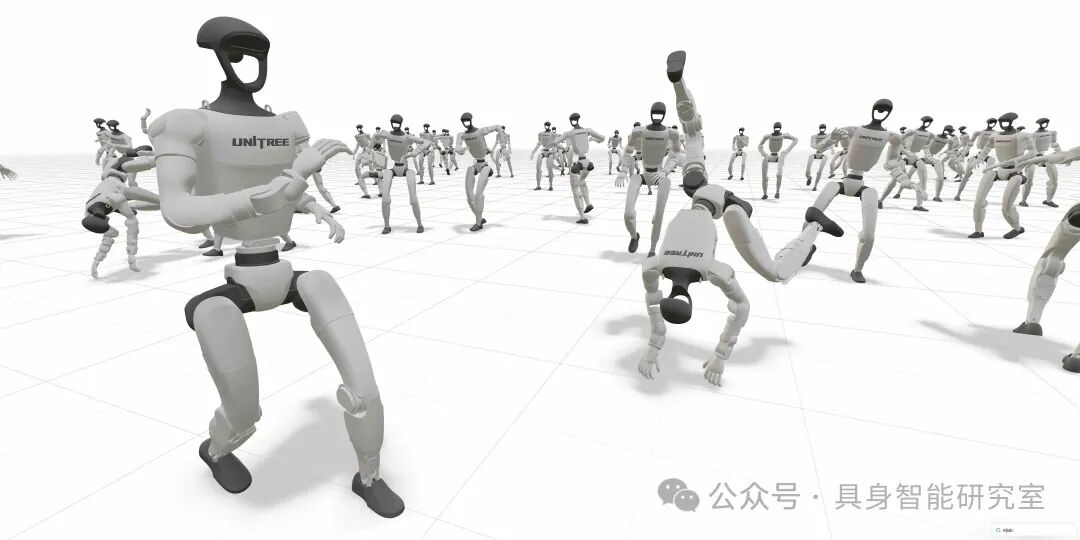
图 2|大量虚拟机器人同时进行动作跟踪,呈现出不同的动作姿态。
MuJoCo 生态中的 MJX、MuJoCo Warp,就是面向加速计算与并行仿真的路线。MuJoCo 本身的模型检查与调试方式也仍然有价值:执行器输出、碰撞几何和接触状态,都能帮助研究者分析一次失败。
训练规模扩大以后,代码组织同样会成为问题。一台机器人走平地、爬坡和模仿动作,可能共享许多观测与控制逻辑;每个任务都复制一套代码,会增加修改和维护的成本。
Isaac Lab、mjlab 等学习框架把这些部分做成可组合的组件。mjlab 使用 MuJoCo Warp,提供面向 PyTorch 的训练接口;MuJoCo Playground 则提供一组可以开展学习实验的环境。选择哪一套,还要看团队已有代码、需要复现的研究和调试习惯。
说一套仿真工具“快”,还要分清快在哪里。大量环境每秒合计推进多少步,衡量的是总吞吐量;一个环境完成一步需要多久,衡量的是单步延迟。并行环境的总吞吐量提高,并不代表每个环境的单步延迟都更低。
训练还涉及相机渲染、policy 推理、参数更新和环境重置。只比较物理步进速度,无法直接推算完整训练要花多久。
对项目更有意义的问题是:在同样的任务要求下,多久能得到一个通过真机测试的 policy?
物理后端与训练框架之间,也出现了更多组合方式。
Newton 提供统一的模型、状态与求解器接口,包含通过 MuJoCo Warp 运行的求解器,以及面向其他物理对象的求解路线。它让不同物理需求能够在共同的框架下组织。
Isaac Lab 3.0 Early Access 则进一步拆分物理、渲染和可视化,支持 PhysX、Newton/MuJoCo-Warp 等路线,部分工作流可以不安装或启动完整 Isaac Sim。这一版本仍在早期访问阶段,采用新架构需要验证具体任务的兼容性。
团队因此可以按任务组合所需功能。
更换物理后端之后,接触、执行器和数值设置仍要重新检查。
接口能够复用,原有实验结果还需要验证。
操作学习又把场景、物体与视觉数据推到了更重要的位置。
让机械臂抓起桌上的杯子,除了学会怎么运动,还要识别杯子在哪里、杯口朝哪边、会不会被其他物体挡住。换一个杯子,形状、材质、质量和抓取位置都可能改变。
因此,仿真需要提供足够丰富的对象与场景。基于 SAPIEN 的 ManiSkill就围绕操作学习组织任务、数据采集和 baseline,支持 GPU 并行仿真与视觉数据采集;不同并行环境还可以放入不同场景和物体。
Isaac Sim/Lab 也在这一方向上提供场景、传感器、遥操作和示范数据生成能力。对于研究者,仿真既是 policy 练习动作的地方,也可以是生成带有状态或标注的数据、反复评测同一组条件的工具。
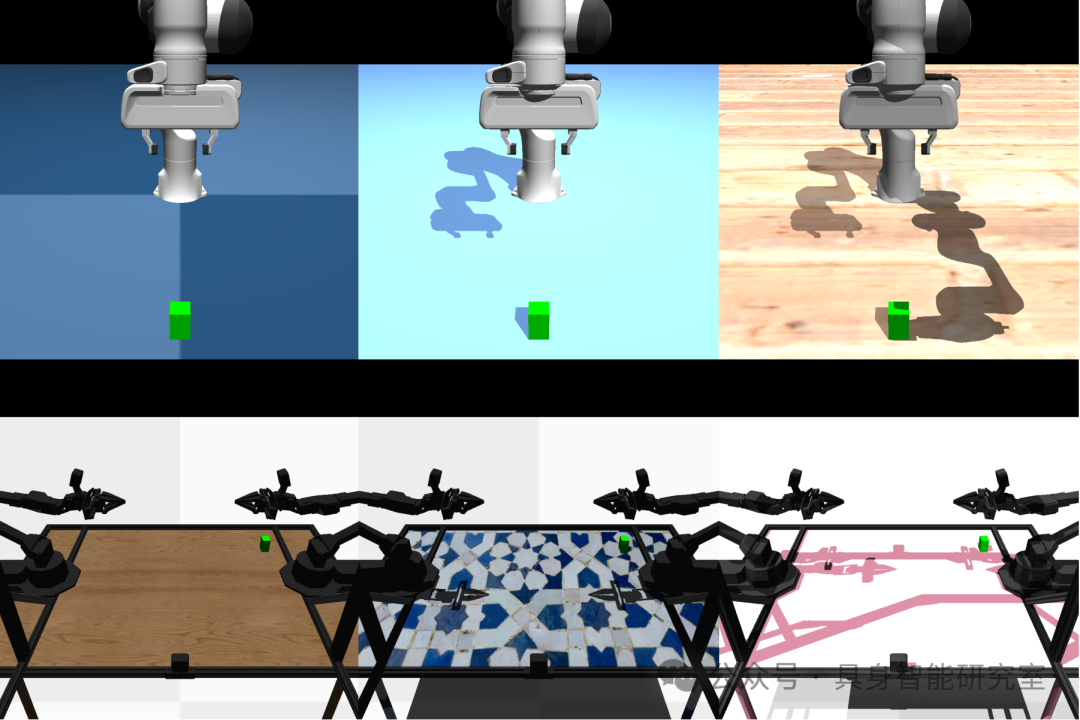
图 3|不同的光照、阴影、纹理与颜色,可以成为视觉 policy 的训练条件。
对视觉任务,图像差异会直接影响 policy 输入;对主要读取关节状态的行走任务,电机响应和接触误差往往更直接。平台的渲染效果、物理能力和训练效率,需要放回具体任务里衡量。
机器人要接触的对象,也越来越多地包含柔性材料。
拿起刚性方块,与抓住会被挤扁的海绵,需要处理不同的接触过程。这里有两个容易混淆的概念:
软接触描述接触处的力与变形关系,软体模型还要描述物体自身怎样变形。
软接触模型可以允许接触面之间存在一定的压入,再根据压入和相对运动计算接触力;物体本身仍然可以按刚体处理。抓住海绵时,还需要计算它受到挤压后形状怎样变化。整理线缆要面对弯曲和缠绕,铺平布料要面对折叠与自接触,这些都需要能表达相应形变的模型。
MuJoCo 在 3.0 引入的 flex 可以用一维、二维和三维单元描述可变形对象,flexcomp 帮助生成模型;弹性 cable 则用于表现不可伸长线缆的弯曲与扭转。绳、布料和体积软体,都已进入它的建模范围。
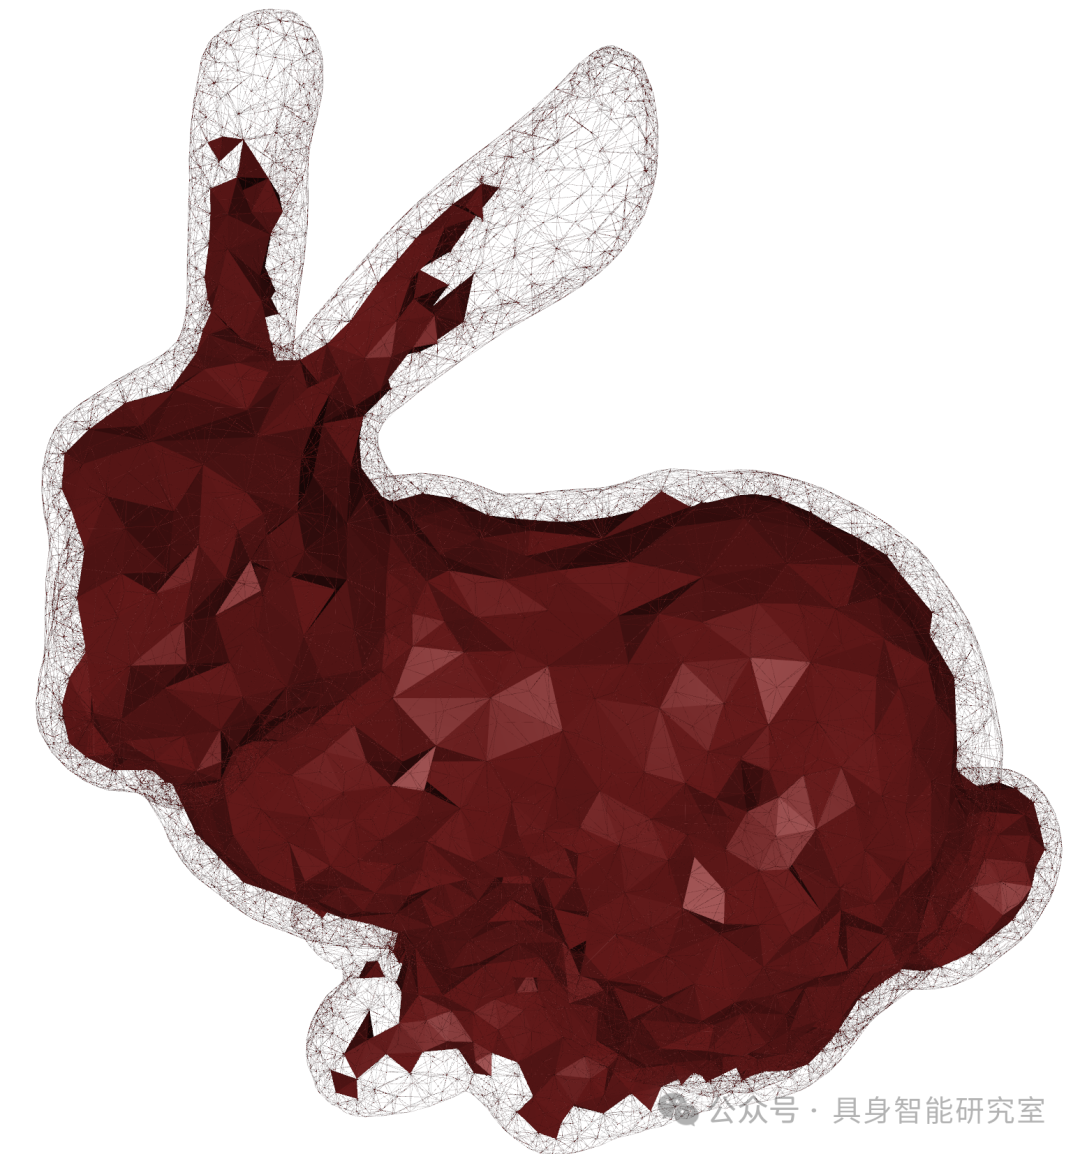
图 4|MuJoCo 的可变形对象网格,展示了内部的四面体结构。
Genesis 则将刚体、有限元、物质点法和粒子等求解路线组织到同一平台。Genesis World 的官方示例包括软体抓取、布料和流体交互,也提供使用 FEM、MPM 驱动软体机器人的方法。
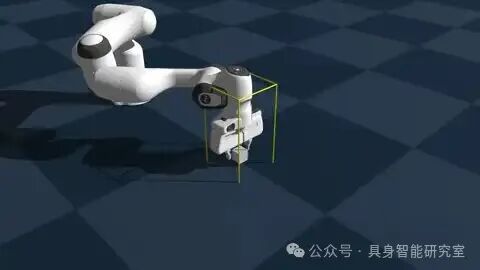
图 5|机械臂抓取可变形方块,方块随接触发生形变。
这些软体能力已经能用于搭建任务、检查交互和测试控制方法。
做具体项目时,需要进一步确认材料模型、求解精度与计算成本是否适合目标对象。
尤其要分清后端:原生 MuJoCo 的能力,不能直接等同于每种 GPU 实现都完整支持。当前 MJX-JAX 的功能表仍将 flex 列为不支持,MuJoCo Warp 的 flex 支持也还在完善。
软体任务因此会把材料测量带进机器人研发。布料的弯曲刚度、线缆的扭转特性、软物体与夹爪之间的摩擦,都可能影响动作。模型需要保留哪些细节,应由任务来决定。
sim2real 的进展,要看机器人在什么条件下完成了什么任务。
判断一次从仿真到真机的迁移,可以沿着三个问题往下看:
物理过程能否对得上,真机能否完成任务,换个条件后能否继续稳定完成。
落脚会不会滑、夹爪能否夹稳,反映模型能否捕捉关键交互;任务成功率和误差,反映 policy 能否实际工作;换物体、换地面和连续运行的测试,则决定这些能力能用到多大范围。
真机部署已经有可以参照的开源流程。宇树同时提供基于 Isaac Lab、mjlab 的训练项目,包含仿真检查和实际部署步骤;Genesis-Humanoid 也提供人形训练与部署流程,关联项目 ExtremControl 展示了全身遥操作。
更具体的表现,可以看 MuJoCo Playground 的公开实验。作者在四足、人形、机械臂与灵巧手上部署 policy,展示了行走和物块操作等任务。
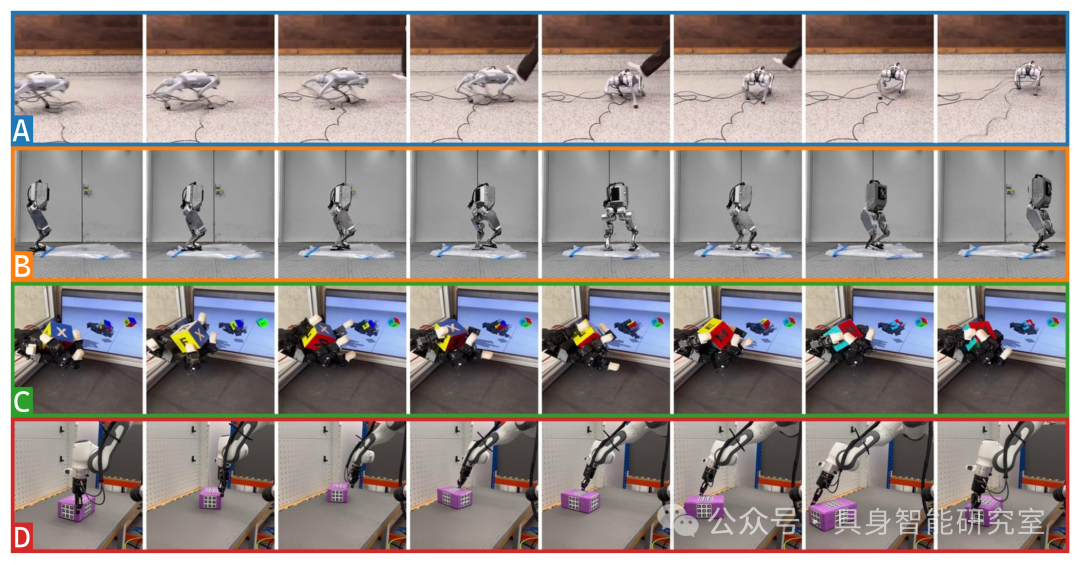
图 6|从上到下:Go1 行走中受扰恢复、Berkeley Humanoid 在滑面上转向、灵巧手转动物块、Franka 推动物块。
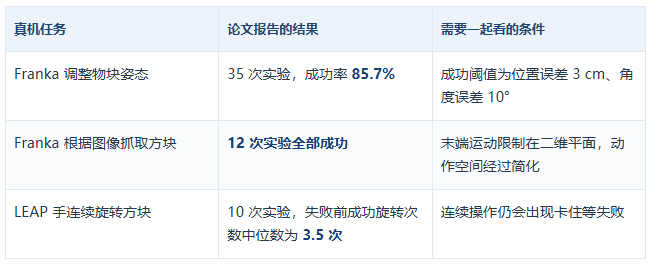
12 次抓取全成功,说明方案在这组实验条件下能够工作。要判断它能否处理陌生物体和杂乱桌面,需要增加相应测试。物块姿态调整的结果,也需要连同厘米级的位置容差一起理解;精密插接还要接受更严格的误差检验。
行走和特定动作跟踪已有可复用的工程路线,抓取、灵巧操作与装配也有具体成果。
从这里继续往前,需要看同一套 policy 换环境后怎样表现,能连续工作多久,失败后能否恢复。
当通用模型已经能控制机械臂,仿真还承担什么?
2025 年,何泰然在 WhynotTV 对谈 Meshy CEO 胡渊鸣时,引出了 Sergey Levine 在《Sporks of AGI》中的质疑:更强的模型也可能更充分地学到仿真的偏差。胡渊鸣认同这一担忧,更看好 data-driven 的仿真:让难以手工建模的材料与接触过程从真实数据中学习。
到了 2026 年 9 月,GPT-6 Astra 已经能根据相机画面与机器人状态,调用动作接口控制真机。Robocurve 的测试中,放块入碗成功 19/20 次,拼块入槽成功 2/20 次。通用模型可以直接接入机器人执行任务,底层控制器负责将目标位姿转成关节运动。仅凭这组结果,还无法定位精密操作的主要瓶颈。
仿真本身也在变得更 data-driven。PhysTwin 从少视角 RGB-D 交互视频中重建可变形对象,保留弹簧—质量模型,并通过真实运动优化物理参数。
真实数据参与建模,模型再用于预测新的交互。
随着 data-driven 模型的能力增强,仿真需要承担的工作也会变化。
已有模型能完成的任务,可以直接测试部署;仍然欠缺的能力,则需要定位问题,再比较仿真训练、真机数据和控制方法的投入与收益。
sim2real gap 通常来自几种误差的叠加。
物理上,质量、重心、摩擦和电机输出可能与模型不同;感知上,相机位置、遮挡和噪声会改变观测。任务本身一旦变化,policy 还需要应对新的物体和初始条件。
policy 的观测与动作接口必须对齐真机。
部署时使用的观测需要能在真机上获得;目标位置、位置增量和力矩对应不同的控制方式,关节顺序、坐标系、动作缩放和控制频率也要一致,延迟则需要纳入建模与测试。
开发者通常先测量硬件、校准模型,再在训练中让质量、摩擦、延迟等参数在合理范围内变化。后一步就是域随机化,用来帮助 policy 适应差异。变化范围需要有依据;如果任务的关键是布料形变,只调整刚体的质量和摩擦,也补不上缺失的形变过程。
论文里的“零样本迁移”,通常指 policy 没有在目标真机上继续学习或微调。开发团队仍可能做过硬件测量和模型校准。
一次训练用了几分钟,与整个项目用了多长时间,是两笔不同的账。
仿真评测也需要真实数据来校验:如果一个测试场景无法预测真机中的失败,再高的仿真分数,也不能单独说明部署质量。
准备选型时,可以先从手头的任务出发。做移动机器人系统联调,关注场景、传感器和 ROS 接口;做大规模运动控制学习,关注并行物理、执行器建模和现成部署项目;做视觉操作,关注对象多样性、渲染与数据采集;做软体交互,则把材料模型和求解器支持放在前面。
选择工具时还可以问四个具体问题:第一个任务多久能跑通,失败能否定位,换一台设备需要改什么,模型和部署代码有没有人持续维护。搭建与排错的时间,也应计入平台的使用成本。
经过校准的模型、可复现的训练与部署配置、来自真机失败的测试案例,是团队之间值得共享的成果。
比如,硬件团队测出执行器的实际响应,算法团队就能据此校准模型;把真机失败复现成固定测试,也能检查后续更新是否解决了问题。
这些成果让合作有了具体的起点。接手项目的人能够沿用哪些模型、复现哪些结果、少花多少排错时间,同样是衡量仿真进展的一部分。
推荐阅读

×
右键可直接复制图片