 阅读时间大约5分钟(1601字)
11小时前 VLA 如何把图像和指令变成动作?三张图讲清楚 VLA 数据流
来源:豆包
出品:机器人技术笔记聊聊VLA的数据流,也就是一张相机图像、一句操作指令,怎样一步步变成机械臂的动作。桌上有一块红积木和一个盒子,让机器人把积木放进去,它收到的...
出品:机器人技术笔记
聊聊 VLA的数据流 ,也就是一张相机图像、一句操作指令,怎样一步步变成机械臂的动作。
桌上有一块红积木和一个盒子,让机器人把积木放进去,它收到的是图像像素和一句“把红积木放进盒子”。可到了执行时,需要给出的却是七个关节的位置,以及夹爪要开多大。
这次把 VLA 里面的处理过程画成了三张图:先准备输入,再经过网络,最后输出动作。图里采用动作查询和线性动作头,前后的数据尺寸可以一路对应。
这段不到两分钟的动画,展示了完整过程。
第一张图:图像和指令如何变成 token
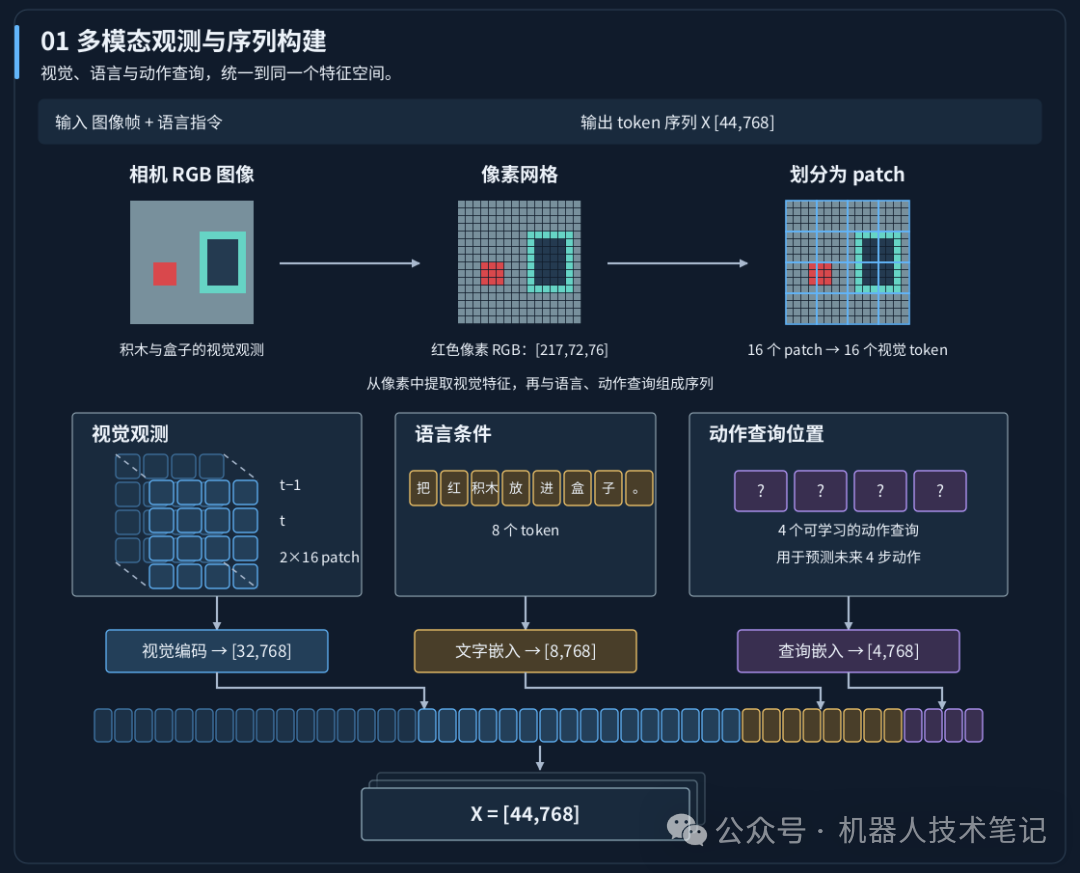
图1|图像分块并编码后,与语言和动作查询拼成 token 序列。
放大相机拍到的图像,红积木、盒子和桌面都是像素。图中一个红色像素的值是 [217,72,76],三个数分别表示红、绿、蓝的强度。
要从这些像素里提取有用的信息,先把相邻像素分成小块,也就是 patch,再送进视觉编码器。编码后,每个图像块变成一组特征数值,作为视觉 token 进入后面的网络。图里的一个蓝色小格,背后就是这样一串数。
这里用了前后两帧图像,每帧 16 个 patch,编码后合计 32 个视觉 token。每个 token 按 768 个特征值来画,这部分数据就是 [32,768]:32 组,每组 768 个数。
文字也要转成数值。“把红积木放进盒子”经过分词和嵌入,在图里用 8 个语言 token 表示,每个同样是 768 维,得到 [8,768]。实际怎么划分这些文字,由模型的分词器决定。
紫色的 4 个格子则是动作查询。它们起初是一组可学习的特征,会和图像、语言一起进入网络。我们打算预测未来 4 步动作,因此放了 4 个查询,等网络处理完,再从这 4 个位置取出结果。
把 32 个视觉 token、8 个语言 token 和 4 个动作查询拼起来,一共 44 个,每个 768 维。接下来送进网络的,就是这份 X [44,768]。
第二张图:Attention 和 MLP 如何处理信息
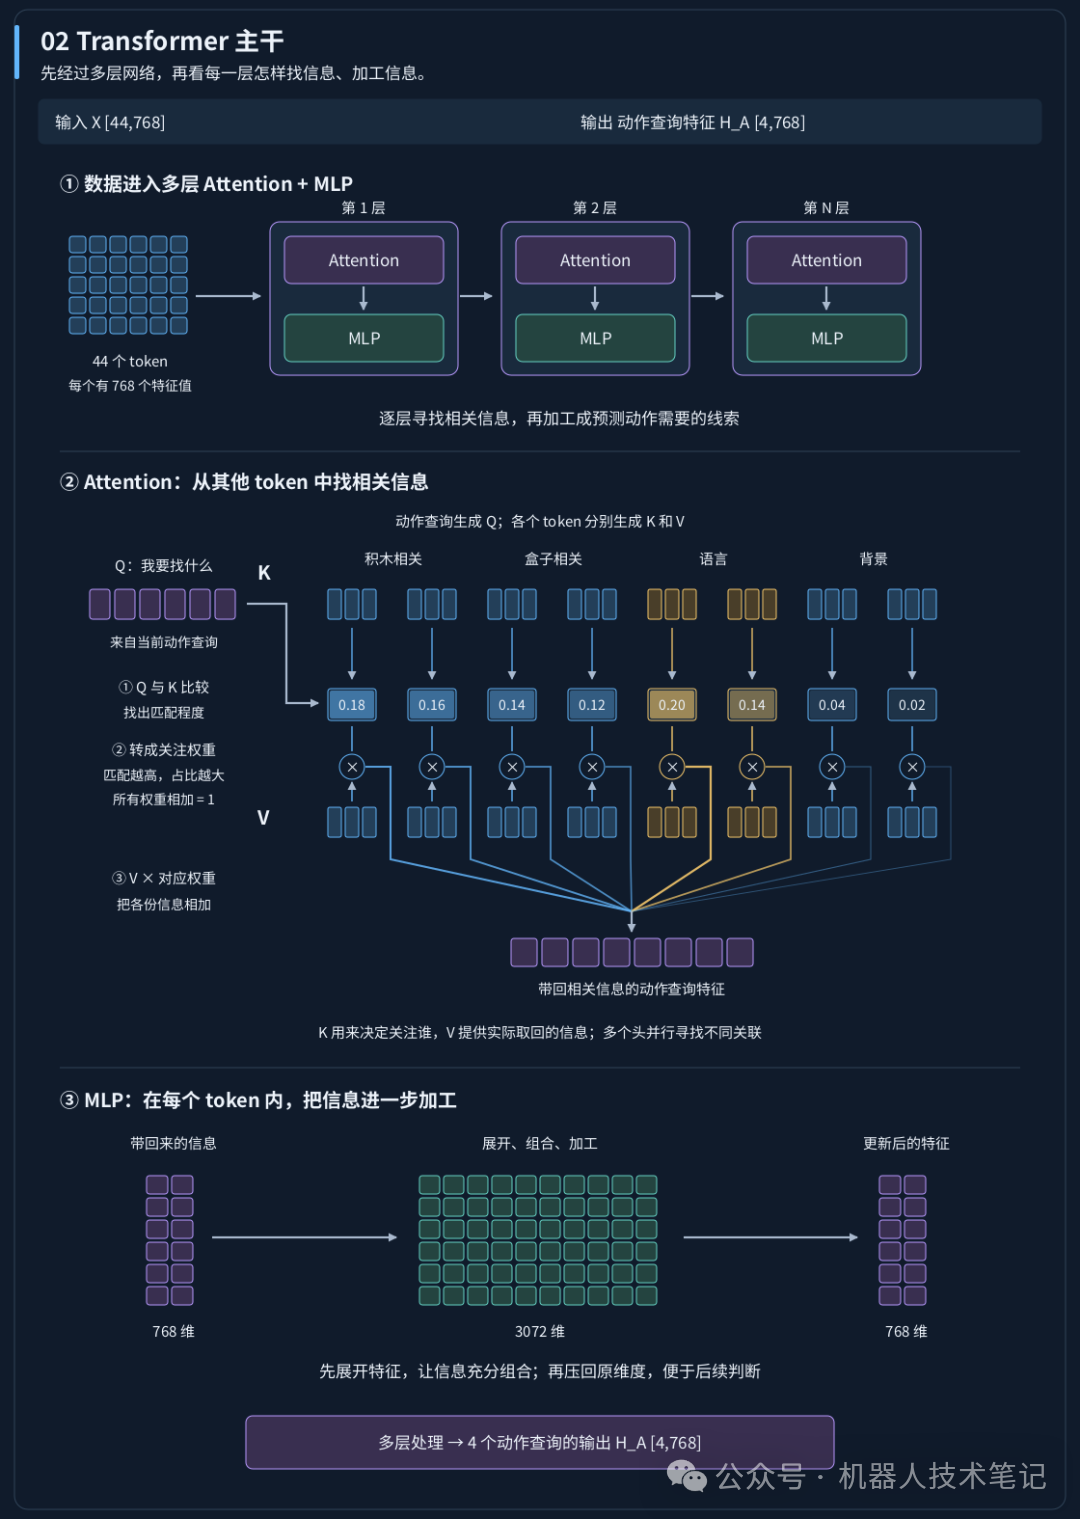
图2|Attention 根据 Q/K 匹配结果读取 V,MLP 继续加工特征,经过多层处理得到动作线索。
输入准备好了,接下来要让动作查询读到图像和指令里的信息。比如积木与盒子的位置,都与这次动作有关。
这些 token 会经过多层 Attention 和 MLP。Attention 先负责在 token 之间读取信息。
拿一个动作查询来说,它会生成向量 Q,表达当前要找的信息;其他 token 生成 K 和 V,其中 K 用来与 Q 比较,V 是实际取回的特征。
Q 与各个 K 算出匹配分数,再把分数转成权重,就知道每份 V 要占多少。
比如某份 V 的权重是 0.20,另一份是 0.04,它们都会参与计算,但占比不同。分别乘上各自的权重,再把结果相加,就得到了这次 Attention 取回的信息。图中的数值是为了把这个过程画出来;真实权重由模型计算,所有权重的总和为 1。
多个注意力头会并行做这件事,再合并结果。它们各自关注哪些特征,由训练形成。
信息取回来之后,MLP 接着加工。它在每个 token 内部,把特征展开、组合,再压回原来的长度。比如图里的 768 维先展开到 3072 维,经过非线性变换,再回到 768 维。虽然前后都是 768 个数,内容已经更新了。
Attention 在 token 之间读取信息,MLP 的这一步计算则分别发生在每个 token 内部。
每经过一层,动作查询的特征都会更新。取出最后一层那 4 个查询位置的结果,就得到 H_A [4,768],交给动作头。
第三张图:模型如何输出关节和夹爪动作
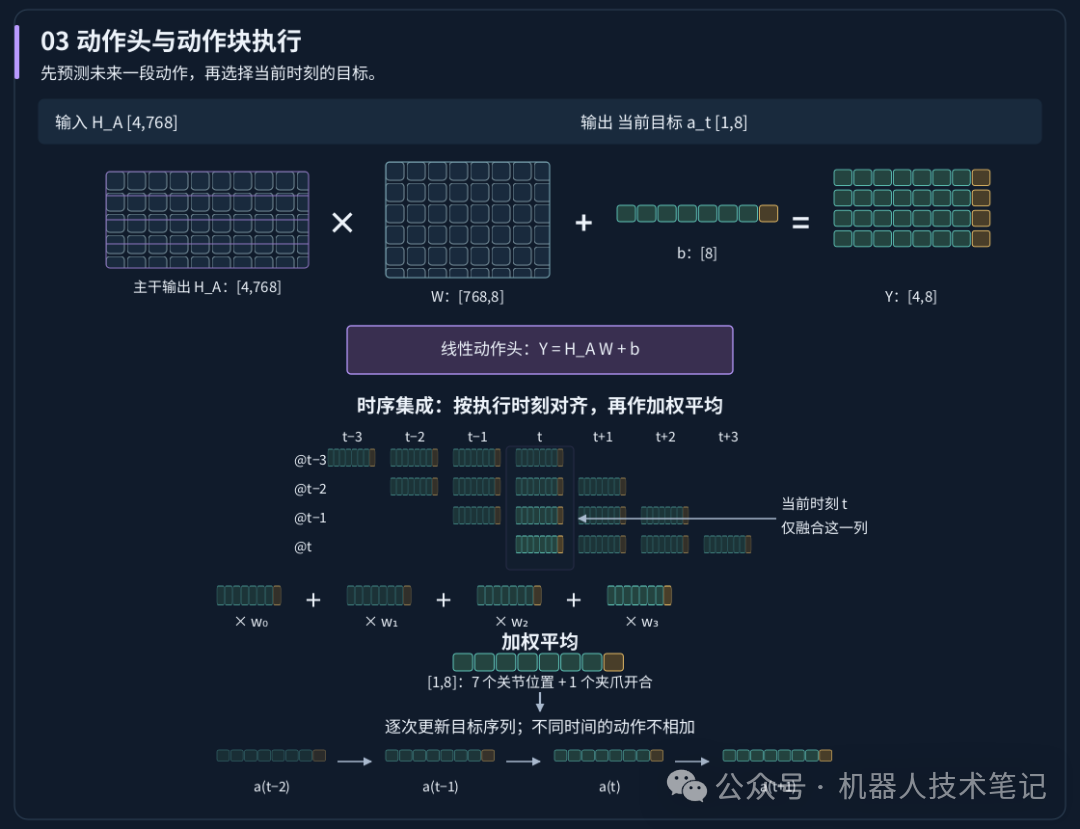
图3|动作头生成未来动作块,再将同一时刻的预测融合成关节位置与夹爪开合目标。
动作头要把刚才的特征换成关节和夹爪的目标。图中的线性动作头通过训练得到的参数,把一个查询的 768 个特征值变成 8 个动作数值。4 个查询得到 4 行,每行对应未来一步,合起来就是 [4,8] 的动作块。
一行里的前 7 个数,是七个关节的位置目标;第 8 个数,是夹爪的开合目标。
单看某一个时刻,动作便是 [1,8]。其中的 8 表示七个关节和夹爪这八个通道。
一次预测未来几步,就是动作分块,ACT 等机器人策略也采用了这样的做法。不过,算出了几步动作以后,机器人还可以继续看新图像、重新做预测。
前后几次预测因此会有重叠。上一刻预测的“下一步”,和这一刻预测的“当前步”,指向同一个时刻。由于观测更新了,两次算出的目标可能略有差别。
图里把这些预测排在一起,紫色竖框圈出的就是当前时刻 t。采用时序集成时,对这一列加权平均,就能得到现在要执行的 a_t [1,8]。
这一步只合并指向 t 的预测,t+1、t+2 的动作仍各自保留。
相机继续送来新图像,模型便能据此更新动作目标。目标交给后续控制系统,经过轨迹处理和关节跟踪,机械臂才实际动起来。
这三张图里的数据流可以连成一条:
图像像素和语言 → token 序列 → 动作查询特征 → 动作块 → 当前动作目标。
像素和文字经过编码进入网络,动作查询从中读取信息,再经动作头转换为关节与夹爪目标。随着新的观测进入,同样的流程继续运行,下一次动作也随之更新。
推荐阅读

×
右键可直接复制图片