 阅读时间大约8分钟(2824字)
2026-09-24 视觉能替代触觉吗?FELT 把触觉变成了机器人中间层
来源:豆包
作者:毛不毛 出品:具身智能前沿导读机器人操作经常需要触觉,但触觉数据比视觉数据更难采集、更难标定,也更依赖具体传感器。FEL...
作者:毛不毛 出品:具身智能前沿
导读
机器人操作经常需要触觉,但触觉数据比视觉数据更难采集、更难标定,也更依赖具体传感器。FELT这篇论文提出了一条折中路线:先用成对的 RGB—触觉数据训练生成器,再从 RGB 观察中预测双指压力图,或直接输出供策略使用的 latent tactile features。它在四项真实机器人任务中改善了纯视觉基线,但这不等于视觉已经取代触觉。本文拆开看三件事:FELT 生成了什么、它怎样进入策略,以及它在哪些场景下会失效。
视觉能替代触觉吗?先把问题换个问法
机器人为什么需要触觉?因为视觉和触觉看到的不是同一件事。
视觉擅长提供全局信息:物体在哪里、姿态大概怎样、手应该往哪个方向靠近。触觉则更接近接触现场:手指有没有碰到物体、接触点偏向哪一侧、夹持过程中是否开始滑动。
在插入、套杯、擦拭和重定向这类任务里,机器人往往已经“看见了目标”,但仍然不知道接触之后是否对齐。此时再加一张普通 RGB 图,未必能解决问题;真实触觉传感器却又脆弱、昂贵,而且换一个传感器形态,数据和策略可能都要重新适配。
所以,FELT 真正提出的问题不是“视觉能不能彻底替代触觉”,而是:如果视觉画面里已经包含了足够多的接触线索,能不能先估计出一份触觉表征,让机器人策略用起来?
这两个问题差别很大。前者是感知替代,后者是数据和策略接口设计。
FELT 生成的不是一张“看起来像”的图片
FELT 的全称是 Feature-Extracted Latent Tactile,可以理解为“从视觉中提取出的潜在触觉表征”。它把腕部鱼眼相机拍到的 RGB 图像,映射成左右手指的压力触觉图;也可以跳过完整图像,直接输出供策略使用的中间特征。
它的生成器训练依赖成对的 RGB—真实触觉数据:同一时刻,腕部相机记录 RGB 图像,手指上的真实触觉传感器同步记录接触位置和压力分布。这样的一组“画面—触觉读数”才构成训练监督。论文使用了 2700 多条 handheld UMI-style demonstrations 和 260 万组 RGB—触觉帧对,之后才把生成器应用到没有触觉通道的视觉演示上。
这里有一个容易被忽略的限制:FELT 不是零数据学会“感受”,而是用真实视触觉数据学习“视觉画面与接触结果之间的对应关系”。
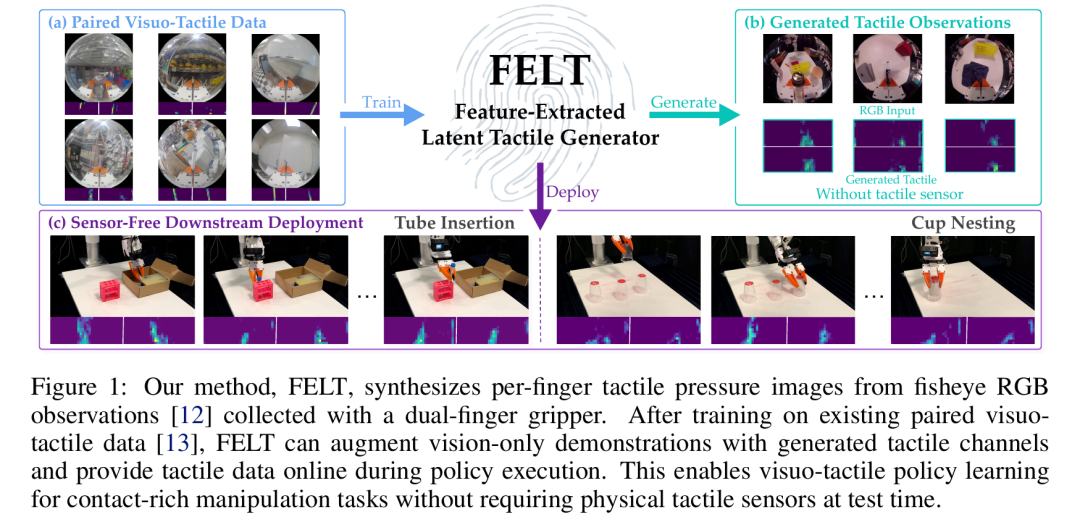
图片说明:Figure 1 展示从 paired visuo-tactile data 到 generated tactile observations,再到 sensor-free downstream deployment 的完整链路。图片来源:FELT 论文 Figure 1
为什么要给左右手指各自建一套查询分支
如果只是把 RGB 编码后接一个回归头,模型可能能学会“这里大概有接触”,但不一定能学会左右手指的受力差异。
FELT 的处理方式更像是在告诉模型:这不是一张普通图片,而是两个有物理位置的触觉面。
第一步,RGB 输入经过冻结的 DINOv2 视觉编码器,提取视觉 token。冻结意味着这部分编码器在训练生成器时不更新,生成器主要学习如何从已有视觉特征中读出触觉信息。
第二步,左右手指分别使用一个 12×32 的触觉查询网格(tactile query grid)。每个 query 对应触觉面上的一个位置,通过 cross-attention 读取视觉特征。两个分支还会通过带门控的跨面板信息交换(gated cross-panel exchange)互相传递信息,因为双指夹持不是两个完全独立的动作:一侧压力变化,另一侧可能需要配合。
第三步,query 被还原成二维网格,交给面板感知的卷积读出头(panel-aware convolutional readout)。这个读出头同时预测两类信息:哪些位置发生了接触,以及接触强度大概是多少。
这套结构的意义在于,它没有把“触觉”简化成一个整体分类标签,而是保留了传感器的空间布局、左右关系和压力分布。
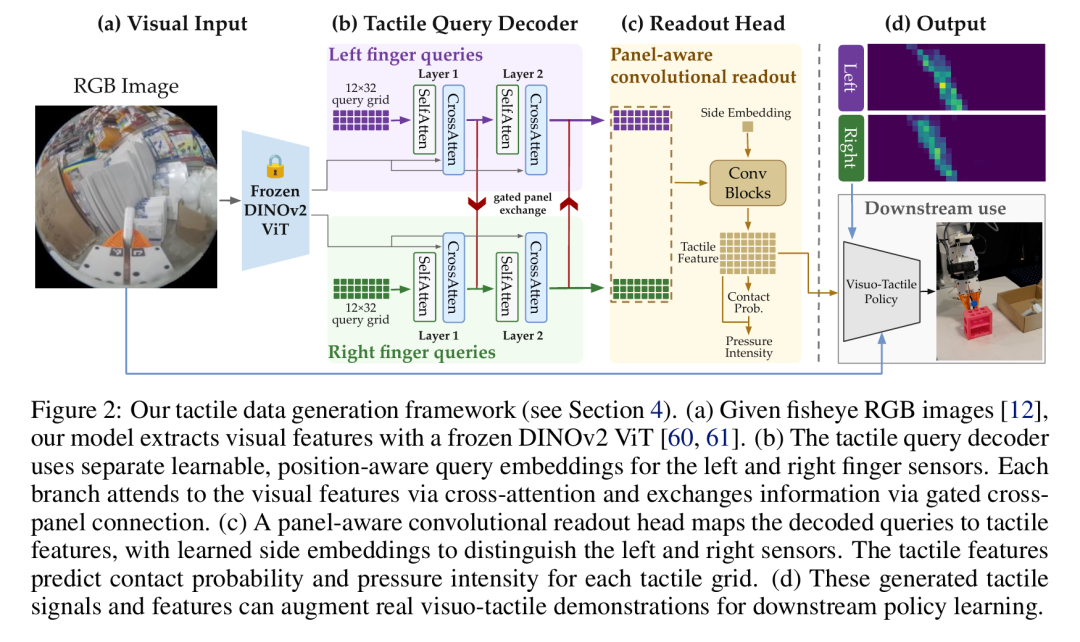
图片说明:Figure 2 展示冻结 DINOv2、左右手指 query decoder、gated cross-panel exchange、卷积 readout 以及下游 visuo-tactile policy 的数据流。图片来源:FELT 论文 Figure 2
真正值得看的,是它如何进入策略
FELT 可以以三种方式参与机器人学习。
第一种是离线补全。原来只有 RGB 和动作的视觉演示,经过生成器后补上一条估计的触觉通道,变成视触觉演示。这个过程不需要给每条历史数据重新装上触觉传感器。
第二种是在线生成。策略运行时,生成器根据实时 RGB 画面生成触觉图,再把这张图送入原本需要触觉输入的策略。这样部署时可以不安装真实触觉传感器,但策略仍然保留触觉接口。
第三种也是更值得注意的一种:不生成完整触觉图,直接使用生成器中间层的 latent tactile features。它更像是把“接触状态的可用摘要”交给策略,而不是要求策略先理解一张带噪的压力图,再从图里重新提取特征。
这里要区分两种“无传感器”:在线生成方案的策略训练仍然使用过真实触觉,只是在部署时用生成触觉替换传感器读数;latent features 方案则连策略训练和部署都不要求真实触觉。
这也是文章主线最重要的地方:FELT 的价值不只是生成触觉图,而是提供了一个视觉到策略之间的触觉中间层。
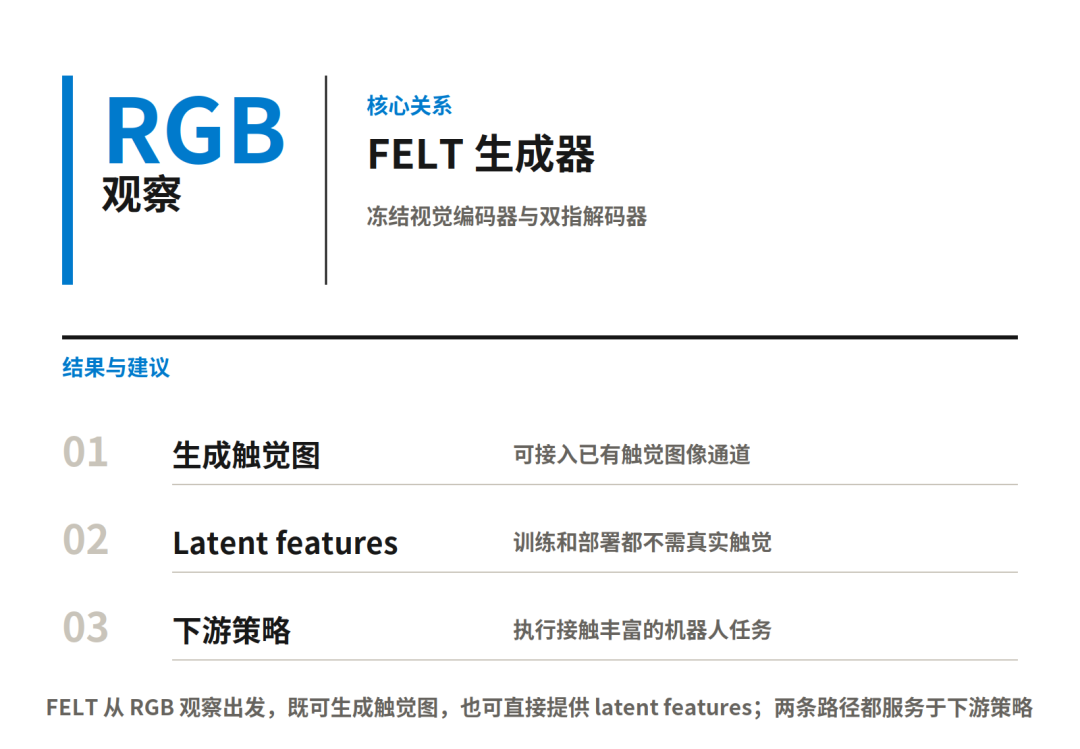
图片说明:同一个 FELT 生成器可以输出生成触觉图,也可以直接输出 latent features;两条路径都服务于下游策略。该图为基于论文方法与部署描述制作的确定性关系图。
真机结果说明了什么,又没有说明什么
论文在 xArm7和双指夹爪上测试了四类接触丰富任务:Tube Insertion、Cup Nesting、Eraser Wiping 和 Triangle Peg Insertion。每种配置在每个任务上进行 20 次试验,比较纯视觉、真实触觉、生成触觉和 FELT latent features 四种设置。
结果方向是清楚的:Vision + FELT Tactile 在四项最终任务指标上都高于 Vision Only;在 Cup Nesting 和 Triangle Peg Insertion 上,生成触觉达到与真实触觉相同的最终成功率。FELT Features 则在三角插入任务上达到 90%,纯视觉为 50%。论文还报告生成器在单张 RTX 4090 上约 20ms 的延迟。
但这里不能把 90% 读成“FELT 已经比真实触觉更强”。每个任务只有 20 次试验,论文自己也提醒,单项成功率的统计误差大约在 7–11 个百分点。更稳妥的判断是:在这些任务、这些传感器和这套低数据设置下,视觉生成的触觉确实能改善接触关键阶段。
论文的阶段结果也支持这一点。不同方法在抓取阶段往往差异不大,触觉带来的收益主要出现在重定向、插入、套叠和擦拭这些接触更关键的环节。也就是说,触觉表征的价值不是让机器人“看得更清楚”,而是帮助它在已经接触之后继续修正。
latent features 为什么可能比“生成图片”更好用
这部分论文给的是一个有数据支持、但仍然没有完全证明的解释。
真实触觉图像包含传感器噪声、标定误差和瞬时变化。对于每个任务只有 60 条 demonstration 的低数据设置,策略可能很难从这些细节里学到稳定规律。
FELT 的 latent features 则来自在大规模成对数据上训练过的生成器。它保留了空间接触结构,但可能把一部分瞬时噪声压平,因此更像一个稳定的接触摘要。论文把这称为 hypothesis,而不是已经证实的因果结论。
这个差别很值得注意:模型并不一定要还原一张物理上逐像素准确的触觉图,才有机会帮助策略。对下游控制来说,一份能稳定区分“正在接触、接触偏左、接触在变化”的中间表征,可能比一张看起来更真实但噪声更大的图更有用。
它还没有替代真实触觉
FELT 的边界也很明确。
首先,FELT 的生成器训练依赖成对的 RGB—真实触觉数据。真实触觉传感器可以在部署阶段被移除,但不能从生成器的训练监督中凭空消失。
其次,它依赖接触区域在 RGB 中足够可见。如果手指、物体或接触面被严重遮挡,模型就缺少判断压力分布的视觉线索。论文给出的后续方向是增加相机视角,或者使用时间模型保留之前没有遮挡时的信息。
再次,目前实验只覆盖压力型触觉传感器(pressure-based tactile sensors),不能直接推广到磁性、凝胶等其他触觉形态。它也只在双指夹爪和四类任务上验证,不能据此推出跨手型、跨传感器和跨任务的通用触觉能力。
所以更准确的说法是:FELT 让机器人在部分可见接触场景中,用视觉估计出一份足够帮助策略行动的触觉表征。它减少了真实触觉硬件在数据扩充和部署环节的依赖,但没有消除触觉数据、遮挡和传感器差异带来的问题。
触觉的下一步,可能不是“装不装传感器”
过去讨论机器人触觉,问题常常是要不要装传感器、选哪种传感器、分辨率够不够。FELT 把问题往前推了一步:即使最终仍然需要真实触觉,模型能不能先学习一个视觉可估计、策略可消费的触觉接口?
这条路线的价值,不在于宣布视觉赢了触觉,而在于把昂贵、脆弱、难规模化的感知模态,拆成了几个可以分别优化的环节:真实触觉用于建立对应关系,视觉用于扩大可用数据,生成器用于补足接触表征,策略再决定这些表征是否足够支持动作。
视觉没有替代触觉;它先替触觉承担了一部分数据和接口工作。
推荐阅读





×
右键可直接复制图片