 阅读时间大约5分钟(1855字)
2026-10-10 波士顿动力、RAI、CMU:不用AMP对抗训练,Atlas和宇树G1也能走得像人
来源:豆包
作者:Yuanxq 出品:具身智能研究室机器人走得稳,未必走得自然。只给速度跟踪和抗扰动奖励,强化学习可能学出手臂僵硬、膝盖一...
作者:Yuanxq 出品:具身智能研究室
机器人走得稳,未必走得自然。只给速度跟踪和抗扰动奖励,强化学习可能学出手臂僵硬、膝盖一直弯着、落脚生硬的步态;照着人类动作学,又容易在数据没覆盖的速度和方向上出问题。DeepMimic 用参考动作教策略运动,AMP 用判别器给动作风格打分,生成式模型则尝试根据目标生成参考动作。这些方法都在回答同一个问题:怎样让机器人保留人类步态,又能随时听从操控指令?
HuMBLE 的做法是先学动作,再扩展指令范围。教师先在仿真里学会执行人类动作,学生跟着教师学习,但输入只保留机器人自身状态和三个速度指令。随后,学生一边继续练习参考动作,一边练习随机速度与转向组合。这样,用户只需指定往前多快、向侧面多快、转身多快,机器人便能自己安排迈步和摆臂。作者在 Atlas R1、Atlas D1 和 Unitree G1 上测试了这套方法。
方法拆解
输入与动作数据
策略接收前后速度、侧向速度和转向角速度,再结合关节角度、关节速度、IMU 角速度、重力方向和上一次动作,决定怎么迈步。Atlas 还读取状态估计器提供的线速度。
团队以 120 Hz 采集约三小时的人类动作,覆盖走跑、侧移、转身和启停。动作先映射到比例接近机器人的代理骨架,再优化为目标机器人的轨迹,处理碰撞和地面穿透。G1 同时调整空间尺度和动作时长,所有轨迹还做了左右镜像。
作者从躯干轨迹计算速度,转换坐标系、滤波,再根据加速度前移信号,为每帧标注指令。稍后的实际速度用于近似当前想达到的速度,让准备加速的动作与加速指令对应。
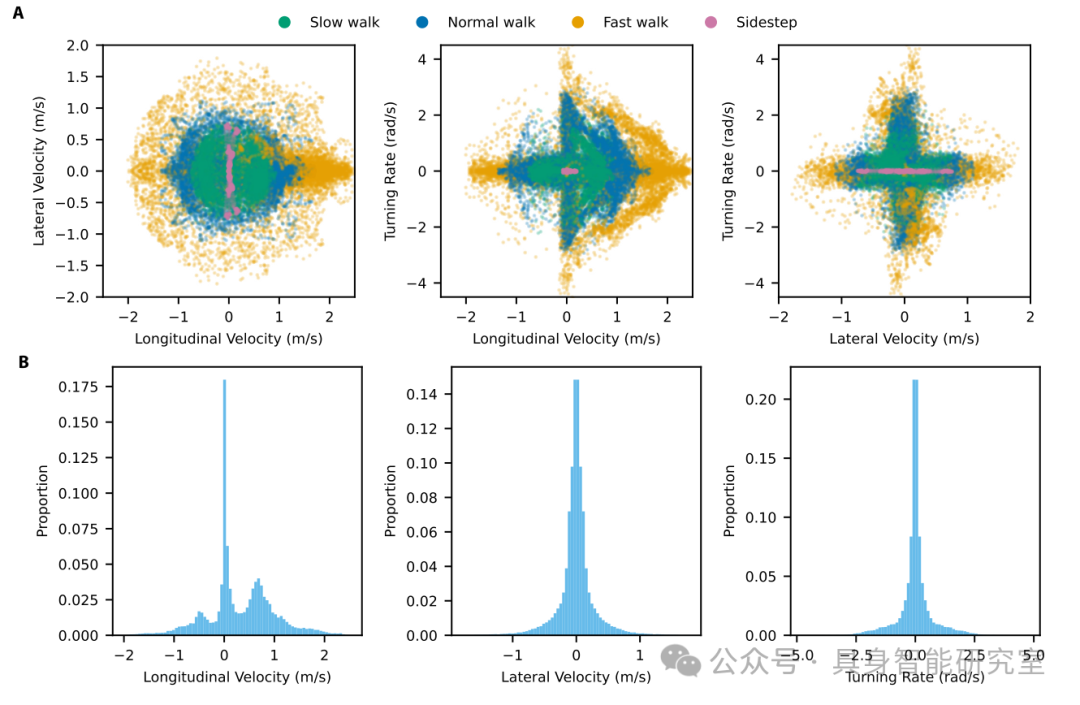
常见行走速度的数据较密集,部分侧移与转向组合样本较少。
教师训练与蒸馏
教师读取当前状态、速度指令和完整参考,用 PPO 学习执行动作。跟踪奖励约束姿态和速度,正则项惩罚动作突变、过大力矩和脚滑,存活奖励鼓励持续站稳。 训练沿用 ZEST 设置,加入辅助力与力矩课程。
重定向解决了身体比例差异,参考轨迹还要在动力学约束下执行。教师会根据实际状态修正动作,使机器人在接近参考姿态的同时保持平衡。
学生只读取本体状态和三个速度指令。训练采用 DAgger 式蒸馏:让学生自己运行,查询教师在这些状态下会输出什么动作,再监督学生更新。这样,学生也能学习偏离参考后的纠正动作。蒸馏完成后,摆臂和迈步由学生直接输出,无需逐帧读取动作库。
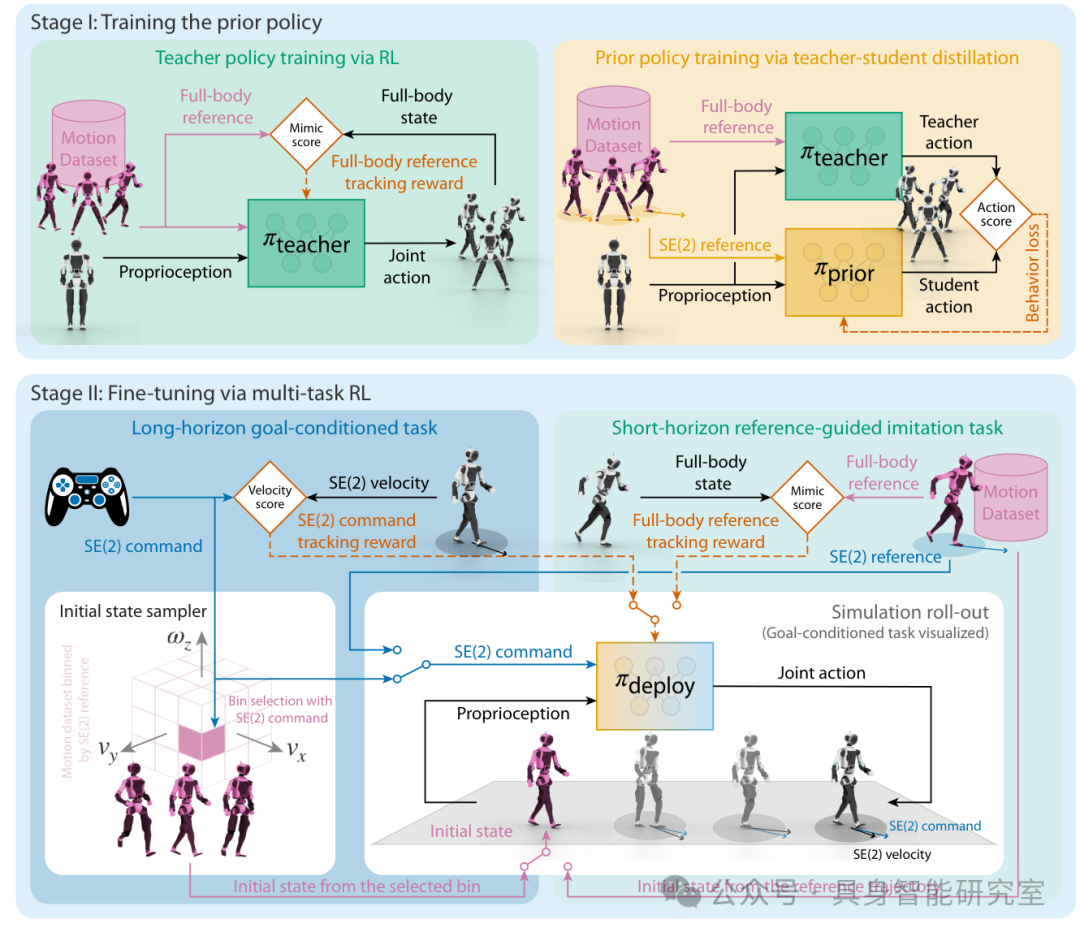
先训练教师并蒸馏给学生,再用两类任务微调学生。
同样的前进指令,在左右脚不同支撑阶段需要不同动作。关节角度和速度帮助学生判断当前步态,上一次动作提供短暂的时间信息,让它接着当前动作走下去。
两类任务一起微调
只练参考动作,难以处理数据中少见的指令;只练随机指令,又容易丢掉原先步态。作者因此让一半环境继续模仿,另一半练习随机速度与转向,共同更新同一个策略。
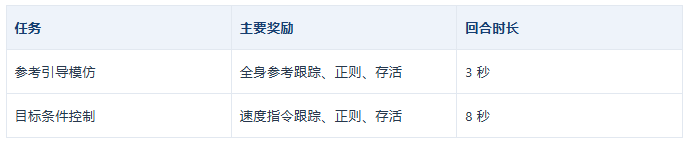
参考回合较短,减少相位差累积;目标回合更长,并在回合中更换指令。全身参考只用于计算奖励,微调中的学生仍只看本体状态和速度指令。
两组任务约束的是不同目标:参考任务要求肩、髋、膝等部位接近人类动作,目标任务只要求跟紧速度。调整环境比例,就能改变两类经验在微调中的占比。
初始化与价值估计
目标任务按指令查找速度相近的参考状态,再在附近采样并加扰动。这种 GC-RSI 初始化减少了起始姿态与指令不匹配造成的过早失败。
作者保留教师的 critic,先固定学生训练价值网络 5000 次迭代,再共同更新。两类任务使用上下文标记,并分别归一化优势值;较小学习率和较低熵系数减少微调对已学动作的影响。
真机执行
部署采用三层隐藏层、每层 1024 个单元的 MLP,以 50 Hz 输出关节位置目标,由 PD 控制器跟踪。真机只运行学生策略,教师、完整参考和 critic 留在训练端。 G1 在 Jetson AGX Orin CPU 上的平均推理耗时为 1.1 ms。
训练加入观测噪声、摩擦与质量变化、随机推力;G1 另有不读取线速度观测的版本,减少户外速度估计漂移的影响。
实验表现
步态与动作误差
HuMBLE 展示了协调摆臂、支撑腿伸展和脚跟向脚尖滚动;速度提高后,步幅也随之增加。
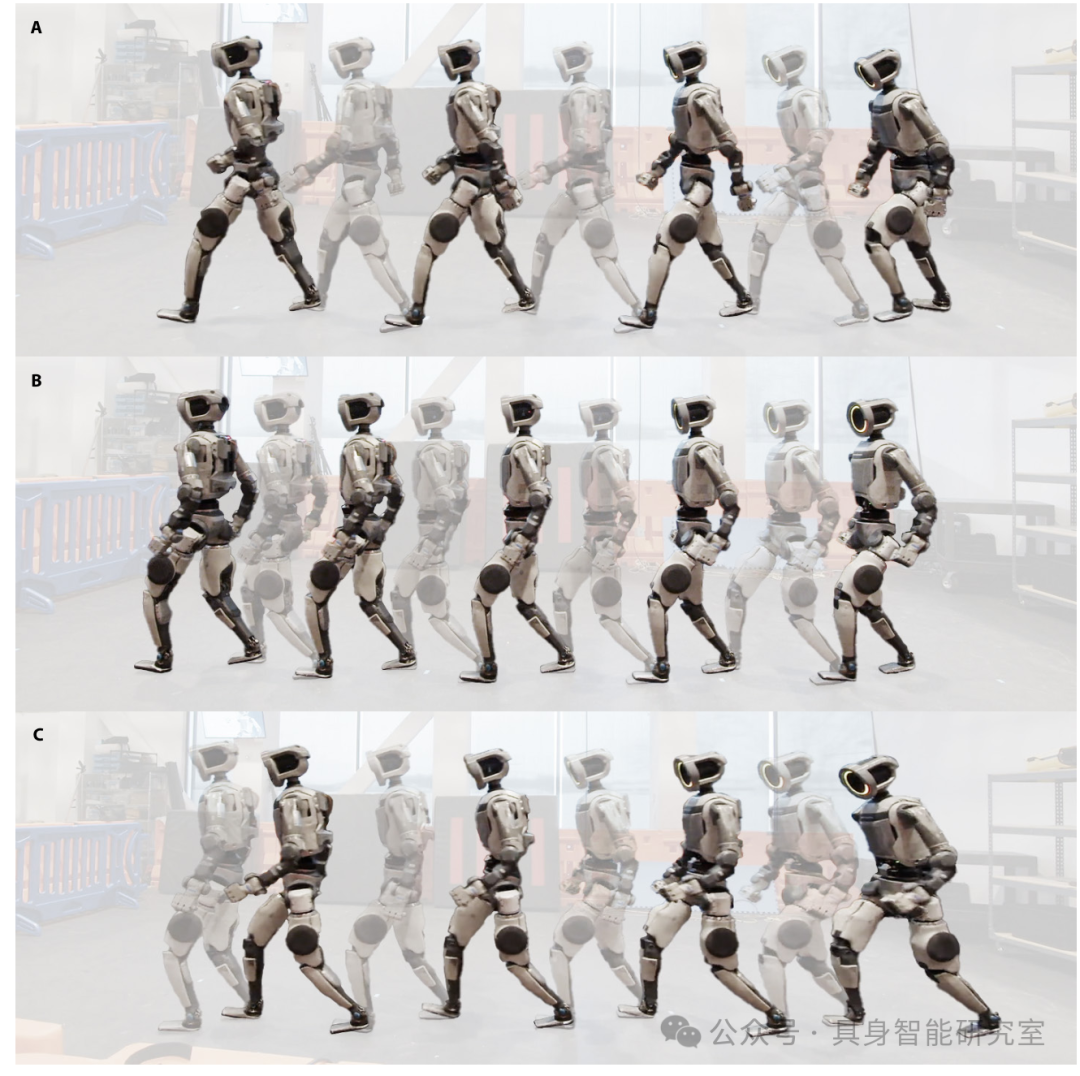
从上到下为 HuMBLE、MPC 和 Tabula Rasa。
G1 仿真测试了八段典型动作。经时间对齐,部署策略的线速度、角速度和关节角度平均误差为 0.0588 m/s、0.1269 rad/s、0.0553 rad,肩、肘、髋、膝和踝仍保留了参考动作的主要变化。
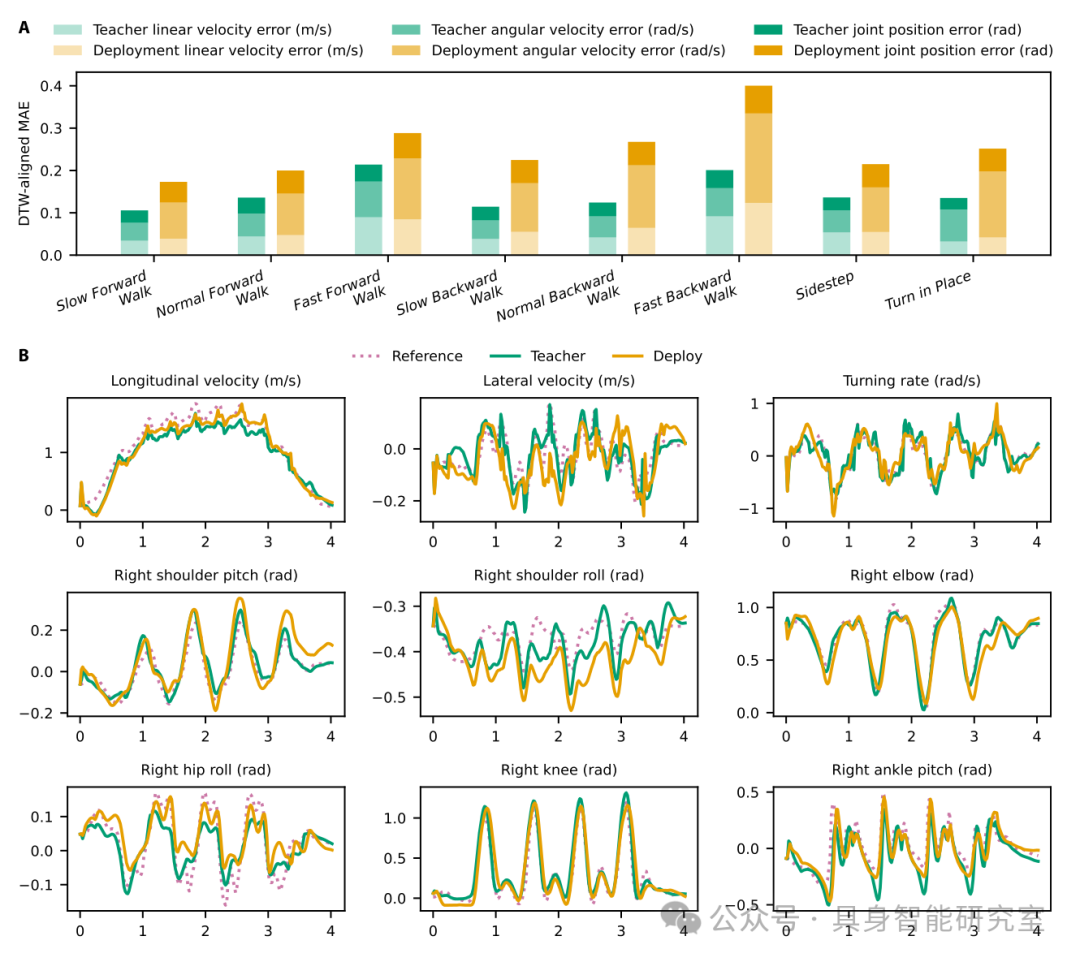
粉色为参考,绿色为教师,橙色为部署策略。
时间对齐允许机器人稍晚抬腿时,仍能比较动作形态。教师有完整参考,关节误差为 0.0330 rad;部署策略误差更大,但保留了摆臂与迈步的配合。
跟踪与抗推
速度跟踪总体接近 Tabula Rasa,高速转换时加速更平缓。前进步态更有利于抵抗纵向推力,侧移时横向支撑更有利。Atlas R1 仿真中,对躯干施加 0.2 秒推力脉冲,主要方向上的最高恢复推力约 1400 N。
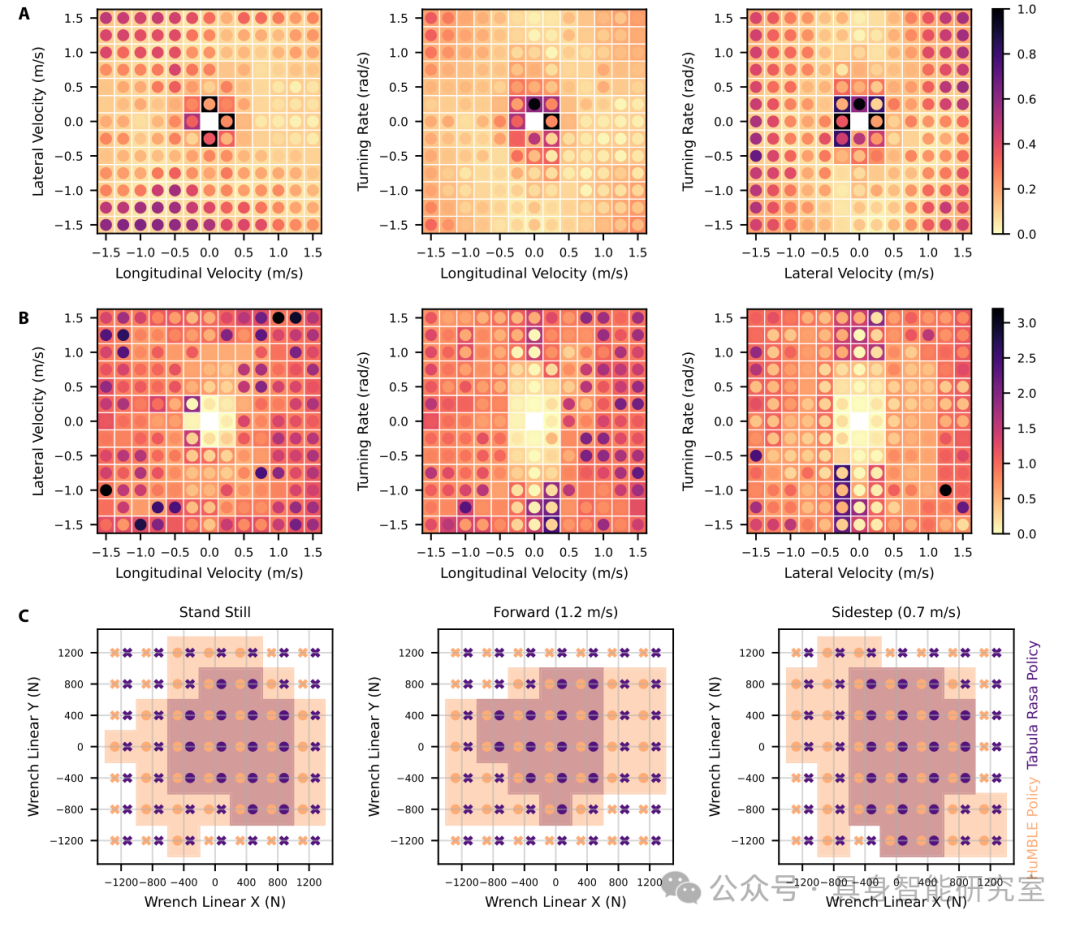
外方块为基线,内圆为 HuMBLE;下方展示抗推结果。
消融与真机
去掉教师,侧移基线走几步后接近停住;只练随机指令,摆臂和躯干动作变得不自然;只练参考,部分侧向指令下会摔倒。两类任务各占一半后,动作保真与速度跟踪得到较好兼顾,报告的指令覆盖测试中没有摔倒。
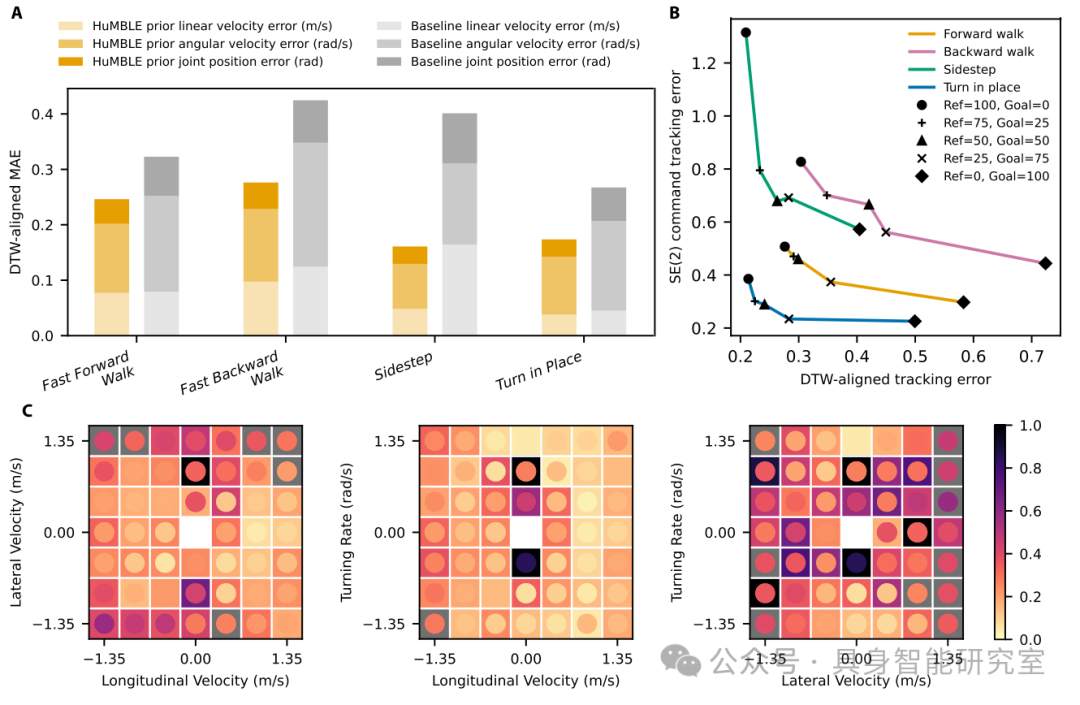
比较蒸馏、任务配比和微调前后的表现。
Atlas R1、Atlas D1 和 G1 均完成真机测试,G1 展示了走跑转换。Atlas R1 多数代表性指令中,仿真与真机的线速度、角速度误差差异约在 0.05 m/s、0.10 rad/s 以内。导航系统直接向 HuMBLE 下发速度指令;箱体任务则另配上箱、下箱策略,由高层控制器协调。
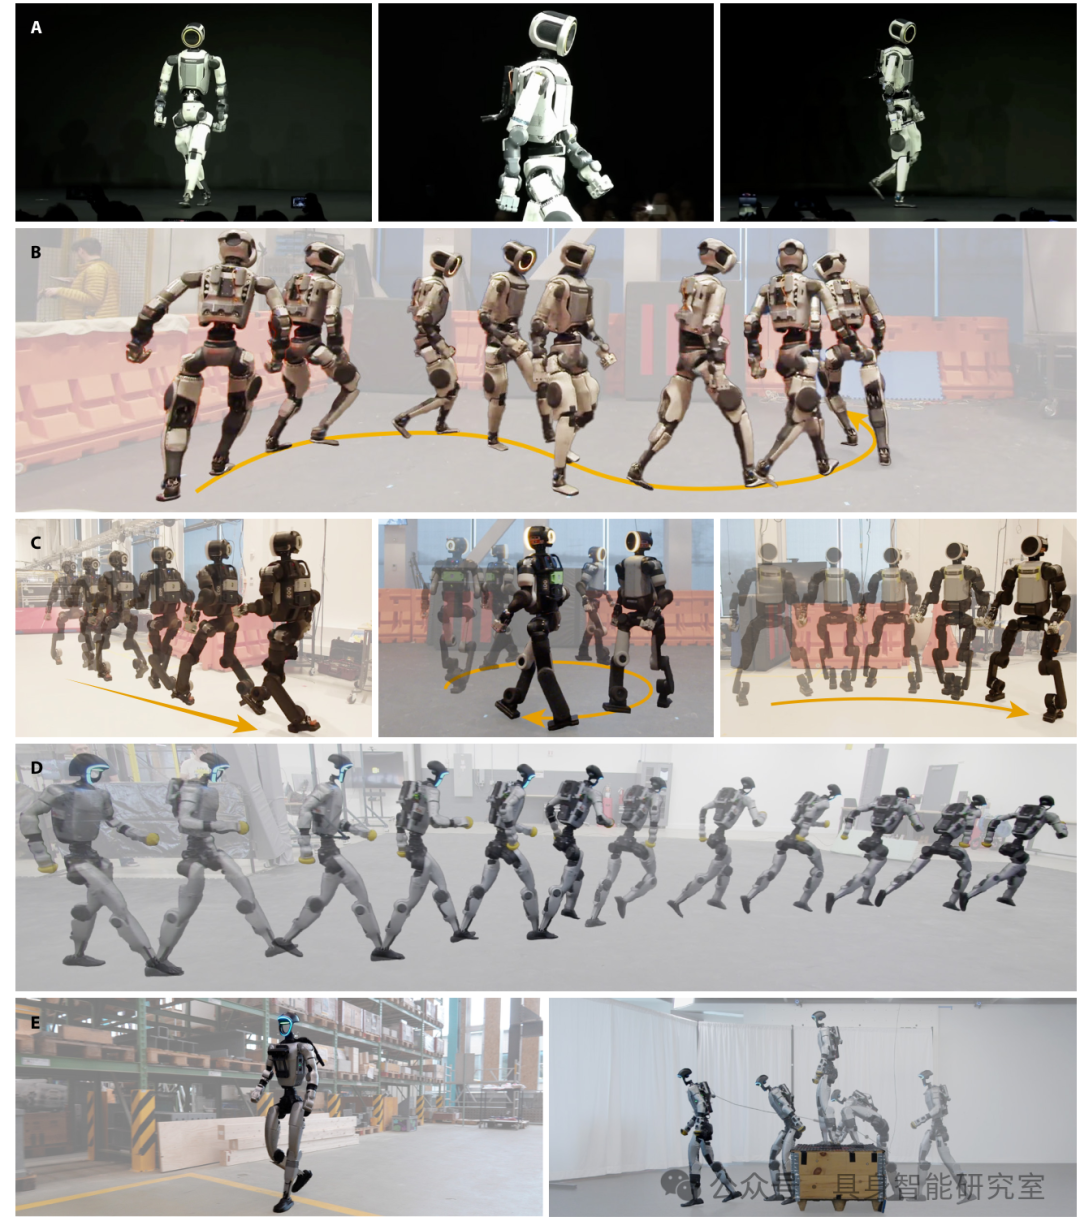
多方向行走、走跑转换,以及导航和箱体任务。

推荐阅读





×
右键可直接复制图片