 阅读时间大约10分钟以上(5060字)
2026-10-12 从VPP到VPP2:你的WAM可能并没有想象中泛化
来源:具身纪元
作者:liuxjerry 出品:具身纪元我们用WAM的初衷,是想充分利用视频模型的泛化能力。今天最好的视频生成模型,是在整个互...
作者:liuxjerry 出品:具身纪元
我们用WAM的初衷,是想充分利用视频模型的泛化能力。
今天最好的视频生成模型,是在整个互联网的视频上训练出来的。它们见过厨房、工地、球场、手术台,见过人手、机械臂、猫和卡车。这些模型身上带着一种非常宝贵的东西:泛化能力。
接上动作之后,我们同样希望机器人在面对没见过的任务时,泛化能力会有显著提高。
但VPP系列的作者彦江在和我们交流的时候提到了一个反直觉的现象:WAM其实并没有达到理想的在陌生场景和陌生任务上的泛化效果。(值得一提的是,Video prediction policy是24年底的作品,早于WAM这波热潮。但到了2026年,WAM其实并没有被优化到理想的效果。)
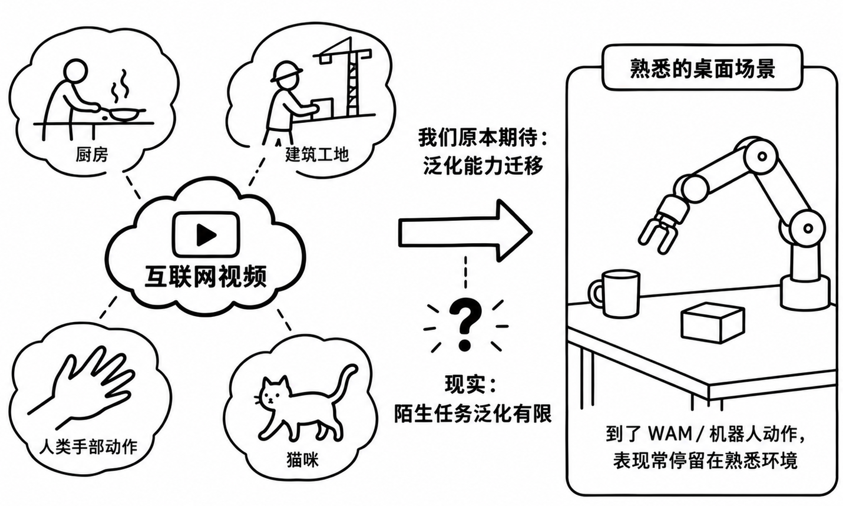
去翻一翻此前 WAM 论文的项目主页。你会发现一个奇怪的规律:它们展示的视频预测,几乎清一色落在自己后训练过的机械臂场景里。桌上摆着几样熟悉的东西,机械臂以熟悉的姿态伸过去。少数几个展示人手的例子,人手也只是在画面里做点轻微的抖动。
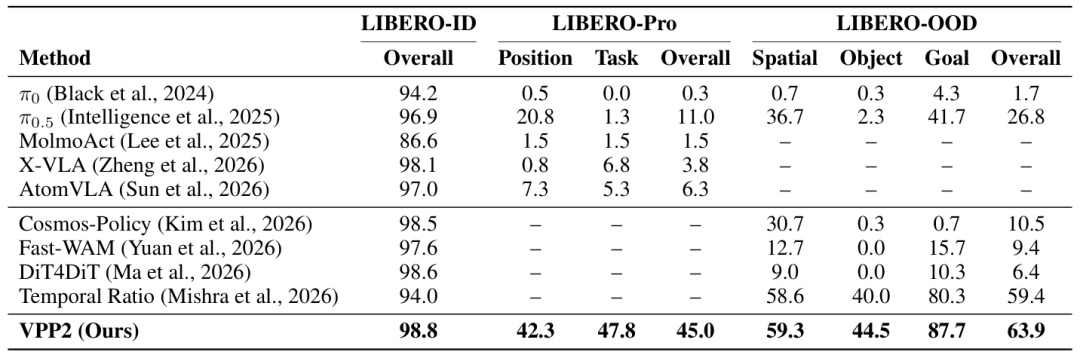
VPP2 在文章中做了个对比实验:在标准 LIBERO 上,一些主流的WAM模型成功率非常高,但换成考验泛化能力的 LIBERO-OOD评分会骤降。这组落差说明,熟悉任务上的高成功率,并不能证明视频先验已经被带进陌生任务。
也就是说,几乎没有一篇 WAM 论文,敢展示开放环境下的视频预测。
这就构成了一个悖论:WAM的全部卖点,是视频模型带过来的泛化能力。可这一代WAM练完之后,视频本身已经不太会泛化了。视频不泛化,动作自然也无从泛化。
问题出在哪?
01视频、动作的错位:两个核心问题
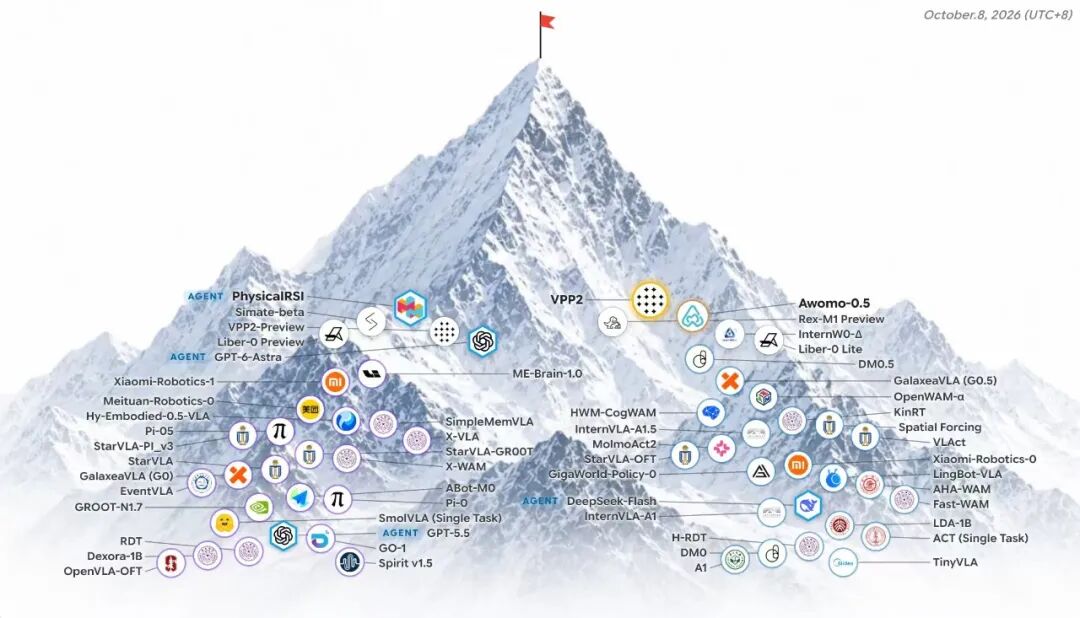
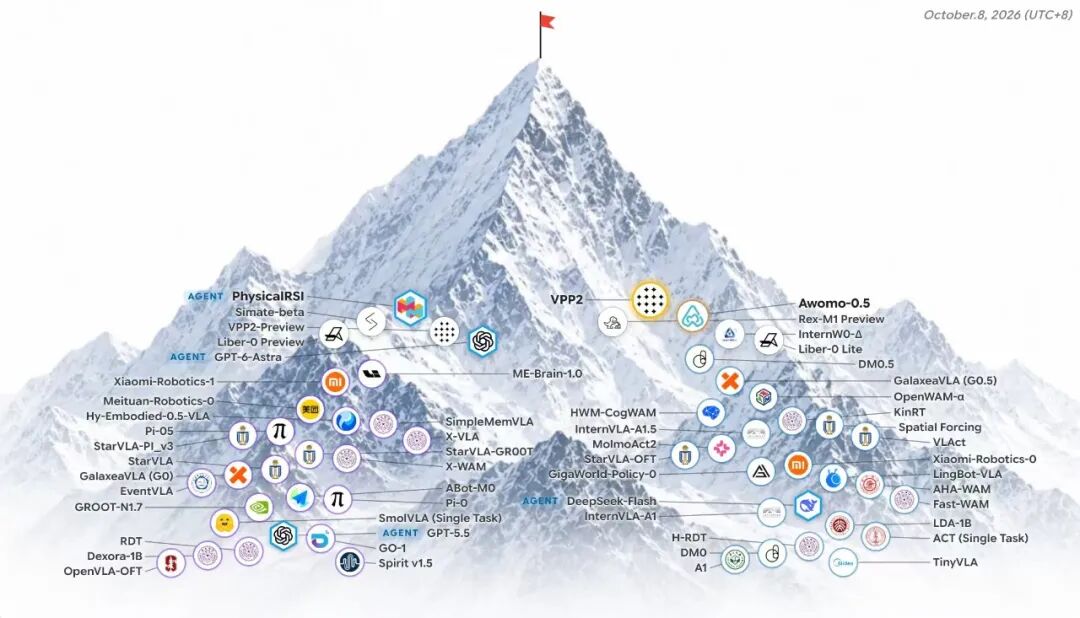
星动纪元刚发布的VPP2的研究,在 LIBERO-OOD 上拿到了63.9%的成绩,提高了5倍多。它未使用任何额外数据或Agent RSI,仅仅使用标准数据集,就在RoboDojo上以39.26分的成绩,排名榜首。
VPP2的代码和项目主页也已公开,它是一个不用额外数据和外挂策略,能被第三方复现的策略。
VPP2的项目主页上放的就是开放环境下的视频预测结果。首帧是随手拍的,后面那些画面,全是模型自己预测出来的。
但我们觉得,在榜单背后,从VPP到VPP2的思考,更值得我们去深挖。在和彦江的沟通中,他给我们点出了VPP2 的问题意识,也是理解这篇文章的钥匙
问题一:大多数 WAM在视频预测阶段不能在操作领域精准地跟随语言去生成
问题二:加入动作之后,已有的视频先验丧失了
下面拆解一下这两个维度:
问题一:视频预测的指令遵循
把视频基座拿过来直接在操作领域用并没有那么容易。开源视频基座大多是为艺术创作、广告、短视频特效等场景训练出来的。这类应用追求的是画面丰富、想象力和视觉冲击力。它天然不完全适合于机器人模型的使用需求。
在微调视频基座模型的路线上,也有两类分化:
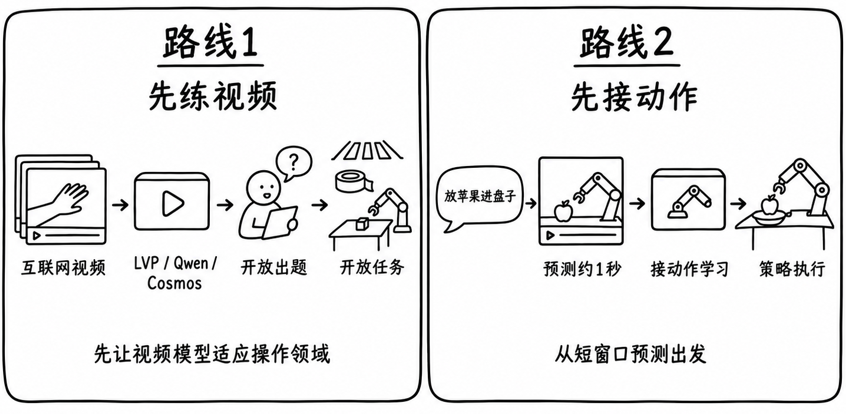
第一类以做视频模型的团队为代表。MIT 的 Boyuan Chen 做过一个叫 Large Video Planner 的工作,简称 LVP。他们把视频模型做到 14B 规模,用互联网规模的人手操作视频去训,然后做了一件很大胆的事:请第三方评测者自己随便出题。
不指定场景,不指定任务,测试者想考什么就考什么。有人选了斑马线,有人选了撕胶带。论文里的说法是,独立测试者被鼓励尽可能刁钻。
结果在 Task Complete 这一档上,LVP 拿到 59.3%。
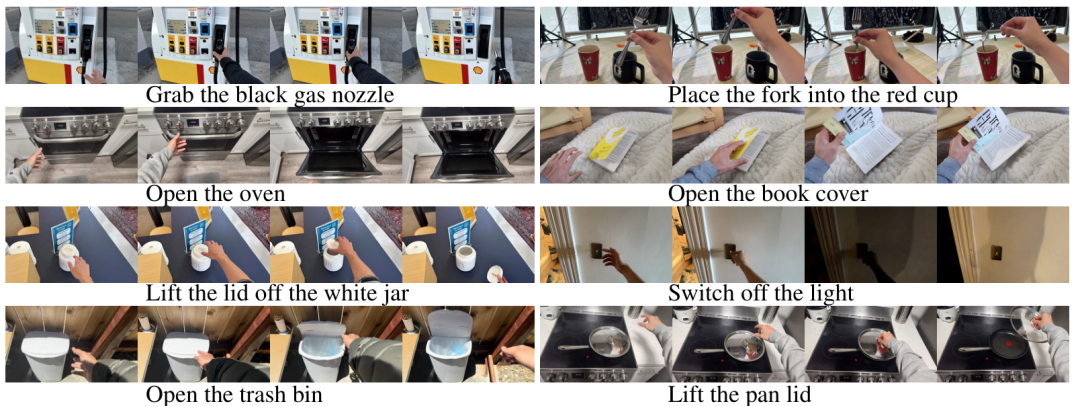
LVP:第三方提出的开放环境任务
阿里 Qwen 团队做的 Qwen-RobotWorld 也展现出了比较强的视频预测能力,包含跨任务、跨构型、跨环境的泛化。
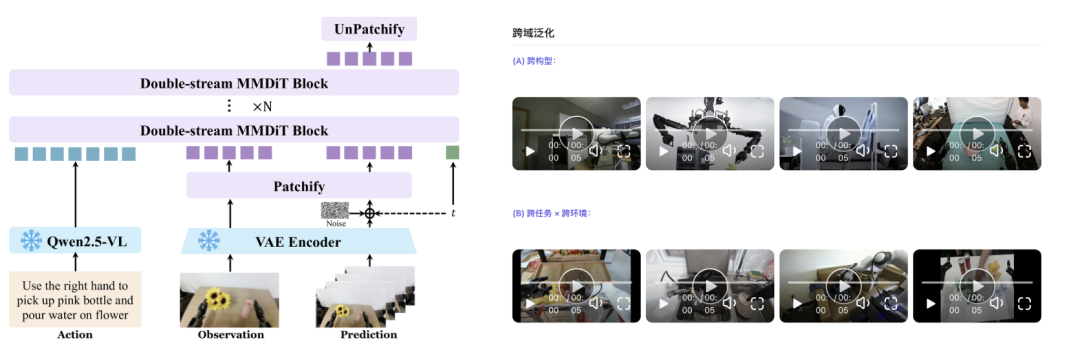
Qwen-RobotWorld:语言条件下的世界模型架构
英伟达的 Cosmos 3 则把基座面向物理 AI 的机器人等垂类继续训练,并展示了语言指令下的物理场景生成能力。
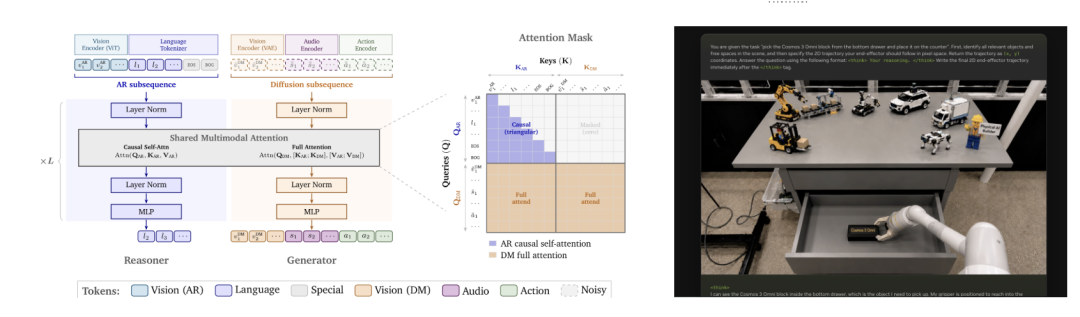
左图,Cosmos 3:MoT 架构;右图,语言跟随能力展示
这些工作提示了一条路径:先让视频模型适应操作领域,使指令与较完整的操作过程对齐,再考虑如何把预测转成动作。
第二类是大多数联合训练的WAM的常见做法,从策略执行出发:机器人通常一次只输出一小段动作,于是训练者也让视频模型只预测约一秒的未来,再把它接到动作学习上。这个选择在工程上很自然;但问题是,整条任务的指令往往描述十几秒甚至更长的过程,和这一秒的视频并不对应,具体来说有两个麻烦:
麻烦一:预测窗口和指令对不上:指令说的是“把苹果放进盘子”这件完整的事,可能要十几秒;模型却只看其中一秒。这一秒里,机械臂也许还没碰到苹果。文字描述的是完成放置,画面却只有机械臂在空中移动。这样的配对会让模型难以学到指令与运动之间稳定的对应
麻烦二:指令本身就有歧义:桌上有碗和垃圾,指令只有四个字:清理桌面。先收哪个碗、先捡垃圾,都说得通。同一句话对应多条合理轨迹,模型就很难学到明确的下一步。
你让它叠碗,它在那儿擦桌子;你让它放苹果,它手在空中晃来晃去。它根本没在听你指挥。
VPP2 论文的示意图画出了这种歧义:同一初始画面配一句笼统指令,可能通向多条都合理的操作轨迹;把操作者、目标物和过程写清,再用完整事件作为预测单位,训练样本里的指令才能与这段演示轨迹对应起来。
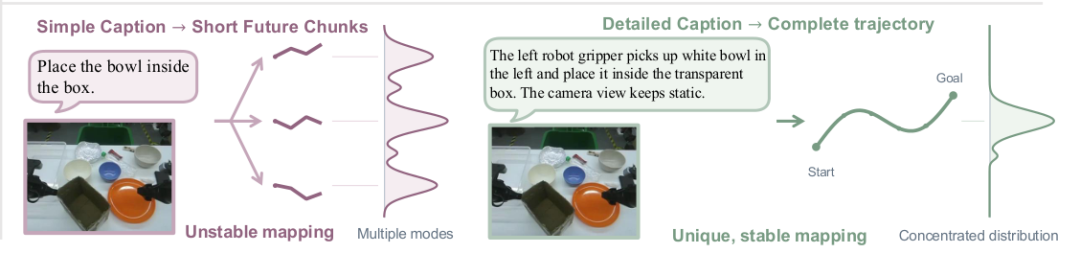
VPP2:模糊指令与详细描述对应的未来轨迹
问题二:加动作的时候,如何让视频能力不被破坏
问题一让视频模型学会遵循操作指令。接入动作模块后,还有问题二:这份视频能力能否保住?
Temporal Ratio论文的作者、Georgia Tech的机器人博士生Utkarsh A. Mishra等人把动作训练后出现的组合泛化退化称为 video-action generalization gap,即视频到动作的泛化鸿沟。他们的实验表明,在测试的设置中,全量微调视频骨干虽能做好熟悉任务,在 LIBERO-OOD 上却明显不如 LoRA 适配。VPP2 论文也将草率地加入动作组件或训练目标,列为视频泛化可能受损的原因。
有两类容易损伤视频泛化能力的做法:
第一种:动作与视频 token 互相可见。
一些模型让动作与视频 token 在注意力中互相可见,方便两种信息交换。如果动作训练同时更新视频骨干,动作损失可能牵动原有的视频表征,让模型更贴合训练过的动作,却削弱对陌生场景的预测能力。
第二种:把多种训练目标放进统一模型。
比如把文本条件的策略学习、动作条件的视频预测等目标放在同一模型中共同训练。统一训练涉及多个目标和数据来源。如果训练方式、数据量以及原有视频数据的混合不足,视频模型已有的泛化能力就很难保住。
02VPP2 怎样分别跨过视频预测与动作学习的两道坎
VPP2 的方案分为数据、训练和推理三个环节,并有针对性地解决了这两个问题。
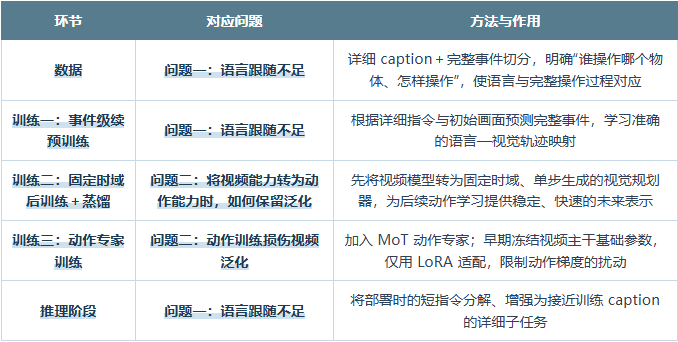
数据阶段:让指令与操作过程明确对应来增强语言跟随能力
针对问题一,在数据处理上,VPP2 的核心思路就一句话:把指令写得足够详细,详细到读完这段描述,机械臂只剩唯一一条轨迹可以走。
举回刚才那个例子。清理桌面,改成:用左手抓起第二个碗,放进垃圾桶。现在机械臂只剩一条路可走了。左臂、第二个碗、垃圾桶,三个约束一卡,轨迹基本被锁死。
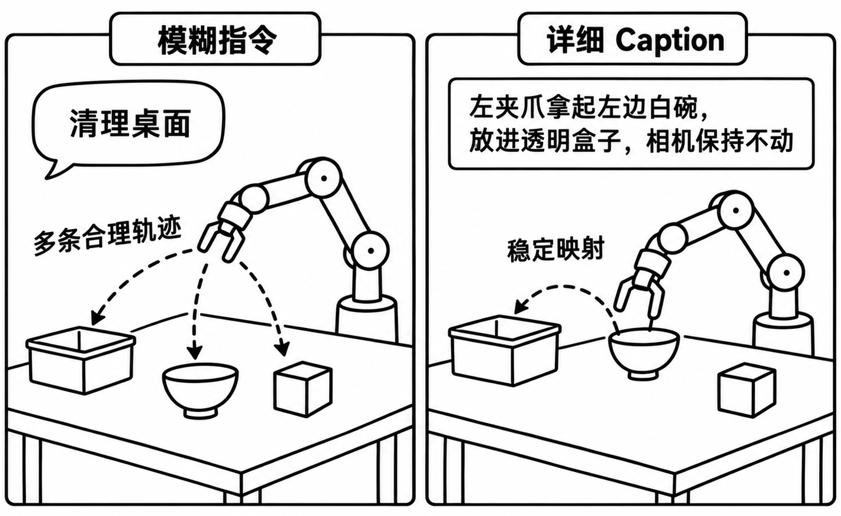
一段详细描述对应的画面是唯一的,模型因此能学到从语言到画面的稳定映射。这段映射一旦建立起来,泛化就有了落点——换一个新场景、新物体,只要描述依然详细,模型依然知道该往哪儿走。
这套逻辑落到数据层,产生了 VPP2 的三个具体动作:
一是语义事件切分。
一个视频片段对应一个完整事件,而不是随手切成一秒一段。
二是详细文本标注。
每段视频配一条 caption,写清楚任务怎么完成、用的是哪只手、抓的是哪个物体、相机视角怎么变。
三是多视角输入和坐标对齐。
多路相机拼成统一的 T 型输入,工作空间和末端执行器两级对齐。这一条是为第三阶段的动作学习准备的。
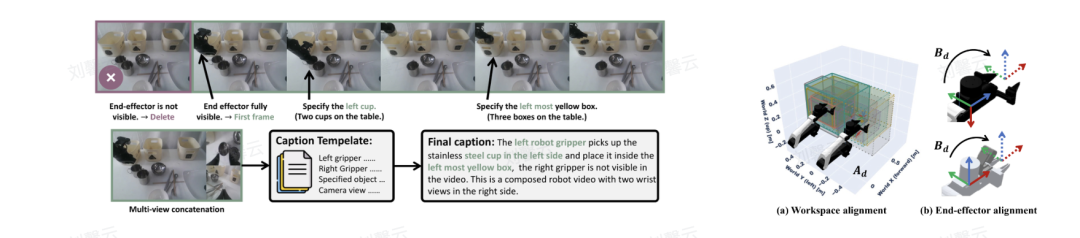
左,VPP2:数据处理与详细标注流程;右,VPP2:工作空间与末端坐标系对齐
训练阶段:把视频预测能力逐步转成执行能力
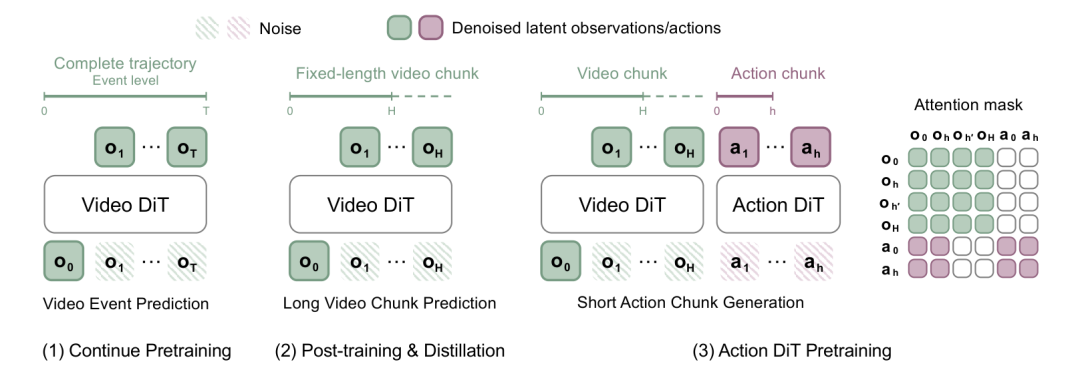
VPP2:三阶段训练流程
在训练阶段,VPP2 分成三个步骤:事件级视频续预训练,固定时域后训练+蒸馏,动作专家训练;前两个主要解决问题一,最后一个解决第二个问题。
第一阶段:只练视频,预测完整事件
有了这样的数据,VPP2 的第一阶段就开始训视频模型。
它做的事是这样的:以子任务为单位,从初始观测一直预测到事件完成。用 49 帧、416×240 的分辨率,跑三万步,批大小 1024,学习率 1e-5,用 flow matching 损失。这一阶段完全不涉及动作。
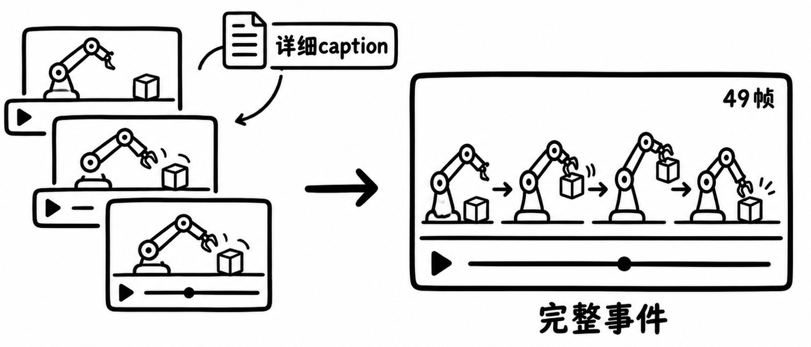
起点和终点被固定下来,指令和视频对上了,再配上详细的 caption,语言到轨迹的映射才能对。
VPP2 自己做了个消融来验证这一点。他们把预测单位从完整事件换成固定时长的片段,其他都不动。结果:
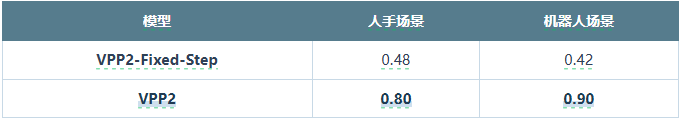
指令遵循成功率直接砍半。
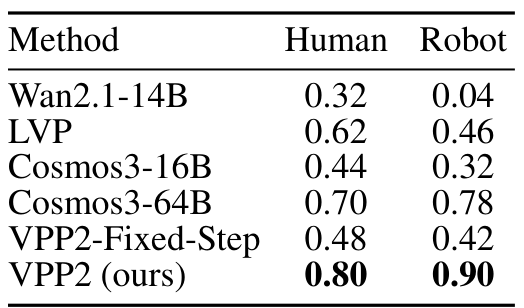
VPP2:视频预测指令遵循成功率
在指令遵循测试中,14B 的 VPP2 也超过了 64B 的 Cosmos 3。这样的收益来源于降低了预测的不确定性。
第二阶段:完整事件带来一个新麻烦
完整事件解决了指令对齐,但它顺手引入了另一个问题。一个 2 秒的事件,和一个 12 秒的事件,拍成同样帧数的视频,帧间隔差了大约 6 倍。同样相邻两帧,在一个视频里是机械臂挪了 1 厘米,在另一个视频里是挪了 6 厘米。视频模型对时间的感觉被拉散了,后面接动作模块的时候,动作没法跟画面上的位移对齐。
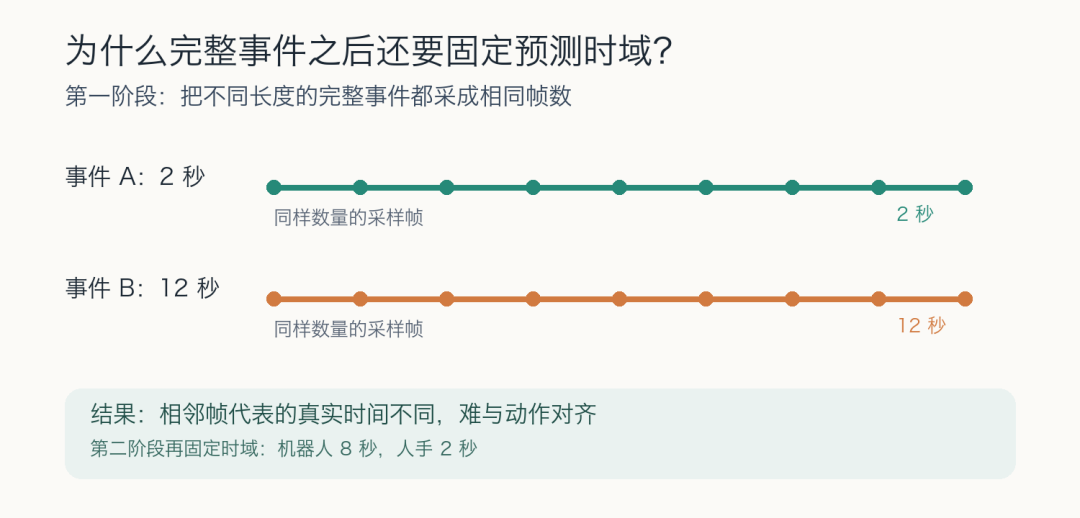
VPP2 的解法是:先享受完整事件的好处,再把时间尺度收回来。
它在第一阶段之后加了一次后训练,把预测时域固定下来:机器人场景 8 秒,人手场景 2 秒。然后用一致性蒸馏(consistency distillation)把这个模型压成单步生成。
原本要走多步去噪的扩散模型,被压到一步就能出结果。原来的推理流程里,视频生成大约 0.12 秒,动作生成大约 0.1 秒(5 步去噪),加起来 0.22 秒。这个速度已经能支撑实时闭环控制了。
这里还有一层隐含的好处:固定了时间尺度,第三阶段的动作学习就有了一个稳定的时间基准。这一步既服务问题一,也提前给问题二铺了路。
第三阶段:先把视频练好,然后冻住
相比一开始就把视频和动作放在一起训练,VPP2 先练好视频,再接入动作专家。动作训练的早期,它冻结视频 DiT 的基础参数,只通过 LoRA 适配视频骨干,避免新初始化的动作模块立刻大幅改动已有表征。
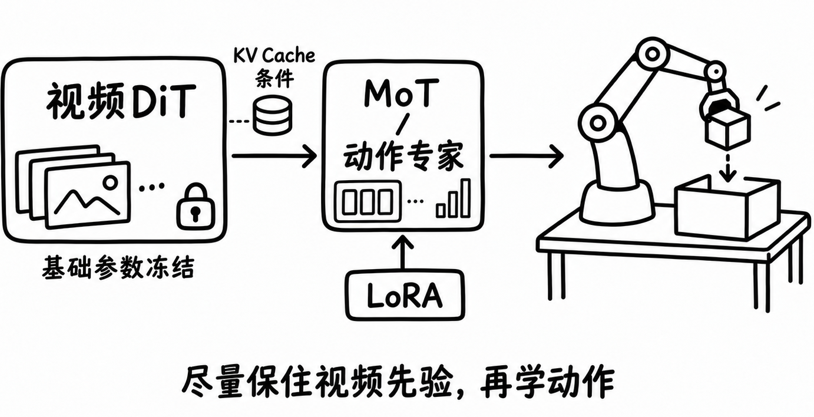
具体做法是,动作专家是一个 0.9B 参数的扩散 Transformer,通过 MoT 架构和视频 DiT 相连。
关键在训练的先后顺序。动作专家是新初始化出来的,一开始参数完全随机,梯度会非常大。如果这时候就让它和视频骨干一起放开训练,这股大梯度会直接冲到视频骨干上去,把刚练好的表征冲乱。
所以 VPP2 在动作训练的早期,冻结视频 DiT 的基础参数,只用 LoRA 去适配它。
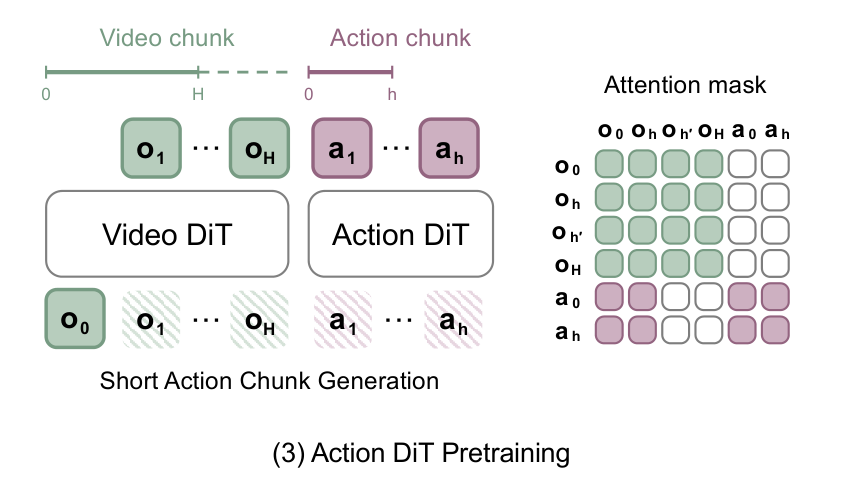
VPP2:视频与动作专家及注意力掩码
还有接口这一层。
动作专家是以视频的 KV Cache 为条件的,没有走那套先把视频渲染成像素、再去读画面的路子。这个设计对应的是隐式逆动力学:模型不需要真的把未来画出来,它只需要读取视频模型内部对未来的那层理解,然后把这层理解翻译成动作。
这样一来,视频模型的功能被限定得很清楚:它只负责提供对未来的预测。动作模块在这份预测的基础上学怎么动。
推理阶段:从人类口语到详细caption,用VLM解决
视频训练与动作训练之外,还有一道部署时的语言接口问题。训练时,视频模型看到的是详细 caption;部署时,人给的常常只是“清理桌面”这样的短指令。问题一在这里还没有完全解决。
VPP2 的解法是配一个 VLM 规划器,做子任务分解和指令增强:把现场的短指令,改写成接近训练时那种详细模板的子任务描述。
这一步和 Seed 加 Seedance 的组合完全同构。用户给一句简短的创意,Seed 先扩写成详细的视频描述,再交给 Seedance 渲染。上层负责把模糊的人类意图翻译成不模糊的语言规划,下层负责把这个规划翻译成画面和动作。
扩写的意义,就是降低未来预测的不确定性。
加上子任务规划后,在 RoboDojo 的五组任务上,平均成功率从 27.6% 提到 57.6%。
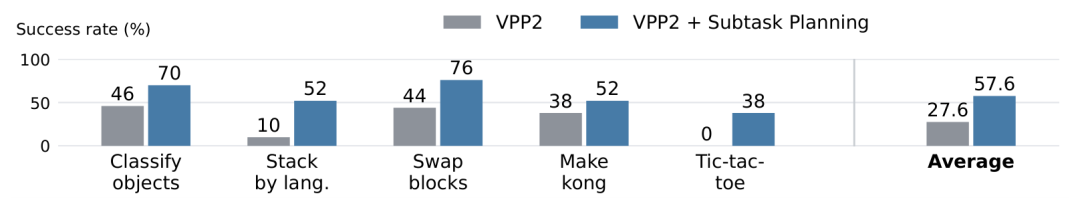
VPP2:VLM 子任务规划前后的成功率
03效果如何:先看视频预测,再看真机与仿真
视频预测:是否真正遵循指令
回到最开始那个现象,视频预测的指令遵循能力。
论文做了一组人工对比。评测用 GPT 打分,另外请人对同一组初始帧、不同指令的预测结果做两两比较,看哪个模型更听指令。五十对一组。
对 Wan2.1-14B,机器人场景下 VPP2 赢 96%,人手场景赢 52%。对 Cosmos3-64B,差距收窄了很多。人手场景 VPP2 赢 28%、平 54%、输 18%;机器人场景赢 24%、平 64%、输 12%。
还有一个很有代表性的场景:把红色纸杯叠到最左边黑色纸杯上,抓最左边的瓶子放到矮杯子前面。这类需要空间理解的复杂指令,VPP2 比两个对手都跟得更准。
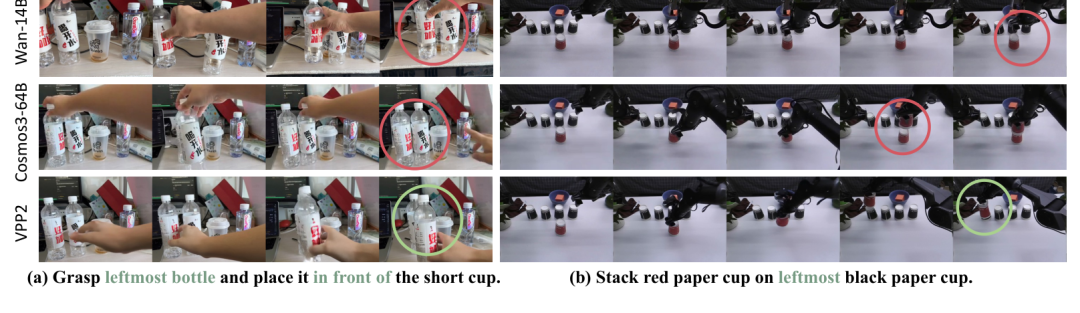
VPP2:与 Wan-14B、Cosmos3-64B 的指令遵循对比
真正有说服力的还是那个官方演示:办公室里随手拍的画面,机器人工作台前随意摆的场景,配上自由选择的指令,模型顺着往下预测。
这件事在 VPP2 之前,几乎没有 WAM 敢做。
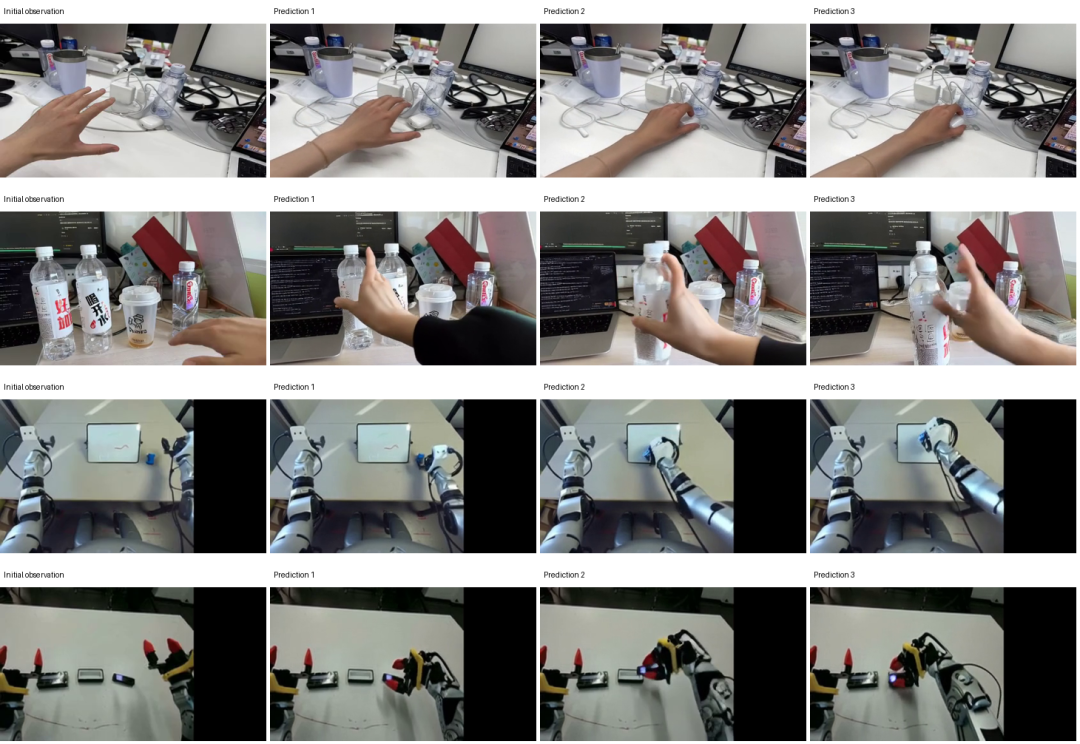
VPP2:官网开放环境视频预测演示
动作表现:真机与仿真
视频预测得再好,最后还是要落到动作上。
VPP2 在真实的 ALOHA 双臂平台上做了零样本测试。10 个任务类别,平均成功率 58.5%。同一条线上,π0.5 是 40.0%,Fast-WAM 是 20.5%。十个类别里,VPP2 在其中九个上表现最好。
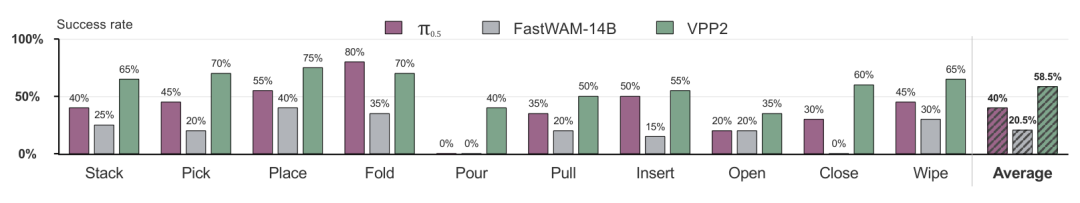
VPP2:ALOHA 真机零样本成功率
在 LIBERO-OOD 上,VPP2 以63.9%,超过了其他benchmark模型。
这块表里还坐着一个很有意思的对手:Temporal Ratio,也就是前面讲过的那篇专门研究视频到动作泛化鸿沟的工作。它的目标是直接冲着这个差距去的,成绩是 59.4%,但 VPP2 仍然高出 4.5 个百分点。
两项工作都关注视频到动作的泛化鸿沟,但处理方式不同:TR 论文在推理时用自适应引导改善组合任务表现;VPP2 先训练操作领域的视频预测,再分阶段接入动作专家。
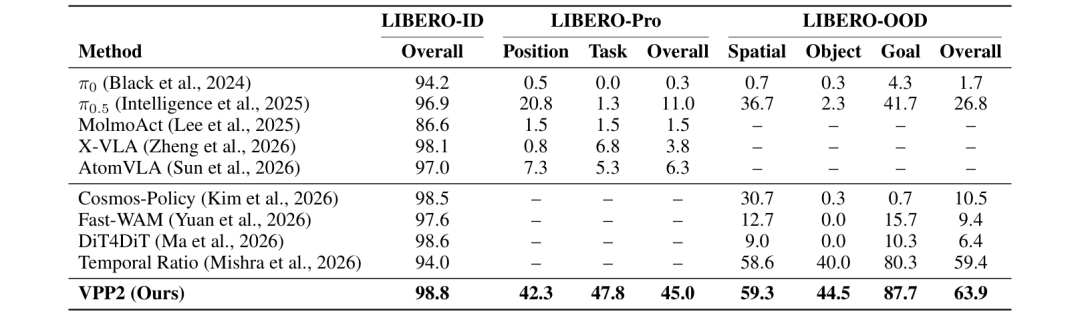
VPP2:LIBERO-ID、LIBERO-Pro 与 LIBERO-OOD 结果
LIBERO-Pro 上,VLA 基线的总体成绩最高只到 11.0%,VPP2 是 45.0%。其中 Task 扰动(同一场景下换指令)这一项,VPP2 拿到 47.8%,而基线最高 6.8%,这检验的就是 VPP2 的指令遵循能力。
在 RoboDojo 上,VPP2 平均分 39.26、成功率 32.26%。对手里,GPT-6-Astra 是 28.97 和 22.48%,Xiaomi-Robotics-1 是 20.07 和 13.93%,OpenWAM-α 是 17.18 和 11.92%,π0.5 是 11.44 和 6.93%。

04写在最后
视觉模型最本质的优势,在众多模型的发布中被淹没了。
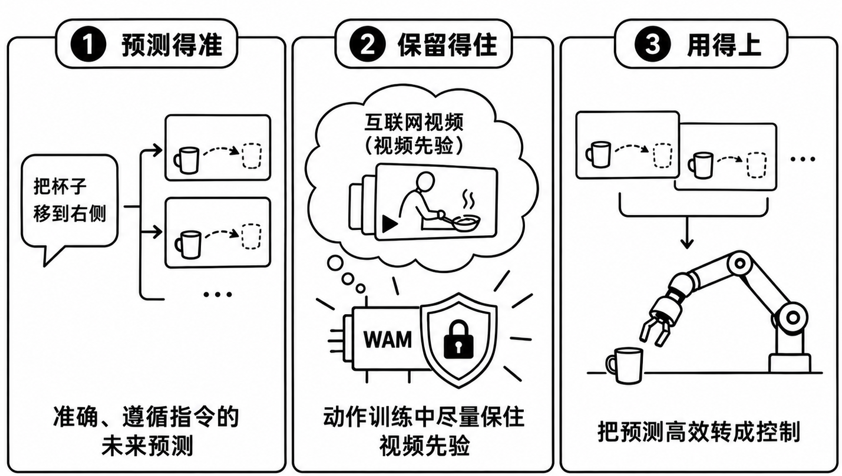
我们回到最初利用视频模型的初心,其实才会发现,真正拉开差距的是三种能力:
第一,能否学到准确且遵循指令的未来预测。
VPP2靠详细caption与完整事件级预训练。
第二,能否在动作训练中保住这些预测能力。
VPP2靠分阶段训练、早期冻结骨干与LoRA。
第三,能否把预测高效地转化成实际控制。
VPP2靠固定时域后训练、一致性蒸馏、0.9B的 MoT动作专家实现了0.22秒的延迟。
谁能保留 WAM 的泛化能力,其实才抓住了世界模型的本质。
后面,我们也与彦江讨论了一些开放的问题:
如果未来出现了更好的开源视频模型,泛化到操作的能力本来就提升了,方法会怎么变化?
彦江的回答是,把它在操作领域做中期训练或者微调,让它在视频预测这件事上达到最好;再想办法加入动作,同时不要破坏它的泛化能力。
在 Astra 这样的上层模型已经足够强的情况下,WAM 的位置在哪里?
未来所有的智能部分,包括记忆/规划/推理等等,都会由 LLM 承担。如果 WAM 能在终局中占据一席之地,它的角色应该是提供某种“条件反射式”的快速响应,要做的就是忠实地follow非常详细的语言指令,完成具体skills。应该要把研究重心往low-level移动,关注交互部分。
上次和彦江讨论时,VPP2 还在成型。如今回听,更能理解他对 WAM 发展脉络的思考。

推荐阅读





×
右键可直接复制图片