 阅读时间大约10分钟以上(5671字)
2026-10-12 具身模型与数据的双螺旋:变中思变
来源:豆包
作者:GGII 出品:高工人形机器人具身大模型追求对新任务、操作环境及物体的零样本(zero-shot)或少样本(few-sh...
作者:GGII 出品:高工人形机器人
具身大模型追求对新任务、操作环境及物体的零样本(zero-shot)或少样本(few-shot)泛化能力。这一追求来自大语言模型和视频生成模型已被验证的范式迁移:高容量架构(如Transformer架构)能够从与任务无关的大规模、多样化数据集中总结经验学习通用模式,并有效地应用于特定任务。
要支撑具身模型的良好泛化,数据集需兼具规模(scale)和广度(breadth):涵盖多种任务和场景(a variety of tasks and settings),同时,数据集中的任务需具备强关联性(well-connected)以支撑泛化,使模型能够发现结构相似任务间的内在规律,并通过创新性组合完成新任务。
以上提法来自RT-1(谷歌DeepMind,2022年10月),为此,RT-1的训练数据集包含约13万段示例和超过700个任务。
RT-1架构和数据集
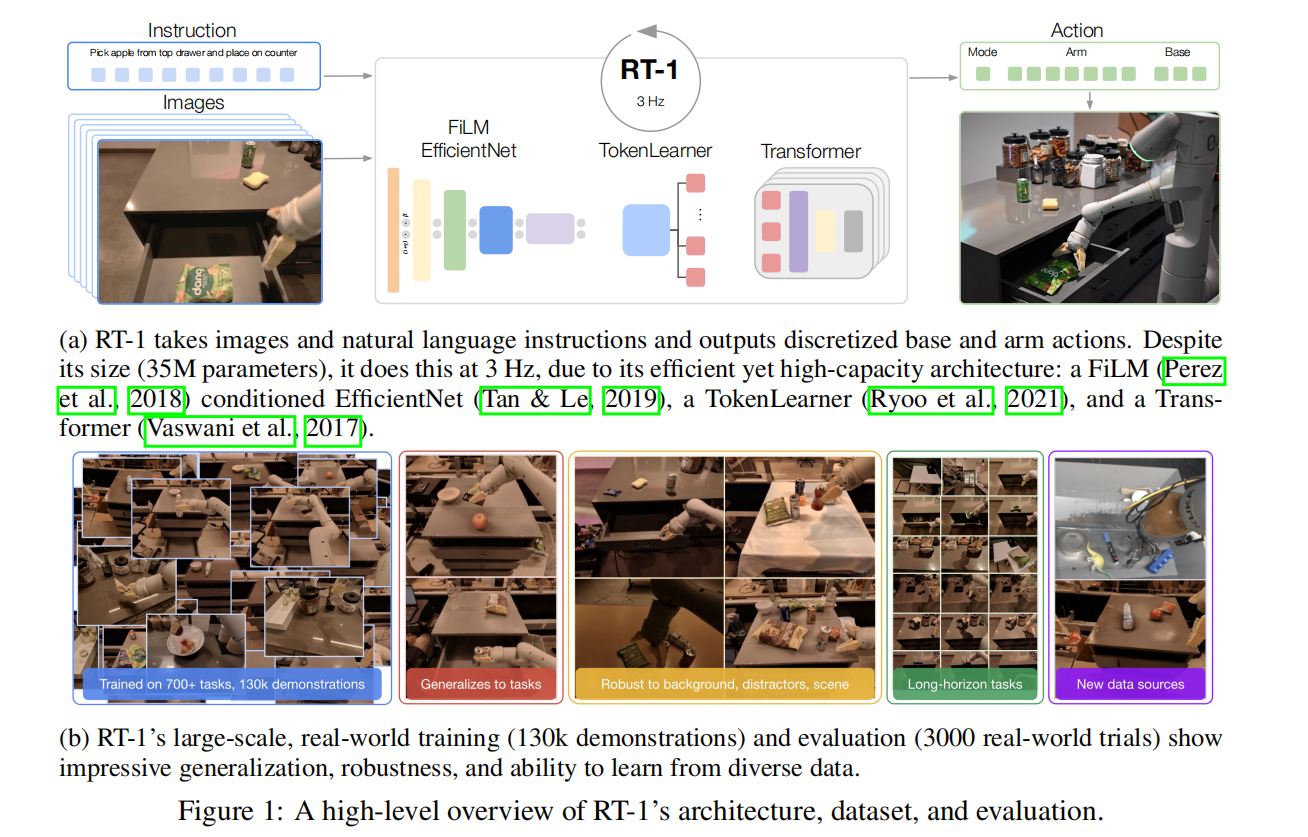
更关键的是RT-1的消融实验发现数据多样性比数据量更重要:压缩25%的任务种类、保留97%的数据量,泛化能力的下降程度,竟等同于直接砍掉49%的总数据量。
这也埋下了一个持续到今天的命题——数据从哪来,以及怎么来得又快又多样又便宜,而模型要回答的是数据怎么用以及什么是有用的数据,两者虽有分工但更需合力。
VLA范式确立,遥操作数据奠定基础
2022年11月,ChatGPT点燃了AI革命。次年7月,RT-2(谷歌DeepMind)引入视觉-语言模型能力,确立了具身智能的VLA范式(视觉-语言-动作)。RT-2通过联合微调互联网规模的图文数据与机器人轨迹数据,增强机器人的语义理解和推理能力,实现了更强泛化。
此后RT-X联合34家实验室开源了跨机器人数据集OpenX-Embodiment(OXE),当时被称作“机器人的ImageNet时刻”——基于它训练的RT-1-X平均性能提升50%,RT-2-X的涌现能力是原版RT-2的3倍。
再到π0(PI)、π0.5(PI)、Helix1.0(Figure AI),其中π0采用1万+小时遥操数据,π0.5采用了400+h多环境异构数据,通过co-training融合多源异构任务与监督信号,用于跨环境泛化、跨结构迁移,提升机器人在真实开放场景中的迁移能力,两大模型先后开源。
OpenX-Embodiment(OXE)数据集结构
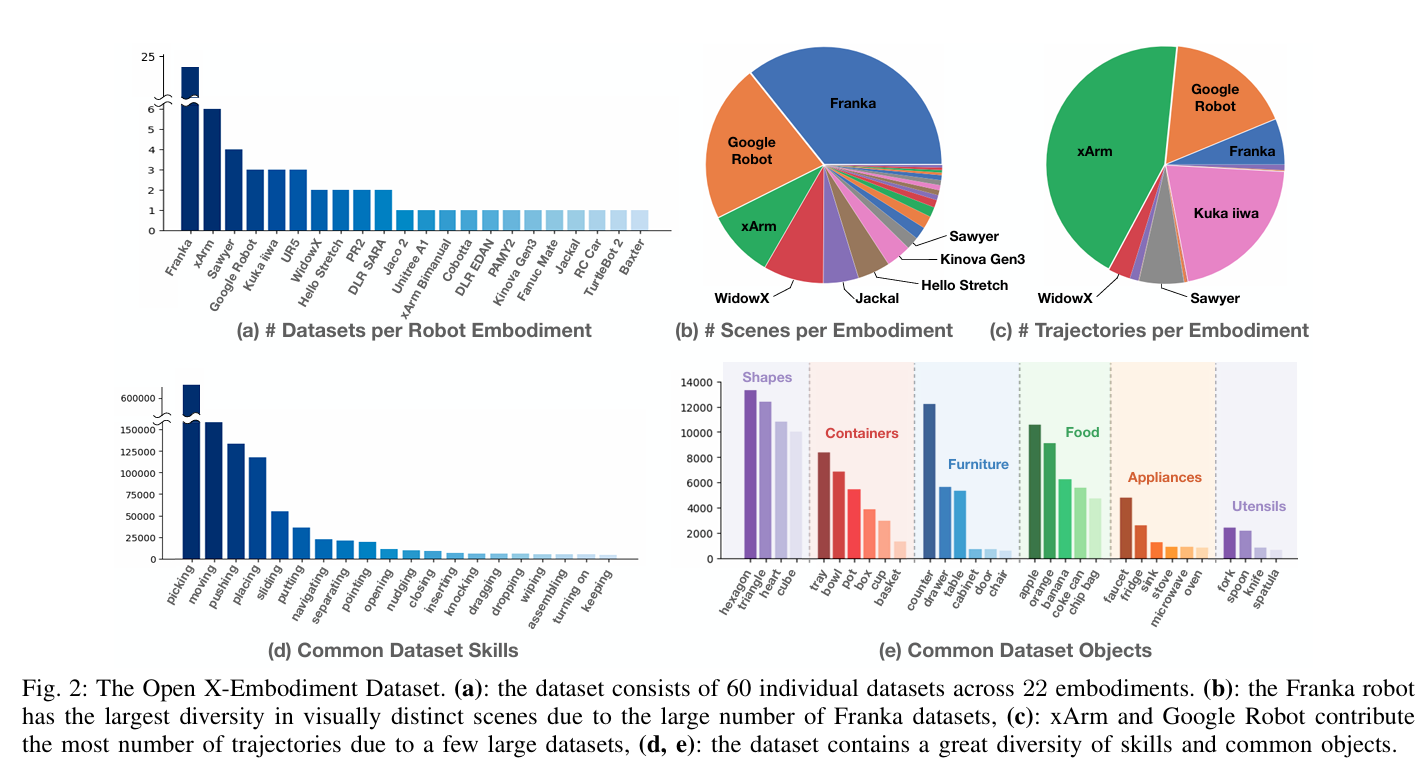
在这一阶段,机器人训练数据以真机遥操为主,且以单臂操作为主,开源数据集与开源模型都建立在真机遥操数据之上。
随着模型能力沿着单臂操作(single-arm manipulation)、双臂操作(bimanual manipulation)、移动操作(locomanipulation)到全身操作(whole-body manipulation)的方向演进,研究者首先遇到的不是模型结构问题,而是数据从哪里来、模型怎么学的问题。
低成本双臂遥操设备与人形机器人成为更好的数采工具。Aloha和GELLO提供了低成本、双臂遥操方案。如Aloha成本低于2万美元,将所有硬件设计全部开源,并推出移动遥操方案Mobile ALOHA。自2023年下半年起,宇树科技、智元机器人等相继发布人形机器人,成为新的科研平台选项。
2024年9月,智元机器人自建了行业第一个数据采集工厂。2025年3月28日,北京首家数采中心石景山首钢园揭牌启用,我国数据采集与训练中心进入建设快车道,推动真机遥操数据生产规模化。但数采厂搭建的场景有限,为采集真实、多样的环境数据,遥操作开始走出采集厂,走向真实商超、家庭等场景。
但真机遥操依赖人工采集,昂贵且缓慢,多样性天然不足。当模型架构趋于一致,数据枯竭(Data Scarity)成了最大瓶颈。
仿真合成数据,卡位多个角色
被动采数据不够,就主动“造”数据。仿真合成数据可大规模高效生成、数据自带完美标注,能够弥补真实世界数据的匮乏,叠加物理引擎的进步,仿真从“辅助训练工具”变成“数据扩增主战场”。
RT-1证明了仿真数据可用于扩充任务多样性、补充长尾任务,2023年,MimicGen、GenSim分别从轨迹扩增、任务扩增两方面验证仿真数据的有效性,2024年,RoboTwin将仿真数据与双臂操作场景结合,同时发布评测基准,并于次年6月升级,通过多模态大模型、领域随机化、硬件适配机制,从源头提升仿真数据质量,缩小Sim2Real Gap。
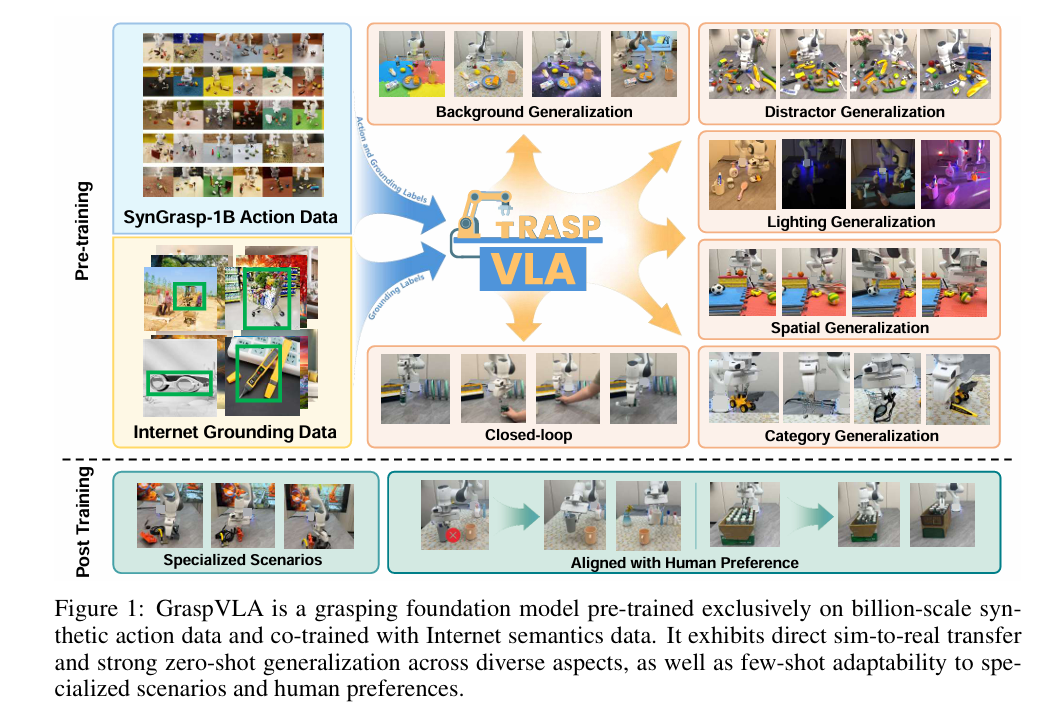
银河通用于2025年1月发布全球首个预训练基于仿真合成大数据的具身抓取基础大模型GraspVLA,成为我国首个估值突破200亿元的具身智能企业。
GraspVLA训练过程
但这条路的软肋同样明显:Sim2Real Gap(仿真到现实的鸿沟)。仿真刷榜接近满分,真机却未必复现。2026年4月,斯坦福HAI发布的《Al Index Report 2026》揭示了这一残酷现状:机器人操控在仿真环境中的成功率高达89.4%,但在真实家庭场景中骤降至12%。而机器人始终要在真实物理环境中稳定完成操作任务。
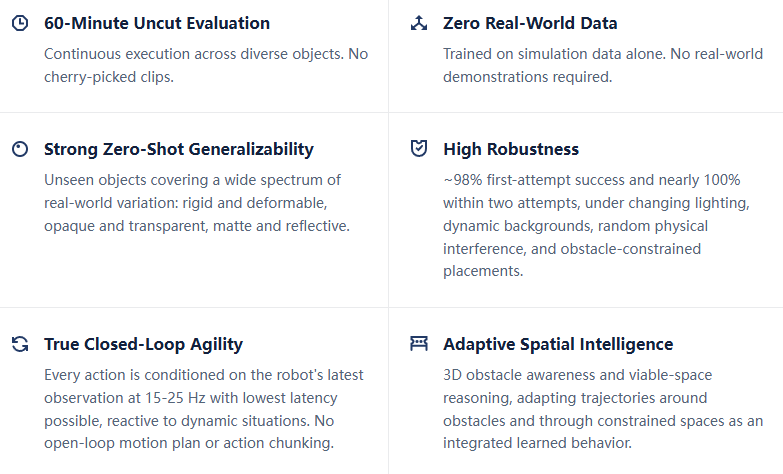
仿真数据的有效性建立在高保真仿真器之上。2026年初,由于Sim2Real Gap,仿真路线一度被质疑。但4月20日,苏度科技Sudo R1以纯仿真训练后的通用抓取又将仿真拉回行业视野。其数据体系即建立在高保真仿真器之上,采用以仿真数据驱动的Sim2Real技术路径,通过世界模型+强化学习,实现低真实数据依赖下的规模化训练与泛化能力提升。在产业侧,其已与宁德时代等开展联合开发,围绕电池生产与物流环节推进具身智能落地验证,模型在zero-shot下即可部署,无需采集客户敏感数据。
苏度科技sudo R1 关键成果
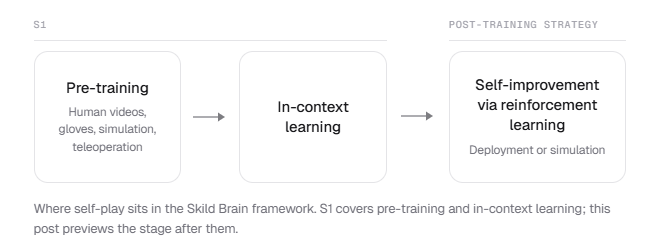
仿真为后训练强化学习提供安全可控的大规模并行探索环境。从人类数据中预训练出的模型能力难以超越人类,强化学习允许智能体通过试错来发现更优解,而仿真能够提供可交互、大规模并行探索环境。2026年8月25日,Skild S1后训练中的Physical Self-Play,在NVIDIA Isaac Sim里和近期版本的自己对抗。每一次能力提升,都会变成下一轮训练里的新压力。模型从一开始连走路都不稳,经过模拟中的“140年”长期对抗后,逐渐学会了起身、带球、护球、抢断等能力。
Skild S1 训练策略
虽然仿真合成数据存疑,但仿真测评始终处于重要地位。真机验证,成本高、风险大,仿真环境评测就成为主要的模型测评方式。如LIBERO、RoboTwin2.0、RoboDojo-Sim等均为仿真评测。
UMI:低成本撬动人类操作数据的折中方案
真机数据贵且慢且跨本体困难,人类作为机器人最好的“老师”,但存在embodiment gap,包括运动学差异、外观差异和视角差异,尤其是是人手,虽然有些灵巧手形状相近,但功能不匹配,人手数据依然难以迁移。此时UMI作为折中方案出现。
斯坦福大学等于2024年2月提出UMI夹爪方案,成本低至400美元,并开源相关硬件图纸。并于次年5月进一步拓展至灵巧手训练,提出DexUMI。
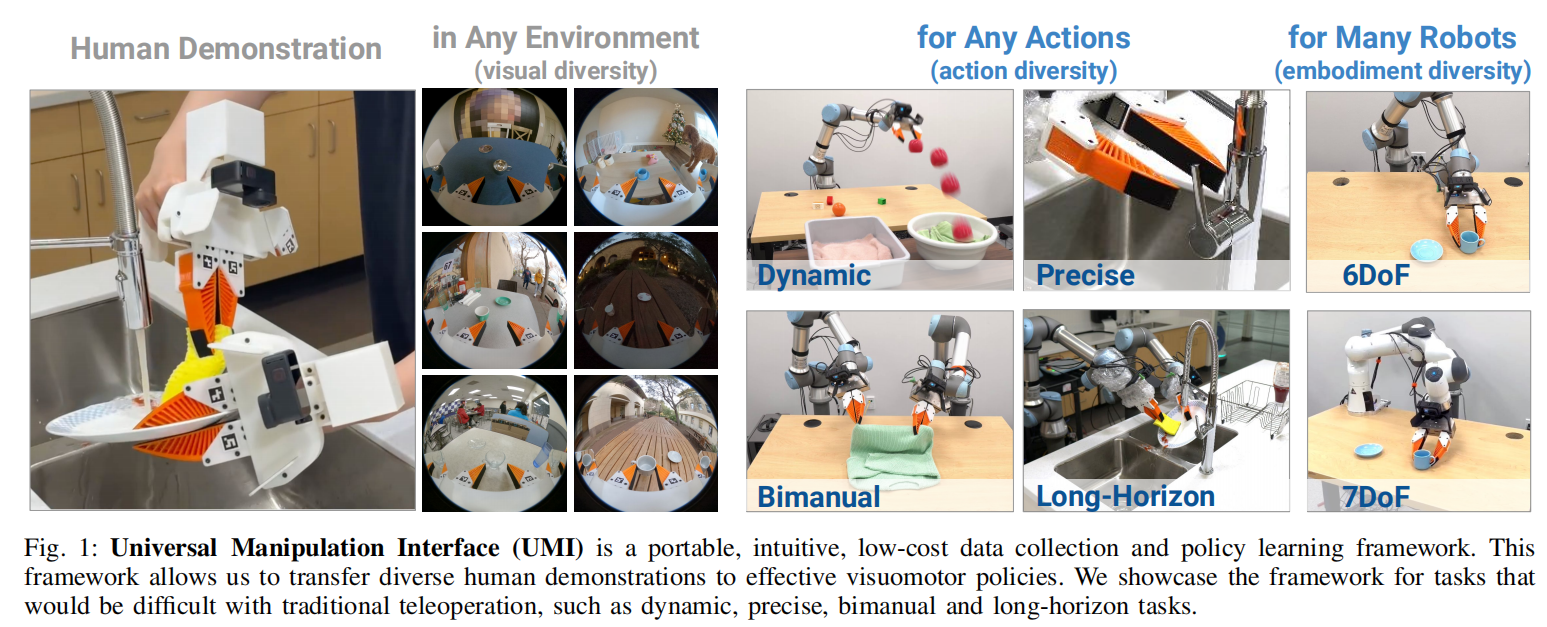
这条路线在2025年底、2026年初被大规模验证:
GEN-0(Generalist AI)在27万小时人类操作视频数据上完成训练,首次在机器人领域验证了ScalingLaw的存在。
GEN-1预训练数据量达50万小时,在以往模型成功率仅为64%的任务上,将平均成功率提升至99%,且每项成果仅需1小时的机器人数据。
Sunday Robotics从Data-First(数据优先)出发,先开发极致好用的三指数据采集手套、积累海量真实世界数据,再反向设计出与手套运动学一致的机器人Memo,手套数据无需映射可直接迁移使用。在从餐桌到洗碗机的完整家务链任务中,Memo完成了33次独特灵巧互动、68次总互动事件、跨越超过130英尺的自主导航,展现了AC-1整套全栈系统独立实现长时序移动操控、未知家庭场景泛化、高精度灵巧操作三大能力。
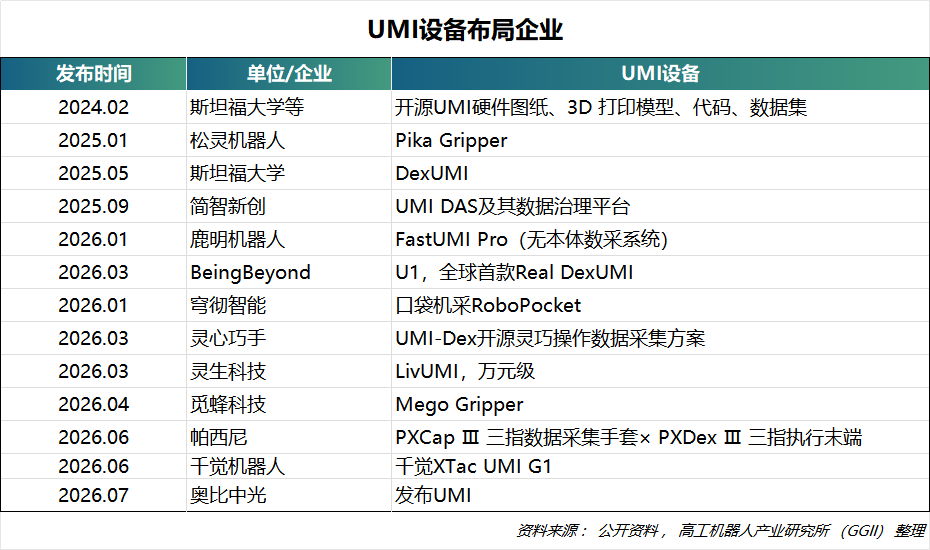
UMI设备让“以人为中心”的具身数据采集第一次具备了工程化与规模化的双重可能性。其将末端执行器与本体解耦,降低了采集门槛和采集成本,提升了采集效率,场景拓展性较强,但目前UMI设备方案多数围绕平行夹爪展开,采集数据无法迁移到多指灵巧手,难以满足高阶灵巧操作需求。已有部分企业针对灵巧手推出UMI解决方案,但仍有待验证。
Ego视频:规模化潜能与Scaling Law
人类视频尤其是第一视角的人类视频是实现可拓展性(scalability)的理想数据源,不仅是规模的拓展,更重要的是多场景、多任务的拓展,但如上文所说,存在embodiment gap的问题。
行业一直在证明Ego视频的有效性和解决embodiment gap的问题:
2024年10月,EgoMimic证明第一视角人类视频不仅能辅助、甚至能替代昂贵的遥操数据,实现更强的泛化能力;2025年,EgoBridge通过最优传输(OT)和动态时间规整(DTW)技术,弥合人类与机器人之间的跨域差距;EMMA则进一步拓展到移动操作场景。
直到2026年初,Egoscale(英伟达)在2万小时Ego视频上预训练,让22自由度灵巧手平均成功率提升54%,引爆了Ego视频数据采集热潮。
Dyna-2(Dyna Robotics)将这一验证规模拓展至100万小时,其验证了:WMA模型存在一条百万小时、尚未见到平台期的规模化定律;“人类→机器人”的迁移规模化定律,人类数据越多,模型在从未见过的机器人数据上的离线预测就越准;未经标注的视频可提升跨本体泛化。GPT6-Astra、Helix2.5均基于Ego视频数据预训练。
Ego视频行业初期以消费级设备采集为主,如Gopro、智能手机、VR头显等,成本低,但传感器同步采集精度和视场角受限。专业的Ego采集设备主要为头戴式,简单的采用双目相机和IMU,复杂的除第一视角外,还会环形布局多个相机采集环境数据。布局企业包括独立数据服务商以及大模型企业、视觉等零部件延伸企业。
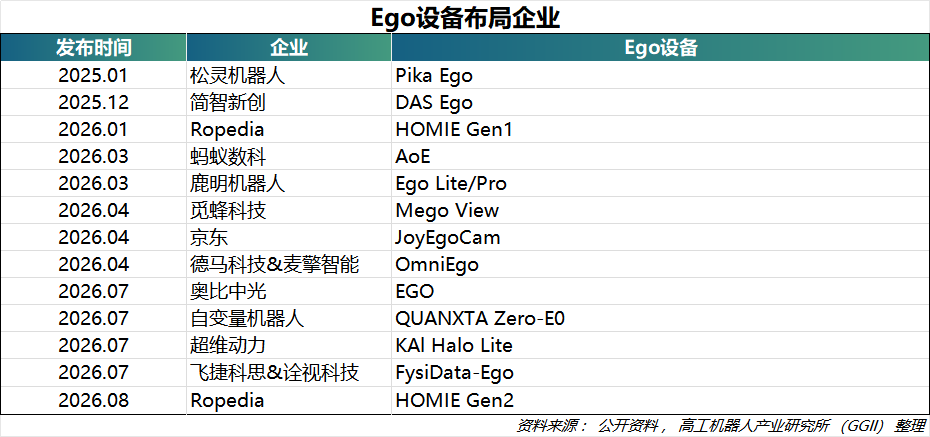
Ego视频为机器人提供了大量的先验知识,但模态相对单一,没有包含深度、关节驱动力、触觉等信息,在关节重映射时会损失部分精度,难以满足Zero-shot。如Egoscale在中训练中增加50小时manus手部姿态+Vive腕部姿态和4h机器人数据对齐动作,后训练中采用特定任务的机器人演示;GPT6-Astra(OpenAI)虽然在泛化性上领先,但是难以实现精细操作和长程任务。
触觉数采手套:灵巧操作的触觉采集
灵巧操作已成为机器人落地的一大卡点。灵巧手是最泛化的末端形态,叠加技术进步、价格下降,手脑协同亦成为研究热点。直驱灵巧手由于算法友好成为2026年灵巧手企业的布局重点。在灵巧操作中的高接触密度任务中,视觉已难以满足应用需求,尤其在遮挡、微小形变等场景,触觉数据被认为是实现最后一毫米精细操作的关键。
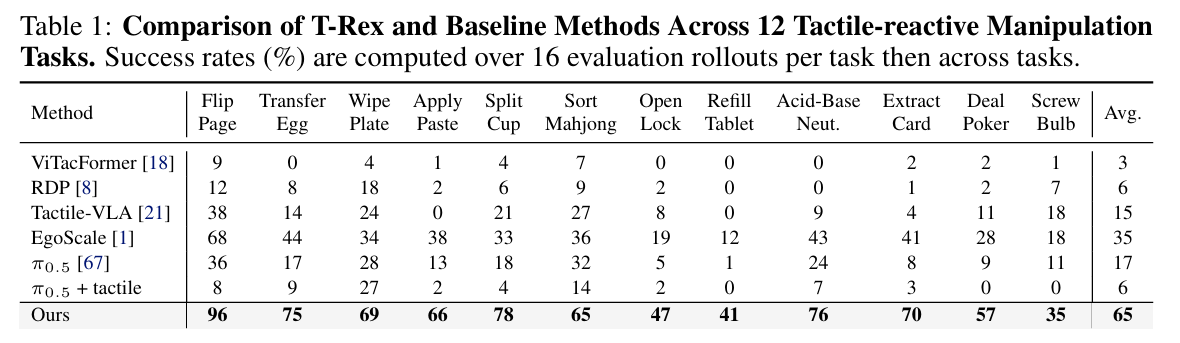
今年6月份,李飞飞联手Jim Fan等34人发表的T-Rex中,加入触觉训练后的T-Rex任务成功率,从只有手部动作没有触觉训练的EgoScale的35%提升至65%,给怎么用好触觉提供了一份参考。
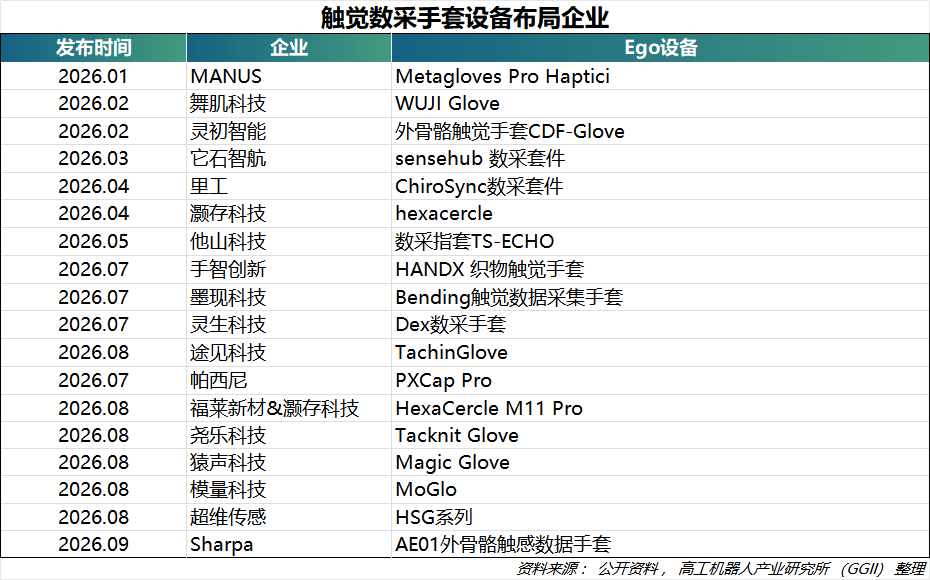
如何采集触觉已成为市场热点和难点。触觉传感器和灵巧手厂家的布局重点是数采手套。但触觉数采手套存在传感器漂移和重复性差等问题,叠加材料自身形变产生噪声信号。
从VLA到世界模型:挖掘数据价值,构建自进化闭环
VLA模型学的是“输入图像+语言→输出动作”的统计相关性,依赖海量的“语言-视觉-动作”成对数据,但大千世界,不可能把所有操作数据喂给机器人,VLA模型的泛化性受限。
2024年,视频生成模型SORA(OpenAI)、Genie 1(Google DeepMind)相继发布。行业开始思考这些模型在生成逼真视频的过程中,怎么学习空间结构、物理规律,预测下一步状态并生成动作,从而成为机器人的底层世界模型。
根据输出的结果,李飞飞将世界模型分为渲染器(像素)、模拟器(状态)和规划器(动作)。其中模拟器希望绕开真机数据增加数据来源,减少仿真数据sim2real Gap,并可提供具身智能训练评测环境;规划器是希望充分利用无标签数据、降低训练数据体量,从多样性的规模数据中学习物理规律。
模拟器中,世界模型使用文本/图像输入快速创建大量视觉风格各异的训练环境,为域随机化提供了丰富的素材;且生成场景符合物理规律,但在高速碰撞、精密装配、长时间稳定接触、多指灵巧手精细触觉交互,世界模型稳定性弱于成熟的仿真物理引擎,一般与之配合使用。NVIDIA Cosmos与英伟达Omniverse配合使用,能够进一步缩小仿真与训练之间的差距。World Labs收购仿真公司SceniX,随后公开real-to-sim-to-real(R2S2R)引擎,并宣布其策略完全在仿真中训练、零真实世界数据,然后直接迁移到真机上执行。
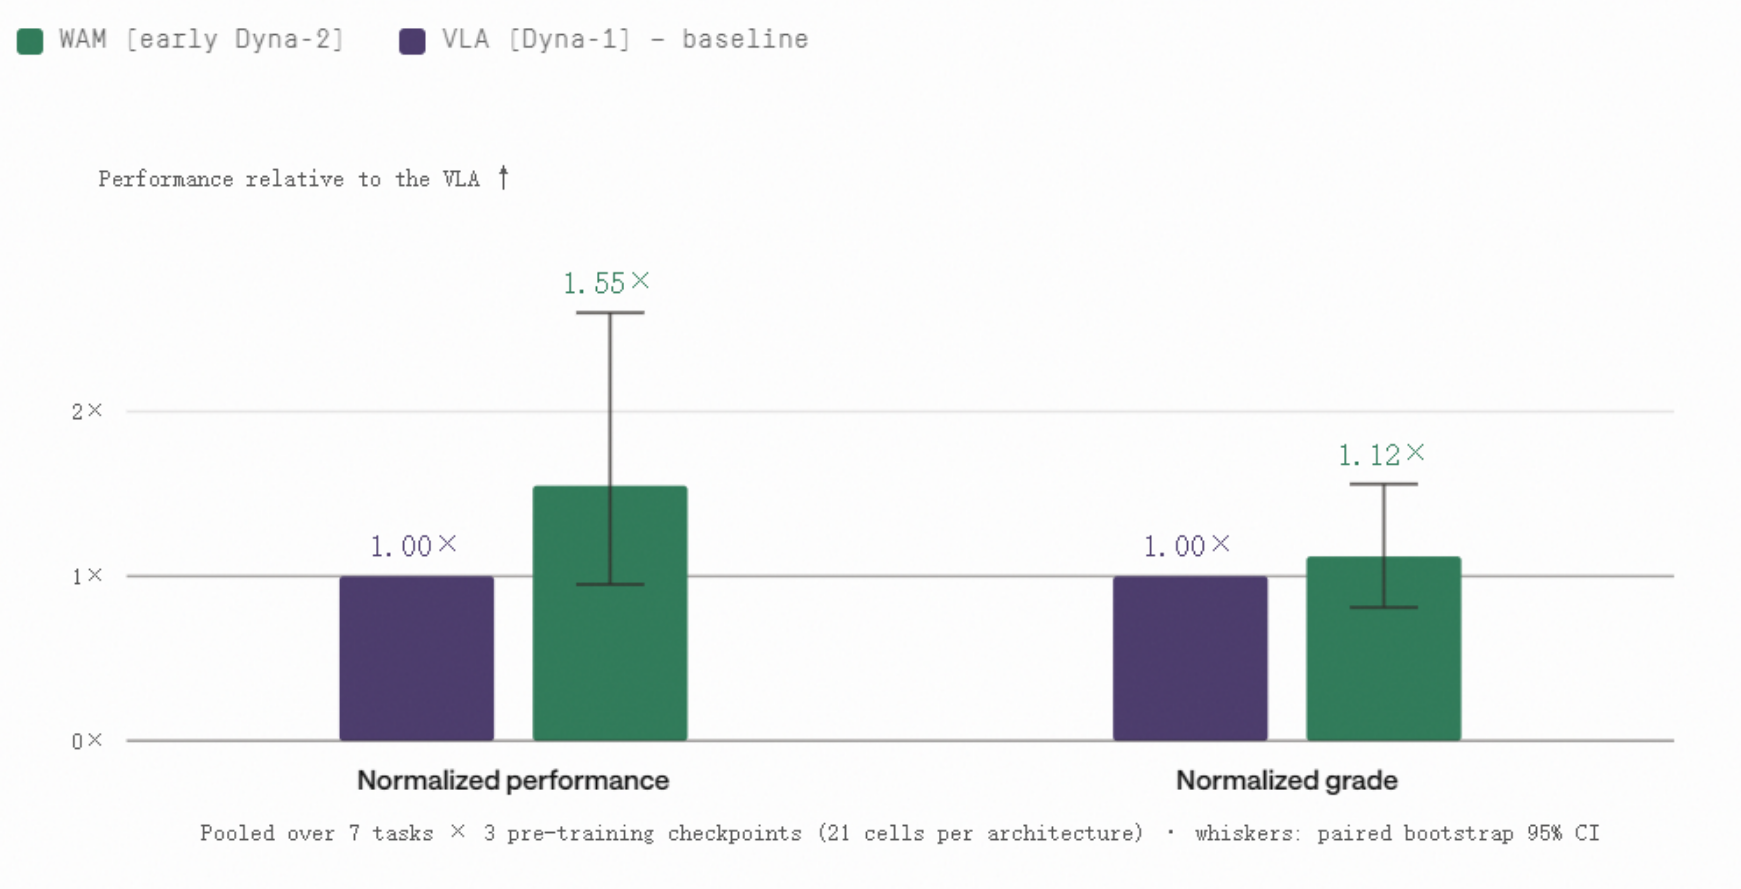
在规划器中,世界模型通过“想象未来”来评估动作的预期后果,从而优化控制策略。根据是否生成未来画面,分为隐式世界模型和显式世界模型,其中隐式世界模型的代表为杨立昆的JEPA(联合嵌入预测架构)。在同等训练数据下,WAM Dyna-2(早期)达到VLA Dyna-1成功率的1.55倍、评分的1.12倍,并能产出更高质量的成品、以及在极端干扰条件下维持作业方面都好得多。
相比VLA的模仿学习以成功操作为主,失败数据为世界模型走向真实安全可用补上关键一环。失败数据让模型看见接触、摩擦、重心、形变、扰动和反馈之间真实而复杂的关系。从这些关系中,机器人开始理解世界。π0.7(PI)是VLA与WAM的融合模型,构建了一套适配实体机器人运行规律的专属错题知识库,为机器人的物理行为划定清晰的安全与操作边界。智元的开源数据集AGIBOT WORLD 2026以“多样交互(Rich Interaction)”为主题,公开聚焦物理交互、记录“意料之外”的数据。
自进化闭环成为具身模型的研究方向之一。VLA通过强化学习等方式实现自进化,如π*0.6的RECAP,真机online RL通过融合人类示范、自主执行经验、专家实时纠偏,实现自我进化。世界模型则通过承担策略、模拟器或评估器等角色成为闭环的关键。英伟达中世界模型(DreamDojo)预测世界,policy(DreamZero)产生动作,Agent负责规划和评估。GigaBrain-0.7(极佳视界)System 1以VLA生成连续未来动作,System 2以VLM理解物理常识、因果关系并完成高层规划,System 3则引入通用世界价值模型,对未来世界及动作价值进行预测,再结合在线强化学习形成持续自进化闭环。生数科技Motus2同时承担策略、模拟器和评估器,形成“生成动作→预测未来→评估结果→更新策略”的闭环自进化迭代。
英伟达世界模型的自进化闭环
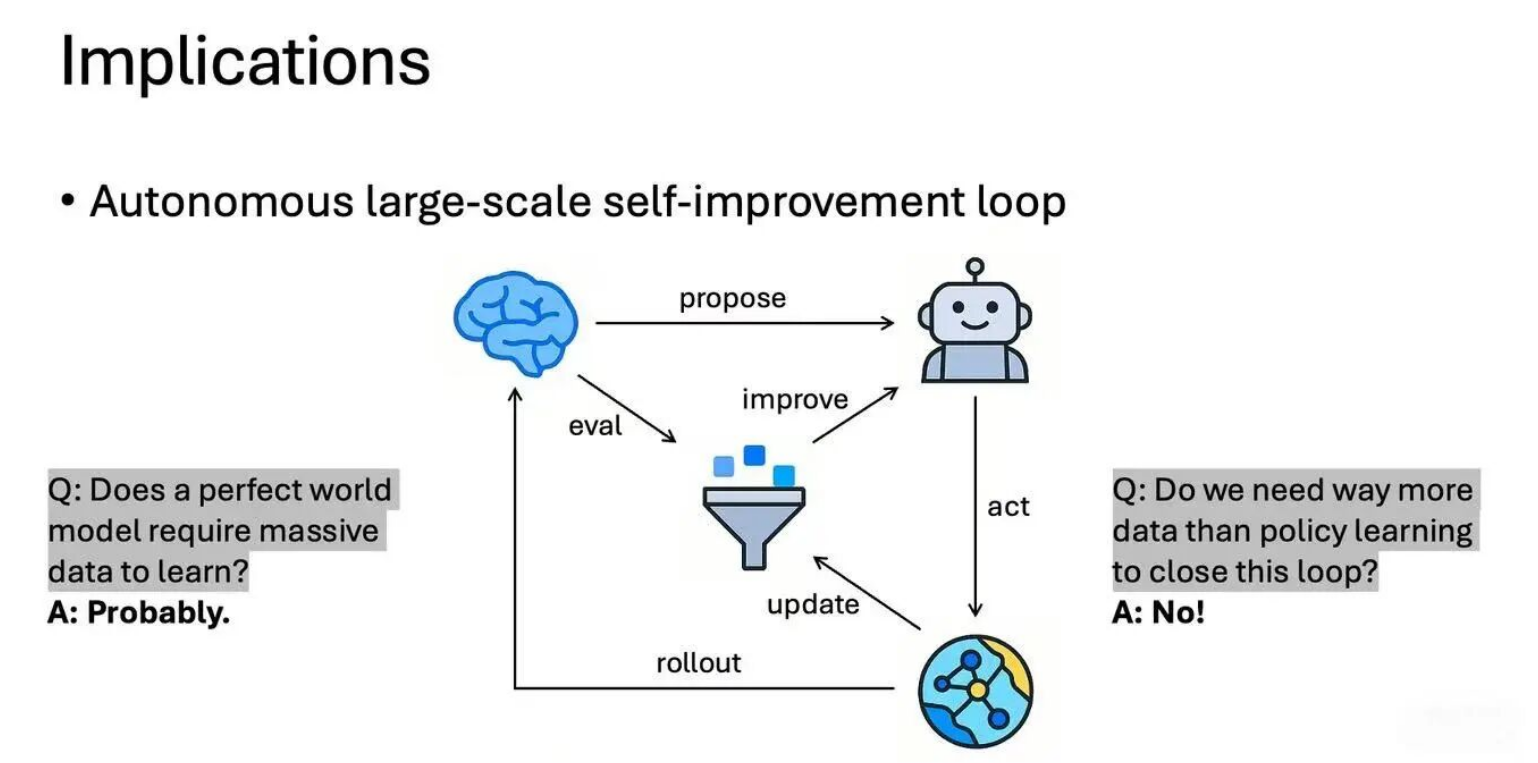
图中大脑代表 agent,机器人代表 policy,地球代表世界模型,中间是数据集。
但是目前世界模型的训练、推理算力开销较大,推理时延高,难以满足真机实时控制要求。如Dream Zero推理速度7HZ但计算硬件的成本高达15万美元。AMD宣布拟以约82亿美元的全股票交易收购World Labs,即希望通过模型研究理解未来计算需求,影响硬件、软件与系统设计。
多源并存的具身数据体系,高质量、高效率数据管线是竞争的关键
目前来看,不同数据路线将在不同训练阶段长期并存,未来的具身智能数据体系,将是多源并存、按任务分层、按阶段取舍,大模型企业根据自身技术能力与业务需求调整数据配方(Data Recipe)。GROOT N1(英伟达)提出“数据金字塔”概念(视频+仿真+遥操);智元GO-1采用ViLLA架构,把互联网图文、人类操作视频与真机数据分层使用。
海量Ego视频数据负责为模型注入通用的物理常识与交互先验;
UMI数据、数据采集手套等穿戴式设备则为模型增强通用的动作理解能力;
仿真合成负责有效数据扩增、corner case模拟训练、后训练强化学习,提升模型的泛化能力和鲁棒性;
真机数据,负责完成具身对齐与下游任务微调。
在机器人大规模部署时,产生的真机数据可以回流反哺模型迭代,而这部分真实场景的交互数据往往被认为是真正的护城河。
模型在变,数据采集方式在变,但核心竞争力始终是根据模型需求动态调配数据配方的工程与组织能力——包括数采设备的系统级标定、毫秒级时间戳对齐,以及数据采集的组织运营能力、数据清洗标注的自动化程度,以及模型的快速验证反馈。
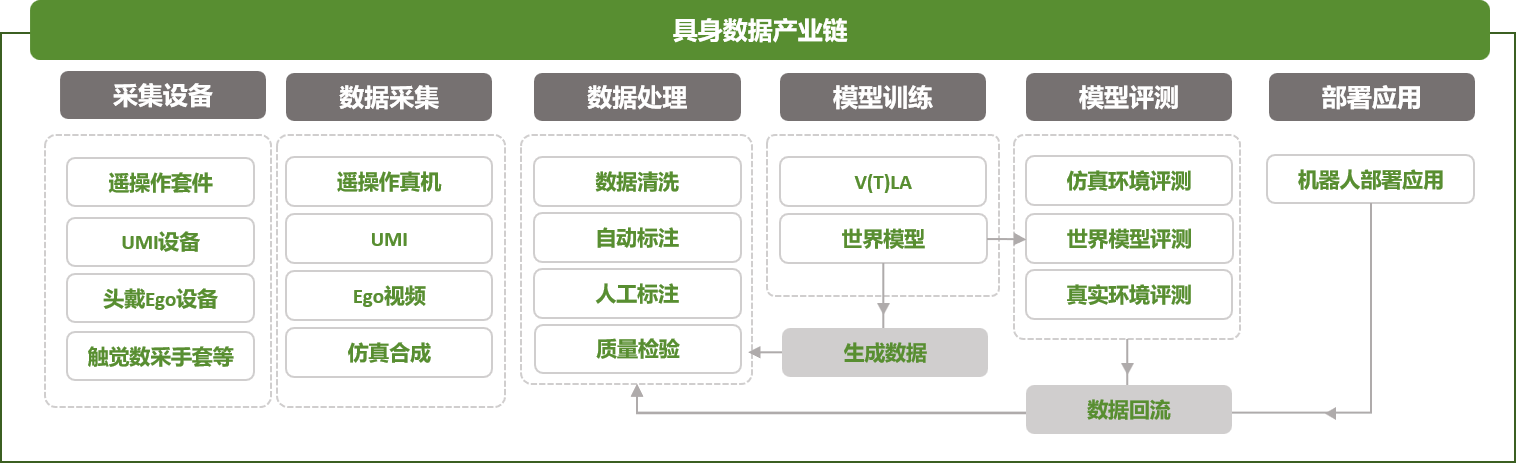
数据采集设备不是简单的传感器拼装,其核心难点是产品的系统级设计,全套标定参数以及多模态信息采集传感器之间的毫秒级时间戳对齐,以保证采集设备的可靠性,以及采集回的数据稳定性、可复现性以及可用性。
数据采集环节主要包括采集任务定义、场景搭建/租赁、人员培训、数据采集,在此过程中,需要进行项目计划制定、进度跟踪、人员调度、风险预案制定等。核心竞争力在于对模型数据需求的理解及采集任务定义、场景资源的获取以及组织运营能力(标准化(SOP)管控能力)。
数据处理环节包括对采集来的数据进行清洗、标注、质量检验(QA)。该环节的自动化程度是未来竞争的关键。尤其是无本体数据采集门槛降低之后,数据处理难题随之放大,海量、多模态、高对齐精度要求都是对人工标注的挑战。借助AI技术,部分企业已推出自动标注管线。
模型是数据的应用端,以终为始,数据有哪些问题、哪些是好的数据还是需要模型端来评价,验证反馈越快,这个数据飞轮转的越快,具身智能性能提升的速度越快。
不过,数据价值的验证是长周期、复杂且没有标准的过程,所以数据服务就有浑水摸鱼的空间。但是这个空间正在被快速压缩,当数据企业的工程组织能力、数据质量难以跟上模型需求时,只有被抛弃。
8月25日,美国机器人公司Figure AI正式发布Index项目,自建数据管线。其此前曾尝试向第三方数据供应商购买数据,但发现“供应商提供的数据在吞吐量、多样性和质量上都无法满足Helix模型的需求”。
写在最后
模型和数据共同决定智能的高度。
数据价值要通过模型来挖掘和验证,模型能力要通过数据规模、质量和结构来提升。
具身智能行业仍处于发展早期,未来不管模型架构如何创新,数采方式如何变化,真正的壁垒在于“数据-模型”的双螺旋的持续迭代升级以及在这个过程中沉淀的工程组织能力。
最终要形成的是“数据、模型、硬件与场景”的产业闭环,当然这就是更大的课题了。

推荐阅读





×
右键可直接复制图片