 阅读时间大约8分钟(2849字)
2026-10-13 具身智能自我进化新范式:人大&清华RoboHarn-Evo,双层循环驱动分层物理知识,让机器人不调参也能持续变强
来源:豆包
作者:Lingshu 出品:具身智能观察室引言视觉-语言模型(VLM)虽已展现出长程机器人操作任务的协调规划能力,但其任务推理...
作者:Lingshu 出品:具身智能观察室
引言
视觉-语言模型(VLM)虽已展现出长程机器人操作任务的协调规划能力,但其任务推理的有效性本质上受限于局部物理交互能否产生预期效果——这一“语义规划”与“物理落地”之间的鸿沟,是具身智能走向通用化的核心瓶颈。现有范式或依赖微调更新基座模型,代价高昂且泛化受限,或缺乏将交互经验结构化沉淀的机制。
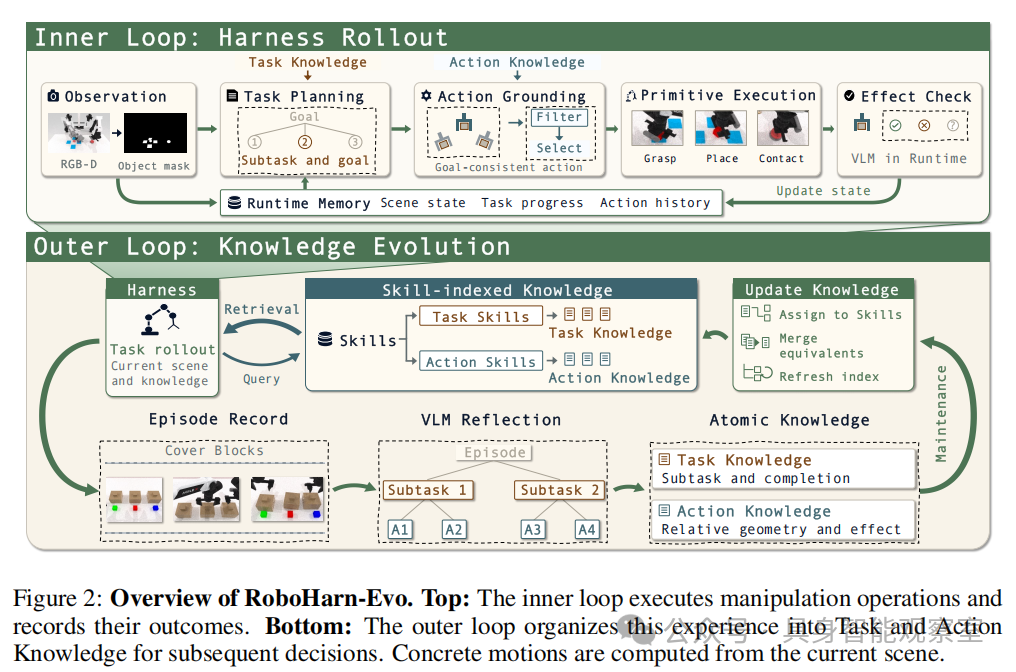
针对这一问题,中国人民大学与清华大学等联合团队提出RoboHarn-Evo双循环框架,在不更新基座模型的前提下,通过反复物理交互自主演化分层物理知识(Hierarchical Physical Knowledge, HPK)。其核心创新在于构建了任务知识(Task Knowledge)与动作知识(Action Knowledge)双层可复用知识体系:前者刻画子任务调度与完成判据,后者编码对象相对的几何策略及其物理效应,并在执行时于对应决策层级检索、在任务目标约束下完成场景具身化。跨回合的物理反馈驱动历史知识修订、适用性更新与条目重组,形成经验到知识的闭环积累。
一、研究现状与动机
近年来,具身智能体日益广泛地利用执行反馈实现在线适应(Online Adaptation),并进一步将交互经验沉淀为持久记忆、可复用技能或运行时演化组件,代表性工作包括 RoboHarness、Harness VLA、PhysMem、EmbodiSkill 等。
然而,如何将累积经验可靠地转化为后续行为的改进,仍面临本质性挑战:在操作任务中,局部动作的成功并不必然蕴含子任务的完成。例如,机器人可能正确抓取目标却将盖子释放至错误位姿,或在当前子任务完成判据尚未满足时过早切换至下一子任务。
这种“动作效应”与“任务完成”之间的语义错位,使得单一粒度的知识更新难以同时保障规划的语义正确性与执行的物理精度。已有层级化技能表示方法(如 SkillNet、XSkill、SkillPyramid)多聚焦于技能组合与泛化,却未在知识层面显式区分任务级完成判据与动作级物理效应。
RoboHarn-Evo 正是立足这一动机,将物理反馈按决策粒度分层校验,从而驱动知识在任务层与动作层上的协同演化。
二、RoboHarn-Evo框架
1,问题形式化
本文将“经验驱动的自我改进”形式化为:在固定 VLM 参数与执行器的前提下,利用物理经验持续精化持久知识。
设第个 episode 之前可用的知识为,任务指令为,则该 episode 在操作边界处被记录为轨迹,其中为观测、为机器人动作序列。运行时记忆与检索到的知识共同条件化 VLM 的工具调用决策:
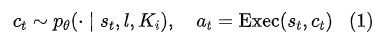
其中为参数化工具调用,执行器在当前场景中将其落地并产生执行反馈。跨 episode 的知识更新规则利用观测到的任务进度与物理动作效应修订知识库:
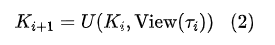
其中包含观测、工具调用与执行反馈。本文目标是寻找一种更新规则,使得随着交互累积,任务成功率单调提升,并在冻结知识快照、固定 hold-out 配置、且不将评估反馈回灌知识库的条件下进行评估。
这一形式化的关键在于:将"模型不变、知识可变"作为自我改进的边界条件,从而把"经验→知识→行为"的闭环显式建模为可分析的对象。
2,内循环:智能体操作套件
内循环维护运行时记忆(来自 RGB-D 观测、物体分割、任务进度与动作历史),并将持久知识分解为任务知识与动作知识,即。VLM 依次选择任务策略与动作策略,二者共同条件化工具调用:
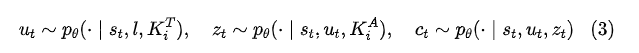
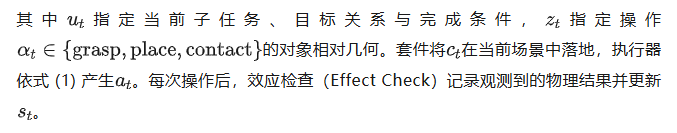
值得强调的是,局部动作效应与子任务完成被分别评估:一次操作可能在物理上成功,但若未满足子任务的完成条件,则不应推进任务规划。这一设计直接对应了本文的核心动机——避免"动作成功≠任务完成"的语义混淆。
3,外循环:分层物理知识的提取与维护
外循环通过 VLM 反射器将可观测轨迹映射为有序的 Task/Action 知识层级:
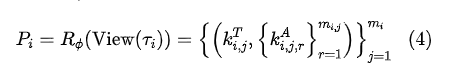
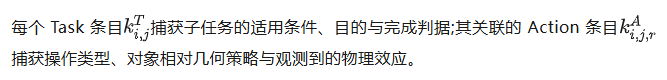
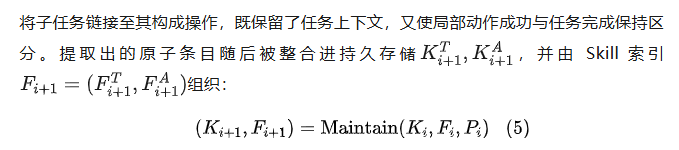
每个 Skill 是一个检索索引,将上下文相关的条目分组并总结其适用场景;执行时则条件化于所选的原子 Task 或 Action 知识。任务-动作 schema 与执行原语保持固定,物理经验只演化知识内容、适用性与检索资格。
从信息论视角看,这一设计将"知识"从模型参数中解耦,使其成为可独立审计、可版本化追踪的一阶对象,避免了端到端微调中"知识不可解释、不可回滚"的固有缺陷。
4,检索与维护:证据驱动的层级化校验
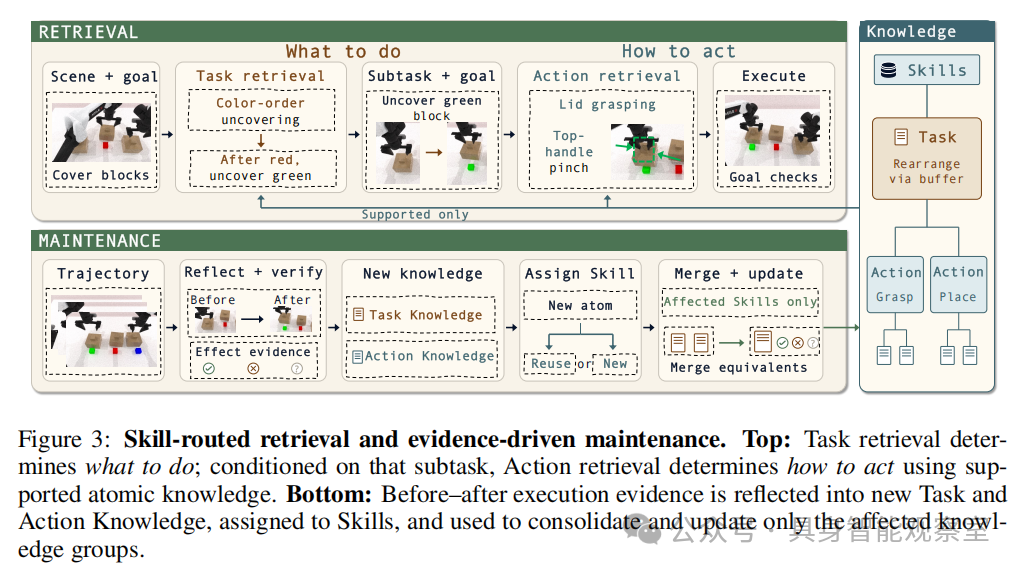
检索过程镜像式地对应式 (3) 的两级决策:给定场景、目标与运行时记忆,Task 检索选择适用于的知识(“做什么”);条件化于该子任务与原语,Action 检索选择适用于的知识(“怎么做”)。
Skill 摘要先将查询路由至相关分组,再由 VLM 选出条件匹配当前上下文的、被支持的原子条目。检索到的任务策略约束动作落地,使所选几何与预期对象关系和子任务目标保持一致。
维护过程则遵循 HPK 层级:Task 知识依子任务完成判据校验,Action 知识依预期物理效应校验。
因此,一次成功的 grasp 可以支持 Action 条目,即便其所属的 placement 子任务尚未完成。对于适用且忠实执行的知识,观测结果提供 support、oppose 或 unverified 三类证据。设条目的支持、反对、未验证计数分别为,则检索资格由下式决定:
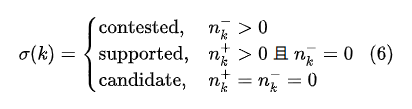
只有 supported 且条件适用的条目才进入检索;unverified 结果保留在证据记录中,但不增加支持或反对计数。
该机制将“撤销”与“修复”分离:撤销阻止被挑战版本的复用,而修复则建立经执行检验的、有证据支持的替代版本。被修订内容仅在满足上式时才变为可检索;早期版本保留其证据(含反对证据),从而实现可追溯的版本化演化。
从理论上讲,这种基于证据计数的层级化校验等价于在知识空间上构建了一个带有“信任-撤销-修复”三态的有限状态机,使知识库的演化具有可解释性与可审计性,避免了无差别经验累积带来的“知识污染”。
同时,Task 与 Action 两层独立校验也意味着:当某一层知识被挑战时,另一层仍可继续提供有效约束,从而保证系统在部分知识失效时仍能维持可用的决策能力,这正是层级化设计相较扁平化经验回放的关键优势。
三、实验结果
实验在 RMBench 与 RoboDojo 两个基准上展开,主对比使用 Qwen3.8-27B、GPT-5.5、GPT-6 三种 VLM 主干,并以与 Harness VLA 作为参考方法。
1,Q1:HPK 的有效性
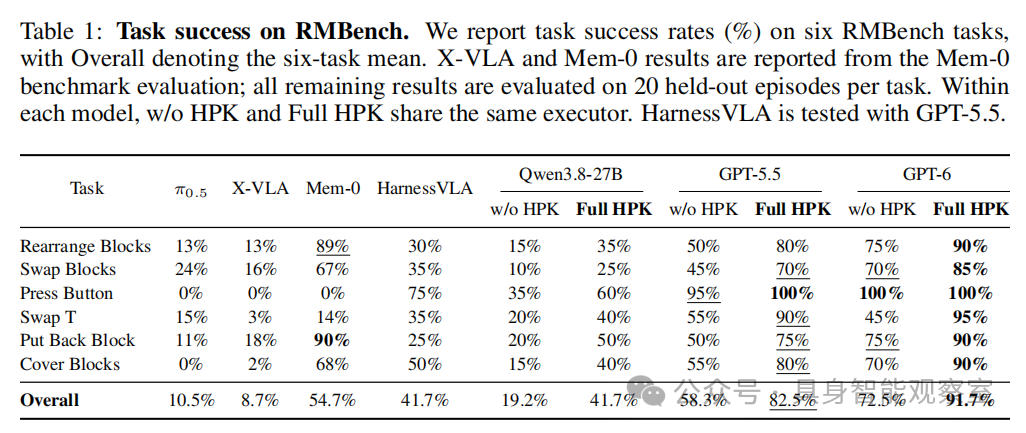
在 RMBench 六项任务上,Full HPK 相较无 HPK 基线将平均成功率从 19.2% 提升至 41.7%(Qwen3.8-27B)、从 58.3% 提升至 82.5%(GPT-5.5)、从 72.5% 提升至 91.7%(GPT-6),最大提升达 24.2 个百分点。
组件消融显示,Task-only 与 Action-only 分别只能达到部分提升,二者结合才超越任一单独层级,也优于不区分层级的 Flat Reflection,验证了两层知识的互补性。
2,Q2:知识维护(Figure 4a–d)
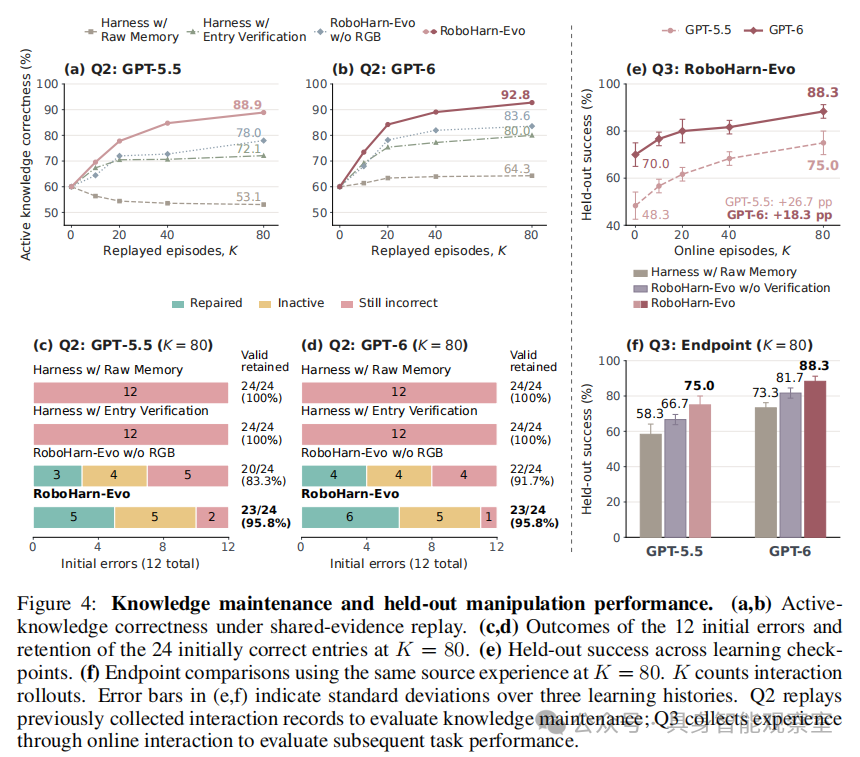
在共享证据回放设置下,RoboHarn-Evo 在时将活跃知识库的正确率提升至 88.9%(GPT-5.5)与 92.8%(GPT-6)。
对初始 12 条错误条目,GPT-5.5 修复 5 条、停用 5 条(合计 83.3%),GPT-6 修复 6 条、停用 5 条(合计 91.7%);对初始 24 条正确条目,两模型均保留 23 条(95.8%)。仅追加原始记忆或仅校验新增条目的对照基线则无法修复任何初始错误。
3,Q3:持续交互的自我改进(Figure 4e–f)
在 Swap Blocks 与 Put Back Block 的 held-out 配置上,经过 80 轮交互后,GPT-5.5 的成功率从 48.3% 升至 75.0%(+26.7pp),GPT-6 从 70.0% 升至 88.3%(+18.3pp)。
在共享源经验下,RoboHarn-Evo 端点性能分别超过 Raw Memory 16.7 与 15.0 个百分点,超过 w/o Verification 8.3 与 6.7 个百分点,证明"构建并校验可复用知识"相较"原始经验回放"具有显著增益。
4,Q4:跨环境知识迁移
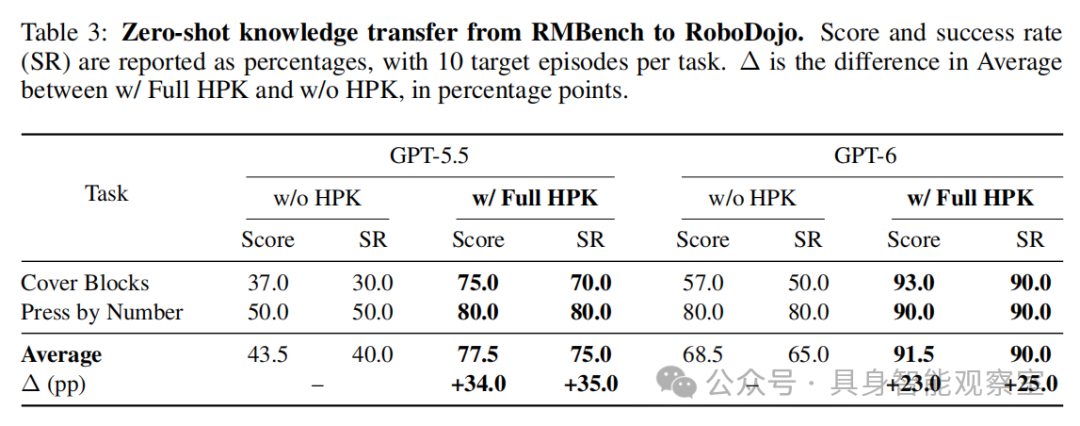
将 RMBench 上习得的冻结 HPK 零样本迁移至 RoboDojo 的 Cover Blocks 与 Press by Number,GPT-5.5 平均成功率从 40.0% 升至 75.0%(+35.0pp),GPT-6 从 65.0% 升至 90.0%(+25.0pp);任务进度分数也分别从 43.5 升至 77.5、从 68.5 升至 91.5。
在 AgileX Cobot Magic 真机平台上,仿真导出的 HPK 零样本即取得 41.7% 平均成功率;经真实世界 RSI 进一步更新后升至 62.5%,任务进度从 70.5% 升至 84.2%,三项任务均获改进。
总结
本文提出 RoboHarn-Evo——在冻结 VLM 与低层执行器的约束下,实现机器人操作中经验驱动的自我改进。
其核心创新在于分层物理知识(HPK)的构建:将子任务决策与对象相对动作策略链接于共享任务目标之下,使历史经验得以在规划与执行两个决策层级同时发挥指导作用;物理反馈进一步跨 episode 驱动知识的修订与复用。
实验表明,Task 与 Action 知识贡献互补收益,证据驱动的维护机制能够修复或去激活历史错误并保留有效知识;基于冻结知识快照的评估验证了 held-out 性能随交互累积而提升;跨基准与真机实验进一步表明,仿真中习得的知识支持迁移,并可通过后续物理交互持续精化。
然而,局限在于:知识更新依赖 VLM 反射器的语义抽象能力,其可靠性构成系统上界;证据计数机制在高维连续操作场景中的可扩展性尚待验证;此外,“模型不变、知识可变”的范式虽规避了微调成本,但也可能限制智能体对全新感知-运动耦合模式的习得。

推荐阅读





×
右键可直接复制图片