 阅读时间大约8分钟(2905字)
2026-10-13 知道物体在哪里,机械臂就能抓了吗?
来源:豆包
作者:毛不毛 出品:具身智能前沿导读相机找到物体之后,机器人还要选择抓法、检查可达性与碰撞,再控制机械臂接近、夹住并搬走物体。...
作者:毛不毛 出品:具身智能前沿
导读
相机找到物体之后,机器人还要选择抓法、检查可达性与碰撞,再控制机械臂接近、夹住并搬走物体。沿着料箱上料的过程,本文解释 FoundationPose、AnyGrasp 与 VLA 分别承担什么工作,以及定位、抓法和运动执行如何衔接。看懂这些关系,才能判断换物体或任务后,一套系统还需要做哪些准备。
一箱零件,先拿哪一个?
假设机械臂要把一箱零件逐个送进加工设备。
如果零件放在固定料盘里,每个格子的位置、朝向都受到约束,程序可以按格子编号依次取料,再用传感器或视觉确认有没有料、是否取走。工装提前解决了不少定位和接近问题。
如果零件随意倒进箱子,情况就变了。相机要观察当前堆叠,系统从中选出一个容易接近的零件,找到抓法,再检查机械臂是否够得着、夹爪会不会撞到箱壁或其他零件。
这时,上料顺序可以由可抓取性决定:先取暴露充分、容易接近的,取走后再更新场景和候选。生产要求按型号取料时,还要加入识别与任务调度。
工业机器人三维视觉系统 Pickit 的文档,就分别讨论抓取点、候选排序和碰撞检查。这类流水线应用通常称为工业机器人自动化。感知、抓法选择、规划和控制由不同模块衔接;模块内部也可以使用学习模型。
沿着这个场景往下看,机器人需要把三件事接起来:找到目标、确定抓法、执行运动。其中,确定抓法可以走不同路线。
有预设抓法:用物体位姿换算夹爪目标
对同一种零件,工程师可以先规定几个合适的抓取位置。例如,避开薄边,从两侧平面夹住它。
零件在箱里换了位置和朝向,夹爪的目标也要跟着变。这就需要物体的 6D 位姿:三维位置,加三维朝向。
FoundationPose 是 NVIDIA 的物体位姿估计与跟踪方法。使用前,先准备目标物体的表示:可以提供三维模型(如 CAD 模型),也可以从参考彩色与深度视图及其位姿信息建立。初始化时,再标出它在画面中的区域。
随后,它结合相机拍到的彩色图、深度图和相机参数,估计物体相对相机的位置与朝向,并在后续画面中持续跟踪。
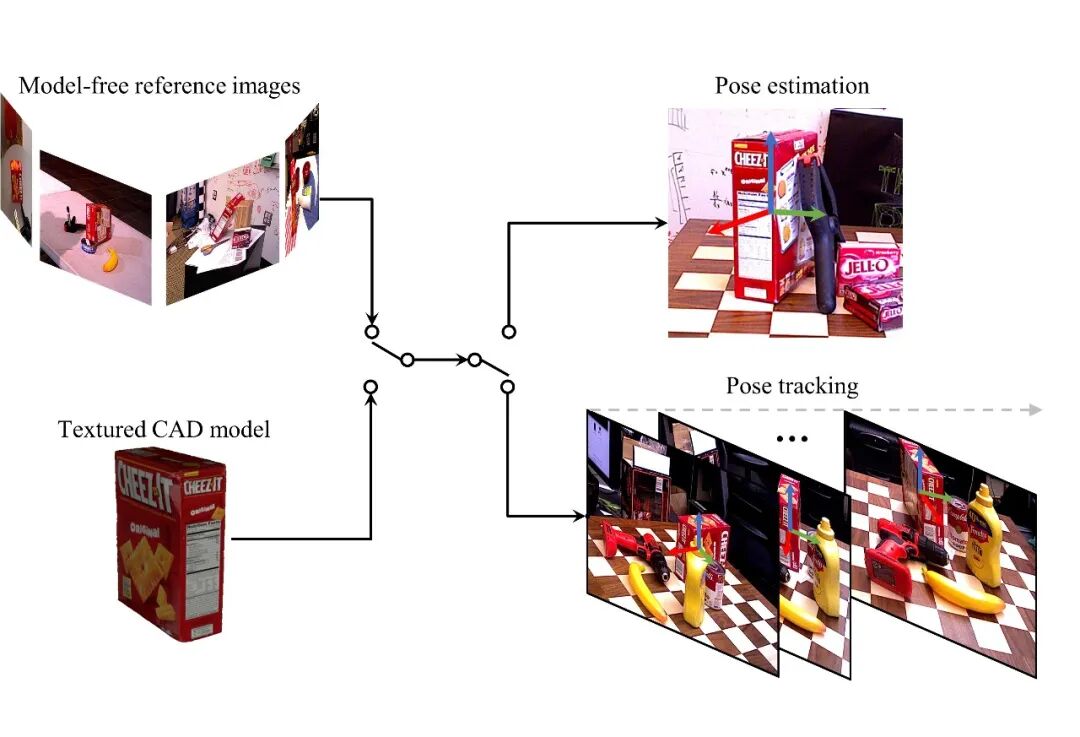
图片说明:左侧是三维模型与参考视图两条输入路线,右侧是物体位姿估计和跟踪的输出。图片来源:FoundationPose 官方项目页,采用原图左侧。
物体位姿需要一个参考:物体自己的坐标系。它的原点和轴方向在建模或重建时约定下来,并随物体一起移动。例如,可以把零件中心设为原点,让一根轴沿着零件的长边。
预设抓法规定夹爪相对这个坐标系怎样放。估计出物体相对相机的位姿后,就能把预设抓法换算成夹爪相对相机的目标位姿;再通过标定转换到机器人坐标系,接到运动执行。
物体位姿描述零件怎样摆,抓取位姿描述夹爪怎样放。同一个零件位姿,可以对应多个抓法;还要结合夹爪形状、周围障碍和后续放置要求来选择。
MegaPose、SAM-6D 等相关方法也使用物体三维模型估计位姿;Gen6D 使用带位姿信息的参考彩色图像。选择这类方案时,先确认能否提供所需的模型、参考视图和相机输入。
没有预设抓法:从当前观测生成候选
如果面对的是事先未知的物体,系统可能根本没有它的三维模型,也没有预设抓法。这时,可以从当前图像或三维表面信息中,直接预测候选抓取。
以 AnyGrasp 为例,它使用点云,也就是一组描述可见表面的三维点。提前训练好的抓取网络从这些点预测抓法,无需为每个目标物体准备专属几何模型。
这类方法通常称为抓取位姿检测或生成。AnyGrasp 输出多个夹爪候选,包含位置、朝向、张开宽度和评分。它直接预测夹爪怎样放,可以跳过物体完整位姿的估计。点云在相机坐标系中时,输出的抓取目标仍需通过标定转换到机器人坐标系。
评分高的候选,还要检查能否到达、是否碰撞,以及是不是任务要求的对象。清空料箱与拿出指定型号的零件,是不同任务;抓取网络提供抓法,目标选择还需要相应的识别或筛选。
三维抓取位姿也可以用一个坐标系表示:原点给出位置,X、Y、Z 轴给出朝向。下图用夹爪线框呈现多个候选,省略了每个候选的坐标轴。Contact-GraspNet、GraspNet baseline 都是相关点云抓取方法。
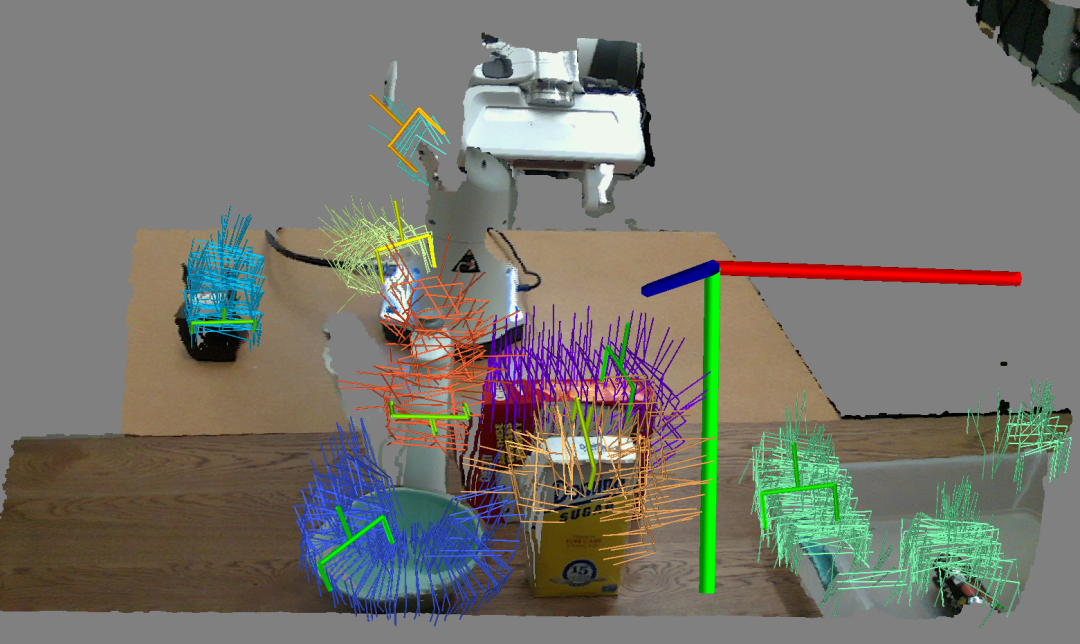
图片说明:Contact-GraspNet 的候选抓取示例,彩色夹爪线框表达位置和朝向;候选仍需筛选后执行。图片来源:Contact-GraspNet 官方仓库。
点云并非唯一输入。也有网络从纯 RGB 彩色图像预测图像平面中的抓取位置、角度等;要变成机械臂可执行的三维目标,还需确定距离与尺度,例如结合深度或已知工作平面。
抓取候选回答夹爪怎样夹住物体。怎样搬运和放好,还要结合后续任务决定。
有了抓取目标,还要让机械臂运动到位
机器人通常用 TCP(工具中心点)及其坐标系描述工具的位姿。对夹爪,可以在两指之间约定一个参考点,再规定轴方向,用它表示夹爪应该怎样放。
算法的抓取坐标系与机器人 TCP 坐标系,原点和轴方向可能不同。执行前,要按两者的定义做坐标转换,得到机器人基座坐标系下的 TCP 目标位姿。所需旋转与位置偏移取决于具体约定,没有统一的“旋转 180°”规则。
逆运动学,也就是 IK,根据这个 TCP 目标求关节配置。对常见的旋转关节机械臂,结果是一组关节角;同一目标可能有多个解,也可能无法到达。
这组角度描述到达时的状态。运动规划还要选择路径,轨迹生成给路径配上时间,控制器再根据反馈跟踪各时刻的目标,让电机实际运动。
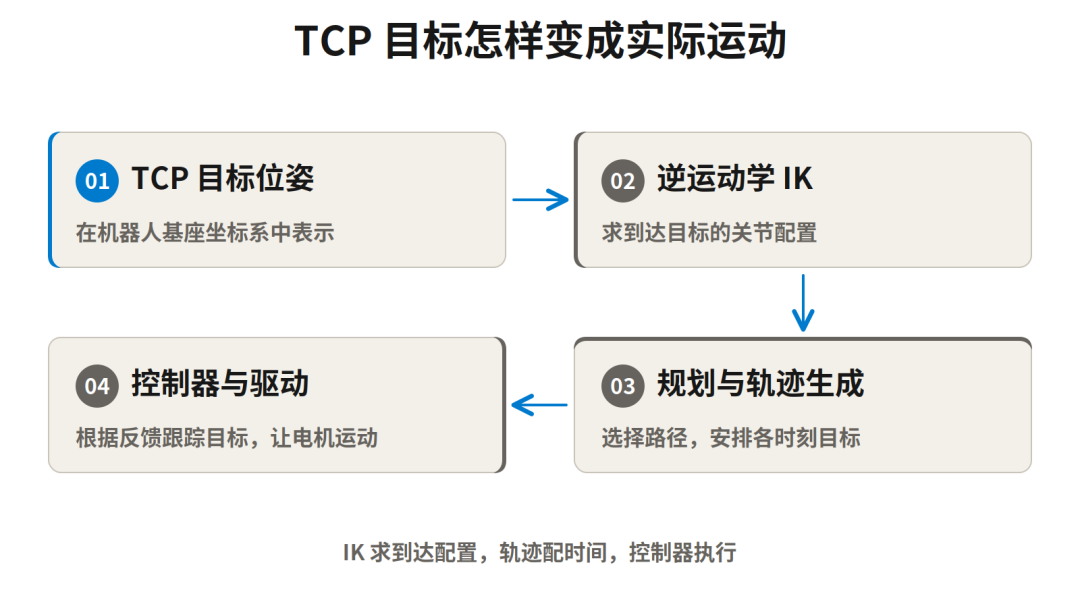
IK 解是目标配置,轨迹描述怎样随时间到达。实际抓取通常还要安排接近、闭合夹爪、抬起和搬运等动作,并检查物体是否取走。到达某个位姿,只是执行过程的一步。
工业机器人接口有时只要求上层发送一个末端目标,是因为控制器承担了后面的转换和执行。内部仍然连续控制关节,工业机器人也可以接收连续的关节目标。
这些环节衔接之后,零件才能从料箱进入下一道工序。
VLA:从观察和指令预测动作
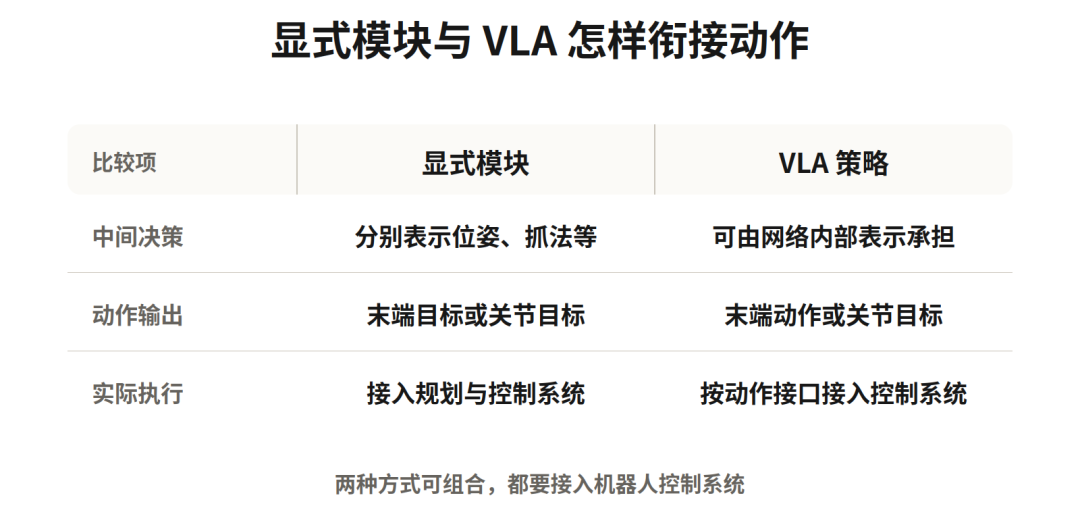
前两条路线采用模块化的机器人操作流程:感知、抓法选择和运动执行分别处理,再接起来。另一种方式是学习型操作策略,也就是从数据中学习根据当前观测生成动作,把部分中间决策交给网络。
VLA,即视觉—语言—动作模型,把视觉观测和语言指令作为输入。例如,结合“拿出红色零件”与当前画面,预测接下来怎样行动。它能学习哪些目标选择和操作决策,取决于训练数据与机器人适配。
这里所说的“隐式”,指策略从数据中学习观察与动作的关系,中间过程不一定逐项输出物体位姿、抓取点或规划路径;最终动作仍然是明确的数值,必须符合机器人的控制接口。
输出形式取决于训练和适配。原始 OpenVLA 输出末端位置与旋转增量,加夹爪动作;OpenVLA-OFT 的 ALOHA 适配使用绝对关节角。两种形式都需要接入控制系统执行。
策略也可以分块预测动作:一次推理生成未来多个时刻的目标,再依次执行。如果 50 Hz 指动作执行频率,就是每 20 毫秒使用一次目标;模型何时根据新观测重新预测,是另一件事。理解响应能力,需要把推理、动作执行和底层控制的频率分开看。
同一台机械臂,只要控制接口支持、策略完成适配,就可以执行预编程与规则安排的动作,也可以执行学习策略预测的动作。区别主要在上层怎样决定动作,底层仍需控制器驱动机械臂。
具身智能研究智能体如何通过身体感知环境并行动,VLA 是其中一条技术路线。它也可以结合位姿估计和运动规划;工业自动化同样可以使用学习得到的抓取模型。判断一个系统时,要看各环节怎样协作。
抓得起来,还要放得合适
回到料箱,如果要求“只拿红色零件”,系统要先选对目标;如果还要按指定方向送入设备,就必须确定怎样放。AnyGrasp 给出抓取候选,完整任务还需要目标选择、运动执行和放置决策。
换成一个直观例子:把杯子抓起后,杯底朝下放到桌面指定位置。系统需要掌握杯子相对夹爪怎样摆,以及杯子最终的位置和朝向。一种方式是结合杯子位姿与抓取位姿,算出杯子相对夹爪的关系;夹紧且没有滑动时,这个关系保持稳定,就能根据杯子的目标位姿换算夹爪的放置目标,再规划下降、松开与撤离。
也可以用 VLA 等学习策略,根据观察与指令预测放置动作,不必单独输出杯子的完整位姿。这需要相应的训练与机器人适配,能否可靠放好仍需验证。显式计算与学习策略都可以承担放置决策,也可以组合使用。
对训练中没见过的物体能否生成有效抓法,称为抓取泛化;听懂目标描述、完成定向放置,则需要另外验证。工业自动化描述应用场景,具身智能描述研究方向。选择方案时,先把任务落到选目标、确定抓法、搬运和放置这些具体环节,再判断哪些信息与能力还没有准备好。

推荐阅读





×
右键可直接复制图片