 阅读时间大约6分钟(2150字)
2026-10-14 人形机器人的重定向卷了两年,现在是不是该收敛了?伯克利把接触位置和动作节奏一起管了
来源:豆包
作者:Yuanxq 出品:具身智能研究室人从桌上拿东西,换成身材更矮的G1,手该怎么伸?桌子原本只到人的腰部,却接近机器人的胸...
作者:Yuanxq 出品:具身智能研究室
人从桌上拿东西,换成身材更矮的 G1,手该怎么伸?桌子原本只到人的腰部,却接近机器人的胸部,照搬姿态可能让手抓空或穿过桌面。重定向既要适配机器人的身体,也要保住手与物体的接触。 围绕这个问题,GMR 侧重人体与机器人之间的姿态对应,VideoMimic从视频重建人和场景,OmniRetarget 将手与物体、脚与地形的关系纳入优化。到了击球、扶桌取物和爬梯子,手脚到达的位置、朝向、时刻,以及接触前后的速度,都影响任务能否完成。
伯克利的 VICAR 把这些要求放进了重定向过程:从视频恢复人的动作和桌子等障碍物,标出击球、抓取或支撑的目标,再调整整段机器人运动。手要到达目标,途中要避开障碍,速度也尽量保留示范中的变化。 作者还把物体或击球点移到不同位置,重新生成动作,用来训练动作生成器;执行时输入新的目标位置,生成器给出对应动作,由强化学习策略跟踪。
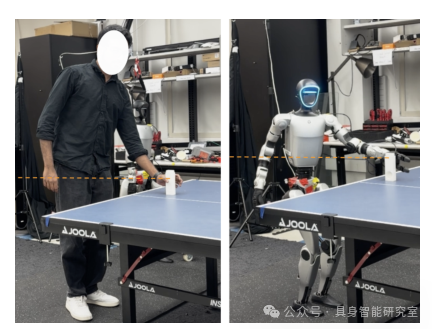
桌面接近 G1 的胸部,直接照搬人的伸手姿态容易出错。
训练与部署
训练从一段人类视频开始,先求出机器人动作,再用这些动作训练两个模型:动作生成器和跟踪策略。 前者根据目标位置给出参考运动,后者把参考运动转成关节控制。
用 GENMO/GEM 提取人体姿态、整体移动和身体关键点;重建桌面等障碍物,人工标注接触时刻、身体部位、位置与朝向。
将人体动作转换为 G1 的初始轨迹,再对整段运动做优化,减少 接触误差、障碍物穿透、速度偏差和关节跳变。
改变物体位置或击球点,重复轨迹优化,得到同一技能在不同目标位置下的动作数据。
用这些数据训练动作生成器:输入 动作风格、接触目标和历史运动,预测接下来一段机器人与物体的运动。
在 Isaac Lab 中用 PPO 训练 G1 跟踪参考动作。策略观察机器人当前状态,输出关节位置目标;姿态和速度越接近参考,奖励越高,动作变化过大、关节越界和不希望发生的碰撞会受到惩罚。
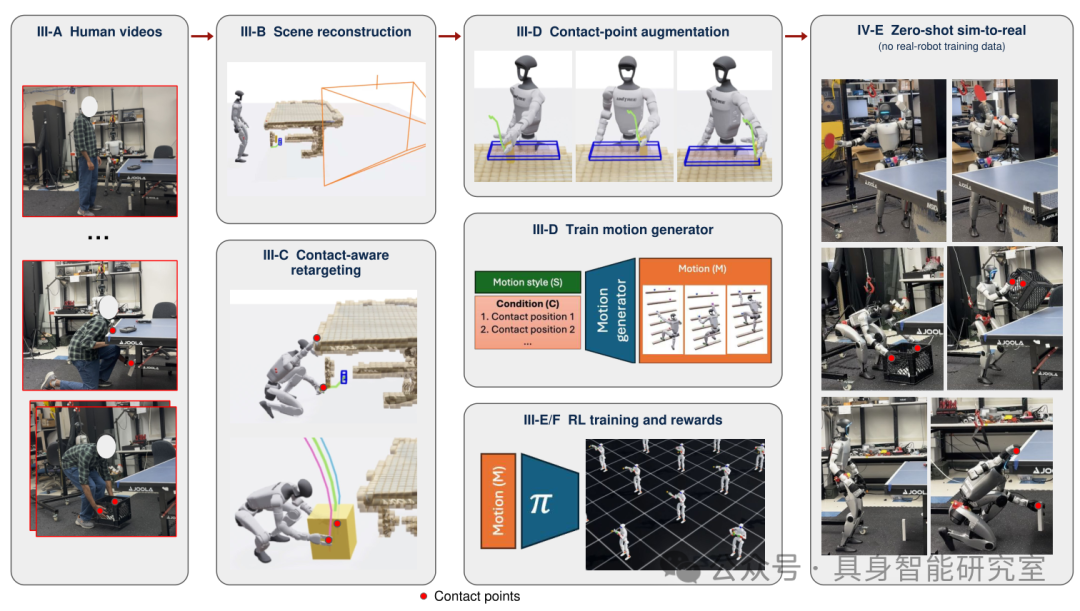
先从视频生成多组机器人动作,再训练动作生成器和跟踪策略。
跟踪训练使用 4096 个并行环境,控制频率通常为 50 Hz。作者随机改变摩擦、关节偏移和躯干质心,并施加推扰,让策略练习在不同物理条件下跟上参考。训练没有使用真实机器人数据。 实机执行时,外部动捕提供球和物体的位置,生成器据此调整参考;跟踪策略读取机器人状态,持续输出关节目标。
接触与场景
接触标注可以直接写成一句指令:“在这一帧,让这只手到达这个位置,并保持这个朝向。” 位置和朝向使用世界坐标,桌上的物体和梯子的横档就是手脚要到达的目标。机器人可以改变肘部、躯干和腿部姿态来够到它们。
以桌下取物为例,作者同时标注 右手扶桌边、左手抓物体。如果只保留左手的抓取动作,右手可能在下蹲时离开桌边。发球则标注抛球和击球位姿,爬梯子标注手脚依次接触横档的位置。这些标注决定了重定向时哪些接触需要留下。
桌面和桌边还要转成优化器能够计算的障碍物。系统先用 UniDepth 估计深度、Semantic-SAM 分割图像,再由 GPT-4o mini 根据任务挑选相关区域。选中的深度像素转换成三维点云,用人体高度校正尺度,最后划分为边长 5 cm 的立方体;一个格子里至少有 5 个点,才算有障碍物。优化轨迹时,就可以检查身体有没有进入这些格子。
整段轨迹优化
重定向分两次求解。第一次先得到适合机器人身体的初始动作。 作者采用类似 OmniRetarget 的交互网格方法,匹配手腕、肘部、躯干等关键点之间的局部位置关系,同时限制关节角度和速度。这一步暂时关闭障碍物惩罚。
第二次把接触目标和障碍物加入,重新调整整段轨迹。 优化中有四项主要代价:
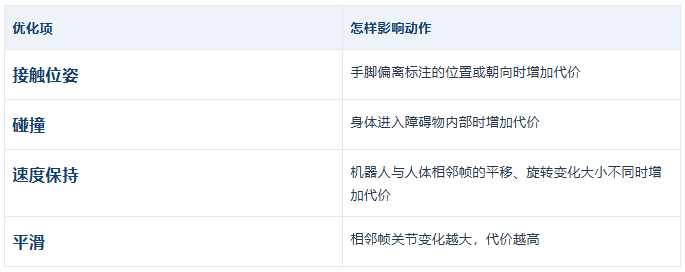
接触和碰撞项的权重较大,优化会优先减少这两类误差。 速度项比较每一步移动和转动的大小,给路径调整留下余地:机器人可以绕开桌沿,尽量保留原动作在什么时候快、什么时候慢。 对发球而言,这能在调整击球位置时保留挥拍节奏。
整段优化还有一个具体作用:避免避障修正把动作拆断。如果某一帧的手被移到桌子左侧,下一帧却被移到右侧,两帧都可能没有穿透,连起来却无法正常执行。VICAR 将前后帧一起调整,让手沿连续路径绕过障碍,再到达接触位置。
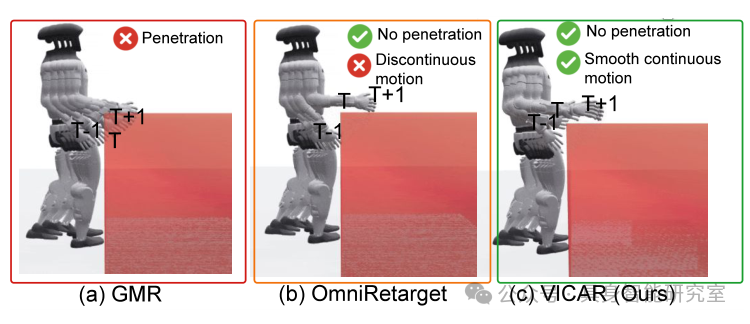
GMR 出现穿透,OmniRetarget 的示例出现动作跳变,VICAR 的路径保持连续。
条件动作生成
一条参考动作对应一个目标位置。物体挪动后,原来的动作可能抓空。作者因此 先移动目标,再重新求解动作,批量生成训练样本。发球在原击球点附近的三维网格中采样,保留抛球条件和发球风格;取物改变物体位姿;双手搬箱的样本保持两手与箱体同步。
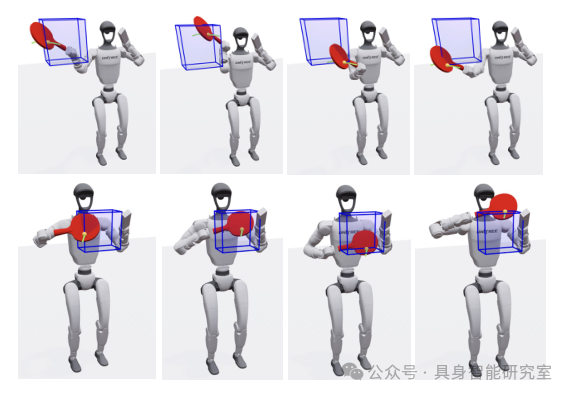
击球点改变后,手臂和身体姿态也随之调整。
生成器学习这些样本中的对应关系。动作风格告诉它要做哪种发球,接触目标告诉它球拍要到哪里,历史运动告诉它动作进行到了哪一步。 它输出接下来一段机器人与物体的参考运动。六种发球用不同的风格标识区分,包括正反手、削球和侧旋。
执行时把新的击球点或抓取位姿输入生成器,就能得到相应参考,再由跟踪策略执行。 多个目标位置下优化得到的轨迹,是训练生成器的数据来源。
实验表现
作者测试了 六种发球、桌面取物、桌下取物、双手搬箱并放置、爬梯子,共 10 个技能。基线也追加了相同的接触位姿惩罚,数据增强、策略训练参数和奖励设置保持一致。
任务成功率
每项仿真评测进行 1000 次试验:
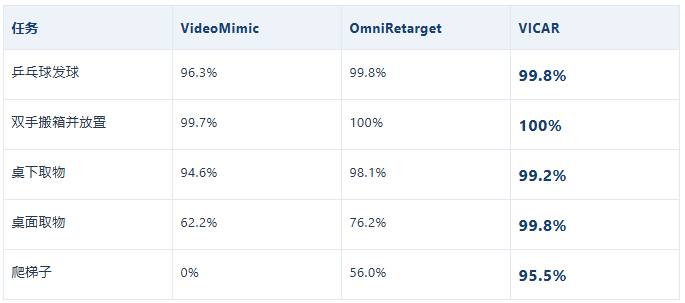
桌面取物从 76.2% 提高到 99.8%,爬梯子从 56.0% 提高到 95.5%。 发球和双手搬箱则与 OmniRetarget 持平。桌面取物还测得:最大关节变化速度从 0.37 降到 0.10 rad/step,末端速度误差从 0.35 降到 0.027 m/step,VICAR 的平均接触位置误差为 0.19 cm。这些数值分别反映动作中的最大关节变化、对示范速度的保持,以及到达目标的精度。
接触位置适应
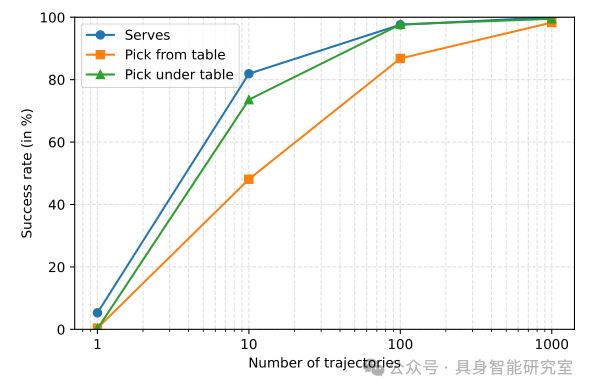
横轴为增强轨迹数量,纵轴为未参与训练的接触位置上的成功率。
作者从同一采样范围中留出一批接触位置,用来测试生成器。只有一条训练轨迹时,换个目标位置就很难成功。 增加到 100 条 后,发球和桌下取物接近 98%,桌面取物约为 87%;增加到 1000 条 后,三类任务都接近 100%。
实机执行
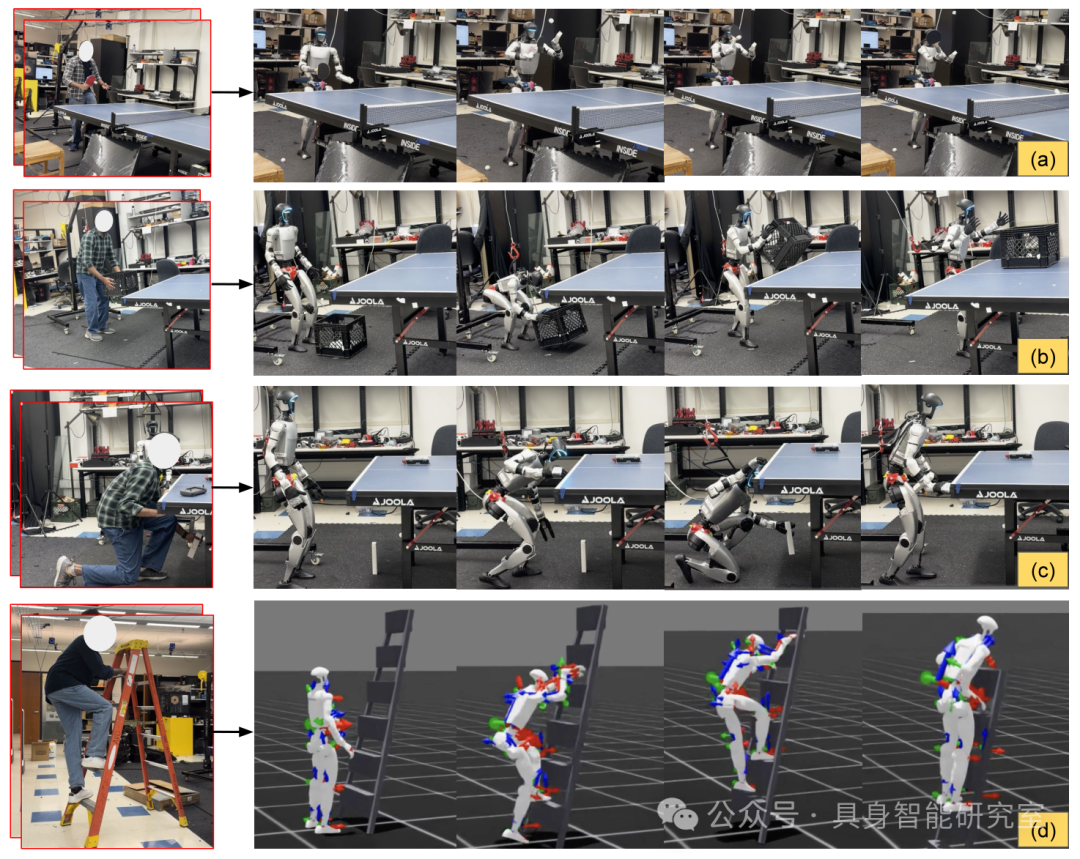
前三行是发球、搬箱和扶桌取物的实机动作,最后一行是仿真爬梯子。
G1 实机测试中,发球成功 21/30 次,桌面取物 10/10 次,桌下取物 7/10 次,双手搬箱 6/10 次。发球和桌下取物成功率均为 70%,双手搬箱为 60%。爬梯子的 95.5% 来自仿真评测。

推荐阅读





×
右键可直接复制图片