 阅读时间大约9分钟(3261字)
2026-10-16 9家路线,统一不了Ego数采方案
来源:豆包
谁在解数据难题?
作者:Lvy 出品:ggjqr
具身智能的竞争,正从模型侧悄悄前移。
算法的瓶颈之下,数据采集成为最明了的对准目标机器人的结构、视野、接触与力的边界。
数据始终是具身智能行业的热门议题。大家一边把各种方案逐一尝试,一边在成败未定的情况下积累Infra与Know-How。
比起马上找到正确方案,大家更看重的,似乎是这些底层能力与经验。
复盘近两年,无论是试错中被舍弃的数采方案,还是正逐渐退场的方案,似乎都曾有过风光无两、备受追捧的高光时刻。
数据并不是采集了就可以用,真机数据贵在真实,却困于规模;仿真数据赢在规模,却输在落差;人类视频胜在丰富,却断在动作与力觉。每一种方案都在解决上一环的缺口,同时把新的缺口留给下一环。
从模型端到设备端,决定数据能否真正可用的重心,正在向设备端转移。模型端的方法再精巧,如果采集设备在源头就没有对准目标机器人的本体结构、观测视角、接触方式和力控范围,数据从产生之初就带着难以消除的偏差。
设备不再只是数据的入口,而是数据可迁移性的第一道约束,例如采集设备与执行端是否同构,可穿戴系统能否同步捕获意图、运动和力反馈,以及执行器能否接住训练出的策略,这些设备端的现实条件直接决定数据是资产还是沉没成本。
就在8月底,北京首个人形机器人数据训练中心正式停运,即便运营方睿尔曼智能将其定义为数据战略的重要升级,也不可否认去年3月才揭牌的训练场在运行仅一年多后便按下暂停键的事实。
同时,最近业内也不乏“UMI必然被淘汰”的论调。Ego数据正加速成型,正加快UMI的退场。
其本质还是对于采集成本的敏感。
那么,对于正成为主流的 Ego 数据,同样存在着不少亟待解决的问题和短板,各家具身智能企业究竟在采集怎样的第一人称数据?它们如何绕开这类数据的先天短板,又靠什么把它变成可训练、可执行的资产?
Ego数据的短板及解决路径
第一个问题出在In-hand-manipulation(手内操作)上。操作时,手指、手掌和工件会从多个角度挡住相机,使视觉系统难以连续获取物体位姿、接触点和运动状态。从数据采集角度看,这种遮挡意味着很多手内操作过程难以获得完整、连续的视觉标注。
针对这一难题,Sharpa、Xspark AI、舞肌科技、大晓机器人分别从EMG手环、触觉层面、重建运动轨迹等方面,提出各自的解决方案。
4月17日,Sharpa发表了一篇新论文DexEMG,其中联合上交的推出的EMG手环路径极具参考价值。
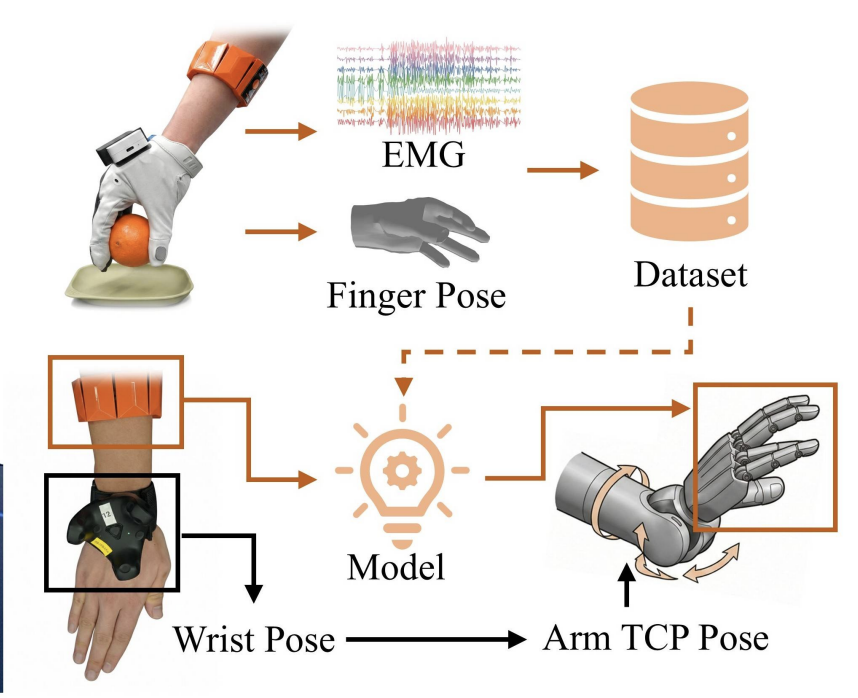
这里涉及到一个知识点,当人类想要活动手指或手部时,小臂肌肉会产生高频电生理活动,并在皮肤表面形成 sEMG 信号;EMG手环可以采集这一信号,从而获取相关肌肉活动信息。
Sharpa给出的思路是:在采集数据的阶段就把 EMG 手环从“记录器”前移为“意图入口”:同步捕获神经驱动、手部运动、接触与力反馈,用神经控制先验补齐视觉盲区。
8月7日,Xspark AI发布HumanTouch,其构建了一套覆盖触觉、手部运动和视觉的多模态采集系统,并发布1000小时人手全掌触觉数据集。
HumanTouch把手套上的传感点分成若干个有意义的区域,比如“食指尖”“掌心”,再判断每个区域的接触状态。系统结合三类信息估计每个区域是否真的发生了接触:当前触觉响应、当前手部姿态与姿态速度、近期触觉历史。
Xspark AI给出的思路是:利用姿态与历史感知的校准模型,将触觉反馈、边际信息以及算法对触觉信息真伪的识别结果,共同用于补足视觉丢失时的信号缺口。
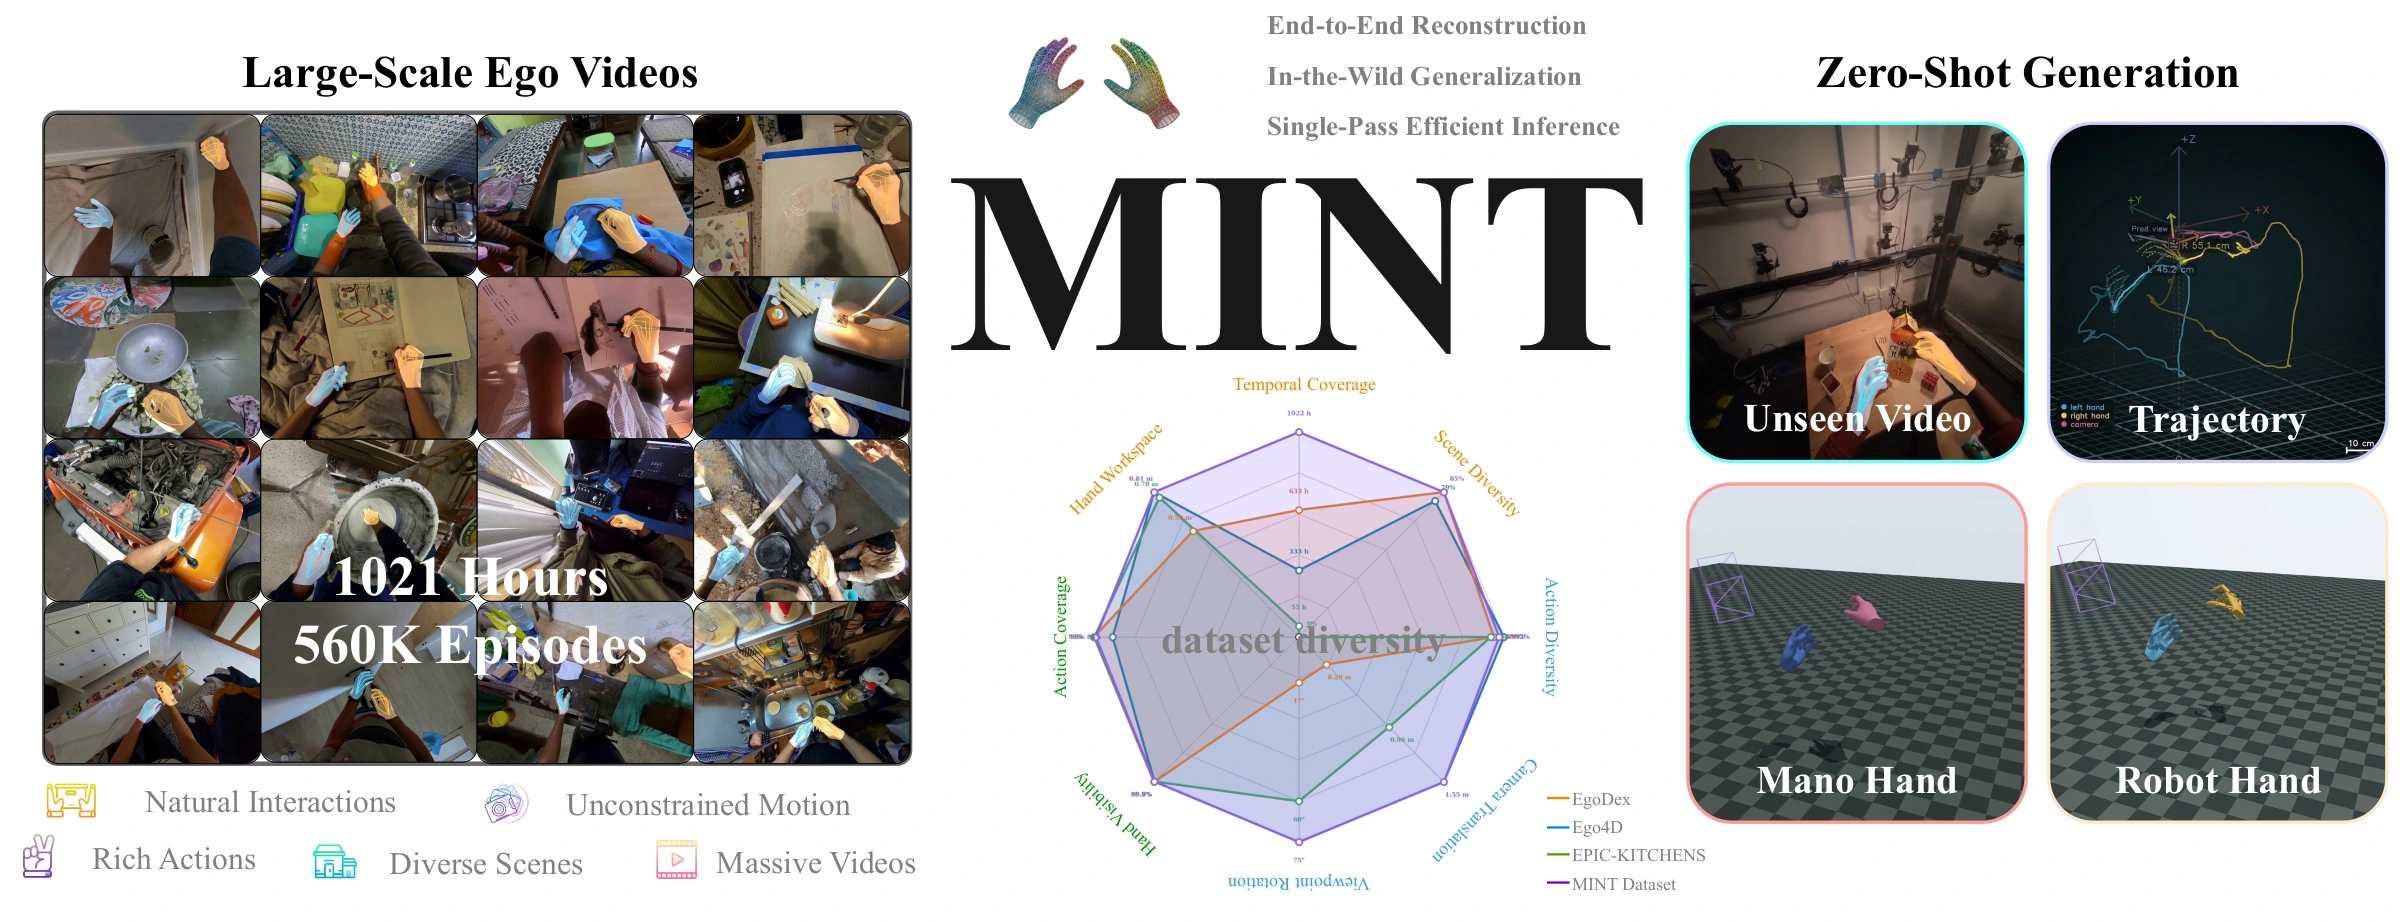
9月7日,舞肌科技开源自研 Minting IN-the-Wild Trajectories(MINT)数据模型与 EgoPipeline 参考代码,同步发布覆盖 1,021 小时第一视角视频的结构化标注数据,让相机与双手在真实空间中的运动数据更容易被规模化获取。
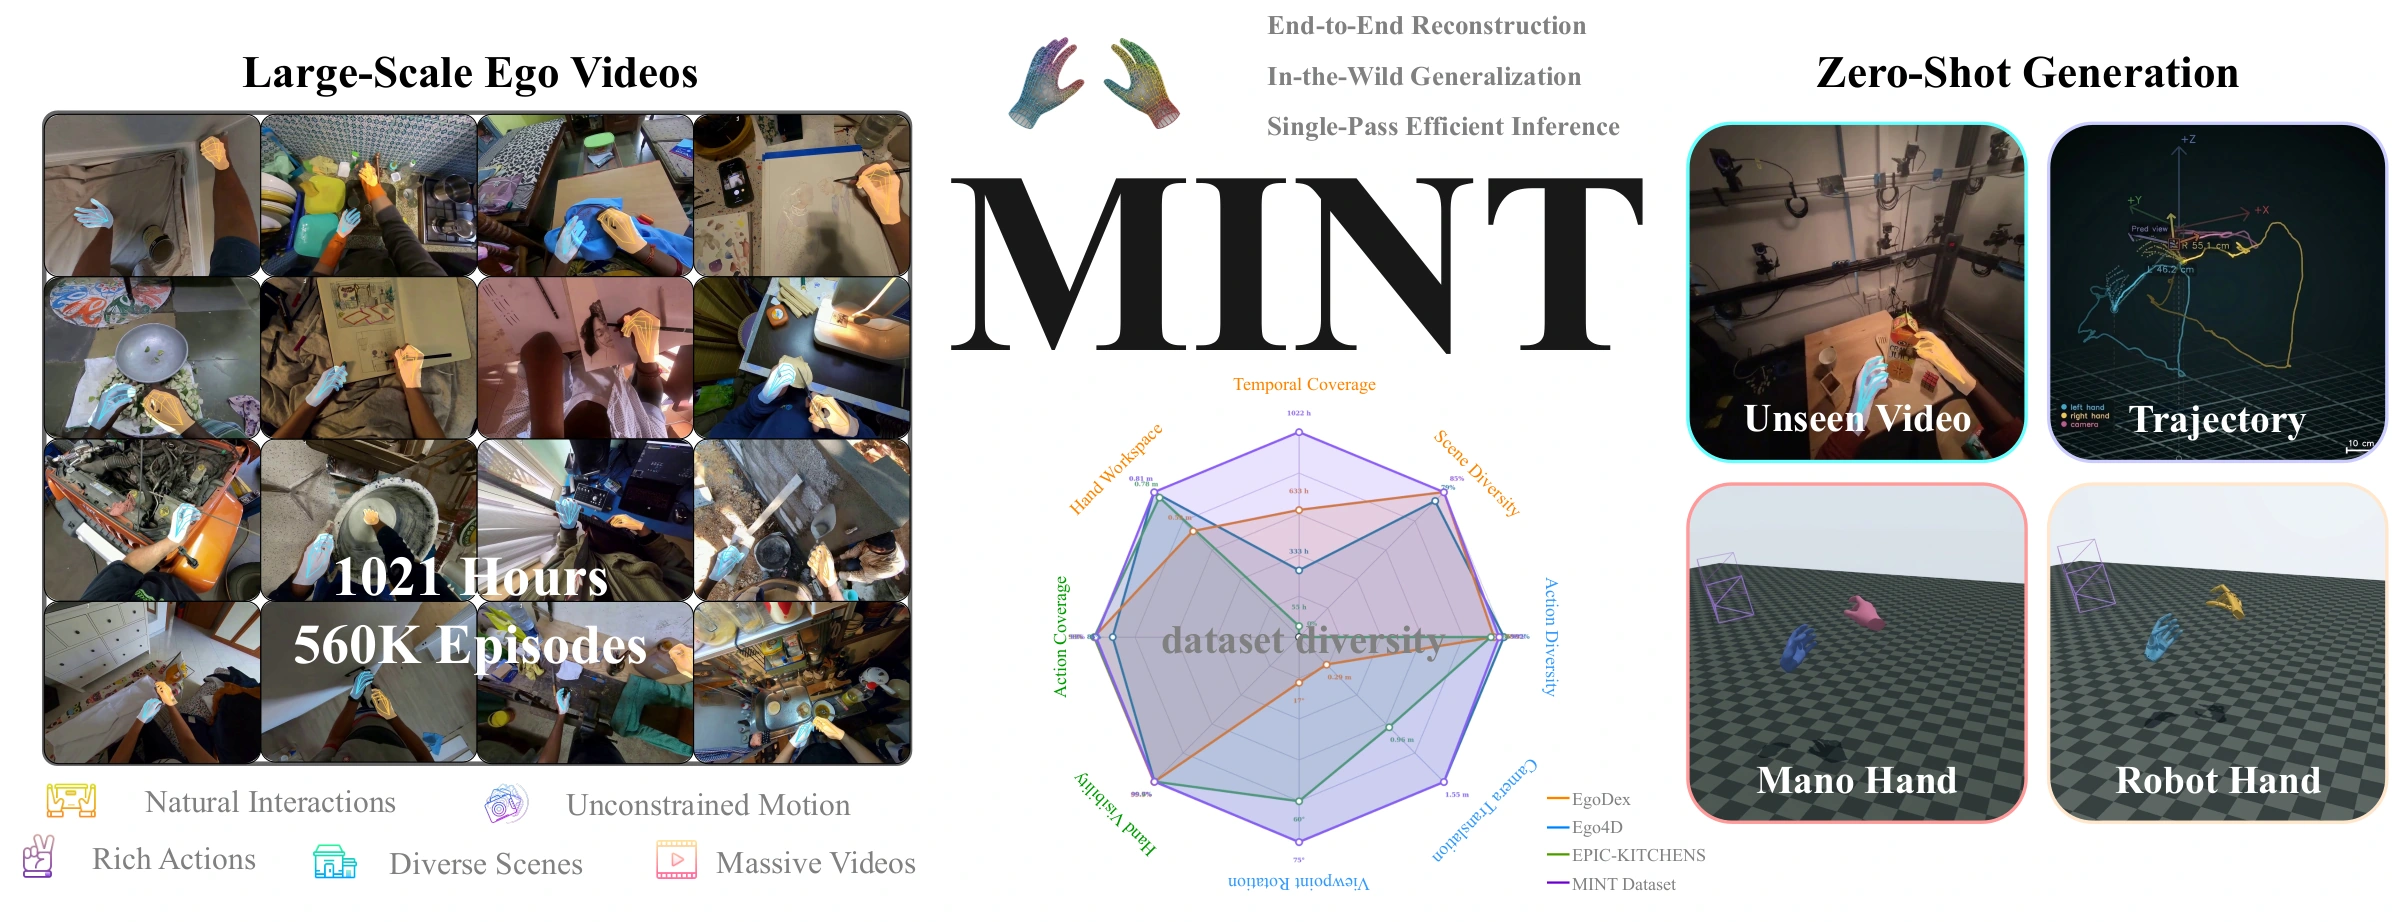
在这一解决方案中,EgoPipeline 负责从普通视频生产监督,并把多个专用模型接起来;MINT 负责学习这批监督背后的映射,让相机和手部预测读取同一套特征。
舞肌科技给出的思路是:将相机运动估计与双手运动估计整合到同一模型,从第一视角视频中同步重建左右手的三维世界轨迹,把自然活动视频转化为结构化运动数据。
值得注意的是,大晓机器人联合香港中文大学多媒体实验室、南洋理工大学等机构,开源了面向第一视角视频的3D双手形状重建模型ACE-Ego-Hand,并已产出约5000小时训练数据。
ACE-Ego-Hand与MINT有着类似的思路,即从海量第一视角视频中提取结构化的双手三维操作轨迹。
第二个问题是采集设备与机器人本体存在结构差异。采集设备往往围绕人的操作习惯和生理结构设计,而机器人则受限于自身自由度、连杆长度、关节限位、末端执行器形态和感知配置。结构不同,意味着同一个动作在采集端和机器人端无法一一对应,需要额外做运动重定向、关节映射和动力学补偿;否则数据规模再大,也可能因具身差异难以复用,甚至引入噪声。
值得注意的是解决同构问题只是表层需求,其深层指向的是数据迁移与数据依赖问题。
其一是尝试实现数据的跨本体融合。
针对这一问题,Beingbeyong(智在无界)提出了解决方案。
1月20日,Being Beyond团队发布跨本体VLA模型Being-H0.5,其配套的数据集UniHand2.0,总时长超过3.5万小时,囊括14000小时的机器人操作数据,16000小时的人类视频数据,以及5000小时通用多模态数据,总训练token数突破 1200亿。
值得注意的是,UniHand2.0首次实现了跨本体的大规模数据融合,汇集了超过30种不同硬件构型的多样化数据,涵盖了从桌面机械臂到双足机器人在内几乎所有已知的机器人形态。
Being Beyond团队给出的思路是:用全品类硬件形态和规模化跨本体数据打底,再以统一动作空间框架做对齐,把不同形态的机器人投射到同一特征表示空间,最终支撑跨本体联合训练与知识迁移。
其二是如何利用human data,帮助某一具体机器人本体减少对真机数据的依赖。
针对这一问题,灵初智能、马里兰大学团队、自变量分别从数据质量、数量,以及数采设备出发,提出解决方案。
4月10日,灵初智能发布了策略模型 Psi-R2、世界模型 Psi-W0,以及近10万小时人类操作数据,其中包含5417小时真机数据,以及95472小时人类数据。
灵初智能的思路是:以数量级差异进行分工,真机数据抬高上限,人类数据支撑泛化。
6月中旬,马里兰大学(UMD)的团队提出新框架 HumanEgo,其理念是用精心设计的human data去对比精心设计过的遥操作数据。
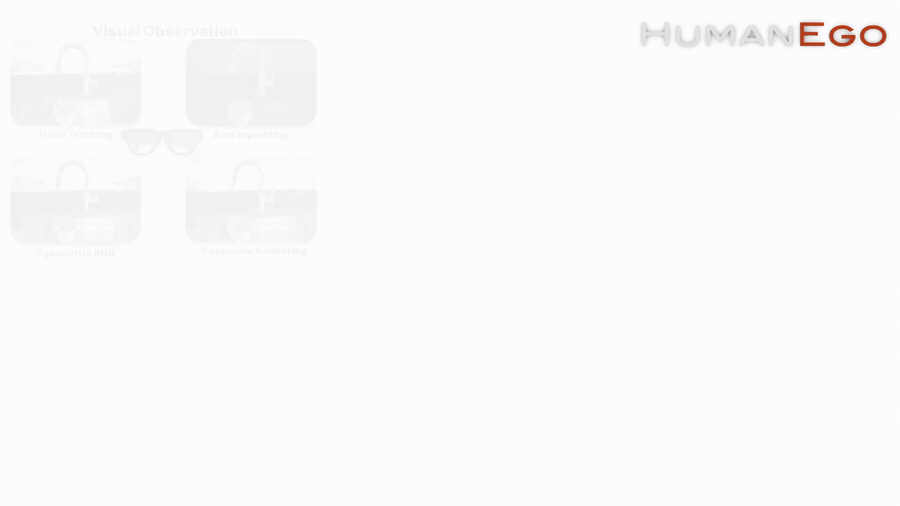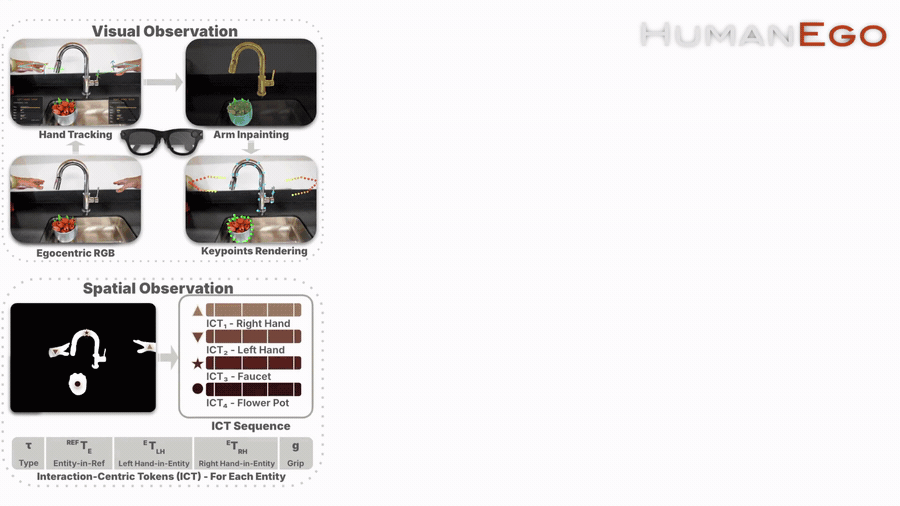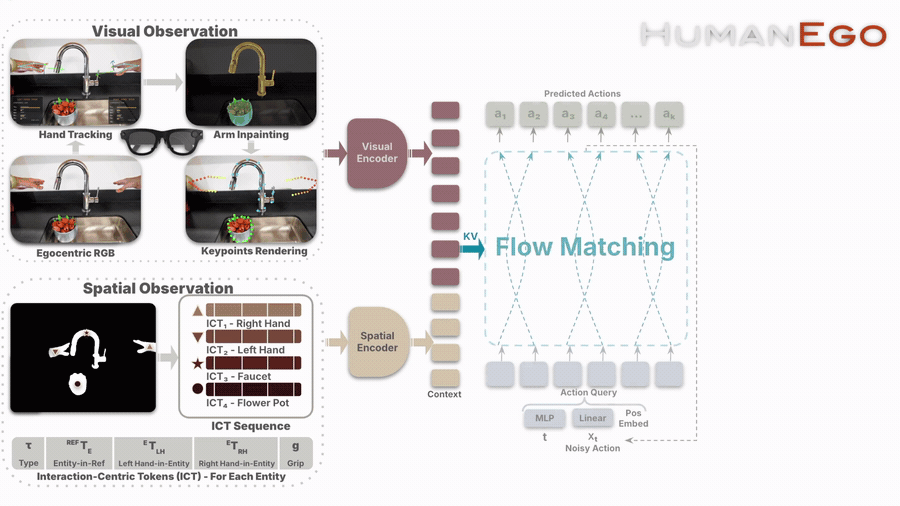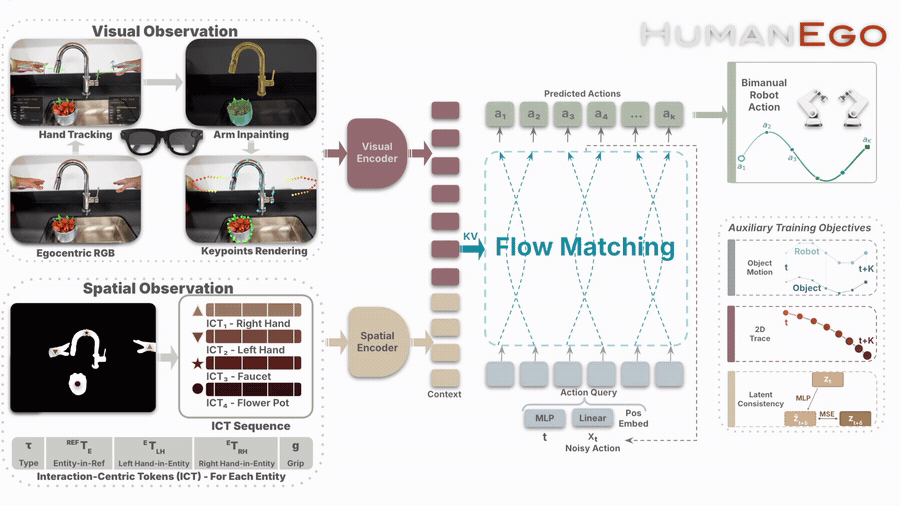
这一框架下,人类第一人称数据更重要的不是视觉,而是交互信息,即把场景中每只手和每个物体都看作一个实体(entity),为每个实体计算一个 29 维的交互中心 Token(Interaction-Centric Token, ICT),编码实体在参考系下的 6D 位姿、左右手相对该实体的位姿,以及抓取状态。
UMD团队给出的思路是:让人类数据的质量尽量逼近真机数据,同时借助算法弥补第一人称视角视频所缺失的信息。
9月2日,自变量发布TwinDEX三指九自由度灵巧操作手,它由一套可穿戴的无本体数据采集系统和一套与之匹配的机器人末端执行器组成。
资料显示,TwinDEX通过提高数据采集端与机器人执行端的一致性,让无本体数据也能够获得接近真机数据的训练效果,为灵巧操作的数据规模化提供了新的方法。
自变量给出的思路是:从硬件出发,让数采设备和执行端尽可能同构,协同设计了硬件、训练和执行系统,让数据从产生之初就符合机器人执行需求。
第三个问题是如何把自然人类行为转化为可拓展的人形机器人可执行数据。
针对这一问题,小鹏机器人、Current Robotics分别提出了解决方案。
9月5日,小鹏机器人发布了跨本体世界模型AnyWorld,其核心是把一段人类交互拆开,再按目标机器人的身体、视角和场景重新组合。
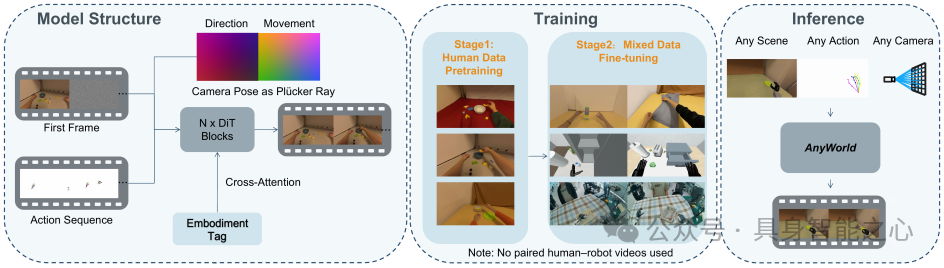
AnyWorld 方法总览
在这一模型下,既可以复刻人类视频数据已经出现过的状态,还可以把已有交互经验视为基础,定向编辑出策略缺失的目标场景和物体布局。目标不是抹掉机器人数据,而是更有针对性地补齐训练分布。
小鹏机器人给出的思路是:AnyWorld 将人类交互翻译成机器人可执行的观测—动作—结果链,并按策略缺口反向生成训练样本。数据生产从“先采后训”扩展为“按能力缺口编译分布”,形成缺口驱动的数据补全机制。
6月18日,Current Robotics发布了全身灵巧操作模型Curr-0,尝试把移动和灵巧操作放进同一个策略里同时解决。
Curr-0由三层架构组成,上中下层依次负责理解任务语义、协调全身运动和姿态稳定、手部和物体之间的精细接触,在同一个闭环策略下,机器人移动时,身体姿态和手部动作同时调整;手部接触变化时,全身状态也同步响应。
Current Robotics给出的思路是:让移动成为操作的动态基座,让操作成为移动的稳定锚点,使全身自由度按任务意图、扰动和接触状态动态路由,而非按技能模块静态拼接。其目标不是让机器人“边走边动手”,而是让全身在持续接触变化中共同完成操作。
数据尚未从资源变成解决方案
截至目前,行业已经积累了大量采集方案、模型架构与工程经验,也交了不少学费,但真正的分水岭还没出现。
数据量在涨,可用性未必同步;工具在增多,闭环未必更短。
各家给出的路径包括同构采集、跨本体重组、全身统一策略、神经信号前移、人类视频预训练,本质上都在回答同一个问题,如何让数据从产生之初就带着目标本体的约束,而不是事后修补。
谁先跑通这条从采集到执行的完整链路,谁才可能把数据从囤起来的资源变成跑得通的解决方案。
在那之前,热闹属于方案,答案仍属于时间。
11月3日-4日,我们将在深圳举办2026(第三届)高工人形机器人年会暨高工金球奖颁奖典礼,并特设“智核进化”专场,围绕VLA、世界模型与数据飞轮展开深入探讨。

推荐阅读





×
右键可直接复制图片