 阅读时间大约9分钟(3466字)
2026-10-16 VLA 知道怎么做,为什么还是对不准?从误差来源到精密操作
来源:豆包
作者:毛不毛 出品:具身智能前沿导读VLA能识别物体、理解任务并生成动作,精密操作却还要处理位置、姿态、时间与接触误差。本文用...
作者:毛不毛 出品:具身智能前沿
导读
VLA 能识别物体、理解任务并生成动作,精密操作却还要处理位置、姿态、时间与接触误差。本文用插入任务串起感知、坐标、动作和控制,解释不同办法分别改善哪一环,再结合 VLA-Precision 的实机研究,区分任务容差、测量误差与成功率,建立判断机器人操作精度的完整思路。
先问任务允许偏多少,再问机器人有多准
设想让机器人把插头插进插孔。它已经找对插头、选对方向,也把手移到了插孔附近,最后却卡在孔边。对理解任务来说,它已经完成了不少工作;对插入来说,最后一点位置或角度偏差就足以让前面的努力失效。
视觉语言动作模型(VLA)根据图像、语言指令和机器人状态生成动作。它能学会操作规律,但动作还要经过具体接口和控制器,最终落实为机械运动。操作精度来自这条完整链路。
讨论之前,先分开三件事。
任务容差是允许偏多少。插头相对孔口允许多大的横向位移和倾角,决定了对齐要求有多高;接触力等条件还会影响操作能否完成。同样一毫米,对宽口容器和紧配合插孔,后果可能完全不同。
定位准确度与重复定位精度描述机器人到达位置的表现。前者关心实际位置与目标相差多远;后者关心重复执行时,落点聚得有多紧。每次都停在孔口右侧同一个位置,可以很稳定,却始终插不进去。
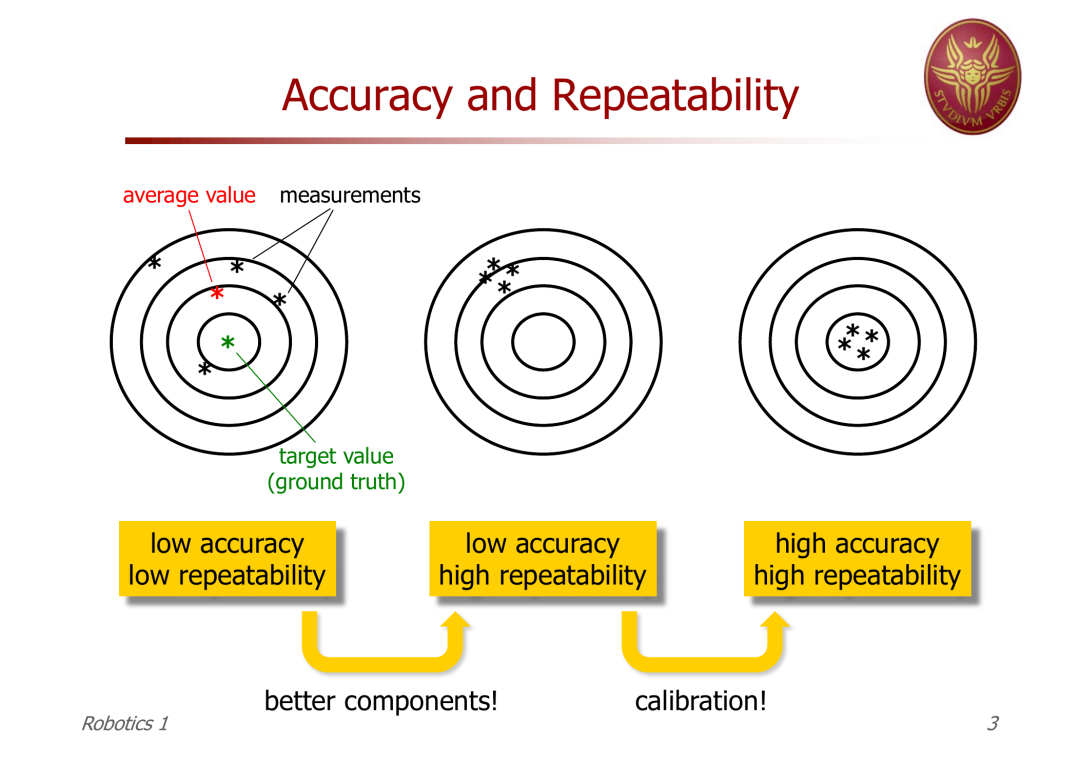
中间的落点集中但偏离靶心,右侧则集中在靶心附近;重复性与准确度需要分别观察。
| 来源:罗马第一大学 Robotics 1 课程讲义,第 3 页
任务成功率统计完成了多少次。机器人可能先碰到孔边,再通过局部调整完成插入。成功说明整套过程有效,却没有单独告诉我们第一次对准偏了多少。
所以,“毫米级操作”需要进一步说明:这是任务允许的偏差,还是测出来的误差?测的是工具尖端、物体,还是机械臂末端?是否包含了接触后的调整?这些条件决定数字能说明什么。
从看见插孔到移动插头,误差经过了哪些地方
先从相机看见的东西说起。若采用显式几何定位,系统需要从孔口图像估计它在空间中的位置和朝向。遮挡、模糊或估计偏差,会让后续动作从一个有误差的目标开始。
接着要让目标与机器人处在可比较的坐标系里。相机标定描述成像关系;手眼标定确定相机与机器人之间的位置和朝向;工具标定则确定工具参考点相对机械臂末端的位置。这个参考点通常简称 TCP,可以选在夹爪中心或工具尖端。
坐标变换有误时,系统可能稳定地把孔口映射到错误位置。机器人自身的运动学模型也要与实机匹配:UR 官方机器人驱动文档提醒,应提取对应机器人的出厂标定参数供运动学模型使用,否则末端位置可能出现厘米量级偏差。这里的模型描述关节与末端位置之间的关系,与 VLA 的神经网络参数是两回事。
端到端 VLA 未必显式算出孔口的三维坐标。它可以从图像直接预测关节目标或末端动作,把一部分对应关系学进参数。但输入相机、机器人状态、动作单位和执行接口仍有具体约定,部署时同样需要核对。
最后是目标怎样变成运动。动作可能表达关节角度,也可能表达末端位姿或位移;控制器再驱动电机去跟踪它。跟踪中的偏差、负载造成的形变,以及工具和被夹物之间的位置变化,都可能改变插头最终到达的位置。
这几类误差会相互影响,不能把不同坐标系中的误差数字直接相加。排查时应让它们各自有可观察的参照:目标估计对不对、坐标转换对不对、实际运动有没有跟上指令。
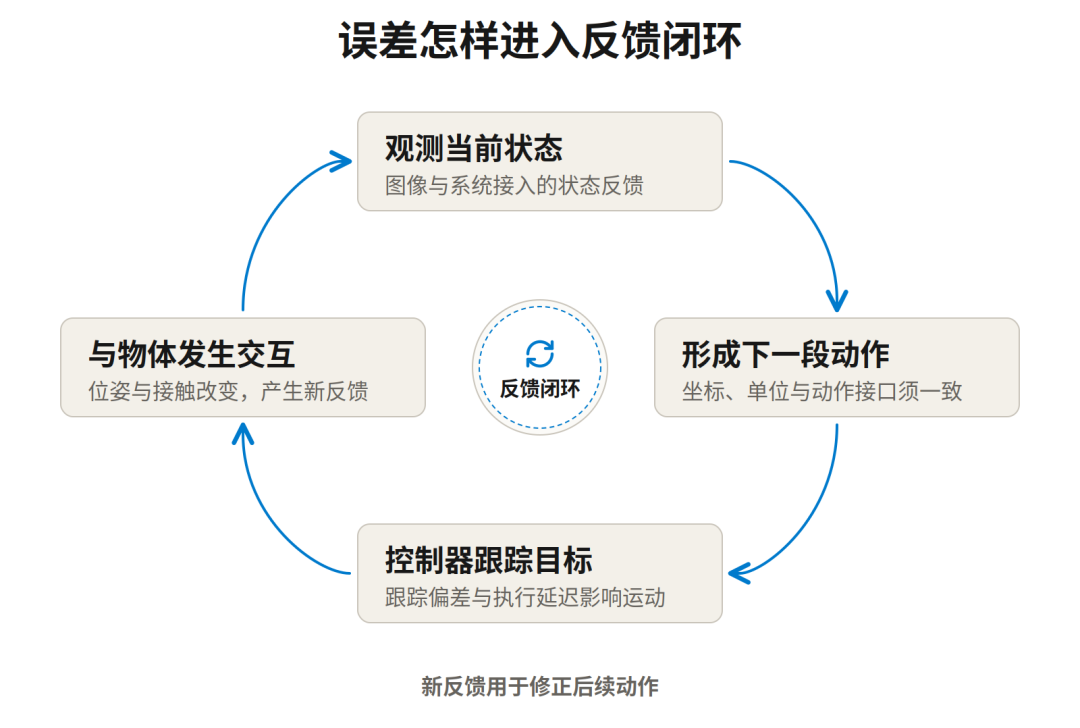
闭环能纠偏,前提是反馈看得见、来得及
回到插头:如果机器人只看一次图,就把整段动作执行到底,偏差在途中出现后,策略可能一直没有机会调整。
视觉伺服提供了一个经典思路:用持续获得的视觉信息形成误差,再让控制器据此调整运动。图像式方法直接比较图像特征与目标特征;基于位姿的方法先估计三维位置和朝向,再计算偏差。两种方法都需要可靠的观测与相应控制条件。
学习策略也可以依据新图像修正动作,控制器内部还可能持续读取关节或力的反馈。“有闭环”需要说明闭的是哪一层。电机把关节角跟踪得很好,仍可能是在准确执行一个已经过时的插入目标。
时间因此也会变成位置问题。用示意数字说明:若目标相对工具以每秒 20 毫米匀速移动,100 毫秒内相对位置就会变化 2 毫米。系统若仍按旧位置行动,就要面对这段变化。因此,反馈是否及时,要看采图、推理、通信到执行的完整时间。
VLA 常用动作分块,一次预测未来一段动作。这里需要分开:预测了多长、实际执行多少步、多久把新观测纳入决策。预测一长段,并不要求全部执行完才重新观察。
动作分块是一种通用的动作组织方式,ACT 则是采用这种方式的具体策略模型架构与模仿学习方法,全称为 Action Chunking with Transformers。它根据相机图像和关节状态,用 Transformer 预测一段未来动作,再用示教数据训练。因此可以训练出具体的 ACT 模型,但采用动作分块的 VLA 不一定采用 ACT。
实时动作分块方法 RTC 关注的是执行衔接:执行当前动作段的同时,怎样生成下一段动作?旧动作可能准备从障碍物上方绕行,新动作却选择下方,直接切换或平均可能生成不合适的中间动作。RTC 会约束新动作段与即将执行的动作保持一致,同时利用新观测更新后面的部分。
因此,缩短执行段需要同时考虑推理是否跟得上、段间是否连续。反馈更频繁有价值,抖动和停顿也会影响接触过程。
VLA-Precision 是一项针对 VLA 实机后训练的研究,其中一个实验使用经过任务示教微调的 π0.5 模型,在三项精密插入任务上比较执行长度。动作采用逐步相对位移表示:每一步的目标由前面的位移累加得到,预测误差也可能随之累积。
在这组实验中,每段执行长度从 3 步增加到 6 步,平均自主成功率从 58.3% 降到 6.7%。这说明该动作表示和任务设置对执行长度敏感,不能推成所有模型都应执行 3 步;后面介绍的在线训练结果,也属于另一组实验。
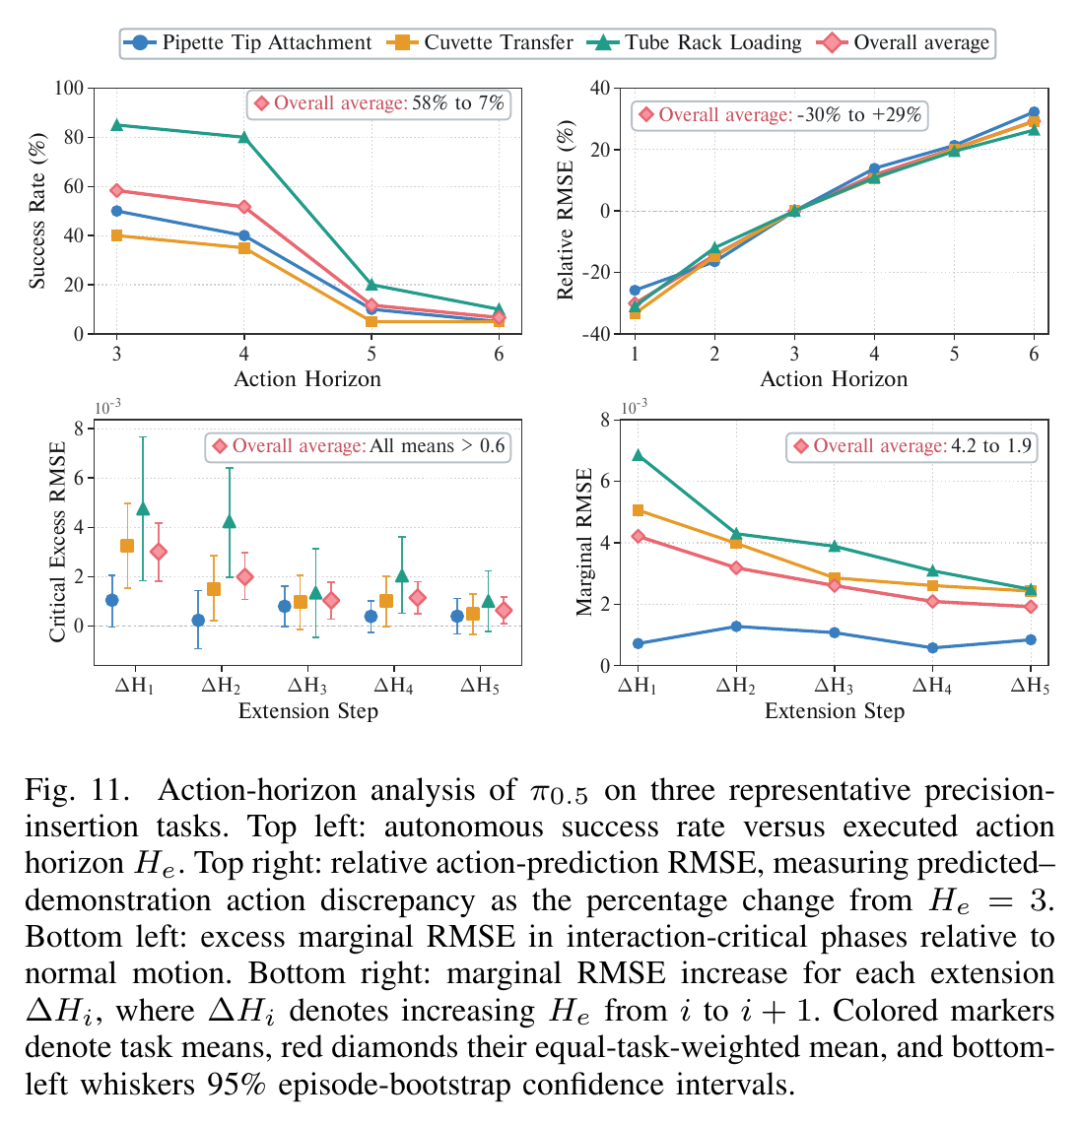
左上比较执行长度与成功率;右上比较动作预测与示教之间的相对误差变化,未测量末端毫米误差。
| 来源:VLA-Precision 论文 v3,Figure 11
碰到孔边之后,还需要处理力与接触
视觉能帮助接近孔口,插入过程还涉及接触。插头顶住孔边后,继续沿原方向推进可能增加受力,位置目标本身未必能告诉系统该如何调整。
力与触觉反馈提供另一类信息:是否碰到东西、接触发生在哪里、有没有滑动,以及受力怎样变化。系统要把这些信息接到决策或控制里,才有机会据此修正。
经典控制中,混合运动—力控制在不同方向上分别安排运动和力的目标。例如沿接触表面移动,同时控制压向表面的力。阻抗控制则设定位置、速度偏差与响应力之间的关系,让机器人在接触时表现出一定的柔顺性。接触后的受力需要控制,靠近目标的位置也仍要可靠。
VLA-Precision 的部署也包含这一层:论文在 UR5e 和 Franka 上都配置了阻抗控制,分别通过机器人支持的力或关节力矩接口落实。策略更新带来的收益,是在这些机器人、传感器和控制条件上得到的。
对插入任务,可以据此理解分工:视觉与状态估计帮助接近目标,策略决定下一段动作,接触反馈与控制器处理局部受力。具体系统可以把这些职责组织在不同模块里,验收仍要覆盖整个过程。
在线训练怎样把“这次改对”变成“下次做对”
执行中的纠偏解决当前这一次;训练还要回答,下次遇到类似状态能不能更好。
行为克隆用示教中的观测和动作训练策略。若部署时偏离了示教覆盖的状态,模型可能缺少相应的恢复行为。增加纠正数据可以补充这些经验;在线强化学习则进一步利用实际交互结果改进策略。
VLA-Precision 采用两阶段后训练:先用示教微调 π0.5,建立任务策略;再在真实机器人上交互,冻结已得到的基础参数,只更新动作专家中新增的 LoRA 参数。LoRA 是用少量可训练参数调整模型的方法,动作专家负责生成机器人动作。
它的 ACoB 方法同时改进动作生成和价值估计:前者决定怎样做,后者估计某个动作会带来怎样的后续回报。人接管时,系统保留原提案与纠正后的动作。实际执行轨迹用于学习后果;在接管发生的同一个状态下,再要求纠正动作的估值高于被替换的提案。
成功动作和有效纠正也直接用于训练动作专家;与此同时,冻结的第一阶段策略作为参照,约束新策略偏离原有行为的程度。
这解决了一个具体缺口:人把操作救回来后,不能让模型误以为原先被否决的动作同样值得执行。
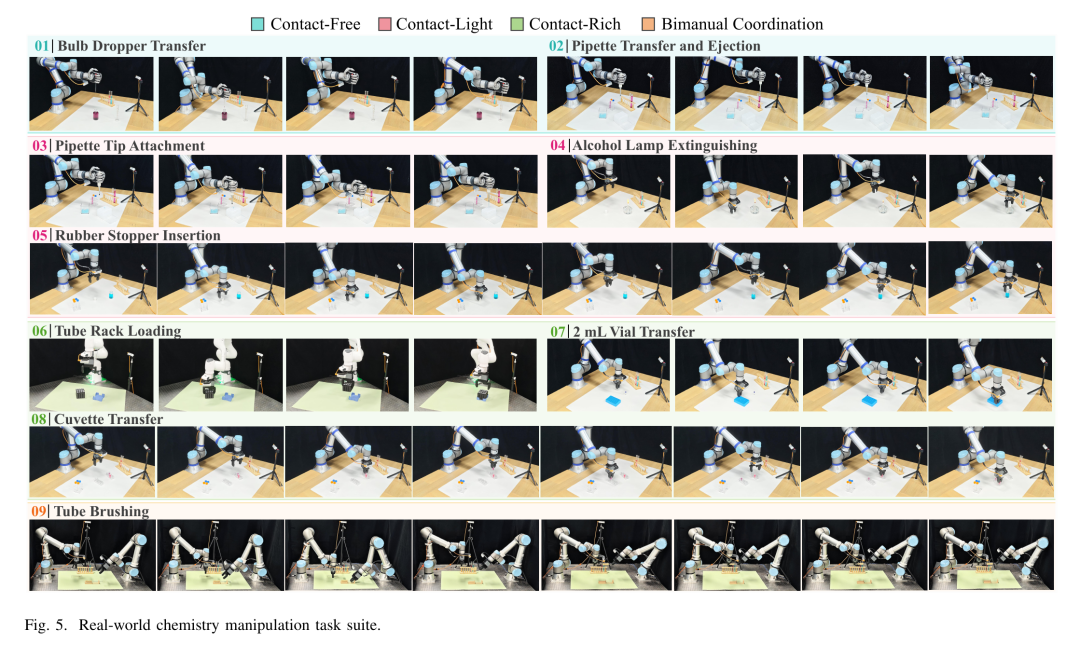
九项化学操作覆盖不同接触条件与一项双臂任务;移液器装吸头、试管架装载等任务具有不同的对齐容差。
| 来源:VLA-Precision 论文 v3,Figure 5
论文报告九项任务的 180 次留出测试中成功 177 次,平均成功率 98.3%。实验设置表列出的容差并不统一:装吸头为 ±0.25 毫米,橡胶塞插入为 ±0.5 毫米,其他任务还有数毫米容差。98.3% 描述任务完成情况,±0.25 毫米描述特定任务的对齐要求。实际动作偏了多少,还需要相应测量。
平均每项 45.8 分钟指在线训练阶段,前面还有任务示教与微调。论文也未覆盖包含多个精度关键阶段的更长双臂序列。这个案例说明,在给定任务和系统中,在线训练可以继续改善已有策略;标定、执行和接触条件仍然是效果成立的基础。
怎样判断改善落在了哪一环
真正排查一套系统,我会先固定任务、工具和测试条件,再按下面几类现象找证据。这是依据前述机制整理的排查思路,现象只能提示检查方向,不能单独确诊。
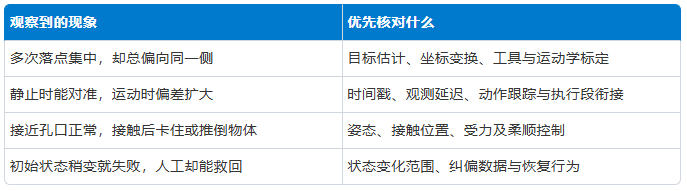
验收时还要把几份结果放在一起。测位置与姿态误差时,说明参考真值、测量对象和测试位置;看任务成功率时,保留样本数、初始状态变化范围、超时与人工接管规则;看效率时,记录完成时间、重试次数和完整反馈延迟。平均结果之外,失败集中在哪里也很有价值。
这样才知道,成功率提高是第一次对得更准、接触后更会调整,还是付出了更多时间与重试。它们都可能帮助完成任务,对下一步工程选择的含义却不同。
让插头插进去,需要目标足够可靠、动作能够落实、偏差能够被发现,修正又能及时生效。谈 VLA 精度时,我最想追问的就是:这次偏差发生在哪里,系统凭什么看见它,又由谁把它改回来?

推荐阅读





×
右键可直接复制图片