 阅读时间大约7分钟(2521字)
2026-10-16 资本大迁徙:从减速器到数据工厂,下一个“卖水人”赛道已开闸
来源:人形机器人场景应用联盟
数据天堑如何跨越?
出品:人形机器人场景应用联盟
具身智能正在遭遇一场持续加剧的数据饥渴。大语言模型可以依托互联网海量文本完成预训练,但人形机器人需要的多模态物理交互数据,没有现成的“动作互联网”可供取用。训练能够在非结构化环境稳定作业的机器人智能体,需要十亿小时级别的真实交互样本,而当前全球高质量可用数据仅有数十万小时,巨大缺口正在卡住模型泛化能力的上限。
在此背景下,数据基础设施的建设能力,不再是企业的配套研发成本,而是决定具身智能模型迭代速度与落地边界的核心竞争力。造得出机器只是基础门槛,能不能持续生产高质量训练数据、高效完成闭环训练,才是下一阶段产业竞争的重中之重。
01.
硬件卷到过剩,行业撞上“数据天堑”
过去两年,人形机器人行业叙事长期聚焦硬件比拼:扭矩、减重、量产成本、关节数量。很多厂商可以快速做出样机、跑通demo,可一旦进入非结构化真实环境,问题集中爆发。
行业测算显示,训练达到接近人类通用操作水平的具身智能模型,需要10亿小时量级真实物理交互数据;但截至2026年初,全球可直接用于人形机器人训练的高质量物理交互数据仅约50万小时,缺口超过99%。
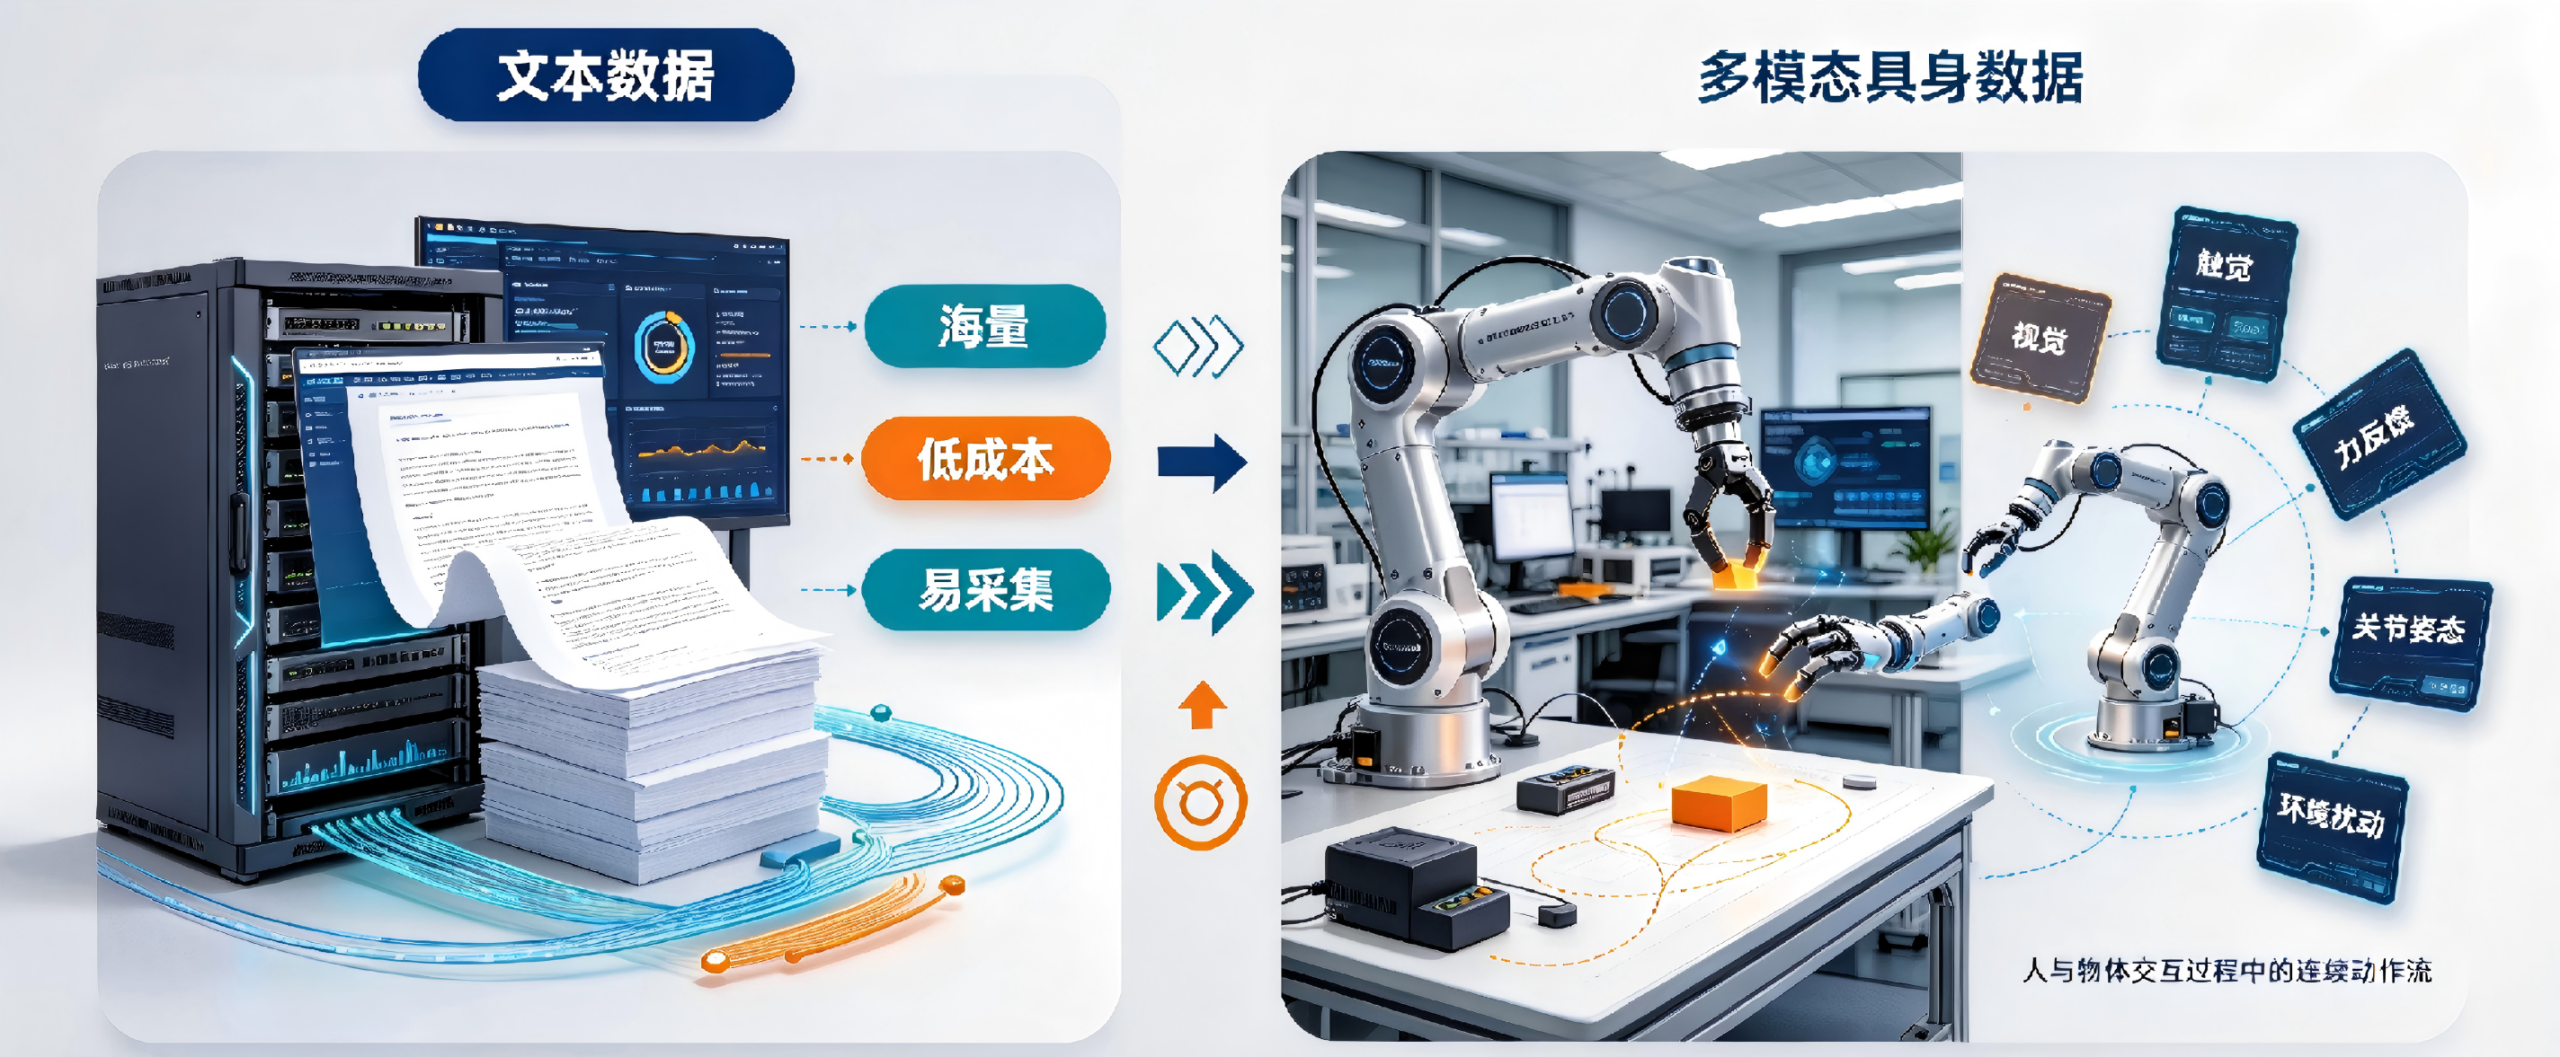
大语言模型的文本数据海量、低成本、易采集;但人形机器人需要的是多模态具身数据:视觉、触觉、力反馈、关节姿态、环境扰动,是人与物体交互过程中的连续动作流。
实验室里标准化环境产出的数据被业内称为“糖水数据”,场景简单、缺少随机扰动,泛化能力极差;而真实世界充满物体摆放变化、光线波动、突发干扰的“牛奶数据”,才是让机器人学会容错、自主调整的核心原料,但采集成本极高、标注难度巨大证券时报。
这就是当前行业不可忽视的显著矛盾:硬件产能逐步释放,但高质量真实交互数据供给严重跟不上模型训练需求。
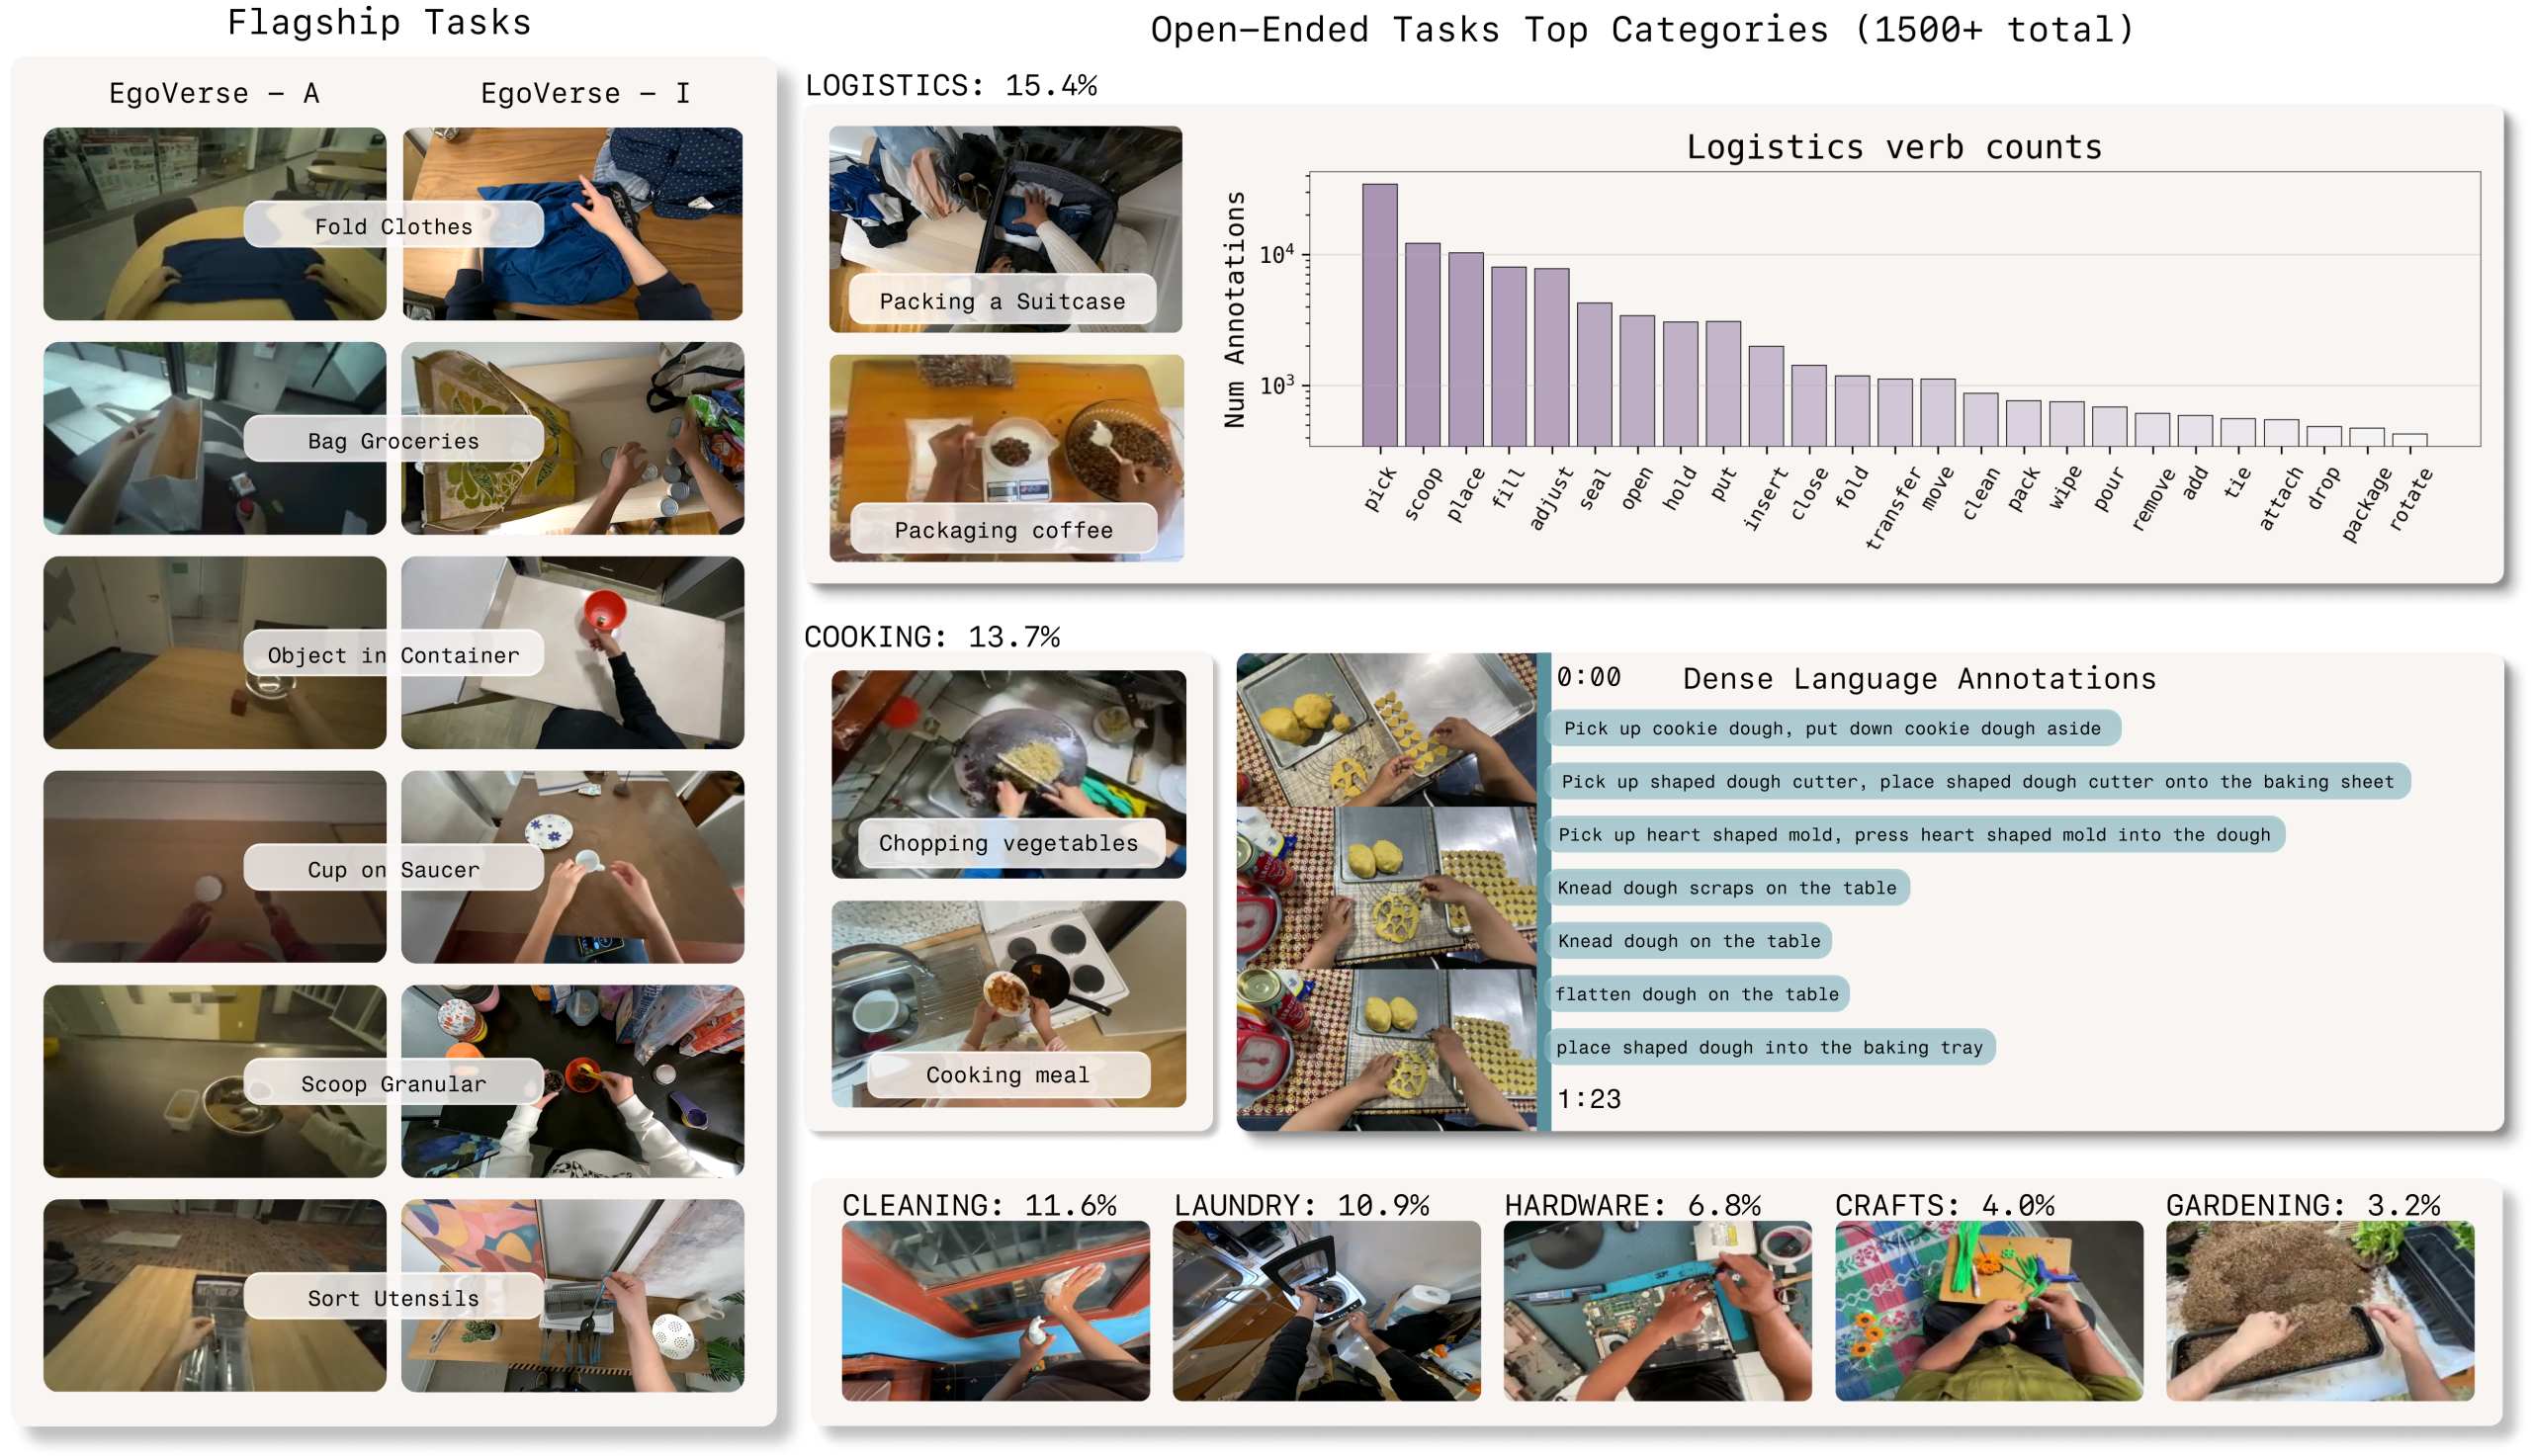
资本嗅觉最先发生变化,资金从减速器、本体制造,大规模转移到数据采集、数据处理、训练场基建赛道。其中的一大典型案例便是Mecka AI 拿到6000万美元B轮融资,由红杉领投,英伟达、微软 M12、高通、三星集体跟投。这家公司不造机器人本体,不做模型,专注机器人训练数据基础设施。它的模式是招募人员穿戴全身传感器,录制日常实操动作 —— 煮咖啡、组装零件、搬运物品,采集第一视角Ego数据,清洗处理之后打包供给机器人企业训练模型。团队阵容透露出一个行业信号:资本押注的不是一台机器,而是机器人学习所必需的数据引擎。
与此同时,全球多家厂商正在批量建设“机器人训练场”,本质就是搭建机器人的实体学校:通过复刻家庭、仓储、车间等真实场景,让机器人持续重复实操,自动采集动作与感知数据,闭环迭代模型。国内数据同样印证了这样的趋势,国内已经建成投用的具身智能训练场70家,在建、规划项目还有46家,人形机器人竞争正进入数据军备竞赛阶段。
02.
如何给机器人“攒经验值”?
值得关注的是,头部人形机器人公司正在用截然不同的方式解决数据缺口——而这些路线的分歧,可能决定下一阶段的行业格局。
路线1:重资产自建真机训练场,实景闭环采集
智元机器人选择自建数据工厂,通过遥操作采集。训练师通过遥操作设备操控人形机器人完成任务,机械臂抓取、分拣、装配,每一次操作的视觉、力控、关节数据都会完整记录。依托旗下觅蜂科技打造一站式物理AI数据平台,构建 “真机采集 + 无本体采集 + 仿真合成” 三类数据供给体系,计划2026年达到千万小时级数据产能,长期目标冲击百亿小时数据产能,数据产品对外向全行业开放,不只供给自家机器人。
优必选采用工业实景扎根的全栈闭环方案,在柳州、自贡落地工业级数据采集中心,把机器人部署到汽车、物流产线真实场景采集作业数据。同时牵头国内《人形机器人数据训练场建设规范》国家标准,统一采集、标注、处理全流程标准。思路很明确:一边在真实业务场景跑机器人,一边源源不断沉淀场景专属交互数据,业务落地和数据积累同步完成,数据反哺机器人作业精度提升,形成闭环增长UBTECH。
路线2:硬件规模化 + 开源生态,仿真与真机数据飞轮
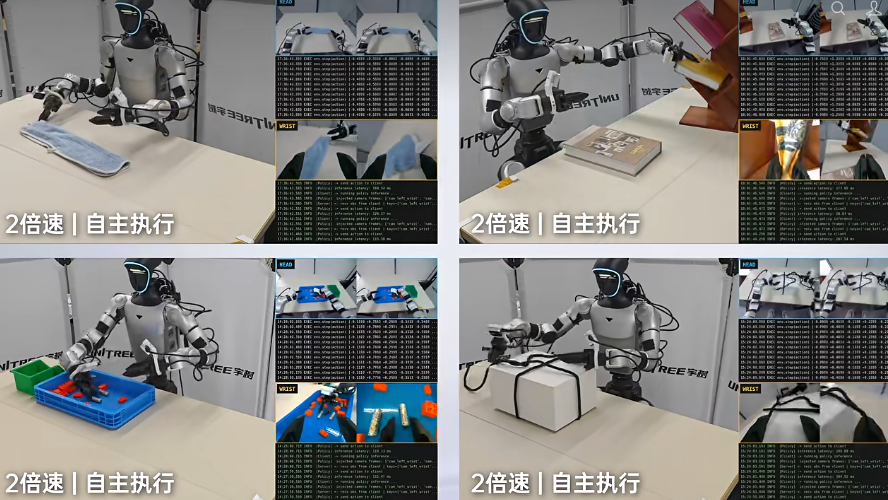
宇树的核心战略则是硬件规模化量产,依托自研电机、控制器的供应链优势,主打高性价比人形本体。如果盲目投入巨额资金修建大规模实体训练场,会显著抬高成本,拉长回本周期,与低成本规模化的定位冲突。因此宇树选择走 “真机采集 + 高保真仿真 + 开源社区共建” 的轻量化路线。
一方面基于 IsaacGym 等仿真引擎搭建高保真物理仿真环境,采用OASIS方案,在虚拟空间批量生成海量动作、障碍物、物体交互样本,低成本覆盖大量极端边缘场景,通过域随机化扩充视觉样本,降低真机试错成本。另一方面,宇树开源 UnifoLM-WBT-Dataset百万级真机数据集,包含数百小时来自G1人形机器人在工业操作、家居收纳、障碍通行等真实物理交互场景的动作轨迹数据,面向全球开发者开放,共建数据生态。当然这套方案短板同样清晰:仿真环境和真实物理世界存在 “现实鸿沟”,仿真生成的数据无法完全替代真机交互数据,最终依然需要真实场景数据完成现实对齐校准。
路线3:场景落地前置,在真实业务现场 “边干活边攒数据”
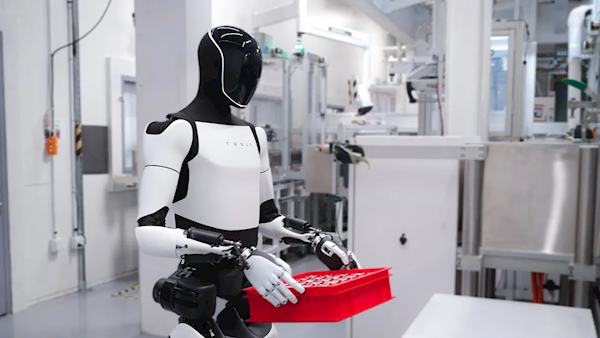
特斯拉Optimus的策略,是直接把机器人放进工厂产线,在真实生产环境持续作业采集数据。工厂场景固定、安全可控,机器人在执行分拣、搬运任务的过程中,持续收集视觉、触觉、碰撞反馈数据,再回灌模型迭代。这是典型 “以场景换数据”,一边验证生产力,一边积累稀缺真实交互数据。
除此之外还有专门做数据基础设施的独立厂商,比如帕西尼在国内多地建设全模态数据采集工厂,规划多座超级采集基地,目标年产近百亿条全模态交互数据,并且推出数据云商城,向全行业开放数据资产,定位人形机器人赛道的“卖水人”,专门供给行业通用高质量数据集。
03.
繁荣的另一面:数据工厂的 "虚火" 与退潮
数据基建赛道热闹了近两年,全国冒出了上百个数采中心,其中一部分却并没有收获预想的效果,而是在喧嚣之后悄然倒下。
北京首个人形机器人数据训练中心,2025年3月在石景山首钢园揭牌,一度是全国标杆——复刻了家庭康养、新零售、汽车装配等十余个实景场景,部署上百台机器人,靠遥操作采集。可运行不足18个月, 就在2026年8月悄然停运,合作方睿尔曼智能撤出了全部设备。运营方承认,实验室遥操路线不符合升级方向,采集的数据质量、精度没达到要求,“数据收入分摊到运营成本性价比太低”;睿尔曼方面也承认,这座中心本质仍是“实验室场景”,要真正“干活”,数据必须来自真实的生产和生活场景。换句话说,不是数采中心没用,而是“为采数而采数”的旧范式, 被现实证伪了。
这给行业提了个醒:数据工厂能不能走通,关键不在建了多少座、采了多少小时,而在数据有没有真正进入现实场景运作、数据飞轮能不能真正运转起来。
04.
数据本身就是资产
未来人形机器人公司的估值,不只看硬件参数,更要看自有高质量场景数据集规模、数据闭环迭代能力。没有持续数据供给的硬件厂商,即便造出机器人,模型能力会很快陷入停滞。
减速器、电机、本体制造,是机器人的身体;而高质量多模态交互数据,是机器人的“成长教材”。当硬件方案逐步趋同,数据基础设施将决定谁的机器人能走出实验室,在千变万化真实世界稳定干活。

推荐阅读





×
右键可直接复制图片