 阅读时间大约10分钟以上(4954字)
2026-10-19 “生成”还是“扫描”,世界模型正在分野
来源:具身元点
我想问的是,你们究竟在创造怎样的世界?
作者:北野五 出品:具身元点
20张房间照片,喂给OpenAI的GPT-6Astra,重建出一间客厅,沙发摆错了位置。
OpenAI给这个模型的官方三维重建分数是95.9,几何重合率接近满分。分数再高,位置还是错的。
坐标偏一点,机械臂就抓空。颜色偏假、材质偏塑料,这些反倒能将就。
10月14日的禾赛秋季发布会上,禾赛CTO向少卿把这组对比搬上了大屏。同一个房间,照片喂给GPT-6是一条路,新出的空间相机Kosmo是另一条路。这场发布会真正被追问的问题,不是画质差多少。
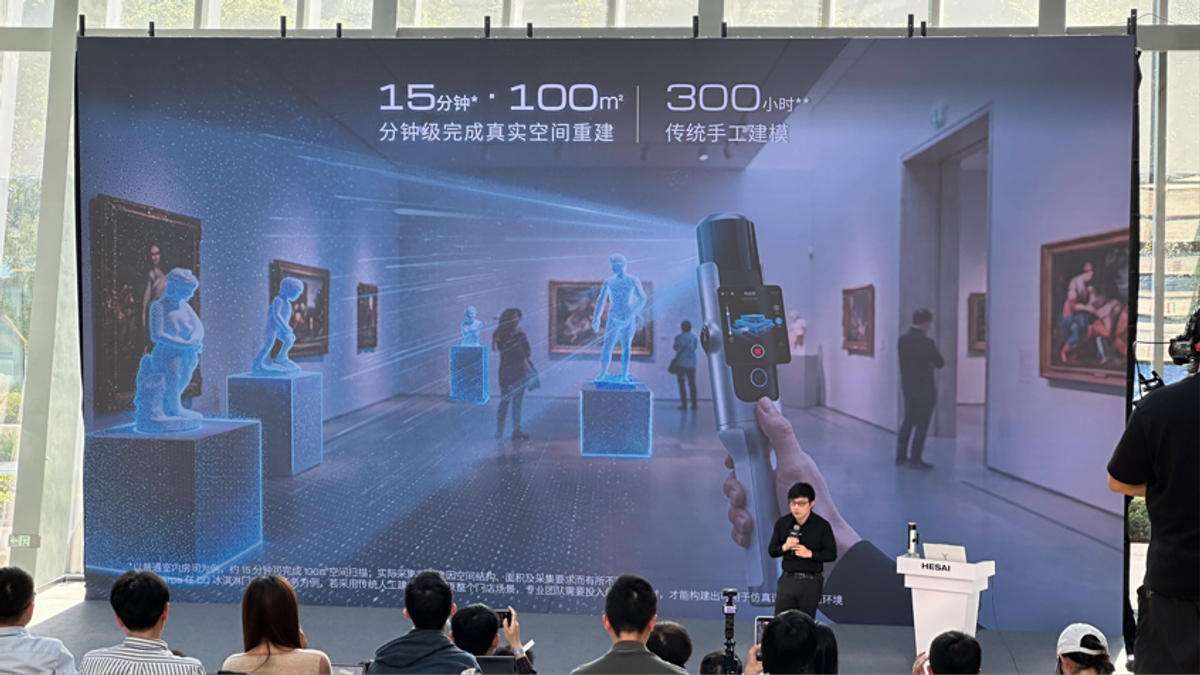
图注:大屏顶部的一行数字,15分钟扫完100平方米,对应下方是传统手工建模300小时。图片来源,禾赛秋季发布会现场照片
机器人干活要用的“世界”到底该从哪来?眼下没人能给出答案。分野是真的,谁赢是假的,真正在争的,是谁有资格定义机器人训练数据的标准。
01.
造世界和抄世界,眼下都撑不住训练
机器人训练需要“世界”。这个世界从哪来,一条是生成,用文字或者照片无中生有地造,OpenAI的GPT-6 Astra是这条路上最新的、也是目前最强的样本;另一条是采集,把真实房间原样扫下来,禾赛的Kosmo是这条路的样本。
这两条路谁也吞不掉谁。生成派造得出的世界看着像那么回事,抓不住东西;采集派扫得出的世界是真的,但贵、慢、还得靠人一台台设备往现场搬。把它们揉在一起的混合态,眼下没有一家跑通过。
所以这不是一场谁替代谁的比赛。真正的战场在别处,谁有资格定义机器人训练数据的标准。这件事今天没有人握住,禾赛的赌注也只是一个合理但未被证明的land grab,不是已经赢下来的位置。
02.
生成派:脑子越来越好用,眼睛跟不上
我们先来看一个数字,95.9分。
2026年9月12日,OpenAI发布GPT-6 Astra,同步推出一个叫BenchCAD的基准,测的是模型能不能从一组多视角渲染图反推回三维几何,也就是通过写CAD代码而不是直接生成网格。
Astra拿到的平均体素IoU是95.9%,上一代GPT-5.6 Sol是83.3%,Anthropic的Claude Fable 5.1是84.3%。官方还演示了它在Blender 里建模一栋房子,再导出到Unreal Engine 5变成一个能走进去的空间。
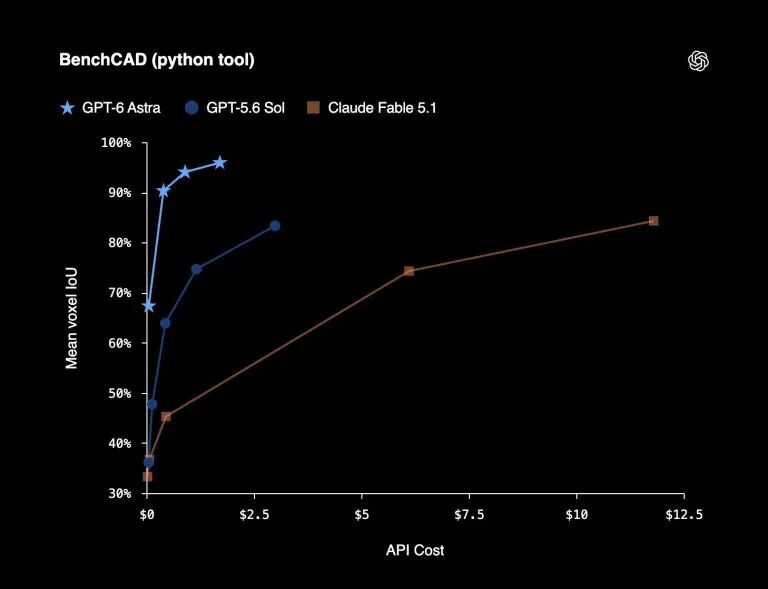
图注:OpenAI官方发布的BenchCAD 曲线图,横轴是API 成本,纵轴是平均体素IoU,三个模型的曲线并排。图片来源,OpenAI
关键在那个IoU的定义。平均体素交并比衡量的东西只有一个,重建出来的几何体跟原始物体重叠得有多准。它不测位置对不对,不测材质真不真,也不测生成出来的世界能不能拿去训练机器人。
这就解释了开头那个95.9分和一张错位沙发怎么会出现在一张幻灯片上。
这两件事之间的缝隙,学术圈已经吵了一年多,而且吵的方向跟禾赛发布会上演示的完全一致。
一篇2025年的3D高斯泼溅与扩散模型综述把话说明白了。现有的定量指标,比如PSNR和SSIM,优先看像素级保真度,根本不惩罚高斯表示特有的那些毛病,漂浮物、高频区域过饱和、拓扑不一致。指标看不见的失败,恰恰是机器人最受不了的失败。
另一篇论文说得更狠,回归方法几何上忠实但不完整,生成方法完整但经常不可信。原文的措辞是“visually compelling but structurally incorrect”,看起来很唬人,结构是错的。这一段几乎是禾赛演示的学术版复述。
这种毛病有名字。Janus效应,指的是生成式管线里二维扩散先验没法在多个视角之间强制出一致的三维几何,同一个物体从左边看和从右边看是两个东西。在稀疏视角重建的场景里,这种不一致被进一步放大。
这个毛病不是随机的,它有明确的来处。扩散模型的训练数据里,绝大多数图片都是正面拍的。
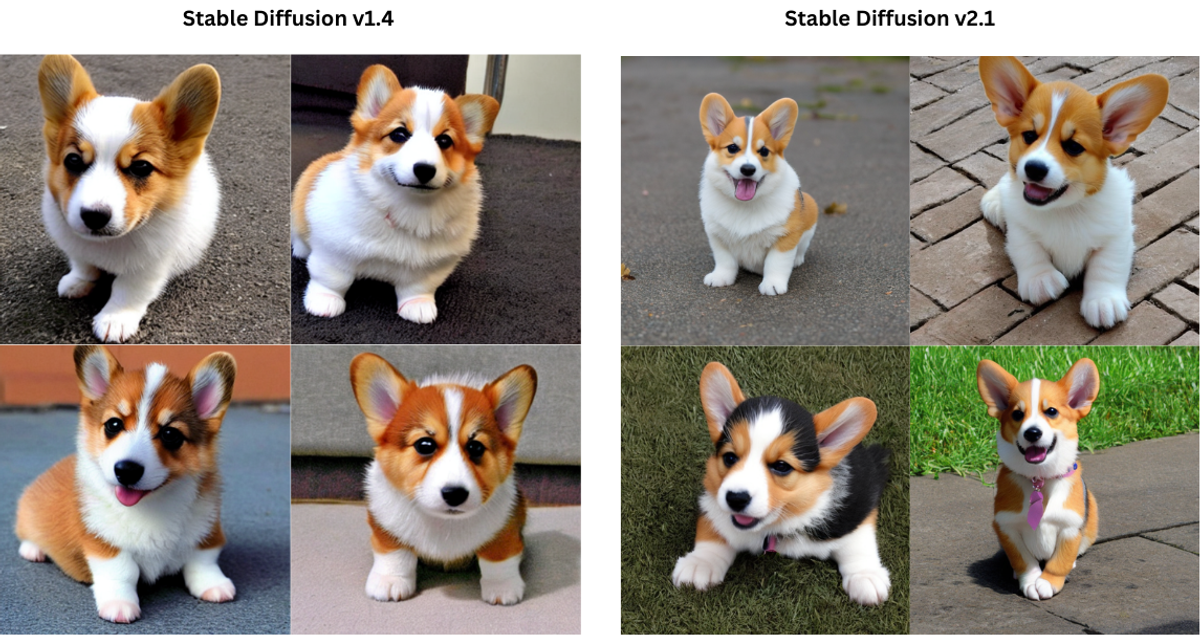
图注:同一提示词生成的全部样本,几乎都是正面朝向,左半为SD v1.4,右半为v2.1。图片来源,论文arXiv 2412.02287
这张图解释了Janus的成因。扩散模型学到的分布里正面样本密度极高,生成时它就倾向于把每个视角都画成正面。拿去当三维重建的监督信号,等于每次都告诉模型「从背后看也是这个样子」。侧面和背面压根没人管,三角面数却按正面那张图去长。
所以向少卿说材质不对、结构不对,不是挑刺。真实花被生成成塑料花,属于扩散模型把自己的先验往上糊;沙发位置错,属于多视角几何没人管。前者是模型太自信,后者是模型看不见。
生成派自己也知道这个短板。NVIDIA官方讲合成数据的时候,说的是合成数据要跟真实数据一起用,合成数据能扩展数据集,但不能凭空造出数据集。Omniverse NuRec这个库干脆直接把真实传感器数据转成OpenUSD交互式仿真场景,它的定位就是从真实扫描出发,不是凭空生成。
有一条线索更值得看。黄仁勋在2026年的技术大会上说过一句几乎是和生成派“对着干”的判断。光靠真实世界数据不足以训练物理 AI,因为现实世界的长尾边缘场景太多。NVIDIA的解法是把算力换成数据原料,合成运动生成管线11小时出78万条合成轨迹,约合6500小时、九个月的人类演示数据。合成数据混着真机数据,能把GR00T的性能提升约40%。
一个人说长尾场景太多所以要合成,另一个人说合成出来结构不对所以要真实。两句话都对,两句话放在一起,就是这个行业眼下真实的处境。
03.
采集派:禾赛只是其中一个玩家
再说采集派。得先说清楚一件事,真采加增广这条路不是禾赛开创的。
这条路上的玩家至少能数出一串。NVIDIA的Omniverse与Isaac体系,学术界NeRF和3D Gaussian Splatting的整套工具链,各类三维扫描与空间重建公司,群核科技这样从空间设计软件转过来的数据平台,以及各家机器人公司自研的数据采集闭环。
禾赛在这张图谱里的位置,是一家传感器公司试图把自己的硬件壁垒往上移到数据层。它开辟的不是一条新路,是挤进一条已经有人在走的路。
而且禾赛自己也不避讳这一点。发布会现场摆出来的另一面是Sharpa,一家由禾赛三位联合创始人二次创业的机器人公司,独立运营。禾赛的关节模组供货给Sharpa,Sharpa的操作数据回过来给禾赛。李一帆把这叫协同效应,并补了一句禾赛的使命不是服务Sharpa,是服务全行业。
但它同时也说明了采集派眼下最现实的状态,能让这条闭环跑通的,是股东关系。
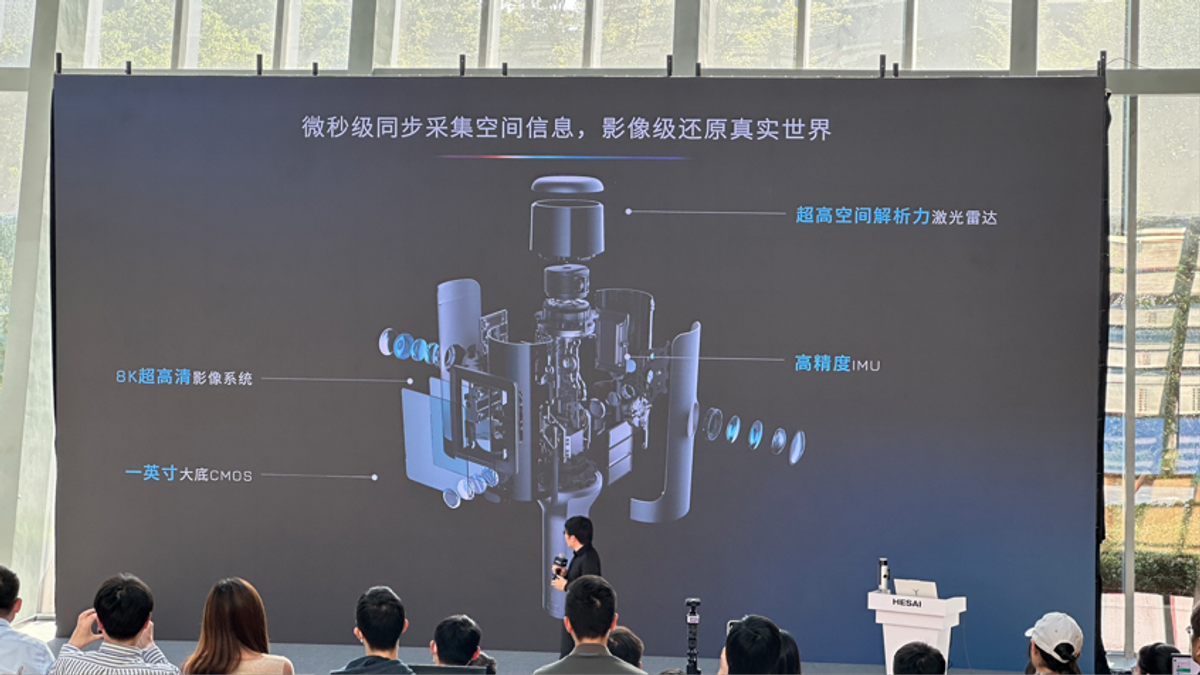
图注:大屏上标注的360度FOV指的是空间相机的覆盖范围。图片来源,禾赛科技Kosmo发布片
现在看禾赛那几个被反复引用的数字,每一个都值得追问。
100平方米15分钟vs300小时。这是发布会现场给出的实测数据。但比的对象是传统建模方法。传统建模是人工建模,指望人在3D软件里一砖一瓦搭。2026年自动重建方案已经不少,拿它跟手工作坊比,等于用计算器跟算盘比。跟同类自动方案比,差距会小得多,这个数字就不是它听上去的样子。
毫米级精度。机器人训练到底需要多高的几何精度,这个问题行业没有公认答案。假设一个机器人要抓取桌上的一杯水,把杯子重建到微米级,和重建到厘米级,对抓取成功率的影响可能小到测不出来。精度这个指标一旦量错了东西,多出来的部分就是溢出。
而且同样的发布会素材里写明,这个毫米级精度是在固定位置扫描时不断变得更清晰这个特质带来的,前提是在同一个机位反复扫。
扫一个房间生成无穷房间。这是全场最动人的一句话,也是最需要小心的一句。增广的质量上限被原始扫描死死卡着,一个房间扫出来的是这个房间的光照、这个房间的材质分布、这个房间的家具摆放。你在这个场景里换一百种物体排列,变的还是这间房的气质。真实的diversity是无穷的,一个房间的真相只有一份。
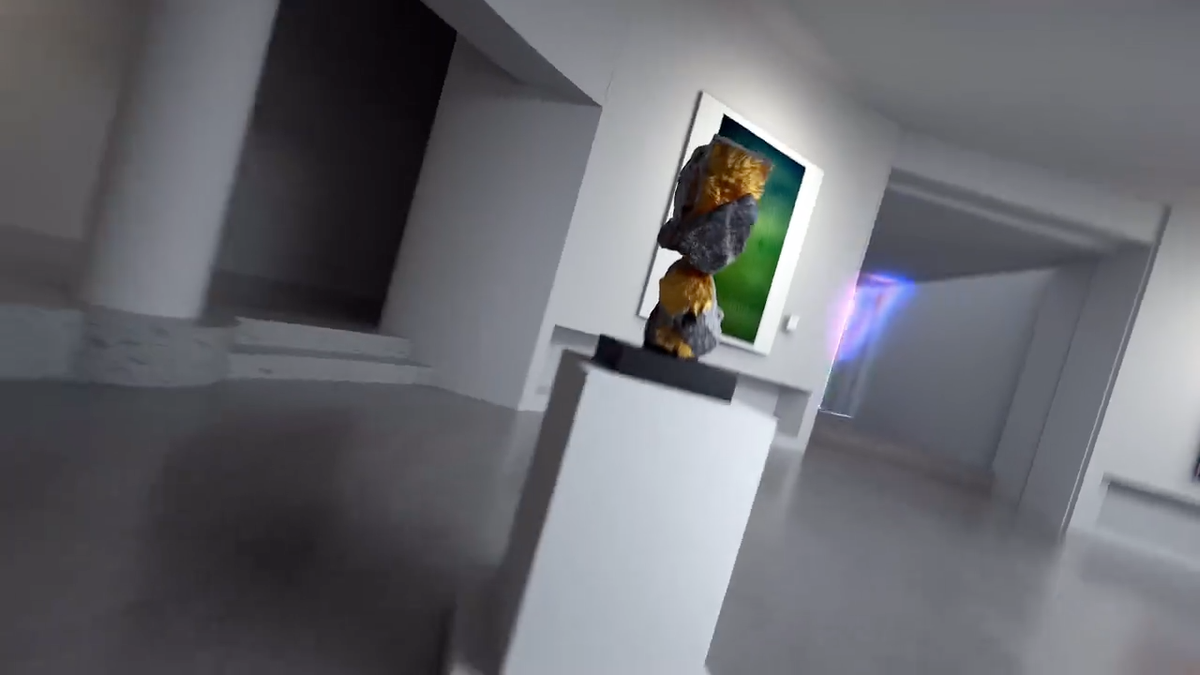
图注:重建后的室内墙面,家具轮廓被激光点云逐点记录,材质与光影一并保留。图片来源,禾赛科技Kosmo发布片
顺着这条往下问,会碰到一个行业公开承认的硬瓶颈。3D高斯泼溅在渲染质量上是当前主流,它的问题在于不具备结构化信息,所以只能用来看,不能用来用。群核科技在做3DGS重建的时候,专门做了两项工作的原因就是这个,InteriorGS给3DGS 补语义,SAGE-3D补碰撞体和物理属性,还有一套基于3DGS的VLN评测基准SAGE Bench。补齐这些,3DGS 才算能进训练流程的数据。
连禾赛自己的说法也是这个逻辑。向少卿讲Kosmo World的三个任务里,第一个是模型生成,第二个是场景编辑,第三个才是生态。能被机器人在里面推着走、能被当作训练环境反复用的能力,靠的是语义分割加智能补全,不是3DGS本身。
顺带一句智能补全,向少卿在演示里说沙发底下是模糊的,因为3D扫描没扫到下面,是AI理解那是地毯之后脑补出来的。这是全场最诚实的一句话,也是最需要被记住的一句话,采集派同样有一部分是生成出来的。
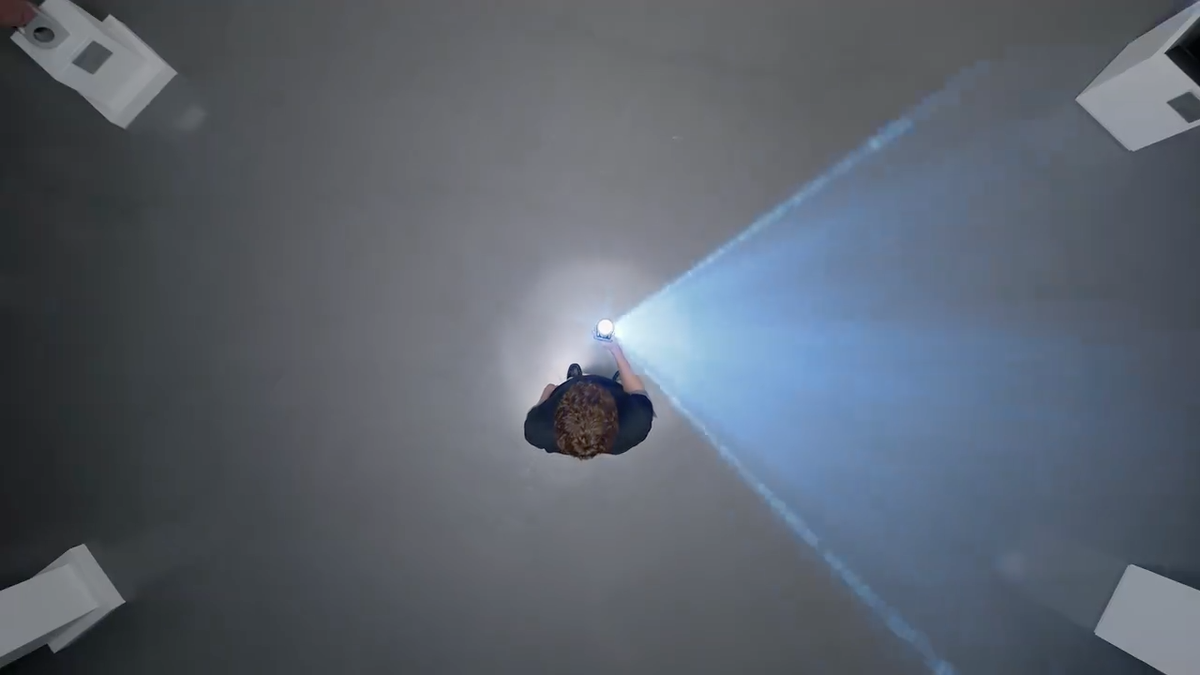
图注:空间相机在真实空间中作业,一台设备覆盖360度视野。图片来源,禾赛科技Kosmo发布片
图注:Kosmo One空间相机主机,一体式机身顶端为定制激光雷达。图片来源,禾赛科技Kosmo 发布片
04.
互补是真的,权利不对等
向少卿用了一个很好懂的比喻,GPT-6是脑子,Kosmo是眼睛加脑子。脑子越来越好,不会跟眼睛越来越好矛盾。人看到的世界,本来就是眼睛和脑子一起处理出来的。放在三维重建上,更好的眼睛配更好的脑子,重建结果只会更好。
这话没错。发布会上的演示也印证了,把Kosmo的3DGS数据当prompt喂给GPT-6 Astra,结构位置就对了,楼梯边上那些莫名其妙多出来的凳子和窗不见了,椅子的位置对了,但样子还是不对,材质还是不对,花还是塑料花。
眼睛给的是几何,脑子补的是材质和光影。这两件事分工清楚,互补成立。
但同一个演示,暴露了一件被这套比喻盖住的事。
把3DGS数据喂给模型,让模型按它生成更完整的场景,这个动作里,谁在给谁打工?
生成式模型的训练和推理,需要大量结构正确的三维数据作为约束。这是它的真实瓶颈。3D高斯泼溅的数据,恰恰是目前工业界最成熟、最可规模化获取的高保真三维几何来源之一。生成式用得上它,不是客气,是在依赖它。
所以禾赛把这段关系讲成眼睛和脑子平等协作,讲的是销售,不是产业现实。眼下采集派更像是生成派的上游供应端,卖的是原料和接口,不是平起平坐的标准制定者。
这个判断有一个很硬的第三方证据,它来自生成派自己。
WorldArena是一个专门评测世界模型对机器人是否真有用的基准,它不问生成的视频好不好看,问的是拿这些生成的轨迹去训策略,比拿真实演示训策略差多少。研究者的做法是,用六个不同的世界模型生成轨迹训策略,然后跟同一套策略在真实演示上训练的结果对比。
结果是,真实数据版本在两个任务上分别拿到77%和66%,大多数生成数据版本远远落在下面。结论一句话,当前的世界模型还不是训练策略的可靠数据来源。
他们的原话更狠,世界模型能扩展一个数据集,但不能创造一个数据集。它们能把你已经采到的东西换一批物体、换一批光照,底下那些演示,还是得从真机上采。
这句话把生成派替代采集派这个判断直接否掉了。同时它也给采集派留了一个不太舒服的位置,既然生成派绕不开真机数据,那谁掌握真机数据的来源,谁就有议价权。
05.
入口之争,以及两个都没解决的难题
真正的战场在这里,但得先把话说得冷静一点,机器人训练数据的标准,今天没有任何人定义得出来。
先说生成派的天花板,合成数据的有效性边界在哪?WorldArena的测试给了一个可量化的答案,在需要手部操作的任务上,生成数据训出来的策略离真实数据训出来的还差着一大截。看得像和用得上之间,隔着一条鸿沟。
再说采集派的天花板,成本降不降得下来,覆盖够不够广,增广能不能逼近真实多样性。这三个问题,禾赛都没有给出答案。15分钟一台设备确实是工程上的进步,但一台设备半小时,一个门店要扫几天,一个城市要多少台,成本曲线跟真机遥操作采集比,还是要看具体场景。禾赛自己的说法是累计接洽超过200家潜在合作伙伴,7月交付首批原型机,三季度起产生营收。这是起步,不是规模。
有一个判断经常被忽略,它恰好是采集派最难被绕开的那道门槛。
开头那只抓空的手,就是这道门槛的形状。机器人是要和物理世界交互的,它没有差不多这个选项。撞一个几何错了的门框,会撞坏。这就意味着结构错对机器人来说是致命的,不是不够好,是不能用。
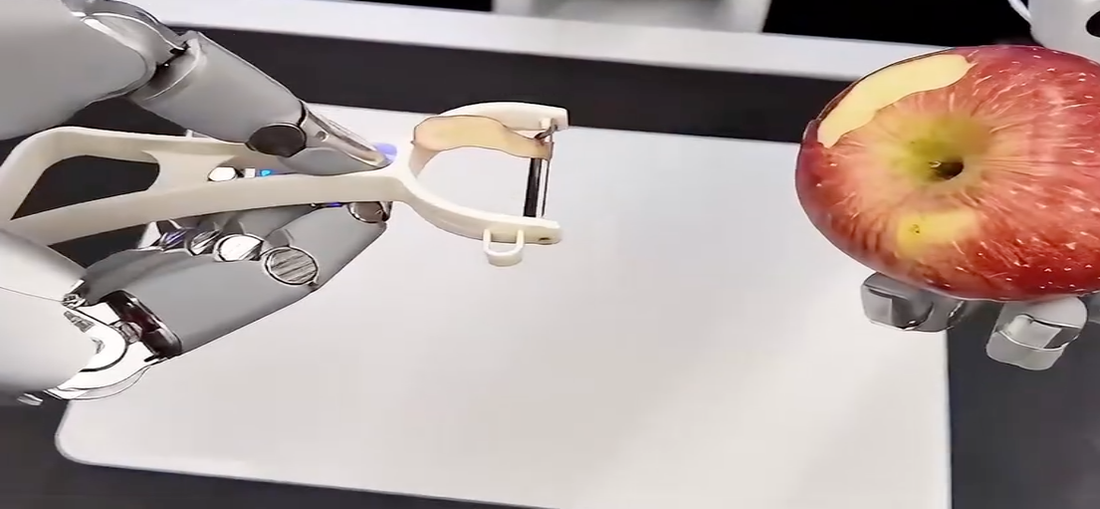
图注:禾赛三位创始人二次创业的 Sharpa,其灵巧手在做精细抓取。坐标准不准,看这个动作就知道。图片来源,量子位报道视频截图,B站账号量子位Daily
所以真实底座这条路线不是落后路线,是另一种刚需。它不保证赢,但它保证不犯那种一票否决的错。采集派的天花板也恰恰卡在同一个地方。贵、窄、增广有上限,这三条加起来决定它成不了唯一答案。
于是禾赛那笔赌注的形状就清楚了。把传感器壁垒上移到机器人训练数据的标准,逻辑上通顺,一家公司有制造能力、有传感器精度、有客户渠道,往上走一层做数据,天经地义。
但它同时被三件事夹击。扫描的成本和覆盖还没解决,增广的质量上限受原始数据约束,以及生成派正在反向依赖它的数据。
这不是一个已经成立的卡位。这是一笔合理的赌注。
06.
谁在卡位?
此情此景,我们能挖掘出真实的需求判断吗?我觉得是可以的。
先看融合,再看争夺。生成式消费采集数据当几何约束,这个动作已经发生了,接下来6到12个月会深化。融合得差不多了,抢标准的大戏才开。看点很具体,谁掌握约束的来源,谁就掌握定义权。
看真实世界数据这一层会不会独立出来。数据会变得稀缺,但稀缺不等于值钱。这一层的利润如果被硬件成本吃掉,那采集派就只是个硬件生意的延伸。禾赛接入了Omniverse、RenderMan、Houdini这三条生态,皮克斯还把这套工作流做成了官方教程向全球创作者开源,这个接入分量不轻。但要分清它是平台的定义者还是被平台收纳的接入者,方法很简单,看标准是谁写的,不是看标识出现在谁的页面上。
看硬件公司和模型公司的关系怎么变。供应商变成潜在竞争对手的老故事,在具身智能一定会重演。一个具体的观察点,模型公司会不会自己下场做采集,绕过硬件供应商。如果生成派自己就能造出结构正确的三维数据,那眼睛这门生意的议价权会被削掉一大块。
这三件事各自会怎么走,现在谁也说不准。能确定的只有一把尺子。它的数据能不能便宜到规模化,能不能覆盖到真实的多样性,是不是被生成式反向依赖。三条里缺一条,故事就还是故事。
95.9分能说明生成派的地板已经很高,说明不了它能替机器人干活。模型生成不出一个坐标准的世界,只靠原样复刻也长不出无穷无尽的空间。眼睛和脑子谁也离不开谁,混合态是唯一的终点,只是现在还没有人跑通它。
今天这两条路,谁都没有说服对方,也都没有把自己证明。真正的赢家,要等那个混合态被谁先跑通。
谁在解决真问题,谁在讲漂亮故事,自见分晓。

推荐阅读





×
右键可直接复制图片