 阅读时间大约9分钟(3292字)
2026-10-22 机器人学走路靠试错,学干活靠示范?讲清模仿学习与强化学习
来源:豆包
机器人运动与操作采用什么训练起点,关键在于示范是否可得、行为后果是否好评价、交互能否低成本重复。
先用同一个任务,分清两种学习方法
假设要教机械臂把杯子放进托盘,两种学习方法会怎样做?下面用这个任务作示意。
机器人需要根据相机画面、自身状态等观测决定下一步动作,必要时还会利用此前的信息。这套从观测到动作的模型或规则,就叫策略。它可以输出夹爪的目标位置,也可以输出关节目标。
一种办法是由人遥操作,记录每一刻的相机画面、机器人状态,以及操作者给出的动作。训练时,模型看到这些输入,学习给出与示范一致的动作。这是模仿学习(Imitation Learning,IL)的典型做法。
另一种办法是给行动的进展和结果打分,这个分数叫奖励,计算它的规则叫奖励函数。让策略尝试行动,记录观测、动作、奖励及后续变化,再用这些经验改进策略,这对应强化学习(Reinforcement Learning,RL)。
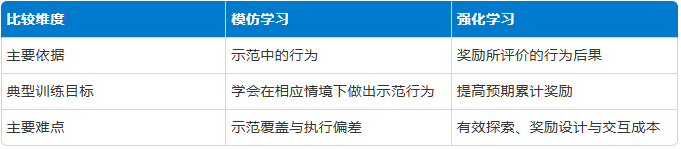
可以先这样记:模仿学习从示范中学行为,强化学习按奖励改进行为。后者关注累计奖励,也就是综合整个执行过程中的奖励,而不只看当前一步。两者可以在同一训练流程中结合。
下图左侧是从示范学习“观测到动作”映射的行为克隆,右侧是继续收集交互经验的在线强化学习,各代表一种典型训练过程。
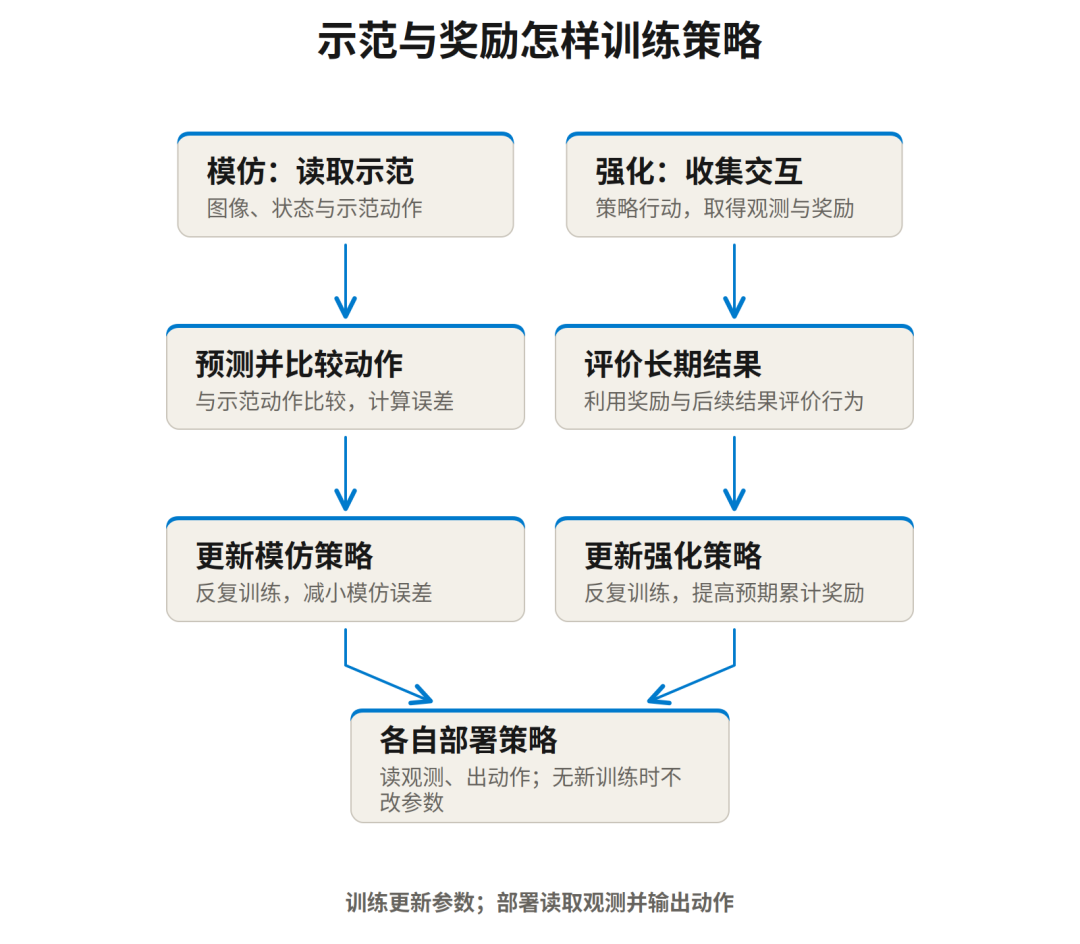
图中两条路径可以各自得到可部署的策略。训练时更新参数,部署时根据现场观测输出动作;读取了新画面、执行了新动作,并不意味着模型已经完成新一轮学习。
模仿学习:从示范中学会根据情况行动
把前面记录的放杯子示范交给模型:输入某一时刻的画面与机器人状态,让它预测对应动作,再根据预测与示范的差异更新参数。反复训练后,模型逐渐学会在相应情境下生成示范中的行为。
这种把示范中的观测和动作配对、训练模型学习对应关系的方法,就叫行为克隆(Behavior Cloning,BC),是模仿学习的一种常见实现。
训练时以示范动作为目标,执行时则根据现场情况预测动作。示范时杯子在左边,执行时稍微移到了右边,学得好的策略可以根据新画面调整抓取位置,而不是按固定轨迹把手伸向原来的位置。
但这种调整有范围。假设示范中的杯子通常竖着,机器人第一次抓偏却把杯子碰倒了,接下来看到的情况就可能是训练时很少遇到的。这叫分布偏移(实际遇到的情况偏离了训练数据)。
如果策略没能正确调整,又把倒下的杯子推远,后续抓取便可能更加困难。这就是误差累积:前面的错误改变现场,让后面的动作更容易出错。增加纠错示范、改进动作建模可以帮助策略应对偏差,具体适应范围仍要验证。
直接学习示范动作,可以采用不同的模型。ACT(基于 Transformer 的动作分块方法),全称 Action Chunking with Transformers,就是一个例子。它用 Transformer 这种处理序列信息的网络结构,读取多路图像与关节状态,一次预测未来一小段连续的关节目标,再交给底层控制器执行。
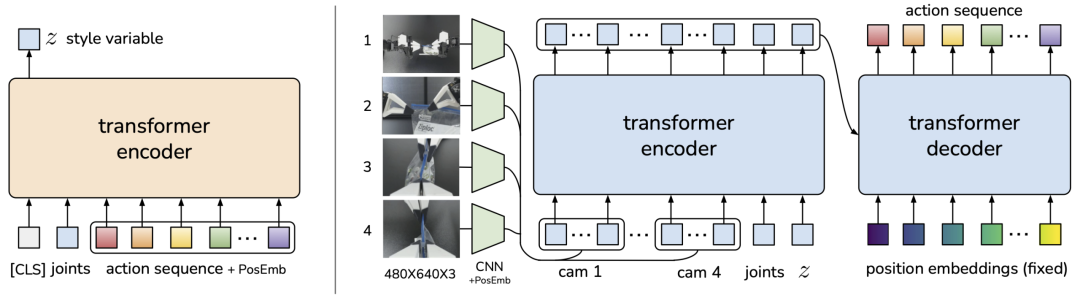
右侧策略把多路图像和关节状态等输入转换成动作序列;左侧编码器辅助训练,部署时不使用 | 来源:ACT 官方项目,论文 Figure 4 对应机制图
另一种代表性方法是 Diffusion Policy(扩散策略)。训练时给示范动作加噪,学习根据当前观测去噪;生成时从随机噪声出发,逐步得到动作序列。ACT 和扩散策略在这里都从示范学习,区别在于模型怎样表示和生成动作。
一次预测一段动作,通常称为动作分块,并不要求整段执行完才重新观察。扩散策略可以先执行其中一部分,再根据新观测生成下一段;ACT 则可融合多次预测中重叠的动作。
这些名字描述不同层次:模仿学习强调从示范中学习,Transformer 是网络结构,动作分块是输出方式。ACT 和扩散策略则是具体方法,不能与 IL、RL 并列当成互斥的训练路线。
从示范中学习,还有一条间接路径:先用逆强化学习(Inverse Reinforcement Learning,IRL)推断奖励函数,再利用推断出的奖励训练策略。行为克隆直接学示范动作,这条路径则让示范提供奖励的线索,再借助强化学习优化行为。
强化学习:学的是长期结果,不是每一步都有答案
仍然让机械臂放杯子。先设定奖励标准:成功放进托盘可以得到奖励,接近目标、保持抓取稳定等中间进展也可以纳入评价。机器人按当前策略行动,系统记录它看到什么、做了什么、得到多少奖励,以及环境随后怎样变化。
训练算法利用这些经验,估计哪些行为有利于提高累计奖励,再更新策略,使它在相似情况下更倾向于采取这些动作。接着继续执行、收集反馈、再训练,每轮都不保证一定提分。
策略负责行动,奖励提供评价,训练算法负责改进策略。这里通常没有逐步给定的正确动作,学习目标是提高整个任务的预期累计奖励。
难点是奖励可能很晚才出现:最后杯子掉了,原因却可能是最初抓得太浅。训练需要判断早期动作怎样影响后续结果。一些方法会训练价值函数,估计从当前情况继续执行能获得多少累计奖励,再据此帮助评价动作。
能判断最终是否成功,不代表容易教会中间怎么做。如果策略很少抓到杯子,只在任务完成时给奖励,就可能长时间得不到有效反馈。增加中间奖励可以帮助引导,但如果用“夹爪离杯子越近越好”代替真正的抓取进展,策略也可能只靠近杯子,却始终不完成抓取。
当成功难以探索到,或失败与复位代价很高时,直接从零做 RL 往往不划算。先通过模仿学习获得可用起点,再根据奖励改进,可以减少一部分无效探索。
上面讲的是在线 RL:更新策略后,机器人继续与环境交互,用新结果帮助下一轮改进。离线 RL 则在训练期间使用固定的一批执行记录,根据其中的观测、动作、奖励和后续变化更新策略,不再收集新的交互数据。
比如,已有记录显示,在相似情况下抓得太浅容易掉杯子。离线训练可以利用记录中的奖励与后续变化调整模型参数,让策略更倾向于产生有利于完成任务的动作。机器人此时没有重新尝试,策略却已经改变了。改后表现仍需另外验证,尤其不能轻信对旧数据未覆盖情况的判断。
在线与离线区分的是训练时是否继续收集交互数据,不能据此判断是不是模仿学习。示范记录在包含所需奖励与后果信息时,也可以用于离线 RL。
为什么运动常用仿真 RL,操作常从示范起步
对于按给定速度行走这类目标明确的任务,评价行为、搭建可用仿真和重复试错,往往比面对多样物体的操作任务更容易组织起来。身体协调、平衡和抗扰动本身仍然很难。
比如,实际速度与目标速度的差距、身体姿态、能耗等可以参与评价;仿真中能同时运行多个机器人,摔倒后自动重置,继续尝试。明确的评价和低成本重复交互,为 RL 提供了可规模化的训练路径。训练时改变摩擦、质量、地形和延迟,还能提高一定范围内的适应能力;人类动作或其他策略也可以提供训练参考。
这条路径仍要跨过仿真到真机的差异,包括动力学、执行器和接触情况。给定测试中的运动能力,也需要在换负载、更强扰动或长期连续作业时重新验证。
操作任务常面对另一笔成本:除了机器人自身,还要处理它与不同物体的交互。杯盖、电池、布料的几何与接触方式不同,要建立足够准确的物体模型,再为每种任务定义怎样才算有进展,并不轻松。真机尝试失败后,还要把物体和场景恢复到可以继续训练的状态。
在这些条件下,先从示范起步,往往比从零探索更直接:先学会从哪里抓、按什么顺序做,再考虑怎样提高稳定性。ACT 就选择直接从真实示范学习,以避开复杂操作场景的仿真建模难题。操作任务同样可以使用 RL,关键在于能否提供有效的探索、评价和重复交互。
当机器人既要走、又要操作时,就要同时面对这些训练条件,考虑怎样组合两种方法。
两种方法,可以在训练阶段结合,也可以在系统里分工
先看同一个策略怎样继续改进。视觉—语言—动作模型(VLA)根据画面、语言指令等信息生成机器人动作。π*0.6 采用的 RECAP 训练方法,把示范、机器人执行经验与人工纠正结合起来,用强化学习改进这样的策略。
RECAP 利用任务是否成功及执行过程中的步数构造回报,训练前面提到的价值函数:估计从当前情况继续执行,到成功还需要多少步,并让失败对应较低价值。再结合一段行动得到的奖励和后续价值,估计这段行动比原先预期好多少,这种相对改善称为优势。
训练时,它根据估计的优势给动作加上高、低两类条件标签,让策略学习相应条件下的动作。执行时指定高优势标签,引导策略生成更有利的行为。实际效果仍取决于价值估计和策略学得是否可靠。
失败尝试由此参与价值判断和行为区分,无须被当成正确动作模仿。收集到新的执行经验与人工纠正后,再更新价值函数和策略,进入下一轮改进。
另一种组合,是让不同策略在系统里配合。UMI on Legs 的上层从真实示范学习视觉操作策略,根据相机画面生成夹爪未来应经过的位置与朝向,也就是末端轨迹。
这条轨迹最初以相机为参照。系统把它转换到任务坐标系,即执行任务时使用的统一位置与朝向参照,再交给仿真 RL 训练的全身控制器。这样,身体和相机移动时,下层仍能围绕同一任务参照跟踪夹爪目标。
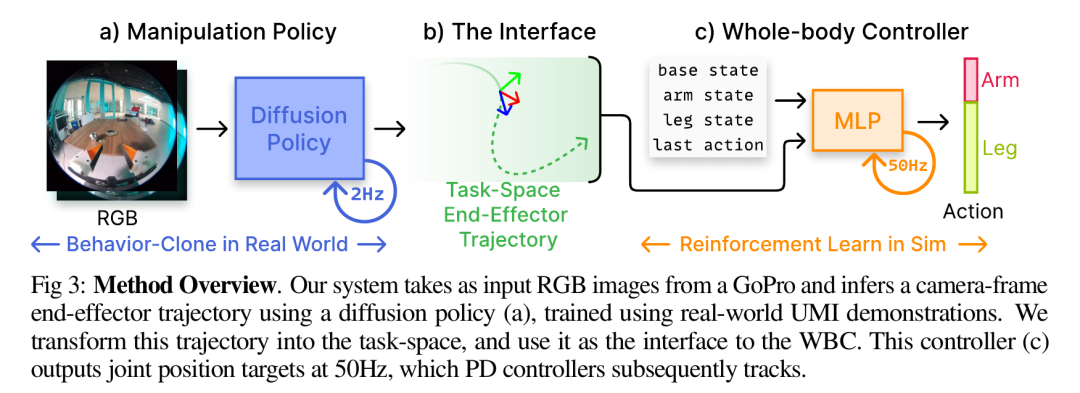
左侧通过真实示范学习操作,中间用末端轨迹连接,右侧结合身体状态控制手臂与腿;频率对应论文中的具体系统 | 来源:UMI on Legs,Fig 3
下层结合当前身体状态,输出手臂和腿的关节目标,让身体移动时仍尽量跟住夹爪轨迹。这里的分工是上层生成操作轨迹,下层协调全身去跟踪,而不是把模仿学习分给手、把 RL 分给腿。上层目标仍可能超出身体可达范围,下层不能保证执行任意轨迹。
我更愿意据此判断训练方案:示范能否提供可用起点,奖励能否区分更好的行为,交互环境能否支持持续改进。把这三个问题问清楚,才知道该在哪一部分模仿、在哪一部分试错,以及两者怎样接起来。

推荐阅读





×
右键可直接复制图片