 阅读时间大约7分钟(2600字)
2026-10-26 StereoPolicy:机器人学动作,可以跳过深度图
来源:豆包
StereoPolicy 通过动作训练学习融合左右图像,让机器人利用双目空间线索,无需先生成深度图或点云。
作者:我不是毛毛 出品:具身智能前沿
把杯子挂上去,先要看清哪些关系
机器人识别出杯子和挂架,还得把杯把的开口对准挂钩。杯把偏前还是偏后、夹爪应该怎样靠近,都会影响最后能不能挂上去。
常见的一条路径,是先得到深度图,再结合相机参数还原为三维点云,供动作模型使用。深度图为像素提供深度值,点云则用空间中的一组点描述物体形状。但遇到透明玻璃、反光表面和细小杯把,重建出的几何可能缺失或失真。动作模型拿到这些结果后,还得据此判断怎样靠近、怎样对齐。
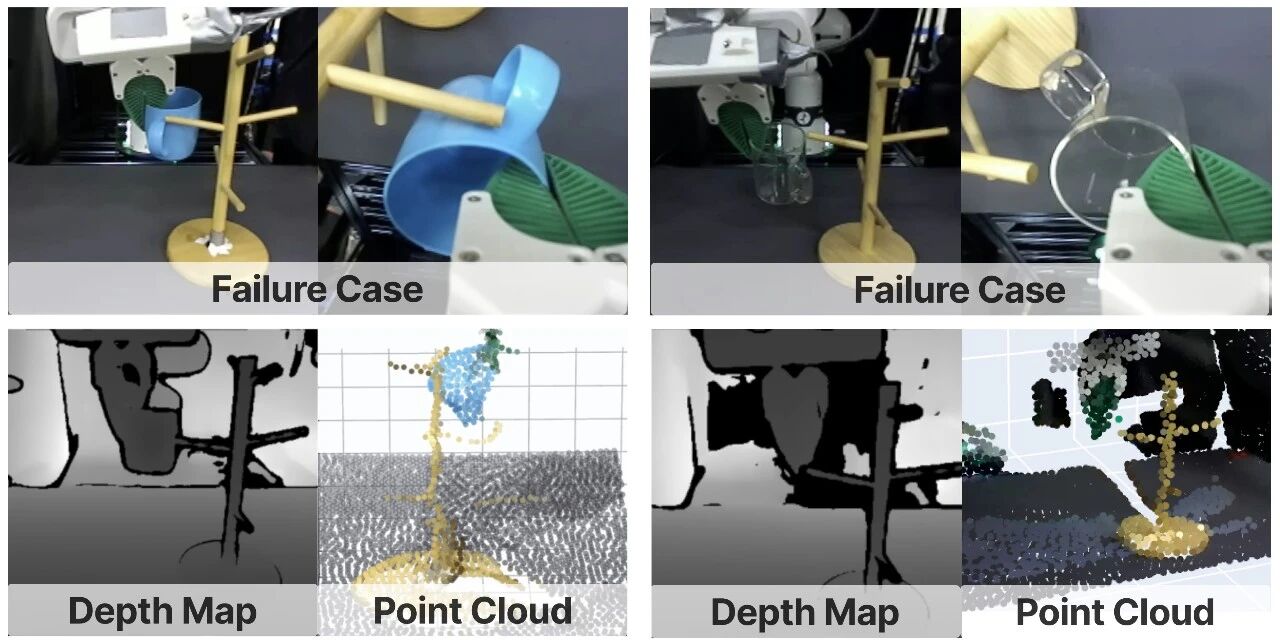
上方为普通杯与玻璃杯的操作画面,下方为对应深度图和点云;留意杯把细节与玻璃杯表面的缺失 | 来源:StereoPolicy v3,Figure 7
StereoPolicy 探索了另一条路径:把同步拍摄的左右图像直接送进动作学习系统,让模型利用两幅图中的空间线索。这里的策略,就是根据观测和机器人状态生成动作的模型。
这项由斯坦福大学、西北大学与 Lambda 合作的研究,首次公开于 2026 年 5 月 11 日,9 月 27 日更新到 v3。它把问题从“先重建出怎样的三维场景”,转向了“怎样从左右图像中提取有助于动作的信息”。深度图不再是动作生成的必经中间输出,空间关系则交给训练后的视觉特征表达。
两张图先各自编码,再让左右特征交流
双目相机从两个相邻位置同时观察同一场景,同一个杯把在左右图中的位置会有差别。这种位置差称为视差,是双目视觉获得空间线索的重要依据。
StereoPolicy 先用二维视觉编码器处理左右图像。编码器把像素变成特征,保留有助于识别物体、边缘和局部结构的信息。左右两路共享权重,也就是使用同一套提取规则;这让特征更容易比较,但不会自动把左右像素配成正确的一对。
接下来是负责融合两路特征的 Stereo Transformer。它通过注意力机制,根据特征之间的相关性汇集信息:自注意力在一幅图内进行,交叉注意力让左图特征读取右图信息,反过来也一样。两种注意力交替使用,使图内的局部结构与跨图的对应线索共同参与融合。
以挂杯子为例,左图中杯把附近的特征可以结合右图中的相关区域,形成比单张图更有用的表示。模型学习如何使用这些对应线索,输出仍是供策略读取的特征,并不逐像素报告距离。
为让位置参与这种比较,模型还使用二维旋转位置编码(2D RoPE),把图像中的横纵坐标信息加入注意力计算。这样,融合时不仅能比较特征内容,也能利用它们在图中的位置。
论文的桌面系统还有两种观察位置:外部视角和腕部视角。每个视角各有一对左右图像,先在各自的双目对内融合,再汇集两个视角的表示。外部相机与腕部相机并不是这里所说的左右两目。
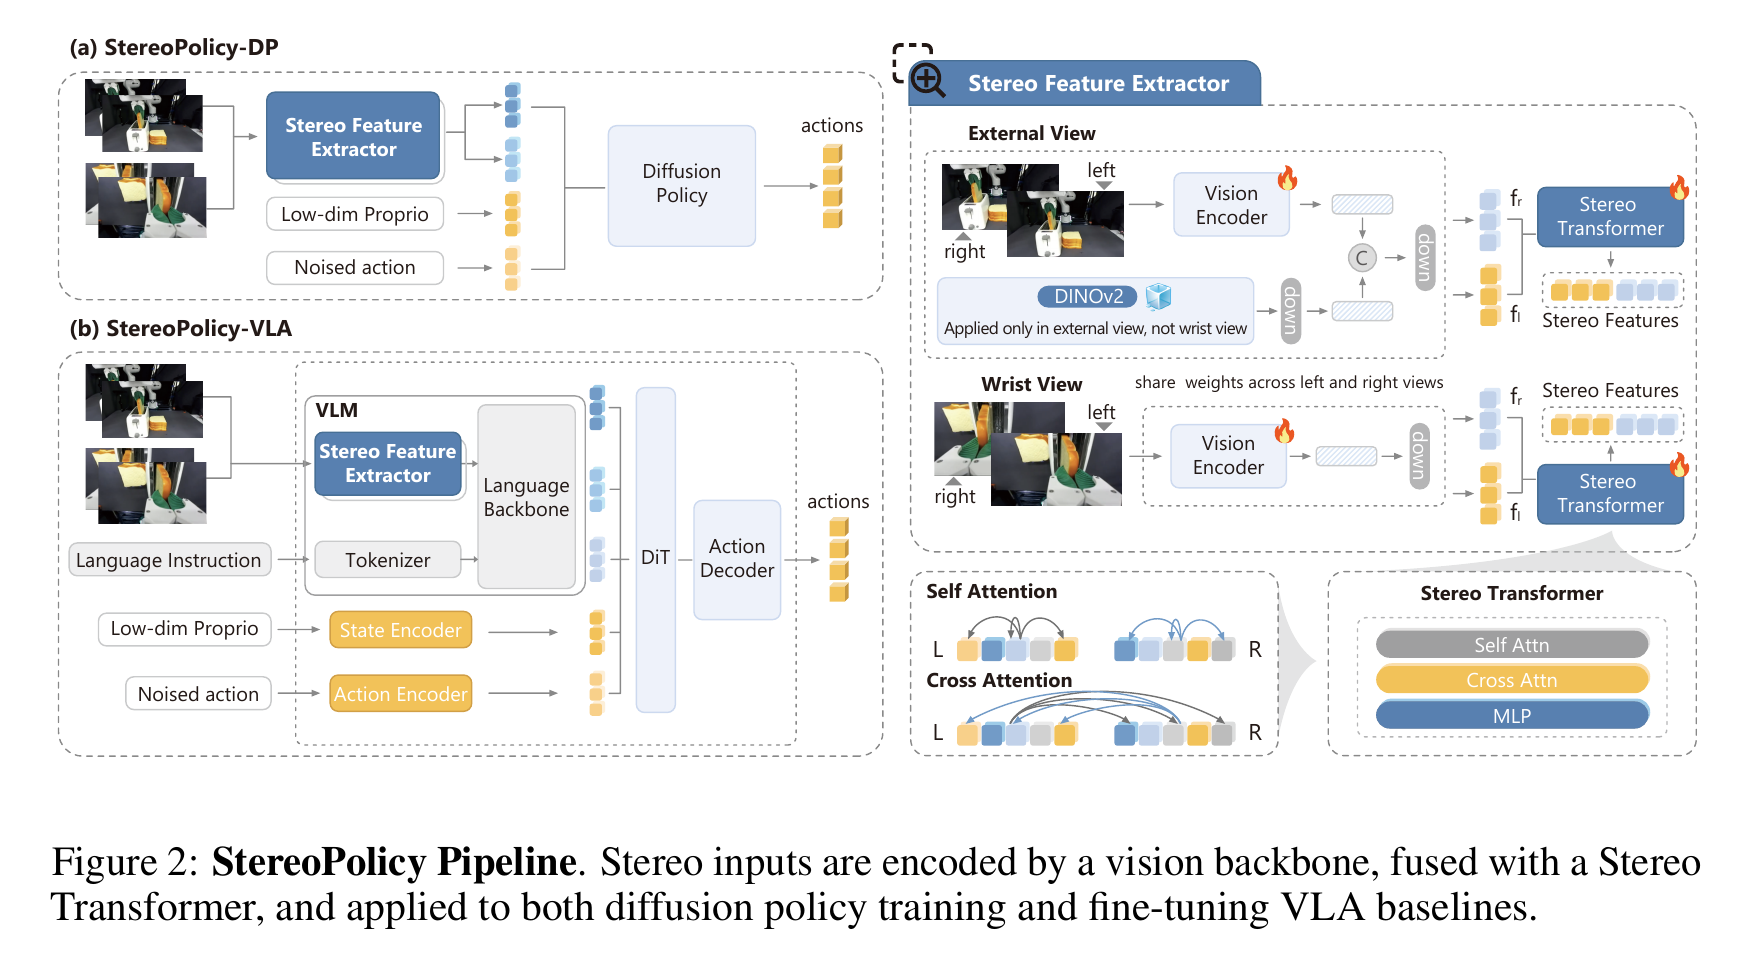
右侧展开双目编码与融合;左上接扩散策略,左下接视觉语言动作模型。外部和腕部视角各自完成双目融合 | 来源:StereoPolicy v3,Figure 2
图中还有 DINOv2,这是一种预训练图像特征模型。作者把它的冻结特征加入外部相机分支,补充通用视觉信息;腕部视角则不添加,因为实验中这样接入反而降低了表现。
用示范动作,训练双目特征
融合模块提供了左右特征交流的方式,但哪些线索有用,还要通过动作训练来学习。
在模仿学习中,训练数据包含机器人当时的观测,以及示范者完成任务时的动作。StereoPolicy-DP 中的 DP 指扩散策略,它根据观测生成一段连续动作,采用的是逐步去噪的方式。
训练时,先给示范动作序列加入噪声,再让模型根据视觉特征与机器人自身状态,预测加入的噪声。预测误差用于更新参数,视觉编码器、双目融合模块和动作策略一起优化;前面提到的 DINOv2 保持冻结。
这意味着,同一个动作训练目标,同时约束视觉编码、左右融合和动作生成,不需要逐像素的真实深度作为监督。以挂杯子为例,示范动作告诉系统在这组观测下应该怎样移动;噪声预测的误差又沿着网络传回视觉部分,调整它提取和融合信息的方式。杯把与挂钩的空间关系,就可以通过这条路径影响特征学习。
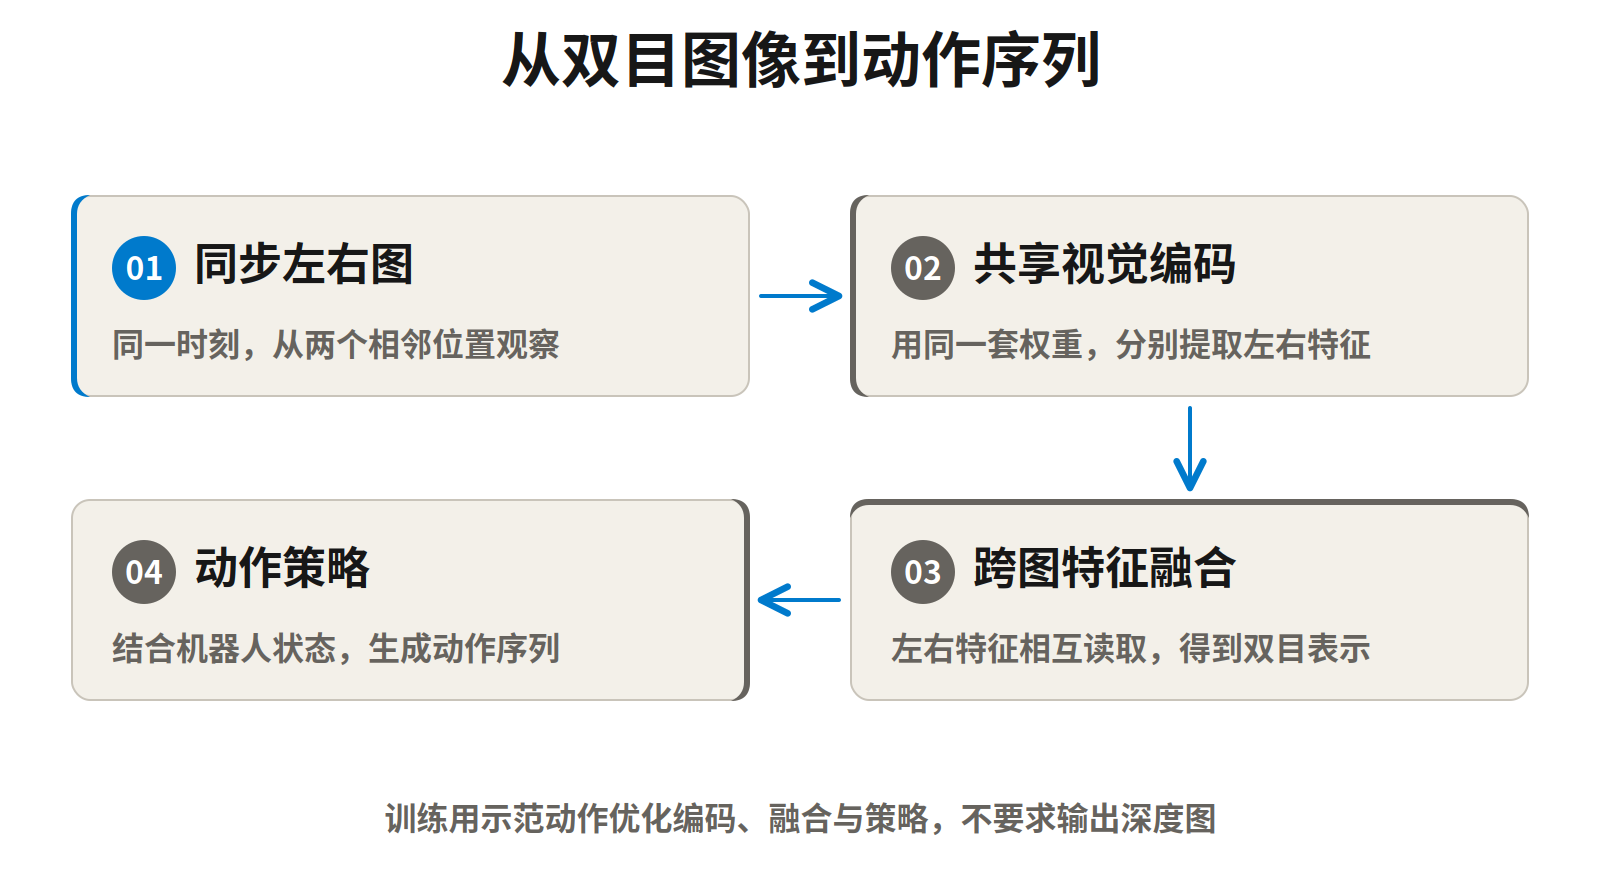
执行时,模型接收新的观测与状态,从带噪的动作序列开始,反复去噪生成动作。它不需要现场再拿到示范动作,也不在每次执行时重新训练。
另一个版本 StereoPolicy-VLA 接入视觉语言动作模型,也就是把图像、语言指令和机器人状态用于动作生成的模型。它用融合后的双目表示替换原先的单目视觉表示,再对整个系统做任务微调。保留骨干架构,并不意味着接上两只相机就能直接使用。
论文还做了一个检查:冻结学到的视觉特征,训练简单的线性读出模型,估计夹爪与目标的相对深度。动作训练后的特征在测试轨迹与布局上误差更低。这支持表示中含有可读出的几何信息,但不能据此认定模型内部生成了一张完整深度图。
增益来自第二幅图,也来自怎样融合
多给一幅图,会不会已经足够?作者为此设置了多视角基线:使用相同的左右图像,分别提取特征后直接拼接,再送进策略;同时调整容量,使其与 StereoPolicy 接近。
这使比较集中到融合方式,而不只是相机数量或模型大小。
消融实验进一步改变输入或移除组件,观察结果怎样变化。在工具悬挂、方块装配和倒水三个仿真任务中,完整模型平均成功率为 84.0%;把左右输入改成两份相同的左图后,降为 62.7%;移除 Stereo Transformer 后,则为 70.0%。前一个对照保留两路输入,却拿掉了左右图像的差异;后一个对照则检查融合模块的作用。
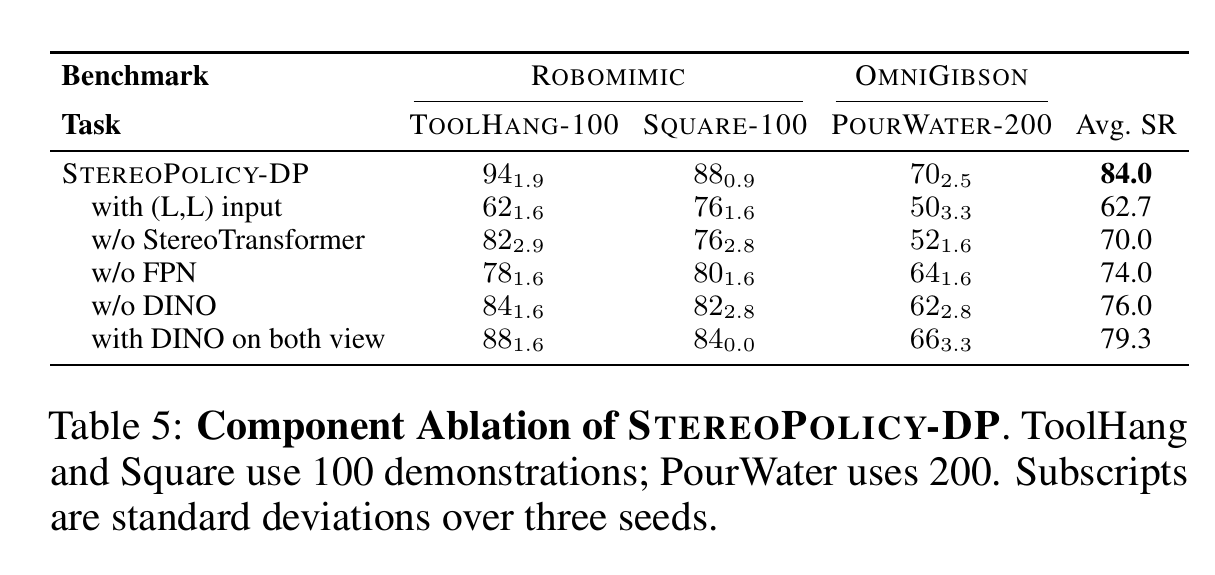
重点看完整模型、复制左图输入和移除融合模块三行;三个任务的演示数量不同,下标为三个训练种子的标准差 | 来源:StereoPolicy v3,Table 5
这些对照支持一个具体判断:在这些任务和训练条件下,真实双目输入与跨图融合共同帮助了动作学习。两项改动分别削弱了完整模型,下降幅度不能相加算成各模块的独立贡献。
真机平均 59%,玻璃杯仍是难题
真机桌面实验使用 Franka 机械臂,配置外部与腕部双目相机。五项任务分别是放香蕉、插吐司,以及悬挂塑料杯、钢杯和玻璃杯;每项收集 200 条示范,测试 20 次,并随机改变初始位姿。
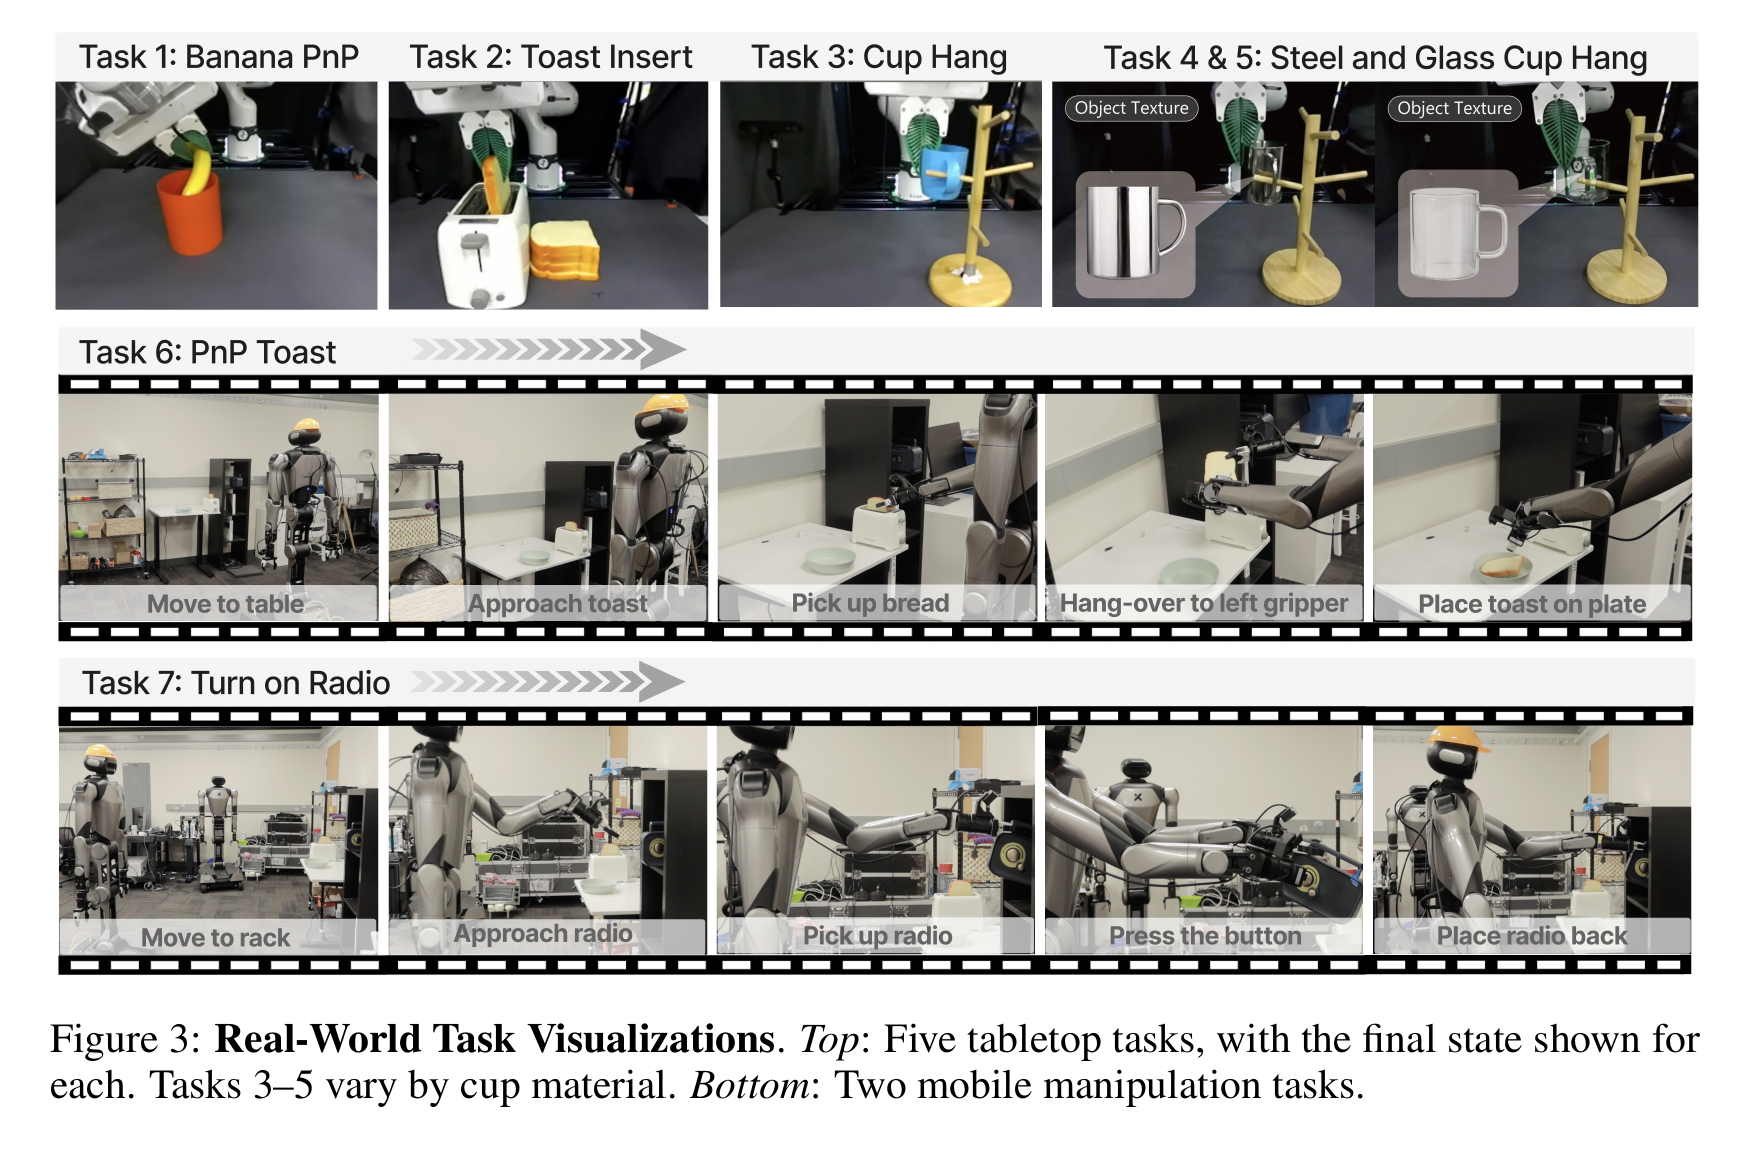
上排为五项桌面任务,下方为两项双臂移动操作任务;画面用于识别任务,成功率来自论文对应评测 | 来源:StereoPolicy v3,Figure 3
五项桌面任务中,StereoPolicy-DP 平均成功率为 59%,单目 RGB 为 43%,相差 16 个百分点。同时输入彩色图像和深度图的 RGB-D 为 41%,直接拼接特征的多视角基线为 45%。这些数字来自论文评测;每项任务测试 20 次,仍不足以推断长期运行的可靠性。
点云结果也要区分具体实现:PointNet 编码方案为 14%,DP3 编码方案为 27%。这些比较反映的是论文使用的传感器、预处理、模型和任务组合,不能概括成点云路线普遍无效。
更需要单独看的是玻璃杯:StereoPolicy 只成功了 3/20 次。避开不可靠的深度重建,仍然消除不了折射、弱边界和细杯把带来的视觉歧义。总体均值的改善,尚未让这项困难任务变得可靠。
省下重建之后,输入条件仍然重要
StereoPolicy 使用同步、经过校正的双目图像。同步保证左右图记录同一时刻,双目校正则让对应点大致位于相同的图像行,便于利用左右位置差异。不输出深度图,仍然需要满足这组输入条件。
相机间距、物距、左右视野重叠和训练配置都会影响效果。论文在工具悬挂任务中,用 6 厘米相机间距训练,测试时保持该间距成功率为 94%;改为 4 厘米和 8 厘米后,分别降至 86% 和 88%。它容忍了一定变化,但最好结果仍出现在训练配置。
我更看重这项研究提供的选择:当目标是完成具体操控任务时,可以把双目特征与动作策略一起训练,让空间线索直接服务于动作生成。是否适合自己的系统,要在目标任务上检验对齐精度、成功率和执行条件;若下游还需要明确距离、三维地图或几何测量,就要另外提供相应的输出。

推荐阅读





×
右键可直接复制图片