 阅读时间大约10分钟以上(5126字)
2026-10-27 为什么SuperMimic引起了社区的关注,也为什么值得关注
来源:豆包
SuperMimic将这件事从百卡集群、一周训练,推进到了单卡数小时。
作者:Marilyn 出品:具身纪元
把十几万条动作交给同一个人形机器人控制器,训练成本能压到多低?SuperMimic 将这件事从百卡集群、一周训练,推进到了单卡数小时。
此前,SONIC 使用 128 张 L40,训练了七天。SuperMimic 只用一张 H100、三个小时,动作跟踪表现就超过了 SONIC 已发布模型。按公开云租价折算,两者的训练费用约为 1.7 万美元和 10 美元。
Pieter Abbeel 在 X 上称它为“Game changer”。
社区也迅速掀起了复现热潮:有人公开了用 AI 编程助手完成的 LAFAN1 实现,单张 RTX PRO 6000 训练约 1.47 小时,就在 40 条动作上做到零失败;有人开始拿自己的 RTX 5090 尝试。
小红书也开启了复现热潮。妙动科技的创始人 YY硕,特意截取了群中关于复现 SuperMimic 的讨论。
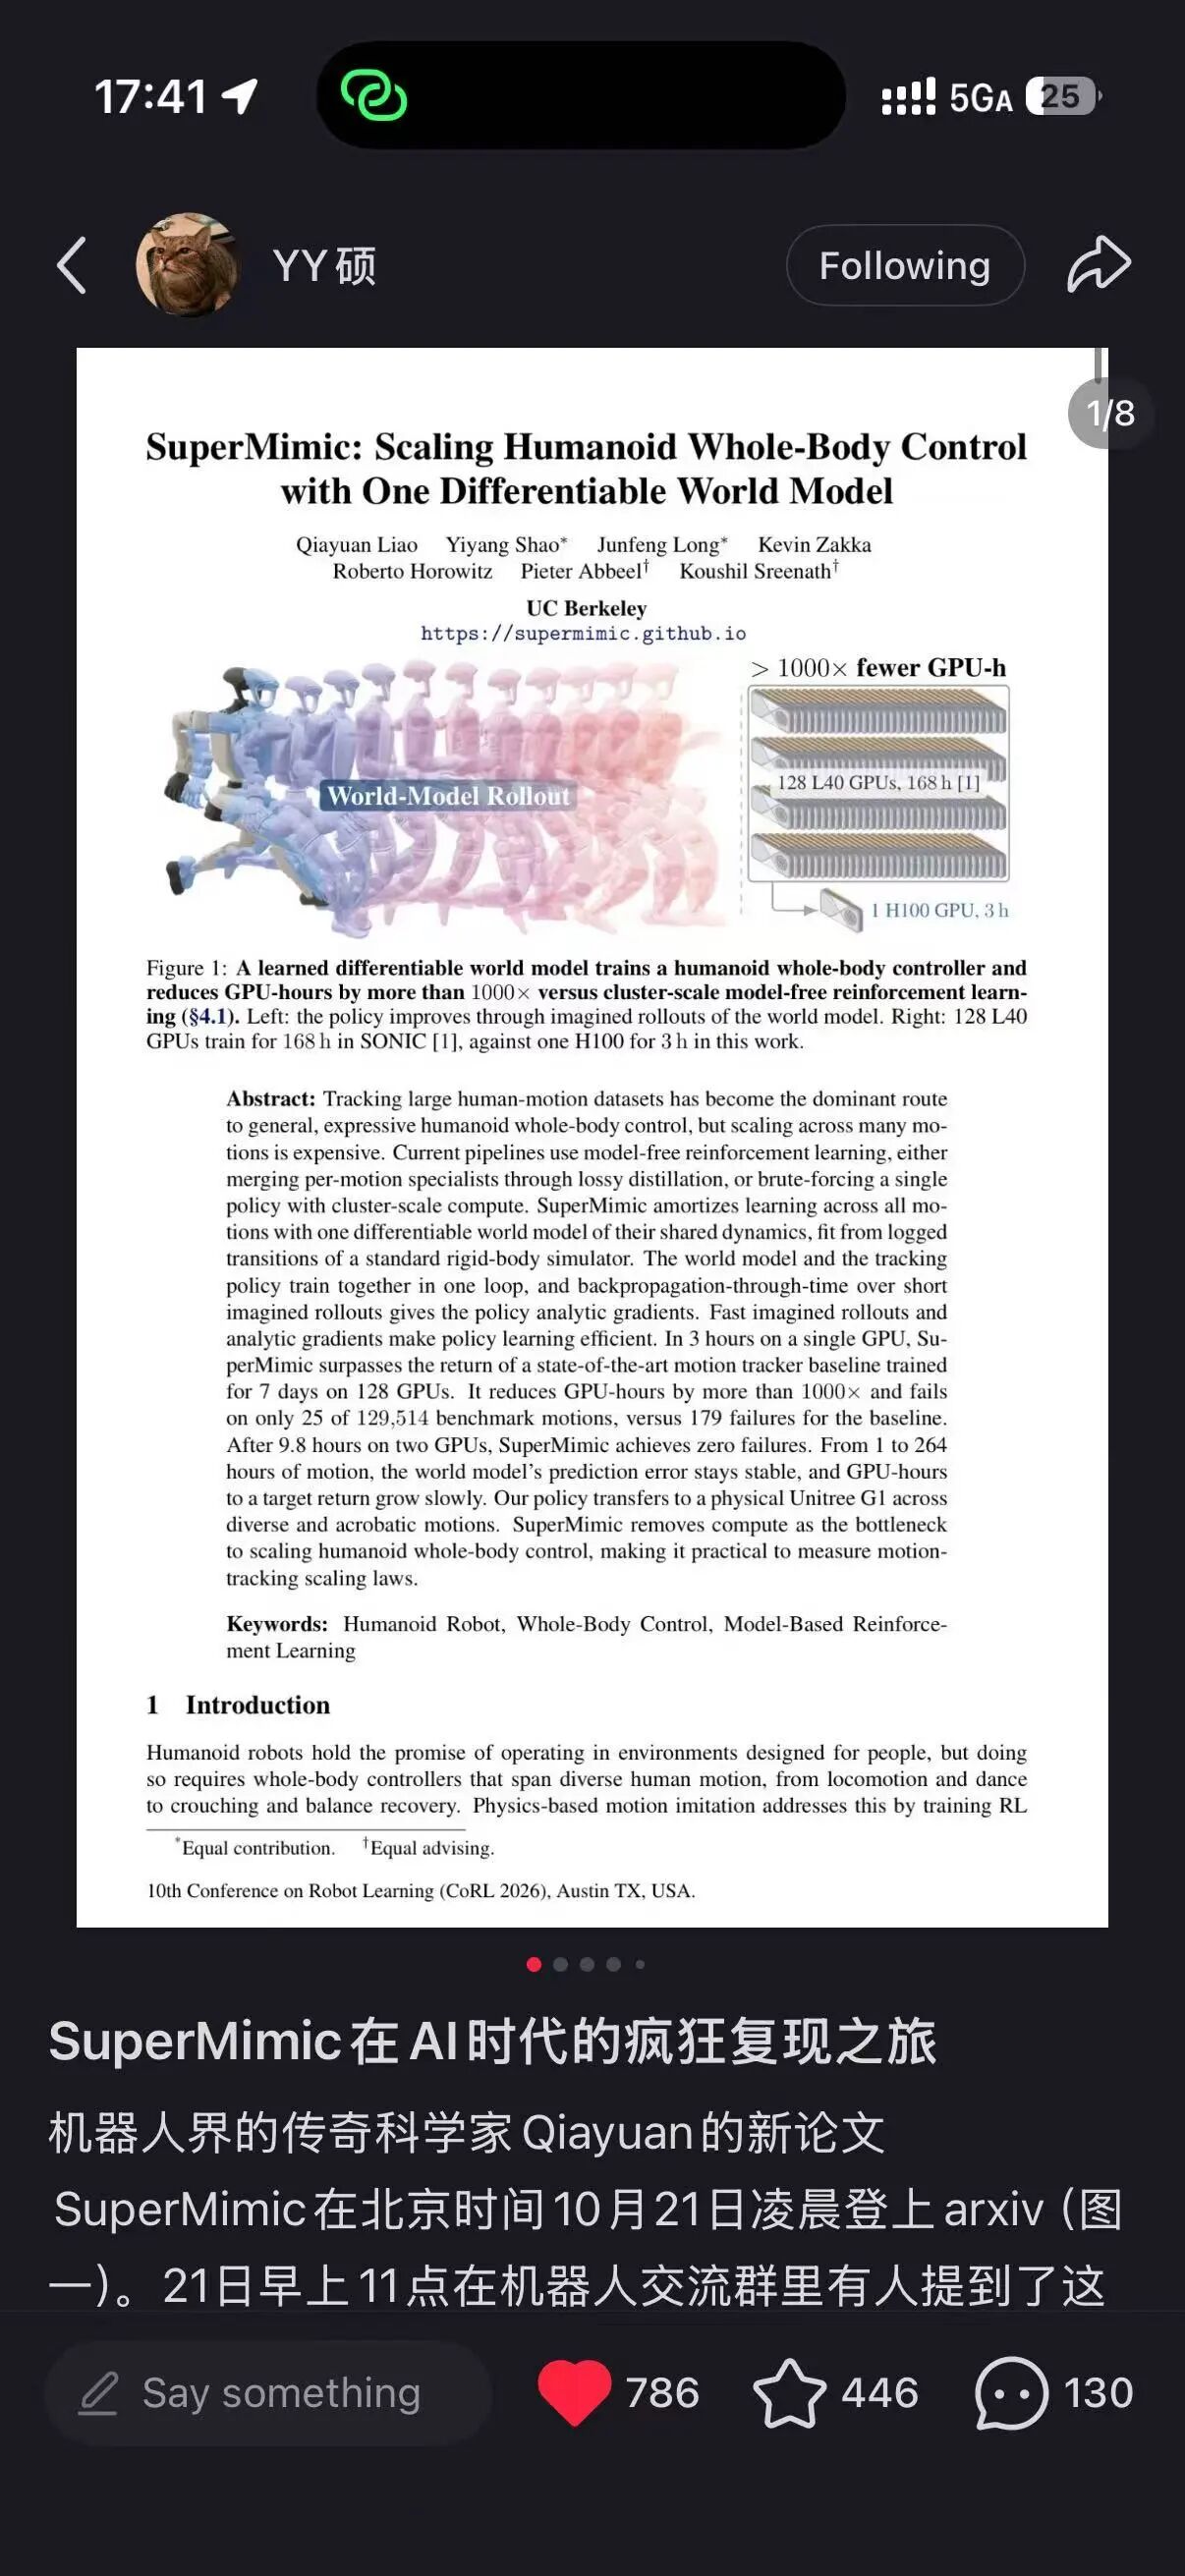
在这些数字和热度背后,更值得关注的是 UC Berkeley 团队 Qiayuan Liao、Yiyang Shao 和 Junfeng Long 的方法。Qiayuan 也主导了 BeyondMimic。
他们直接利用学到的动力学模型的梯度训练控制器,让模型既预测身体会怎样运动,也指导策略怎样改进动作。它让一条早已存在、却常被认为难以稳定用于复杂机器人控制的路线,显出了实际的规模和成本优势。
具体做法可以概括为把仿真器中这副机器人的动力学“蒸馏”进神经网络:物理仿真器产生运动记录,模型学习“执行这个动作后,身体会怎样变化”,策略再沿着模型给出的梯度改进控制。
不同参考动作共享同一个本体,也就可以复用这套学到的规律。
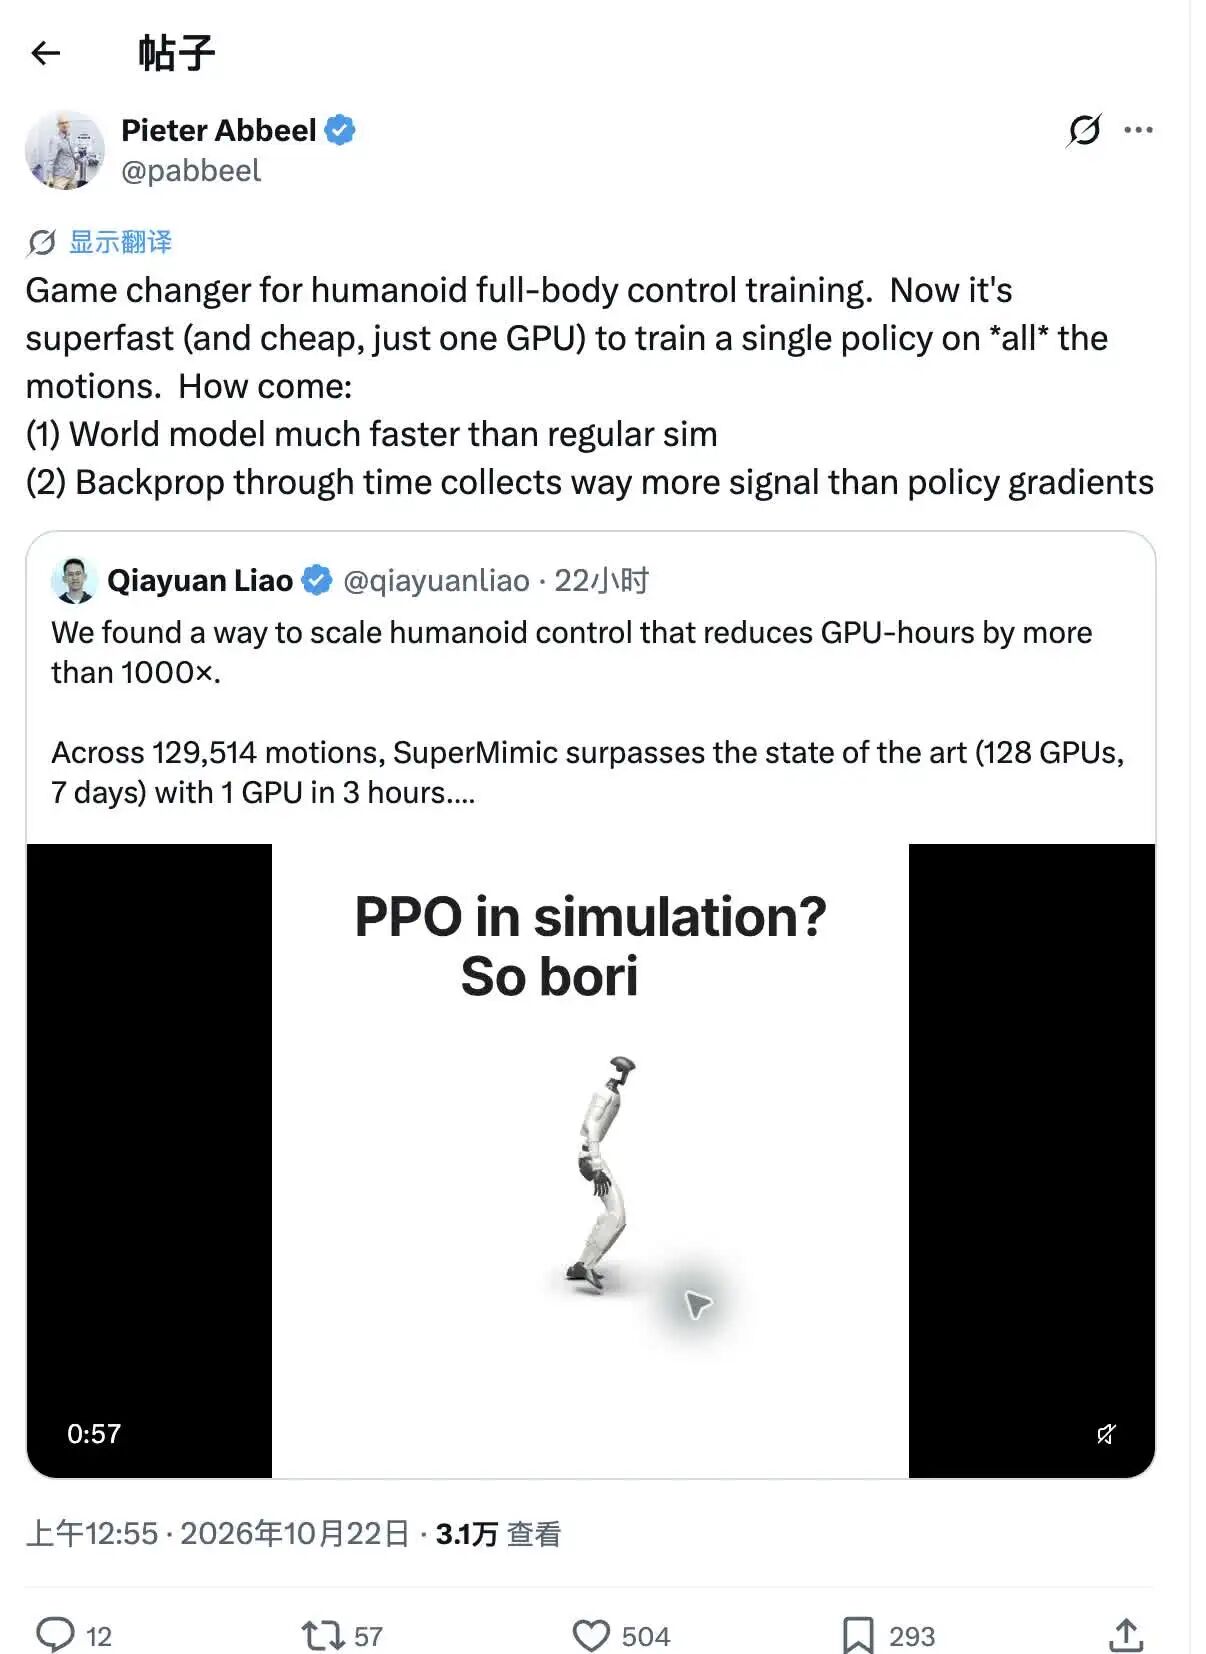
图 1|Pieter Abbeel 强调两点:模型推演更快,反向传播能提供更丰富的优化信号。
01从无模型 RL 到基于模型的 RL:算力可能不再是限制规模扩展的瓶颈
SuperMimic 让基于模型的 RL 走到全身运动控制的前台,它背后其实也有一条比较清晰的学术脉络。
学术界一直在为一个通用控制器而努力。DeepMimic 将动作捕捉片段作为目标,让物理仿真中的角色反复尝试:身体姿态越接近参考、动作完成得越好,奖励就越高。训练由此把一段动作数据变成了能驱动身体的控制策略。PHC 进一步扩大动作覆盖,并训练角色在跌倒后恢复。
动作库扩大后,训练方式也出现了分工。一种做法是先让多个专用策略分别学会各自的动作,再让一个通用策略模仿它们,把能力合到一起,这就是策略蒸馏。另一种做法是从一开始就把大量动作交给同一个策略,让它在训练中轮流练习。
SONIC 走的是后一条路线:同时扩大动作数据、策略网络和训练算力,最终让同一个控制器在真实人形机器人上执行丰富的动作。
SONIC 的价值,是证明了动作数据、策略容量和算力一起增长,能够换来更广泛的全身控制能力。
这也奠定了无模型强化学习在全身运控的地位。增加动作数据和仿真经验,控制器就有机会学到更丰富的行为。直接根据动作执行的结果改进策略,不额外学习一个预测身体运动的动力学模型,因此也不受这类模型预测误差的牵制。
但问题是,如果每次训练都要占用 128 张卡一周,成本很高。训练专用策略再蒸馏,则要承担多阶段训练的开销,以及压缩多个策略时的能力损失。
虽然跳跃和翻滚的目标不同,但机器人的质量、惯性、关节关系和接触规律是不是可以共享?为什么每次优化动作,都主要依赖重新采样来估计动作的后果?能否先把这些规律用一个模型学下来,让整套动作库共同使用?
大家自然就想到了基于模型的强化学习(model-based RL):先建立一个环境预测模型,再用它帮助训练策略。这提供了一种节省训练成本的思路。
SuperMimic 挑战的是这种实践中的取舍:为了获得可靠、可扩展的控制效果,是否必须接受大量仿真试错的成本?
这类尝试之前就有。
SuperTrack 用仿真数据训练运动预测模型,再通过模型的导数改进控制器;ControlVAE 将这套过程与技能表示一起学习。MoConVQ、SuperDyno 继续扩大动作数据,让学到的模型支持更丰富的虚拟角色控制。这些工作已经证明,学习动力学模型并通过它反传,能够有效训练覆盖大量动作的虚拟角色控制器。
SuperMimic 延续了这条路线,进一步推进的是大规模人形机器人跟踪、单 GPU 低成本训练和真机部署。
02怎么训练:先学会预测动作后果,再用预测改进动作
整套训练围绕三个步骤反复进行。物理仿真器提供经验,模型学习运动规律,控制策略利用这些规律改进动作。
第一步,当前策略在 MuJoCo Warp 中采集运动经验。参考动作来自已有的公开动捕数据:大规模实验使用 BONES-SEED,经筛选和重定向后得到适合机器人跟踪的动作;小规模对照使用 LAFAN1。
策略以这些动作为目标,在仿真中尝试控制机器人,记录“当前状态、执行动作、下一状态”,存进经验缓冲区。
这些由当前策略采集的状态转移,才是训练世界模型的数据。采集时还给动作加入扰动,让模型见到偏离参考动作时的身体变化。
第二步,用这些经验训练世界模型。 模型先预测下一状态,再拿自己的预测继续往后推,默认连续训练八步,并与仿真记录比较。这样,训练会直接约束连续预测的误差,避免模型只会预测孤立的一步,接着就越推越偏。摩擦等条件也作为输入,让模型区分不同物理条件下的状态变化。
第三步,让策略在模型里展开短轨迹,并对回报反向传播。 策略输出动作,模型预测下一状态,策略再决定下一步动作。每一步都计算身体位置、朝向、速度等与参考动作的偏差,形成跟踪奖励;默认展开 32 个控制步,再通过整段计算更新策略。
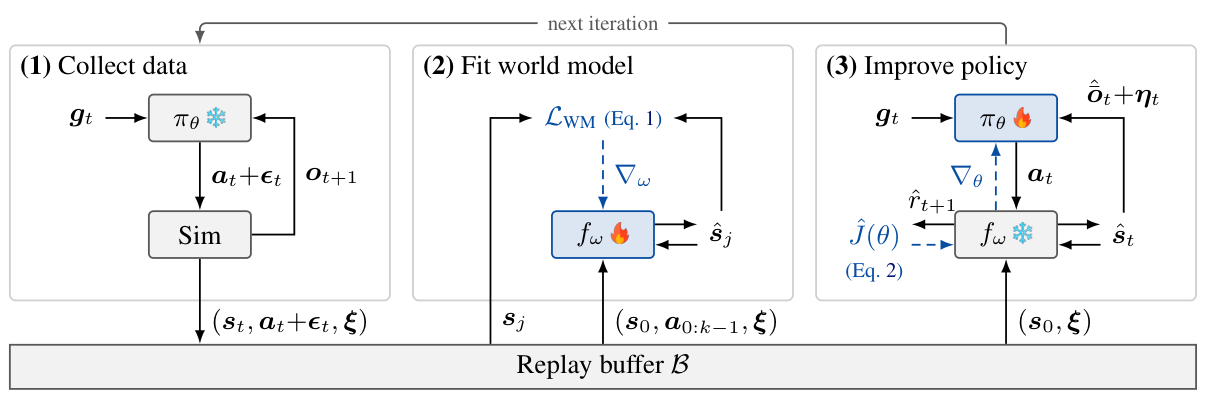
图 2|论文 Figure 2。仿真器采集转移,世界模型学习转移,策略通过模型内的回报梯度更新,三步反复进行。
我们可以对比一下 PPO 和 SuperMimic 的策略更新方式。以起跳为例,PPO 根据采样结果判断哪些动作选择带来了较好的回报。
SuperMimic 则还能计算:膝关节动作稍微改变,会怎样影响后续身体状态,又会怎样改变跟踪回报。这个导数一路传回策略参数,就构成了解析策略梯度。每段轨迹由此提供了更直接的改进方向。
这里有两个关键设计。
首先,策略更新时固定世界模型的权重,但保留对模型输入的求导。 这样策略优化的是自己的动作,而不会通过修改模型,把想象中的结果“改好看”。下一轮采集之后,模型又会用新数据继续学习。模型与策略共同改进,模型也不断接触当前策略实际会到达的状态。
其次,反向传播只穿过短时间窗口,更远的影响交给价值网络 critic。 32 步在 50 Hz 下约为 0.64 秒,critic 估计这段轨迹结束后还能获得多少回报。它帮助策略在短窗口内考虑后续平衡与恢复,也减少长时间连续求导带来的不稳定。训练还使用软终止权重和梯度裁剪。
不同动作共享这个模型,也共享同一个跟踪控制器。部署时,控制器读取本体感知历史和接下来的参考动作,直接输出关节设定值;训练阶段的模型推演不必在每次真机控制时重新运行。
03
省了多少,效果又如何?
论文先给出了最醒目的完整系统结果:SuperMimic 在单张 H100 上训练三小时,就超过 SONIC 已发布模型的跟踪回报。训练数据来自 BONES-SEED,过滤后保留 264.56 小时、129,514 条动作;SONIC 使用的完整动作数据为 611 小时。
作者逐条评估了这 129,514 条动作,检查控制器对整个动作库的跟踪情况。三小时模型只有 25 条失败,使用两张 GPU 训练 9.8 小时后,失败数降为零。随后,同一个策略在真实 Unitree G1 上完成跳跃、侧滚、90 度翻转和原地 360 度翻转,四种动作都没有再单独调参。
更能看清训练方法差异的,是 LAFAN1 上的对照。作者使用相同的 40 条动作、2.45 小时数据,对齐奖励、观测、终止条件、域随机化、网络规模和评估方式。SuperMimic 单卡约 1.2 小时达到 0.82 的归一化回报;PPO 训练 18 小时后,使用 1、4、8 张 GPU 分别约为 0.60、0.70、0.72。PPO 沿用 BeyondMimic 超参数,每卡并行环境数是 SuperMimic 的两倍(见论文 Figure 4)。
这组结果最有力的地方,是继续给 PPO 增加算力,也没有追上改变训练方式带来的收益。
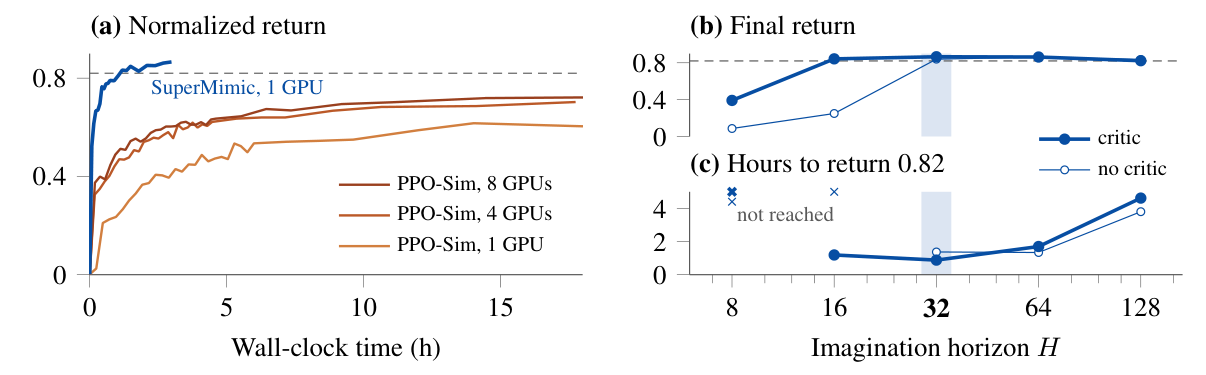
图 3|论文 Figure 4。左侧比较 LAFAN1 上的训练时间与回报;右侧检验短时域训练中 critic 的作用。
身体规律能够复用。动作数据从约 1 小时扩展到 264 小时,模型的八步预测误差保持在相近范围,且达到目标回报的计算消耗增长较慢。增加动作并没有要求模型从头学习一套新的物理规律。
模型推演本身更快。在训练常用的并行规模下,神经网络预测比 MuJoCo Warp 快超过十倍,降低了生成训练轨迹的成本。
04
为什么效果这么好:论文的证据与研究者的讨论
模型能更快地产生训练轨迹,但策略怎样从这些轨迹里学得更有效?论文先通过对照实验,比较了两种策略更新方式。
同样在世界模型里训练,SuperMimic 的更新方式比 PPO 更省训练步数。
作者让两种方法都用世界模型生成轨迹,比较“怎样更新策略”。在行走、跑步、冲刺子集上,SuperMimic 达到 PPO-WM 最佳训练回报所需的想象步数,约为 PPO-WM 的 1/64。
这支持了一个关键结论:收益不只是模型生成轨迹更快,通过模型求导的更新方式,也让训练经验利用得更充分。
结果公布后,RWM 第一作者 Chenhao Li 提出了一个疑问:他们在世界模型里尝试过梯度训练,却遇到了接触动力学造成的不稳定,为什么 SuperMimic 能做得这么好?
RWM 已经能用模型生成训练经验,再通过 PPO 得到可部署的机器人策略。但在其速度控制实验中,直接穿过世界模型反传的 SHAC 表现较差。论文描述了一种恶性循环:不可靠的模型梯度带偏策略,变差的策略产生混乱轨迹,这些数据又让模型更难训练。
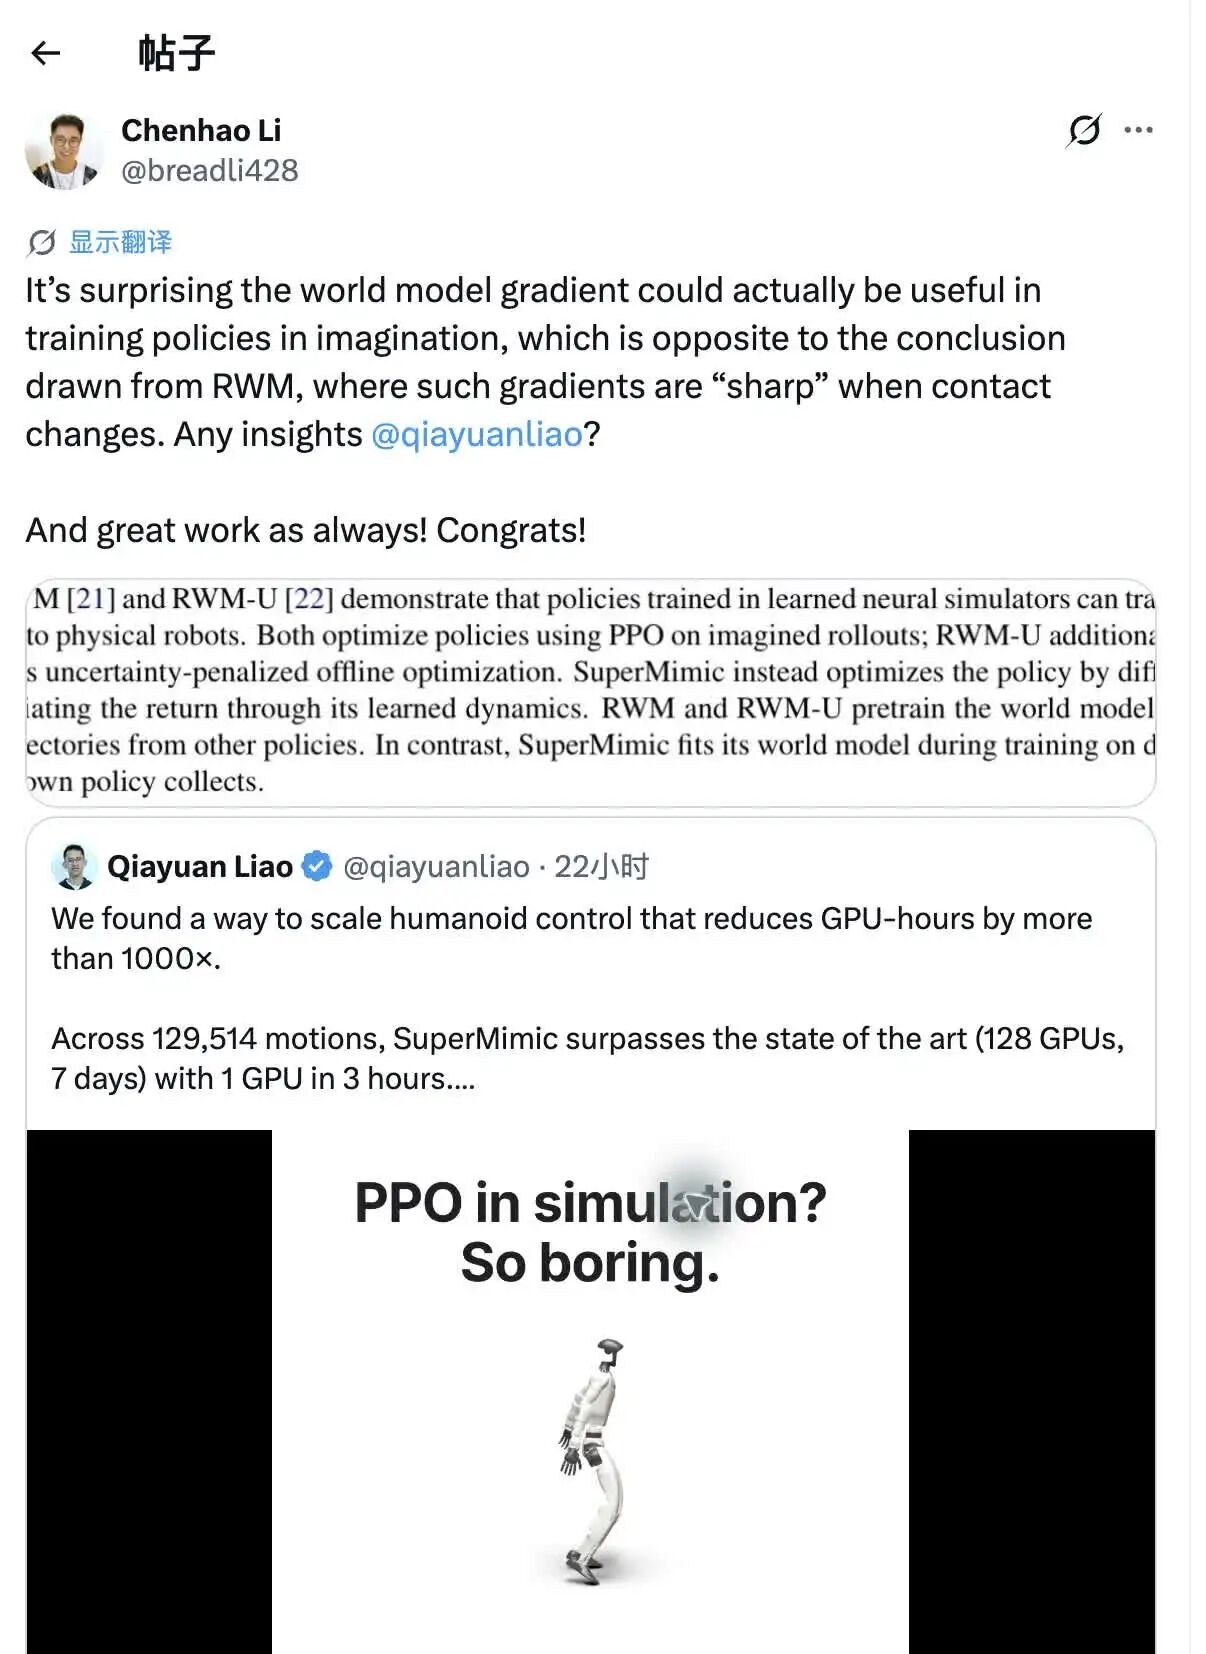
图 4|Chenhao Li 将 SuperMimic 与 RWM 的实验经验联系起来:同样使用世界模型,为什么这里能有效利用模型梯度?
这里的困难是,预测值准确和变化方向准确,是两种要求。脚提前一点触地,支撑关系就可能变化,之后的身体运动也会不同。模型对下一时刻位置的预测可能很接近真实值,却没有给出可靠的“动作再改一点会怎样”。策略恰恰要沿着这个方向更新。
为什么 SuperMimic 里的模型梯度这么好用?大家讨论出几点原因:
第一,参考动作提供了更充分的约束,策略更难钻模型的空子。通过时间的反向传播比策略梯度收集到更多信号。Eliot Xing 提出,动作跟踪的稠密奖励可能很重要;Xiaoyu Huang 进一步猜测,这种奖励几乎用到了模型对身体状态的所有预测。
RWM 同样有每一步计算的奖励,包括目标速度跟踪、力矩和动作变化等约束。两者的关键差别在于:RWM 的相关实验要求机器人按指定速度运动,没有逐帧的全身参考动作;SuperMimic 则要求多个身体部位的位置、朝向和速度都贴近具体轨迹。
要求“以 1 米/秒往前走”,允许很多种步态。跟随一段具体动作,则进一步规定了腿怎么抬、躯干怎么转、各部位何时到达什么位置。策略即便利用模型误差提高了某个指标,也可能因为其他部位偏离参考而丢分。参考动作约束了更多身体量,缩小了策略利用模型漏洞获得高分的空间。
第二,模型可能让接触动作更容易学。Ancha 的疑问是:脚从悬空到落地,身体受力会突然变化。动作只差一点,结果就可能差很多。如果模型把这些变化都学进去了,它给出的动作调整方向为什么还能这么好用?
Eliot 认为,一个原因是仿真器已经做了处理:MuJoCo 使用软接触,让接触力的变化有一个缓冲过程。Guanya 则猜测,神经网络可能又把其中一些过于剧烈的变化学得更平缓。这样,策略稍微调整动作时,模型预测的结果就不至于剧烈跳变,更容易找到逐步改进的方向。
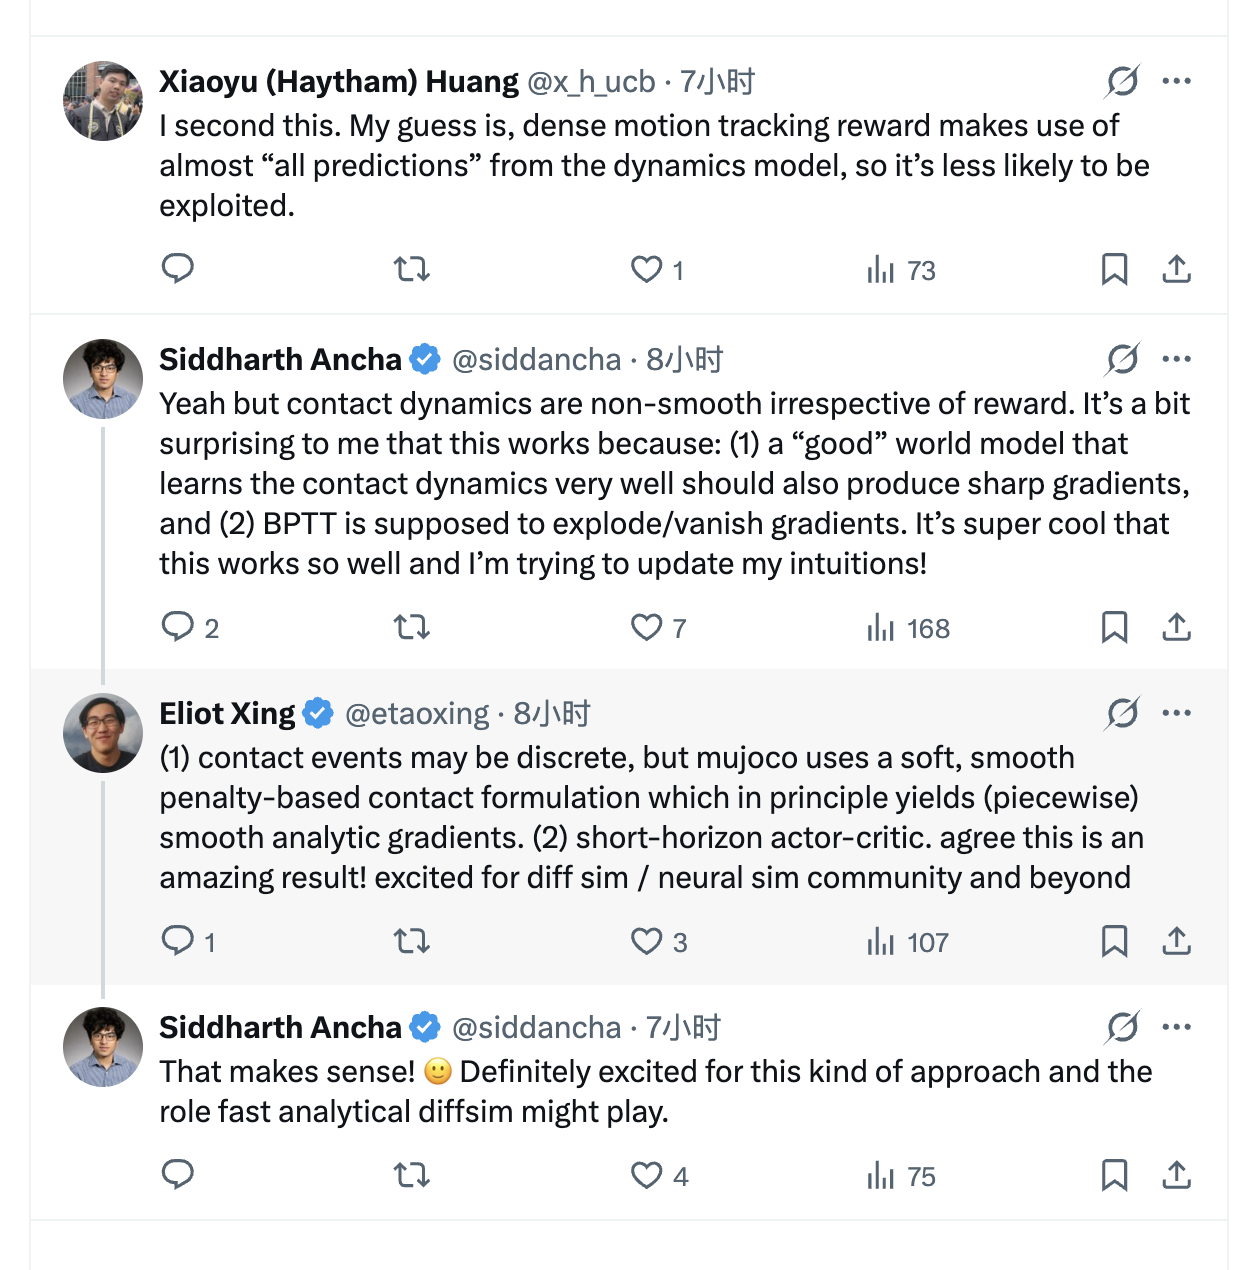
图 5|Huang 讨论奖励约束,Ancha 追问接触处的梯度,Eliot 补充软接触和短时域训练。几个人在解释成功的不同环节。
这种平滑要保留关键的物理规律:模型仍要知道落地会产生支撑和冲击,只是把变化描述得温和一些。如果连冲击都低估了,就会误导策略。Guanya 的猜测是,SuperMimic 的模型可能在这两者之间取得了有效的平衡,既能指导动作,也更容易用来训练。
第三,短时域训练减少了连续求导的难度。梯度沿着许多时间步反传,可能越来越大或越来越小。SuperMimic 使用的短时域 actor–critic 设计缓解了这个问题:只对眼前一小段运动求导,把更远的收益交给价值网络 critic 估计。
论文的消融与这个解释相呼应:作者改变反传窗口长度,并比较有无 critic:
没有 critic,16 步及以下的训练失败。加入 critic,16 步能达到接近无 critic、32 步的表现。默认的 32 步最快达到目标回报;从 64 步加到 128 步,耗时接近三倍,最终回报还下降了。
这个消融实验的意思是,不必把很远的未来都展开并求导,眼前一段通过模型优化,更远的收益交给 critic 估计,就能有效学习。
critic 还改善了受扰后的恢复能力。即使动作跟踪回报相近,在仿真推扰实验中,有 critic 的策略能重新稳定;无 critic 的策略持续踉跄,强扰动下还会跌倒。这说明 critic 的价值也体现在控制行为上。
05
意义与争论:全身控制的实验门槛变了,下一步比较什么?
当然,这条路还有很多可以继续研究的方向。Guanya Shi 的长帖给出了一些想法:
一个值得比较的问题是:通过学到的模型求导,与直接通过物理仿真器求导,有什么差别? SuperMimic 的链条是“动作—神经网络预测—奖励—反传”;可微仿真器的链条是“动作—物理计算—奖励—反传”。两者在速度、稳定性和控制效果上,究竟各有什么优势?
而且本质上,现在 SuperMimic 其实算是蒸馏了仿真器。那它相对于仿真器本身的优势是什么呢?
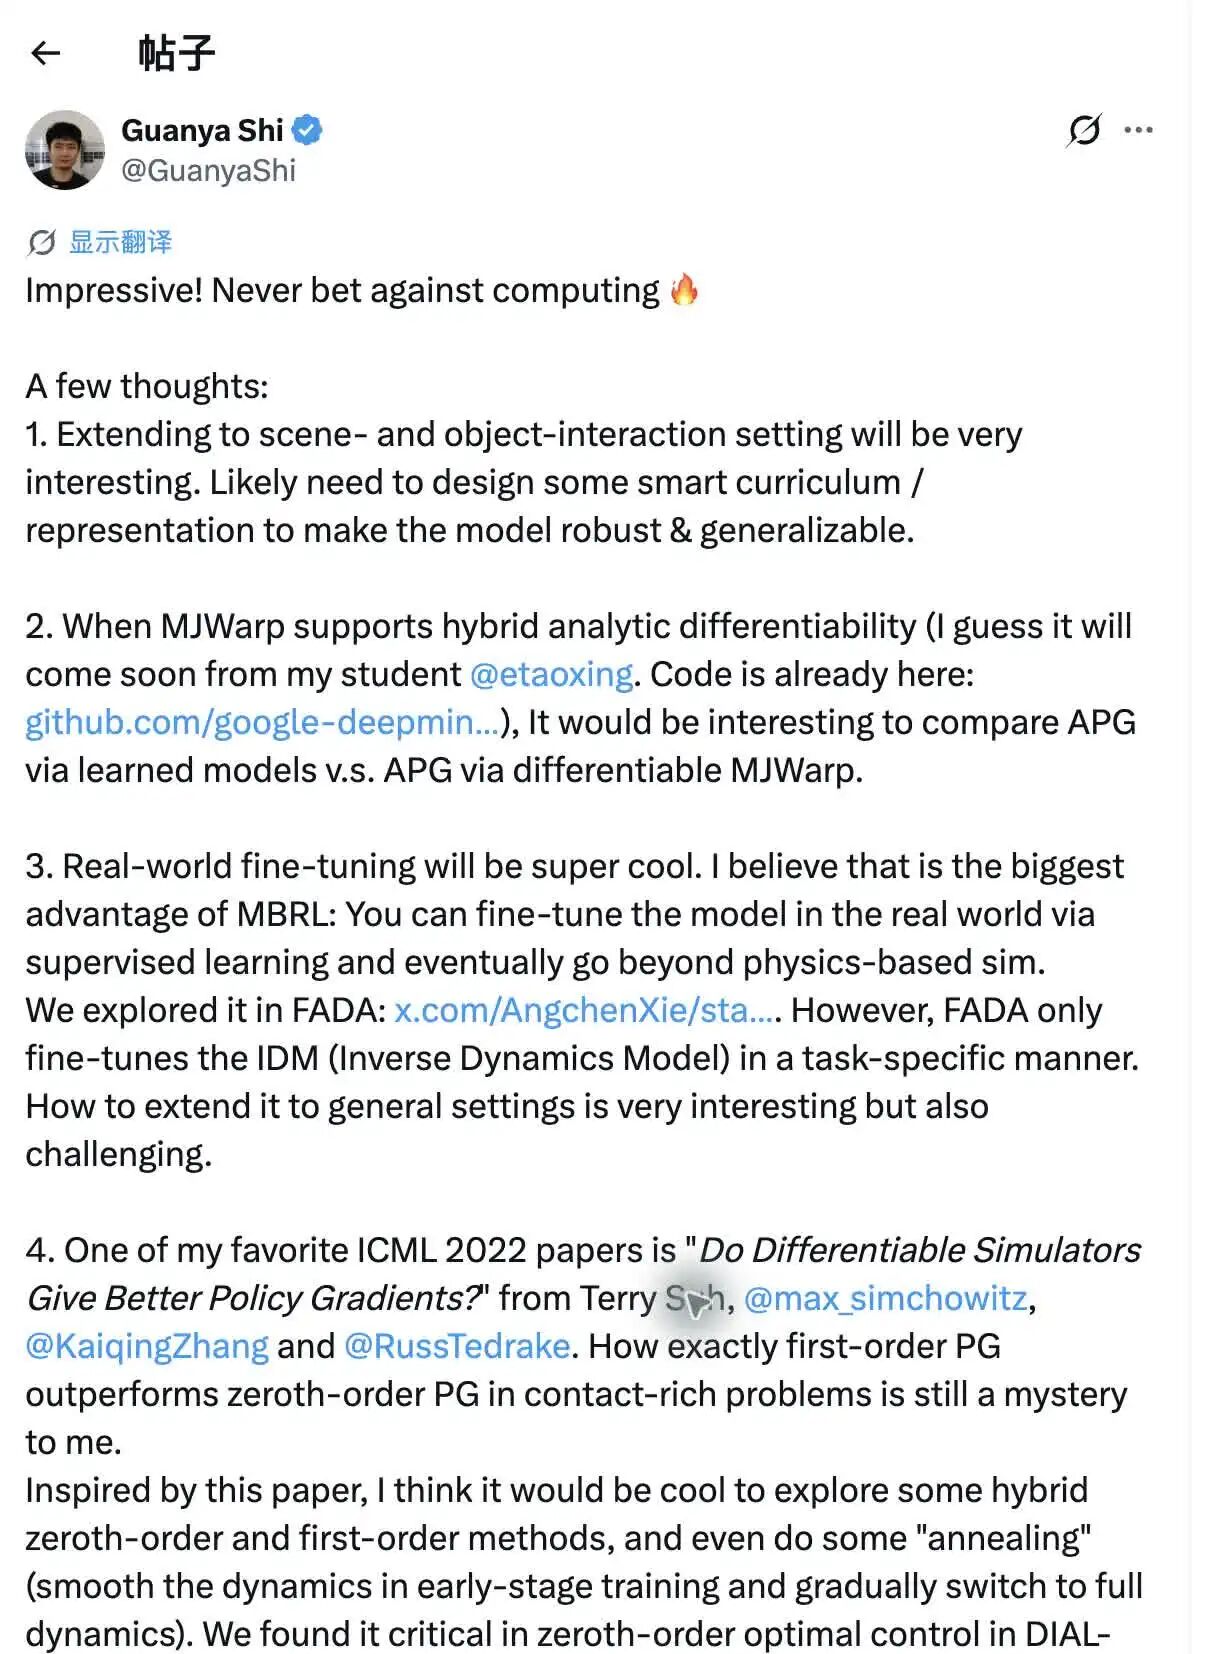
图 6|Guanya Shi 提出扩展场景与物体交互,并比较学习模型中的解析策略梯度和可微 MJWarp 中的解析策略梯度。
另一件更有吸引力的事,其实是用真实数据修正模型。 目前 SuperMimic 从物理仿真器采集数据;如果机器人实际执行后,把状态变化记录回来,就可以用监督学习更新动力学模型,学习仿真器没能准确表达的部分。模型由此有机会提供物理仿真器原本给不出的训练经验。
或许这也为学习不同地形下的运动,以及与物体、场景的交互,提供了一条更有潜力的路径。如何逐步扩展经验,让模型在更复杂的交互中保持可靠,也是一个非常值得关注的话题。
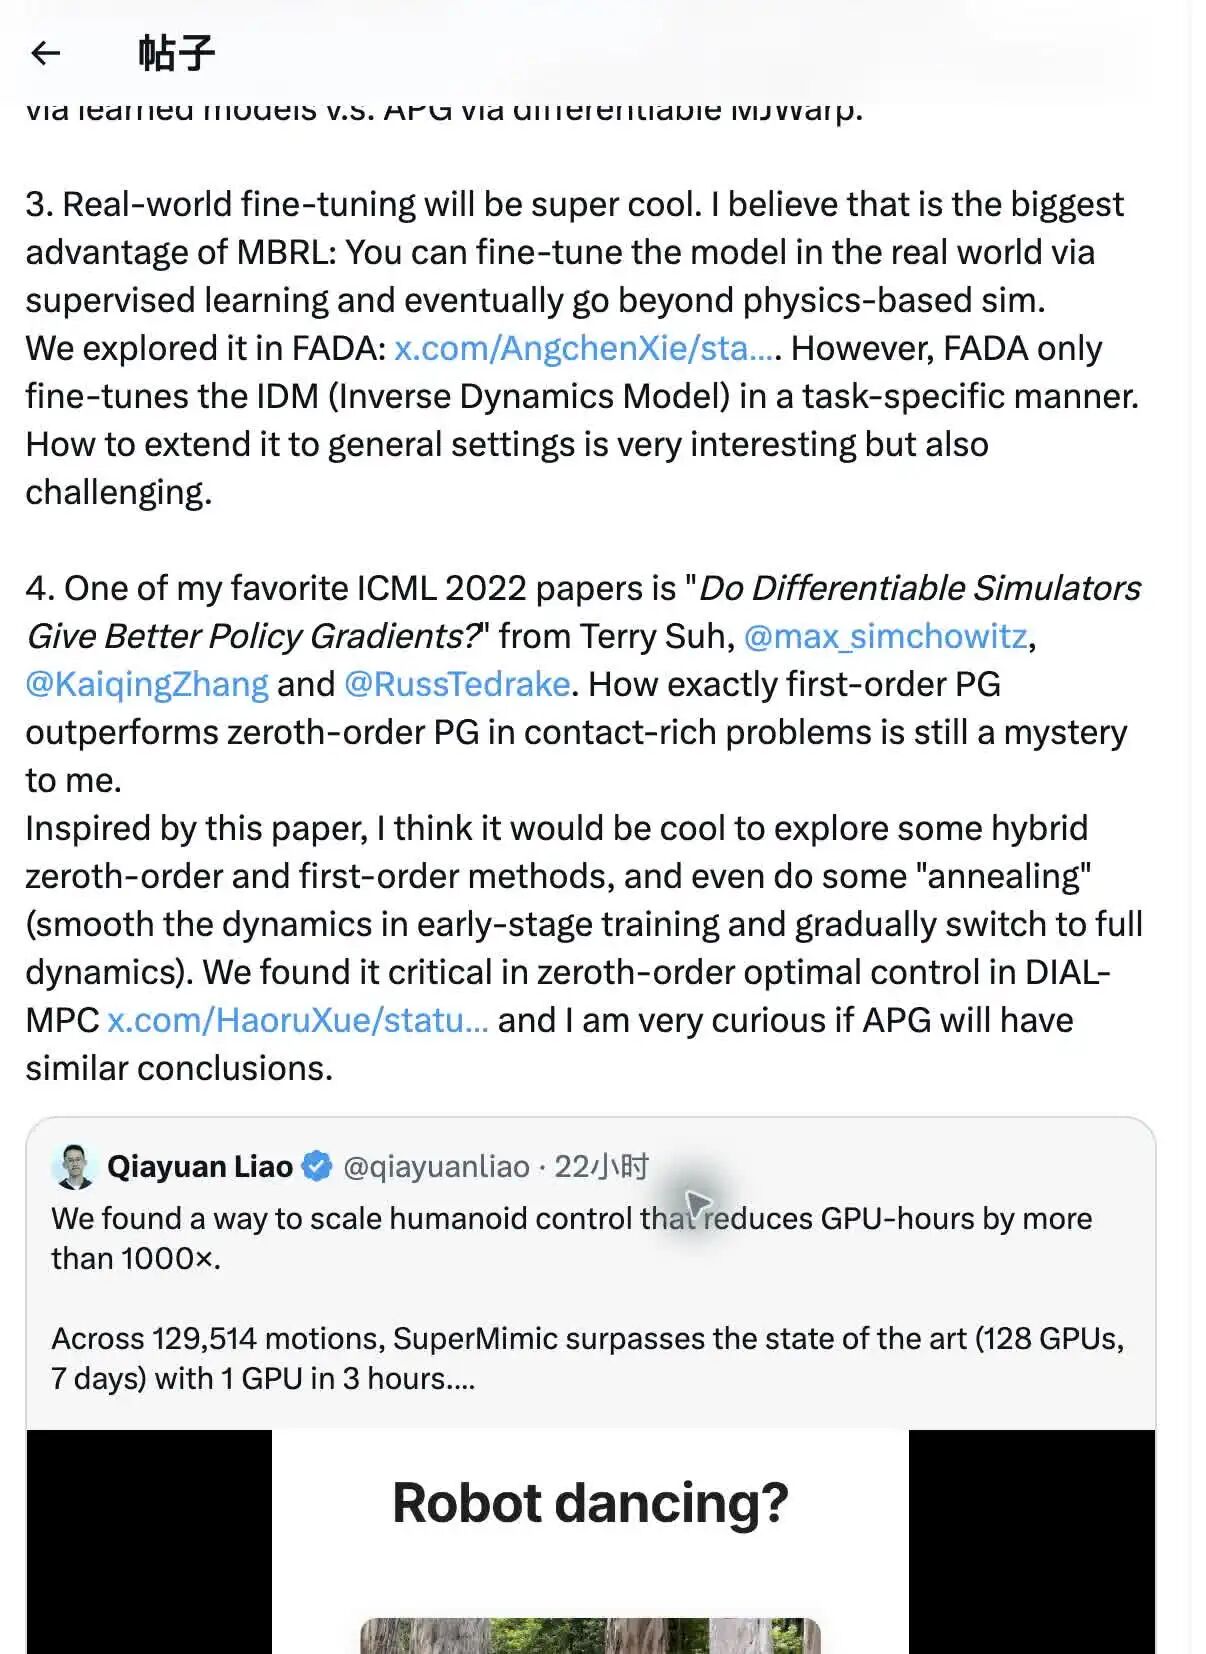
图 7|Guanya Shi 关注真实数据微调,以及一阶梯度与基于采样的方法如何组合。
最后,梯度与采样也可以组合使用。面对接触,一次求导很精确,并不等于它就是更好的策略更新方向;模型的平滑程度、采样与梯度的配合,可能共同决定学习效率。
SONIC 展示了把全身控制做大的价值,SuperMimic 则显著降低了沿着这个方向继续实验的成本。
如果回溯 SuperMimic 的研究脉络,会发现它的技术路线并非完全从零开始。但它的意义我觉得有几个:
• 生成经验更快、更省:世界模型加速轨迹生成,降低训练成本。
• 每段经验提供更多优化信号:模型反传直接指导动作调整,提高经验利用率。
• 训练经验来源更有潜力:未来可融合仿真与真实交互数据,支持更复杂的场景和任务。
• 降低社区实验门槛:让更多团队有能力复现、迭代大规模人形控制。
共同作者 Junfeng Long 谈到自己的认识转变:过去他觉得动作跟踪只是大型 demo 展示;SuperMimic 让他看到了在可用算力下迈向通用人形机器人的更清晰路径。
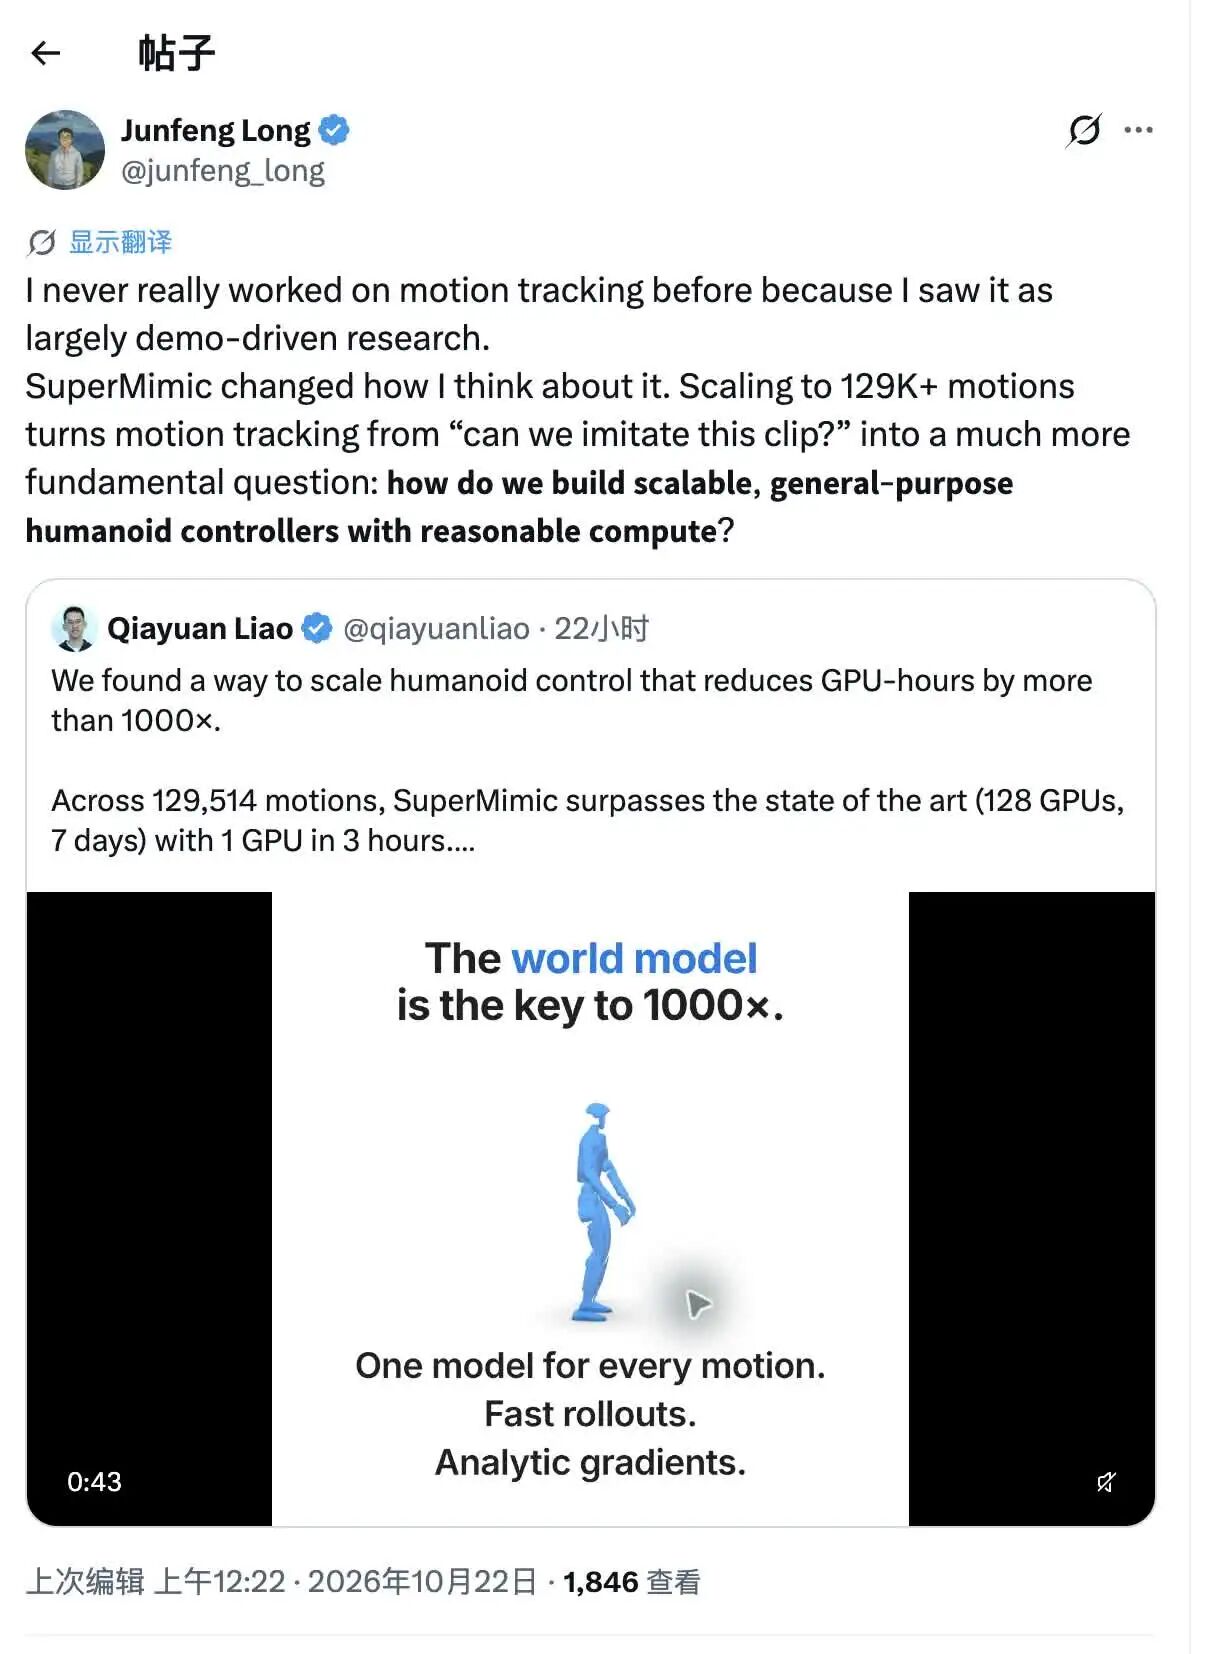
图 8|Junfeng Long 关注的变化:从训练若干展示动作,转向以合理成本建立覆盖庞大动作库的控制能力。
某种意义上,SuperMimic 展现的不仅是算法或算力的账面优化,而是将具身智能的推进节奏,从一场比拼资本与规模的“军备竞赛”,拉回了比拼算法洞察与创造力的常态化研究。
当充足的资源不再是唯一的通行证,创新的频率便能超越单纯规模的限制。这或许是技术演进中最扎实的一步:让探索的成本足够低,让更多人能够站在真实的代码与物理规则前,去推开下一扇门。

推荐阅读





×
右键可直接复制图片