 阅读时间大约10分钟以上(4275字)
2026-10-27 只要人和机器人的接触动态差异存在,真机后训练就是必经之路
来源:豆包
触觉如何帮助已有视觉策略,在真机交互中继续提升成功率。
出品:具身纪元
机器人把插头送到插座旁边,接下来还需要根据接触位置和受力情况调整动作,才能完成插入。这些信息很难仅凭视觉判断。
但如果希望机器人在真实世界部署、稳定地完成任务,要求就不只是偶尔插进去,而是让成功率尽可能接近 100%。已有策略已经能完成大部分动作,剩下的执行偏差该如何解决?
马里兰大学与佐治亚理工学院的研究者提出了 OmniTacTune:保留预训练视觉策略的动作能力,通过真机强化学习训练触觉残差策略,学习接触过程中的动作修正。它研究的是已有策略的后训练问题,触觉提供了完成这些接触任务所需的反馈。
用人类学习任务的过程解释这一动机:看过示范,可以知道一个动作应该怎么做,但示范者与学习者的力量、身体条件不同,照着做也未必能得到同样的结果。人需要通过实际操作,根据每次动作的结果调整,才能让自己的身体适应这个任务。
从人类示范迁移到机器人时,这种差异更明显。人手与机器人夹爪的结构、软硬程度和控制方式不同,即使运动轨迹相近,接触物体时产生的力和物体的响应也可能不同。
如果最终目标是在真实世界接近 100% 地完成任务,那么即使有了很好的预训练策略,最后仍需要让机器人在真机上进行强化学习。机器人需要自主尝试、获得反馈,适应自身动力学和实际接触条件,处理预训练尚未消除的差异。正因为他认为最后这一步不可避免,才选择直接研究如何把它做好。
OmniTacTune 将这个问题落到触觉操作上:在已有视觉策略的基础上,如何高效开始真机强化学习,并利用触觉进一步提高执行成功率?
01
触觉有用,为什么不直接训练视觉触觉策略?
学术界此前有这么几种做法:
一种是采集成对的视觉触觉示范,再训练视觉触觉策略。视觉触觉特征融合、RDP,以及给 π0.5 增加触觉 token 后做监督微调,都属于这一方向。它们能直接学习感知到动作的映射,问题是每换一个任务、传感器或机器人,往往又要采集一批专用触觉示范。於柯霖在访谈中强调,即使同类 GelSight 传感器,不同设备之间也可能出现明显差异。
另一条路是仿真适配。它可以减少真机试错,却必须同时模拟接触动力学和触觉图像。柯林举了开盒任务的例子:盒子有弹簧、粘连和多个活动部件,很难在仿真中完整重现这些接触。
专家纠错、DAgger 以及 HIL-SERL 等真机学习路线则依赖人在探索中干预。OmniTacTune 则利用已有视觉基座的动作能力,让机器人自主执行、收集真实触觉轨迹,再据此启动残差策略的学习。
此前,具身纪元在《英伟达也来做VLA在真实世界自我改进的方法了》中讨论过 PLD。它保留预训练策略,再用在线残差强化学习学习动作修正。OmniTacTune 沿用这一思路,但面对一个新的训练难题:一个原本完全没有使用触觉的预训练视觉策略,如何在没有任何离线触觉示范的情况下,高效开始触觉强化学习?
02
方法:两阶段的真机强化学习
OmniTacTune其实面临了两个难点。
第一个难点是,已有视觉策略没有触觉输入,不同策略的网络架构也不一样,触觉反馈该从哪里接入?如果为每种架构修改 backbone、重新训练融合模型,就需要逐一适配,还要重新利用数据训练已有的动作能力。
OmniTacTune 将触觉反馈用于动作修正:冻结视觉 backbone,在基策略输出的动作上叠加触觉残差。残差策略通过共同的输入和动作接口接入不同视觉策略,实现 不依赖基策略架构的触觉适配,保留基座已有的动作能力。
第二个难点是,没有离线触觉示范,新增的触觉模块靠什么开始学习?原有视觉示范无法直接用于初始化触觉 critic,预训练触觉 encoder 也尚未适应当前任务的接触信号。此时直接启动强化学习,actor 就要依赖尚不可靠的触觉特征和价值估计来更新。
为此,OmniTacTune 设计了 触觉编码器与价值网络的预热初始化:先让基策略自主执行,收集当前任务的真实接触数据;再在 warm-start 阶段适配触觉 encoder、训练 critic,并通过 ControlTac 增加不同接触力条件下的触觉样本,之后再开始在线残差学习。
第一阶段:适配触觉编码器,初始化 critic
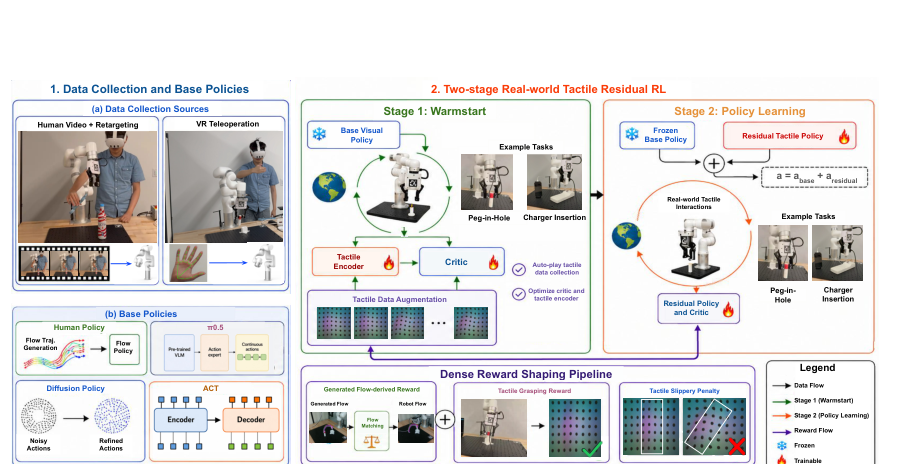
Figure 1,OmniTacTune 两阶段触觉残差学习流程
最简单的方案,是让视觉基策略先自主执行几次,把轨迹存进回放缓冲区,然后直接启动 SAC 强化学习。论文发现,这样做的初期探索不稳定。
问题在于,刚引入触觉时,critic(价值网络)还缺少当前任务的接触经验,无法可靠地估计动作价值;触觉 encoder 也尚未适应任务中的信号。把数据存进回放缓冲区之后,还需要先训练这两部分,再用它们指导残差策略学习。
OmniTacTune 因而设置了一个 12 分钟的 warm-start 阶段。机器人先使用冻结的视觉基策略自主执行,采集状态、动作、奖励和触觉观测。这批数据不只用于填充回放缓冲区,还用于预热 flow-tactile critic,并针对当前任务调整触觉编码器。
触觉编码器同时接受两种训练约束。critic 损失使特征保留与动作价值有关的信息,图像重建损失则帮助保留触觉图像的结构。
训练只使用检测到接触的转移,接触由 GelSight 图像中的标记点位移是否超过阈值来判断。这样可以避免大量未接触画面稀释真正有用的触觉变化。
作者还使用 ControlTac 做接触力增强:每条真实轨迹生成两条时间一致的触觉轨迹,保留机器人状态、动作和奖励,改变接触力条件及对应的触觉图像。
於柯霖在访谈中举例,同样一次操作,上次接触力可能是 5 牛,下次就变成了 8 牛。他解释:“我们其实一个 action,一个 robot state,它可能对应很多个 tactile image。”因此,增强的目的在于扩大触觉样本覆盖,让触觉编码器和 critic 在在线学习前接触到更多力的变化。
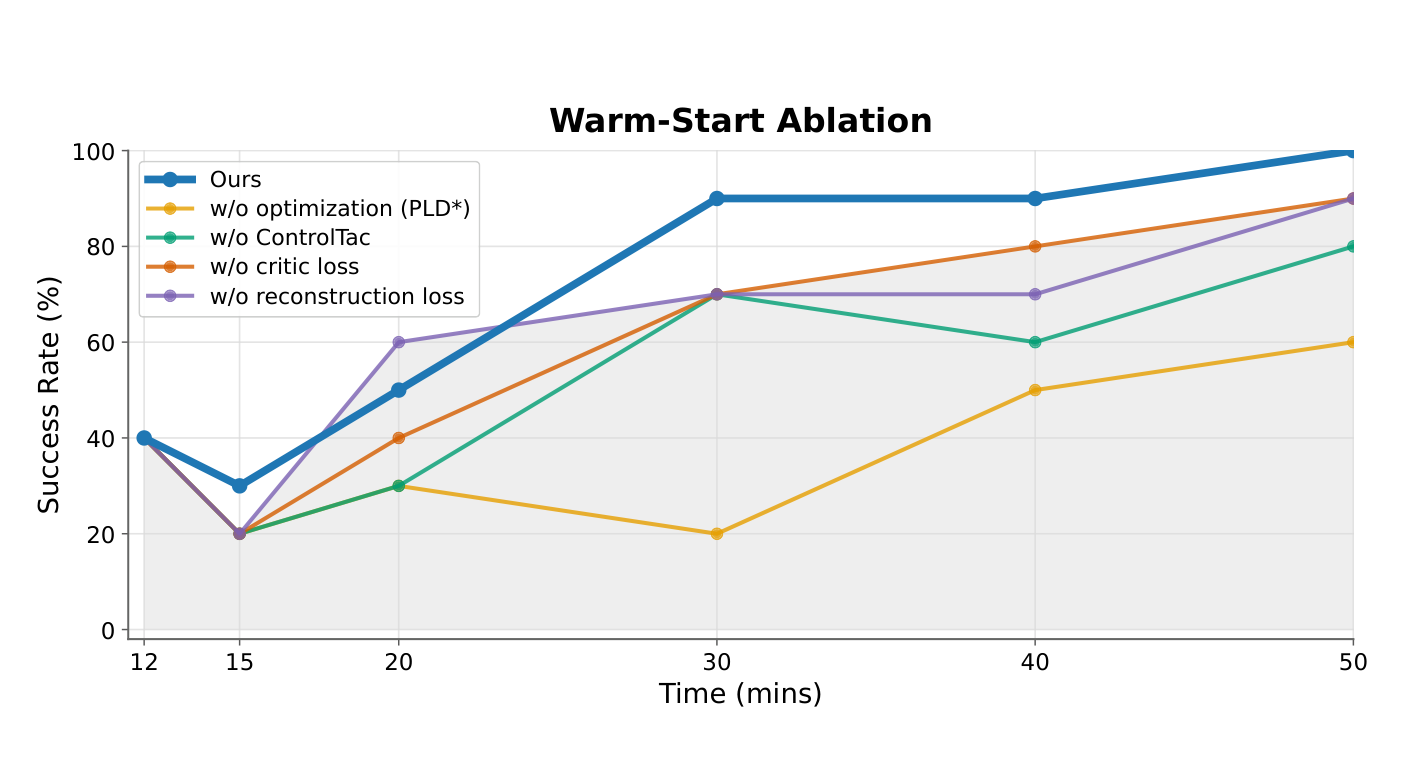
Figure 2,warm-start 消融:完整方法与去掉各项优化后的成功率对比
消融实验支持这一设计。取消 warm-start 中对触觉编码器和critic的优化,早期训练明显更加波动,最终性能也更低。
去掉 ControlTac 增强、critic损失或重建损失,同样会造成退化。
第二阶段:冻结基策略,学习触觉残差修正
进入在线阶段后,视觉基策略始终冻结,SAC 负责更新触觉残差策略(actor)和 critic。最终执行的动作由基策略动作与经过幅度限制的残差修正相加得到。
访谈中,我们问到:新加入的残差会不会把原本的策略带偏?於柯霖解释,初始残差策略接近随机,需要在学习和执行两个环节控制偏离。这里有三个作用不同的组件:
Critic 提供价值估计。
它根据交互数据估计动作的预期回报,指导 actor 的优化方向。
BC regularization 约束策略偏离。
它在训练中增加损失项,使策略在优化任务回报时仍受到基策略的约束。
Residual scheduler 限制执行幅度。
它直接缩放残差动作,初期只允许小幅修正,随后将尺度从 0.05、0.10 逐步增加到 0.15。
critic 和 actor 在交互中一起更新,正则强度和残差尺度则需要结合任务调整。
为什么这套残差策略能接在 Flow Policy、ACT、Diffusion Policy 和 π0.5 后面?残差策略通过共同的输入和动作接口,接入这些不同架构的视觉策略。
残差策略接收机器人本体状态、物体关键点流、当前基动作与短时动作块。触觉特征只在检测到接触后通过门控加入。于是,非接触阶段主要由视觉策略完成接近和搬运,发生接触后,触觉残差才加强修正。
物体关键点也没有逐帧强迫机器人追踪一个精确位置。系统从生成的物体流中抽取较稀疏的轨迹级子目标,只有当前物体运动接近子目标后才切换到下一个。论文的消融显示,逐步关键点条件会过度约束 ACT,因为 ACT 的动作变化较大;稀疏的轨迹级引导保留了局部反应空间,更适合让残差策略处理接触变化。
稀疏的成功奖励,怎样支撑几十分钟真机学习?
只在任务完成时给一个奖励,机器人很难在几十分钟内找到有效修正。OmniTacTune 因此使用归一化的多感官奖励,把任务拆成几个可以连续判断的过程。
抓取前,到达奖励衡量末端执行器与物体初始三维中心的距离。抓取后,物体流奖励比较当前物体变换与生成子目标之间的误差,并随着已完成子目标数量增加。
触觉抓取奖励根据有效触觉区域的深度判断接触是否稳定。平均标记点位移超过安全阈值时,系统给出较大的负奖励并复位机器人。任务真正完成时,操作员再给终止成功奖励 1。
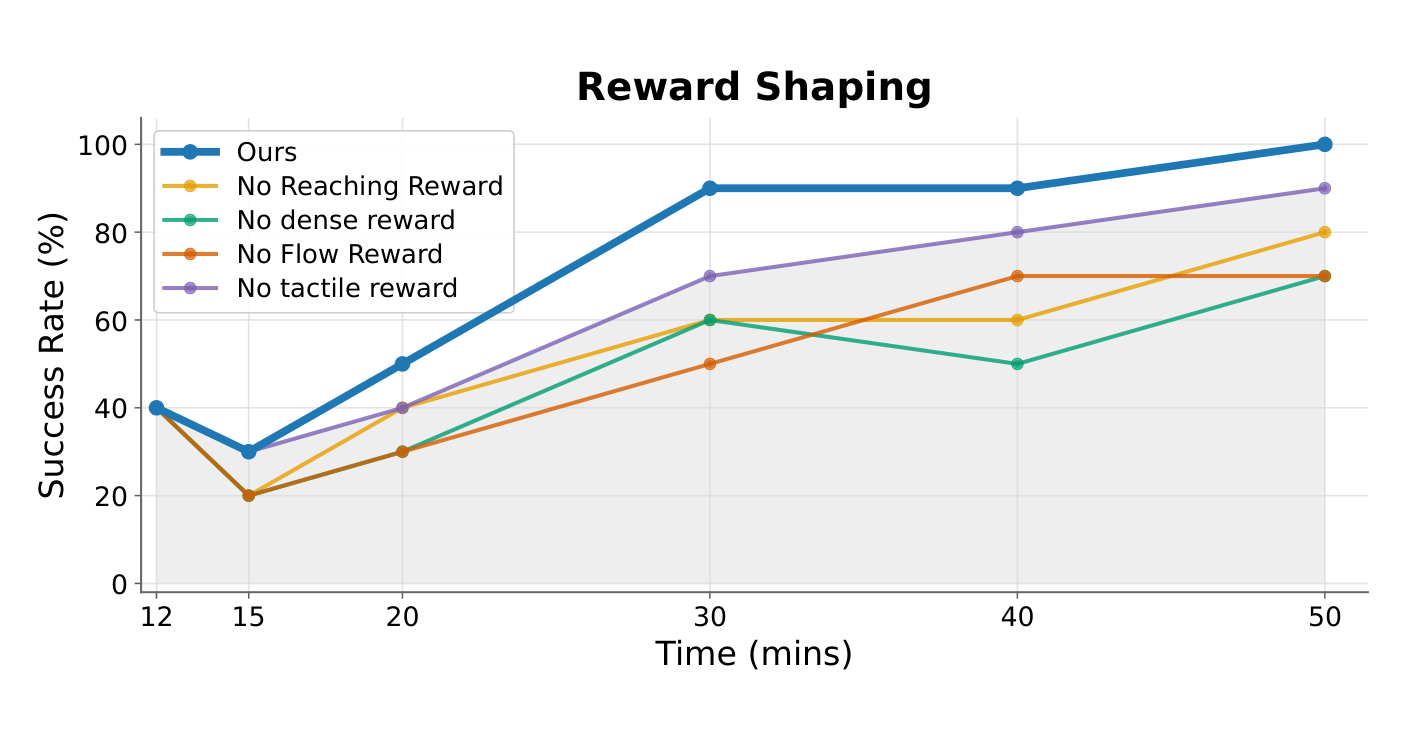
Figure 3,奖励消融:横轴为训练时间,纵轴为插杆任务成功率;蓝线为完整方法
到达奖励和物体流奖励引导机器人接近目标并推进任务,触觉奖励提供接触反馈。消融实验中,去掉其中任一项,最终成功率都会下降;完全去掉稠密奖励,学习过程也更不稳定。
03
真机训练提升成功率:与遥操作的比较,以及对不同策略和触觉表征的适配
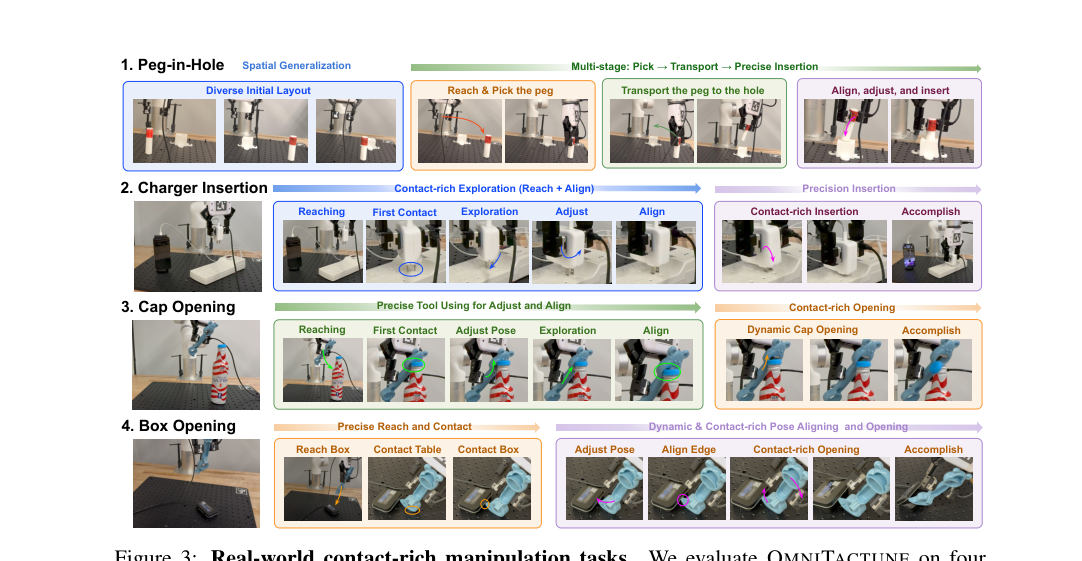
Figure 4,四类接触任务与整体结果
实验使用 xArm7 机械臂、GelSight Mini 触觉传感器和 Intel RealSense D435 相机。四个任务分别是插杆、充电器插接、瓶盖开启和盒盖开启。
后两个任务还要求机器人使用开瓶工具,在持续接触中调整姿态并施力。
实验效果:四项任务的平均成功率达到 93.75%
每个任务先采集 50 条人类示范,训练 Human Flow 视觉基策略。20 次初始测试中,四项成功率依次只有 40%、10%、5% 和 5%。除 ViTAL 外,各方法都先进行 12 分钟预热。四项任务的总训练时间依次为 50、40、60 和 80 分钟,最终模型各评估 20 次。
OmniTacTune 最终达到 100%、100%、90% 和 85%,平均成功率为 93.75%。对照方法 PLD*、仅视觉的 PLD 和 ViTAL,平均成功率分别为 52.5%、37.5% 和 43.75%。
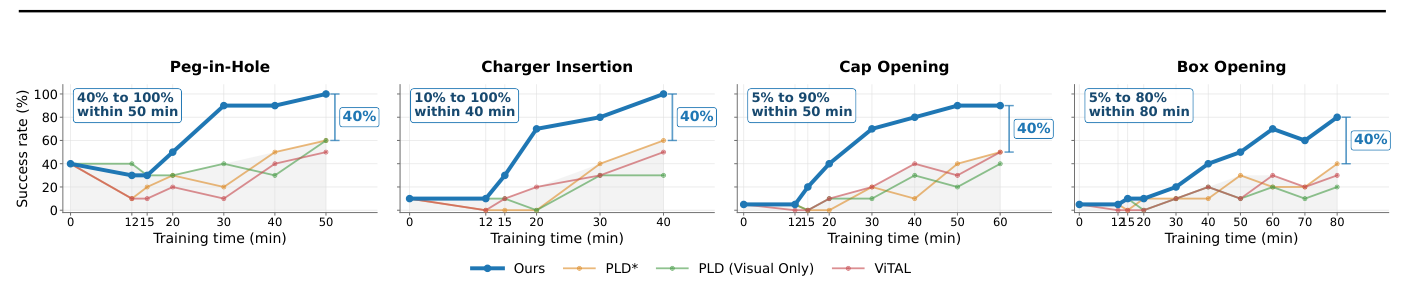
Figure 5,四项任务的训练成功率曲线。曲线各检查点评测 10 次,正文最终结果各评测 20 次,两者统计口径不同。
PLD* 没有在预热阶段优化触觉编码器与critic,学习更慢且波动更大。视觉版 PLD 早期受益于critic初始化,但没有使用触觉,最终表现最低。ViTAL 从零训练视觉触觉critic,样本效率也不及 OmniTacTune。
基础策略:五种视觉策略都能接入触觉残差
在插杆任务上,团队分别测试了 Human Flow、遥操作 Flow、ACT、Diffusion Policy 和 π0.5。五种策略的初始成功率为 40%、50%、25%、30% 和 15%,经过 50 分钟真机训练后,分别达到 100%、90%、80%、90% 和 75%。这些策略采用不同架构,触觉残差通过共同的动作接口完成适配。
与补采遥操作示范相比:相同时间内,在线强化学习提升更大
作者把相同的 50 分钟预算用于额外遥操作,示范数量从 50 条增加到 90 条,再训练视觉触觉模仿策略。ACT 加触觉达到 60%,RDP 达到 65%,π0.5 加触觉达到 45%。
OmniTacTune 接到对应骨干后分别达到 80%、90% 和 75%,Human Flow 版本达到 100%。
这组对照说明,在插杆任务和相同时间预算下,真实交互中的试错比额外收集遥操作触觉示范更有效。
附录比较了轨迹的平滑程度。人类视频轨迹的 M-SPARC 为 -2.889,遥操作示范为 -7.320;训练后的 Human Flow 策略为 -2.664,遥操作策略为 -9.521,指标越高越平滑。作者将遥操作轨迹中的振荡和突然修正,与操作者无法直接感受机器人端接触力联系起来。
於柯霖在访谈中谈到的另一个问题,是示范对接触状态的覆盖:“比如说你每次接触的点不一样,或者你用的力不一样。”同一个任务会出现不同的接触位置、力度和物体响应,而遥操作示范未必覆盖这些情况。他也指出,遥操作数据可能采不到足够的接触信息,人为纠错同样有分布问题。强化学习让机器人在执行中遇到这些变化,并根据结果学习如何修正,数据中也因此包含了失败及恢复过程。
触觉表征:预训练编码器和低维标记点都能使用
团队在插杆和充电器插接任务中比较了 AnyTouch2、Sparsh、T3 三种预训练触觉图像编码器,以及只使用低维触觉标记点的两层 MLP。AnyTouch2 与低维标记点取得接近的最终表现,说明这套适配方法也能使用较简单的触觉表征。
T3 与 Sparsh 在动态接触更强的充电器插接中较弱,作者推测它们的预训练数据缺少动态操作触觉。
04
回到关键问题意识,我们该关注什么
回到论文背后的问题意识,我觉得值得关注的是以下两点:
视觉和触觉的数据规模相差很大,触觉还面临更具体的分布问题。大量视频和示范可以提供任务顺序、物体运动和动作轨迹,但不会自动包含机器人实际接触时的受力信息。触觉数据则与传感器、接触位置、力度和任务紧密相关。即便增加示范数量,也未必覆盖机器人执行时遇到的接触变化。
也许有一天我们能解决触觉规模化的问题,但是如果不能,我们如何去处理这种数据分布的不均衡?
第二点是,面向真实部署,已有策略如何进一步接近 100% 的成功率?
於柯霖对真机强化学习的判断,来自这个部署目标。
人类示范与机器人之间有本体和动力学差异,仿真与真实接触之间也有差距。即使前面的训练已经提供了很好的动作能力,在他看来,最后仍需要让机器人自主执行,根据真实反馈调整,适应自身硬件和任务条件。
归根结底,触觉任务的局限很难仅靠扩大离线数据来完全解决。
既然仿真与现实的差距无法避免,让机器人通过真实的物理交互与反馈去适应环境,或许是一条更具可行性的路径。

推荐阅读





×
右键可直接复制图片