 阅读时间大约7分钟(2529字)
1天前 Figure押注Ego数据,SuperMimic降低通用运控门槛
来源:豆包
人形机器人接下来怎么学干活?
作者:Yuanxq 出品:具身智能研究室
人形机器人完成“走到桌边、抓起瓶子、转身投放”,需要让双臂、躯干和双腿持续配合。围绕这类任务,一条研究路线逐渐清晰:先用动作跟踪训练可复用的全身控制器,再由视觉—语言—动作模型(VLA)根据场景和指令调用运动能力。SONIC 提供全身执行接口,WholeBodyVLA、Ψ₀ 等工作进一步探索视觉语言驱动的移动操作与人类经验迁移。随着训练任务增多,真机示范采集昂贵、难以持续扩充,成为一个直接的数据瓶颈。
HuGe 将超过 2,000 小时人类与机器人数据用于第一视角预训练、真机适应和下游微调。它重点处理人类示范进入训练前的三个问题:动作怎样转成机器人能执行的表示,缺失的机器人身体状态怎样补齐,画面中的人类手臂怎样适配机器人视角。其中一个关键做法是,让仿真 G1 执行转换后的示范,把执行时的身体状态记录下来,补回训练样本。 配合 SONIC 的统一动作接口和手臂外观替换,人类完成任务的过程便能用于训练全身策略。
方法实现
三阶段训练
第一阶段,用大规模第一视角经验学习任务与动作的对应关系。 作者汇集 EgoDex、EgoVerse、Xperience-10M 的人类示范,以及 BEHAVIOR-1K 的仿真机器人示范,共 1,669.61 小时。不同来源的运动被转换到 SONIC 动作空间,再配上图像、任务指令和仿真回放生成的身体状态,训练模型预测后续动作。
第二阶段,用真实 G1 数据适应机器人观测与执行。 Humanoid Everyday、UniFoLM-WBT 和 HIW-500 提供 417.58 小时示范。作者统一关节状态、手部开合和动作标签,继续训练视觉语言骨干与动作模块,让模型适应机器人实际看到的画面和身体配置。前两阶段合计 2,087.19 小时。
第三阶段,用目标任务数据完成专项微调。 仿真侧使用 HumanoidArena 的七个任务,每个任务 100 条示范;真机侧使用 110 条遥操作示范与 400 条人类示范,学习可乐抓取投放。人类示范由 PICO 4 Ultra 和手腕、腰部、脚踝跟踪器采集,补齐动作与状态后,再进行视觉适配,与机器人示范混合训练。
后两个阶段都从上一阶段的策略继续训练。视觉语言骨干与动作模块采用全参数更新,SONIC 控制器始终固定,由上层策略学习如何在不同任务中使用已有的全身运动能力。
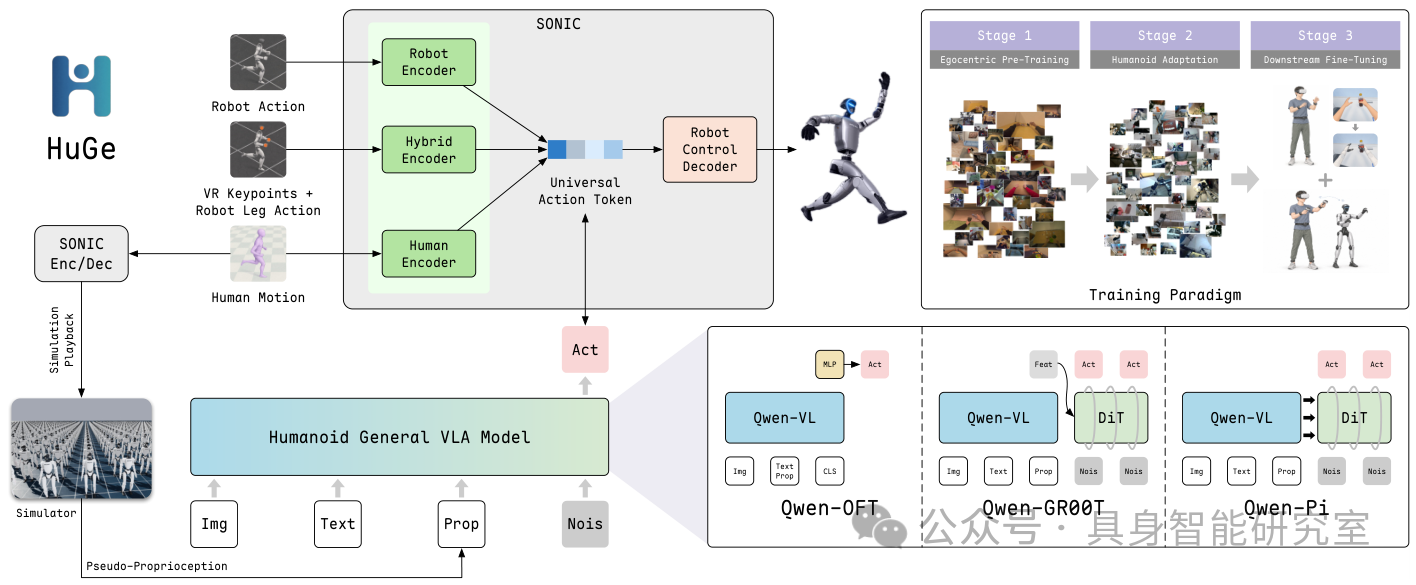
人类与机器人示范进入统一动作空间,经三阶段训练形成任务策略,再交给全身控制器执行。
全身动作接口
HuGe 接收第一视角 RGB 图像、语言指令和身体状态,每一步输出 66 维动作:64 维 SONIC 运动潜在表示,以及左右手各一维开合信号。运动潜在表示是一组连续数值,编码全身运动信息;SONIC 的控制解码器结合机器人状态,将其转换为关节指令,手部信号单独控制开合。
训练数据与部署策略共用 SONIC 的动作表示。 数据处理时,人体动作、机器人动作、VR 关键点与腿部参考,通过相应编码接口转换为运动表示;部署时,VLA 预测同类表示,交给控制器执行。具体处理中,EgoVerse 的头部和手腕轨迹配合固定站立下肢参考,Xperience-10M 提供全身运动参考,BEHAVIOR-1K 则通过规划器生成 G1 运动。
模型一次预测 50 步动作块,在 50 Hz 的动作时间轴上覆盖约 1 秒,联合学习伸手、身体调整等连续运动。所有变体使用 Qwen3-VL-2B-Instruct 骨干,动作生成采用三种已有设计:
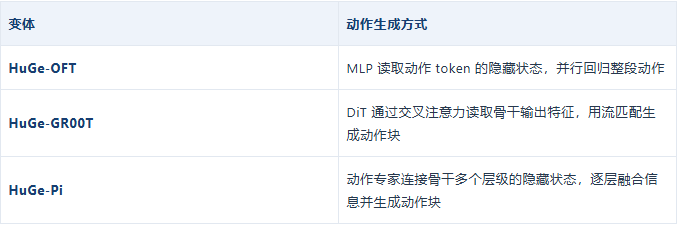
流匹配可以理解为学习把噪声动作逐步变成符合当前任务的动作序列。GR00T 与 Pi 的主要区别,在于动作模块读取视觉语言信息的位置和方式。
补齐身体状态
同样看到桌上的瓶子,机器人可能尚未伸手,也可能已经弯腰接近目标。身体配置决定了下一步动作的起点,而人类示范没有对应的 G1 关节记录。HuGe 利用仿真补上这部分信息:把转换后的动作交给虚拟 G1 执行,记录它在各时刻的身体配置,再与原始图像、指令和动作目标配对。仿真在这里承担了生成训练输入的作用。
最终得到的 34 维伪本体感知状态包含:29 维关节角、2 维手部状态和 3 维身体坐标系重力方向。关节角与重力方向来自回放,分别描述身体配置和倾斜;手部状态优先使用可用的开合标签,EgoDex 则保留仿真手部状态。“伪本体感知”指的就是这套为人类示范补建的机器人状态。
各维状态经过分位数裁剪和归一化后输入模型。手部标签根据关键点或控制事件构建,缺失标签对应的监督会被屏蔽。处理后的样本同时包含任务画面、身体配置和后续动作,模型便能学习从当前姿态出发,怎样完成下一段运动。
对齐手臂外观
抓取画面中,手、手臂和物体的相对位置是重要线索。人手与机械手的形状及遮挡关系不同,作者因此在下游微调前使用 Phantom 流程,移除人类手臂、修复背景,再合成机器人手部外观。
渲染由经过时间平滑的手部关键点引导,减少逐帧抖动;可乐抓取还加入抓取约束和拇指可见性先验,使合成手形与物体遮挡保持合理。视频外观改变,动作目标、伪本体状态和语言指令保持一致,原来的任务经验得以保留。
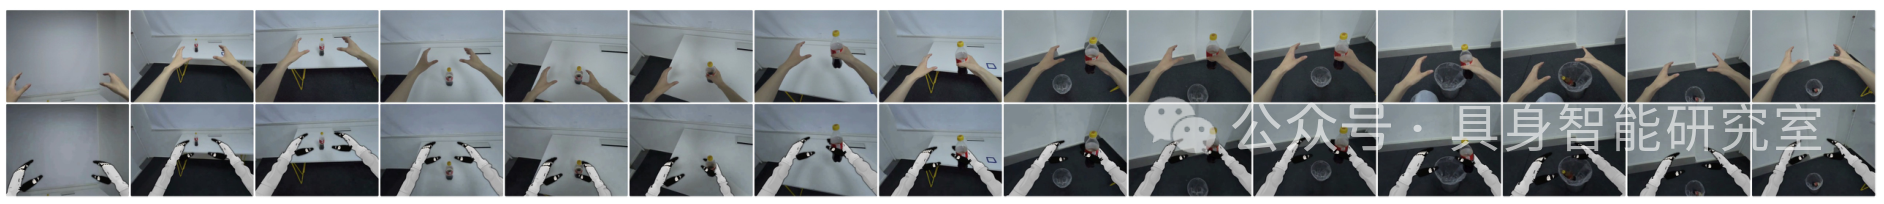
上排保留人类手臂,下排合成机器人外观;同一段任务动作使用相同的训练标签。
混合微调时,机器人样本与人类样本各占一半预期采样概率,使两类数据在训练中保持平衡。
实验结果
多任务表现
HumanoidArena 覆盖踢足球、跨桌搬运、箱体上架、开门、坐沙发、击打目标和避障导航。作者为每种变体训练一个多任务策略,每项任务测试 60 次,七项成功率取平均。
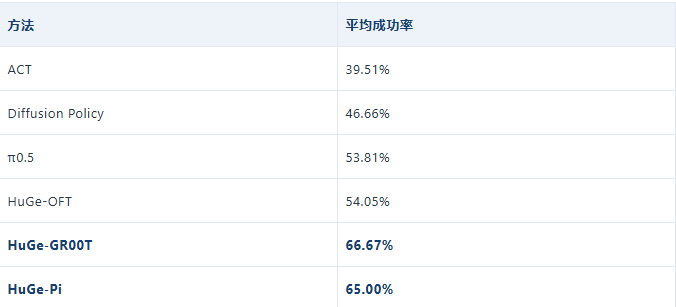
HuGe-GR00T 与 HuGe-Pi 分别超过 π0.5 12.86 和 11.19 个百分点,在人—物交互与人—场景交互两类任务的平均成绩上,也都超过列出的基线。其中,GR00T 的开门成功率达到 95.00%,Pi 的坐沙发成功率达到 83.33%。
训练组件验证
首先是更新方式。在未进行上述大规模任务预训练的设置中,OFT、GR00T、Pi 使用全参数微调的平均成功率分别为 55.00%、58.33%、60.24%,对应 LoRA 为 16.19%、34.05%、40.95%。因此,后续实验统一采用骨干与动作模块共同进行全参数训练的方式。
其次是身体状态。预训练加入伪本体感知后,GR00T 从 61.67% 提高到 66.67%,Pi 从 62.14% 提高到 65.00%。坐沙发的提升尤其明显:两者分别从 61.67%、68.33% 提高到 78.33%、83.33%。这项任务需要协调腰腿完成大幅姿态变化,结果支持了为人类示范补充机器人身体配置的价值。
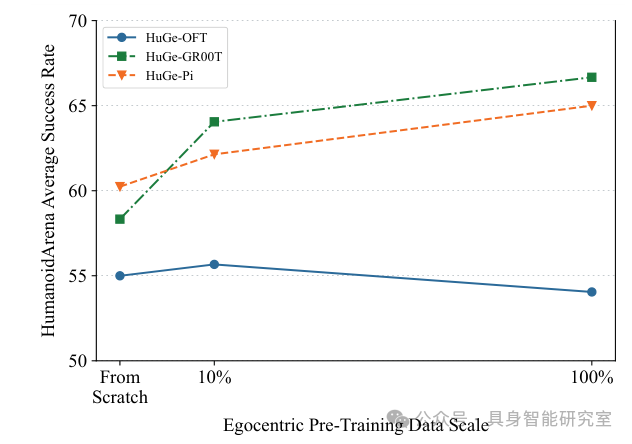
预训练数据从 10% 增至全部时,GR00T 与 Pi 的多任务平均成功率继续提高。
数据规模实验进一步显示,更多第一视角经验能够改善 GR00T 与 Pi 的下游控制表现。OFT 的曲线则有所下降,作者将其与状态文本被截断、输入描述不完整的问题联系起来。这也说明,训练数据中的身体信息需要通过合适的接口完整传入模型。
真机任务验证
真机采用配备 Inspire 灵巧手的 Unitree G1,使用 HuGe-Pi 完成“走近桌子—抓取可乐—转身移动—下蹲投放”的连续任务,并改变瓶子在桌面的位置。三种微调设置都固定使用 110 条机器人示范,每组测试 30 次。
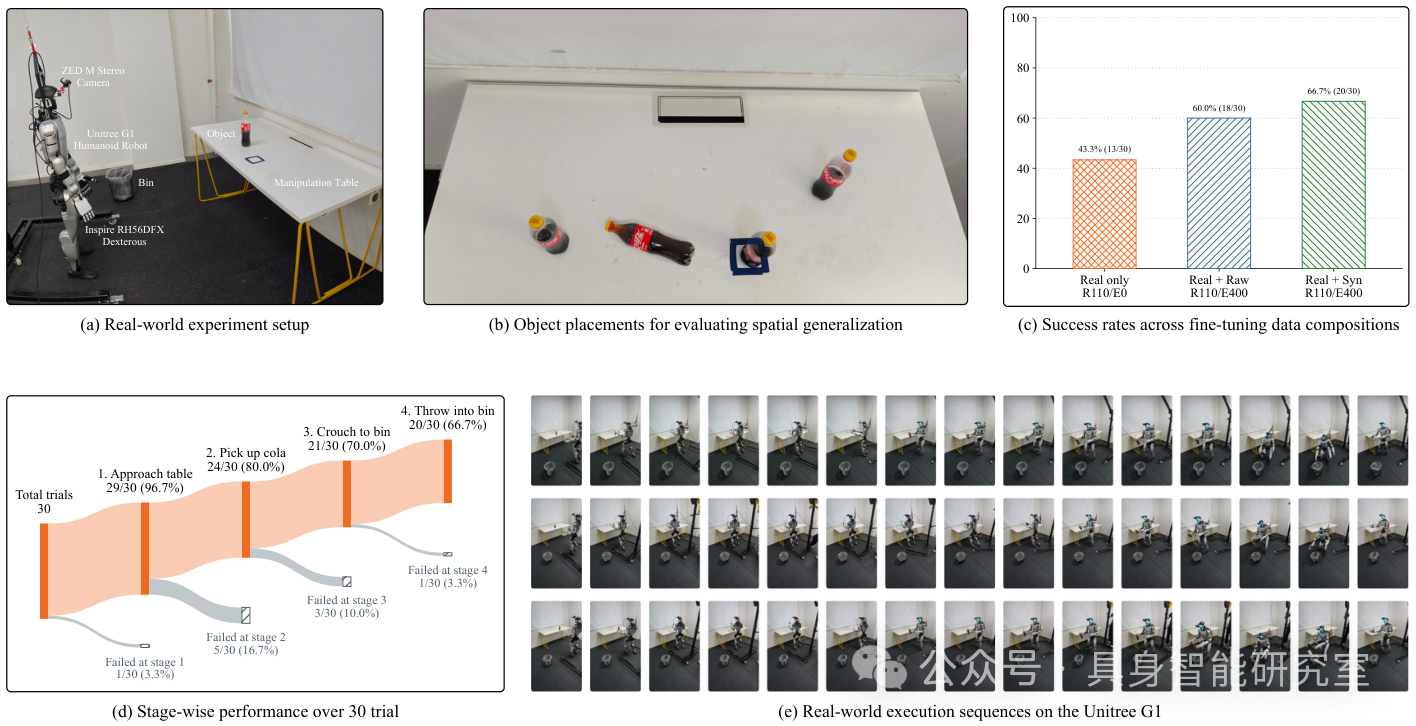
G1 连续完成接近、抓取和投放;加入人类示范后,完整任务成功次数增加。
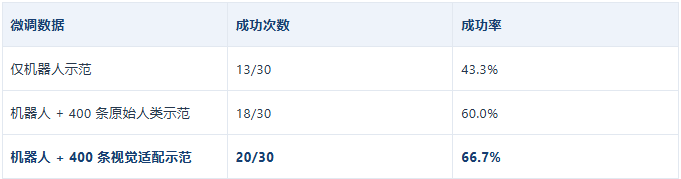
加入人类示范带来 5 次额外成功,视觉适配进一步增加 2 次。 最佳配置在 30 次测试中比仅用机器人数据多完成 7 次任务,成功率提高约 23.3 个百分点。后两组使用同一批人类示范,动作、状态和语言标签相同,因此这组对照能够单独考察改变视频外观的效果。
视觉适配是否让训练画面更接近真机,作者用三个视频模型提取特征进行比较。适配后,人类示范与真实 G1 视频之间的 Fréchet 距离,在 Wan2.2、VideoMAE V2 和 V-JEPA 2 特征空间中分别下降 33.54%、27.07% 和 13.83%。视频特征更接近真机观测,任务测试也获得了更多成功次数。
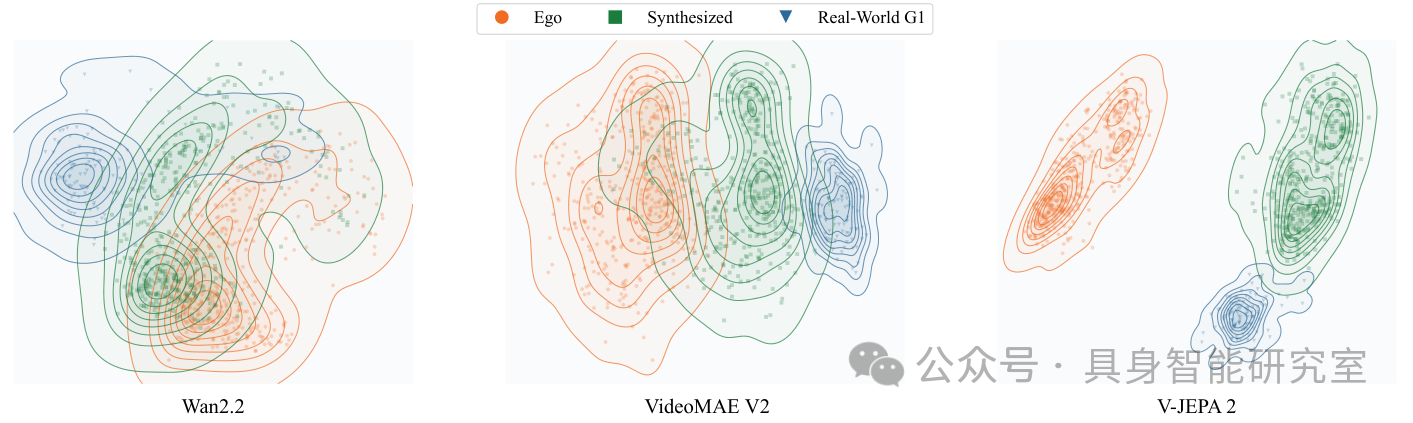
橙色为原始人类视频,绿色为合成视频,蓝色为真机视频;适配后的特征分布向真机数据靠近。

推荐阅读





×
右键可直接复制图片