 阅读时间大约7分钟(2540字)
2026-09-15 机器人数据不是一个池子:示范、失败和接管分别教会模型什么
来源:豆包
作者:毛不毛 出品:具身智能前沿导读机器人采到的遥操轨迹、自主执行记录、人工接管和第一视角视频,常被一起叫作“具身数据”。但它...
作者:毛不毛 出品:具身智能前沿
导读
机器人采到的遥操轨迹、自主执行记录、人工接管和第一视角视频,常被一起叫作“具身数据”。但它们提供的监督强度并不相同:成功示范直接告诉策略在某个状态下怎样动;任务结果和失败更适合判断一段行为好不好;人工接管留下的是偏离现场的修正;只有视频的 Ego 数据则主要补视觉与任务先验。把这些区别保留下来,训练系统才能知道该让哪类数据承担哪种学习任务。
先别问“数据够不够”,先问它给了模型什么答案
一台机器人完成一次“把杯子放进抽屉”,可能留下相机画面、关节状态、控制动作、任务是否完成、何时由人接管,以及一段人类第一视角视频。它们都能进入数据平台,却不能都拿来训练同一件事。
原因不复杂:模型面对的提问不同。行为克隆(behavior cloning,直接学习在某个观察下输出什么动作)需要“当时该怎样动”的答案;价值或奖励学习(给动作或一段过程估计好坏)需要“这段过程好不好、离完成还有多远”的答案;纠正学习需要“已经偏离时,接下来怎样拉回”的答案。只有视觉的视频,甚至没有足够信息回答“机械臂下一帧该发什么控制指令”。
把它们粗暴混成一个大池,最容易丢掉的不是数据量,而是标签的含义。下面这张表可以作为最小分流规则:
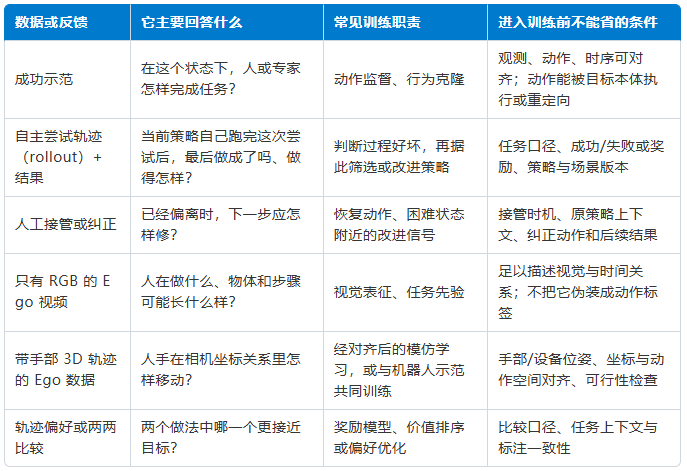
这不是把每种数据对应到唯一算法。RECAP这类方法就会同时使用示范、自主执行和专家遥操介入。关键在于:同一批样本可以进入同一轮训练,但不能假装每一行都提供了同样的答案。
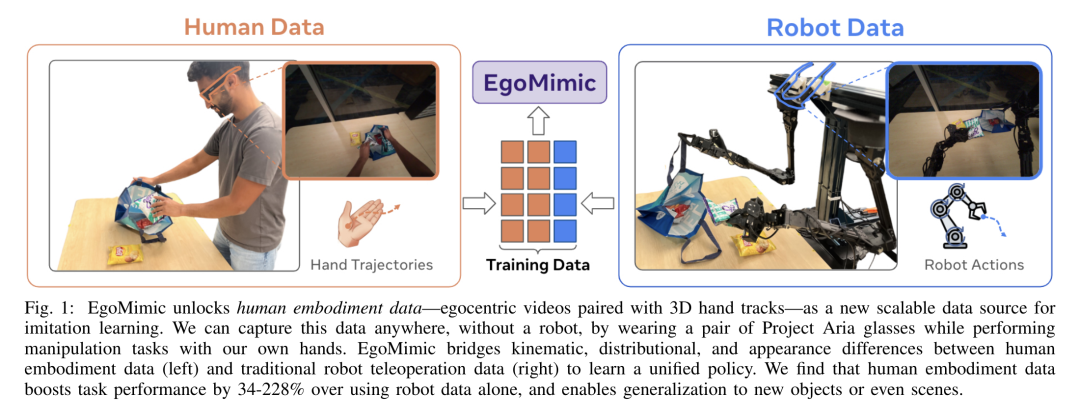
图片说明:图中左侧的人类数据包含第一视角画面和手部轨迹,右侧才是机器人观测与动作;中间的训练模块需要处理两者的对齐。图片来源:EgoMimic 论文 Figure 1
成功示范:最直接的动作老师,但不等于覆盖了真实部署
这里说的“示范”,不是一段“有人完成过任务”的视频,而是一条足以形成观测—动作配对的任务轨迹。最典型的来源是遥操作:人控制目标机器人完成拿起、移动、放下,系统同步记录相机画面、本体状态、动作指令和任务结果。策略于是能学到:看到相近画面和状态时,应该输出相近动作。
这正是成功示范的优势:它给的是细粒度动作答案。比如夹爪该朝哪个方向移动、何时闭合、末端到达哪里,都是其他粗标签很难补出的信息。
但它也有明确边界。示范通常覆盖的是专家走过的状态;机器人部署时一次抓偏、物体反光或动作延迟,就可能进入示范中没出现过的状态。此时继续问“专家在原来的画面里怎么做”已经不够,系统需要知道当前尝试是变好还是变坏,以及偏离后如何恢复。
因此,成功示范应被理解为冷启动和基础动作监督,而不是“只要收够了,后续失败数据就没有价值”。
Ego:视频本身不等于示范,带轨迹的 Ego 才可能参与动作学习
Ego(第一视角数据,记录操作者看到的画面)容易被放进“人类示范”这个大词里。这个叫法本身没错,但用于训练时必须追问:它究竟记录了什么?
如果只有 RGB 视频,模型可以从连续画面里学习物体、场景、交互顺序和任务语义。R3M就用 Ego4D 人类视频预训练视觉表征,再把这套视觉模块用于下游机器人策略学习。这里的视频提供的是“看懂正在发生什么”的基础,不是可直接交给机械臂的逐步动作。
EgoMimic走的是更强的一条路线:Project Aria 眼镜采集第一视角画面、三维手部追踪和设备定位信息,再处理人手与机器人之间的运动学、外观和动作分布差异,并与遥操机器人数据共同训练。它说明带轨迹的 Ego 数据可以进入动作层面的学习;同时也恰好说明,让 Ego 变成可用动作监督,靠的不是“第一视角”四个字,而是额外的轨迹、坐标和对齐工程。
所以数据集的字段说明里,至少应区分“Ego RGB”“Ego + 手部轨迹”和“已对齐到目标机器人接口的 Ego”。把三者统一记为“人类视频示范”,会让后续训练者误以为每条数据都能直接监督动作。
失败和人工接管:一个告诉你哪里不对,一个留下怎样拉回
自主尝试轨迹(rollout)是当前策略自己从开始到结束跑出来的一次任务过程。它特别有价值,因为它会进入遥操专家没见过的偏离状态;但一段 rollout 并不会自动带着“正确动作”标签。若只知道它最终失败,最稳妥的含义只是:这条过程在既定任务口径下没有达到目标。它可以成为奖励、价值或筛选信号,却不能凭空还原每一时刻理应执行的精确动作。
人工接管补上的正是这部分信息。当机器人把杯子抓偏后,操作者接管并把末端拉回能继续抓取的位置,记录中就出现了一个更具体的信号:在这个偏离状态附近,原策略继续执行不如这段纠正动作。接管若连同触发位置、机器人状态、操作动作和之后的任务结果一起保存,就比“失败了一次”的视频更能服务恢复训练。
RECAP 的公开流程把这两种数据放在同一个迭代环里:部署预训练的视觉—语言—动作模型(VLA),收集自主 rollout 与在线人类纠正,用在线数据更新对任务进展的评估,再据此改善策略。它不是在说“所有失败都应该被模仿”;恰恰相反,rollout 的结果与纠正动作承担了不同角色。
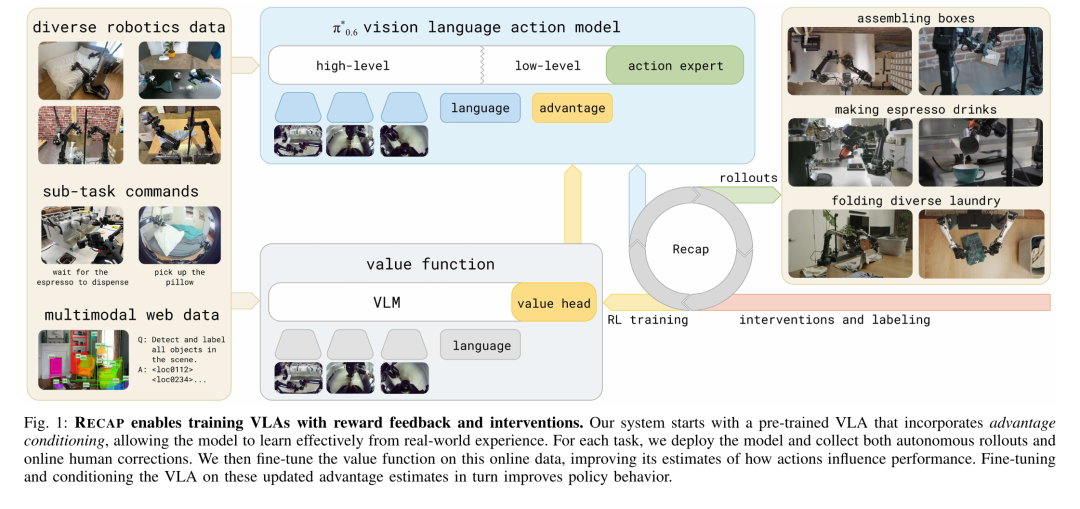
图片说明:右下角的 interventions and labeling 与 rollouts 共同进入迭代训练;图中不把失败轨迹画成单独的专家动作标签。图片来源:π*0.6: a VLA That Learns From Experience,Figure 1
结果与偏好:它们更像裁判,不是逐帧动作脚本
“任务成功/失败”是最简洁的结果信号。它能告诉系统一段执行有没有完成目标,却往往不能解释是视觉识别、接触控制还是动作时序出了问题。若任务结果很稀疏,数据工程还需要保留子任务、失败位置、人工接管和场景条件,才有机会把一次失败归到可修复的方向。
偏好信号则更进一步:人不必亲自演示完整轨迹,只需判断两条路径中哪条更好。Mehta 与 Losey 的研究把完整示范、局部纠正和轨迹偏好放进同一奖励学习框架,但图中三种输入的粒度并不相同:完整示范覆盖整个目标轨迹,纠正只针对局部运动,偏好只给出两种行为的相对好坏。
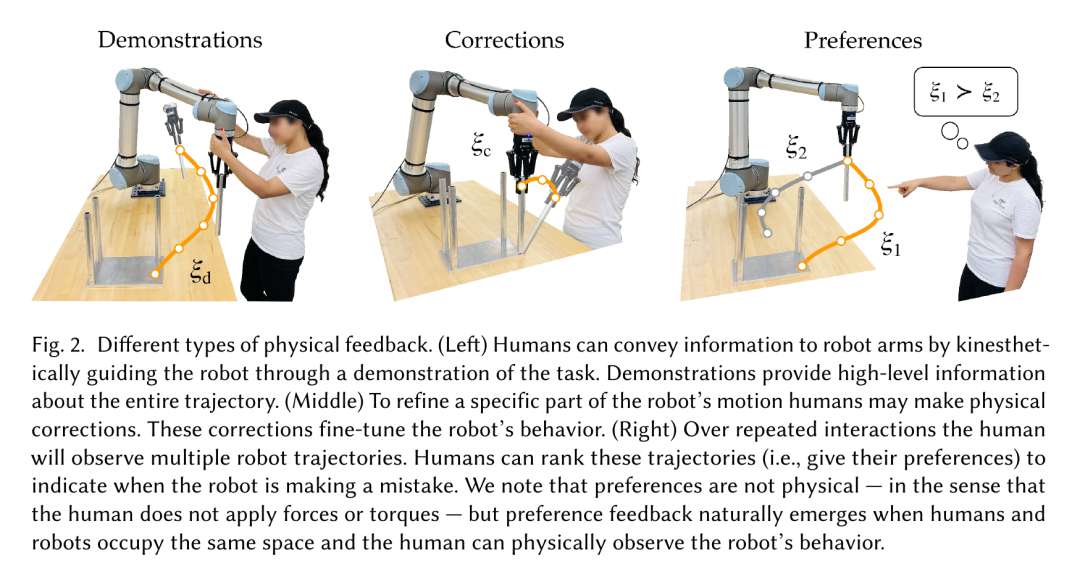
图片说明:左侧给出完整动作路径,中间是在局部位置修正轨迹,右侧只比较两条轨迹何者更好。图片来源:Unified Learning from Demonstrations, Corrections, and Preferences during Physical Human-Robot Interaction,Figure 2
这带来一个很实用的判断:如果团队缺的是“机器人此刻到底该怎么动”,优先补可执行示范或接管纠正;如果缺的是“现有策略的多个做法哪种更接近目标”,任务结果和偏好标签更合适。用偏好替代动作标签,或者拿一次成功标签替代局部恢复动作,都会让训练目标接收到比它需要更粗的答案。
真正要管理的,是信号与训练目标之间的对应关系
把这些数据放回一条部署链,采集系统至少应把下面几件事拆开保存:
动作可用性:动作是目标本体的控制指令、可重定向的末端轨迹,还是根本没有动作?
结果口径:成功、失败、部分完成分别按什么任务规则判定?
人工介入:谁在什么时候接管,接管前的策略输出是什么,纠正后是否恢复?
上下文与版本:场景、对象、传感器、策略和控制器版本分别是什么?
训练去向:该样本是用来教动作、预训练视觉表征、判断过程好坏、学习恢复动作,还是只进入回归测试?
这不是为了给数据仓库多添几列字段。它决定了模型到底能从一条记录里学到什么,也决定了失败之后该补采完整示范、补接管样本,还是只需要补结果标注。
第 3 篇讨论过,飞轮能否成立取决于部署反馈能不能改变下一版系统。走到训练这一层,答案可以再具体一点:数据飞轮不是把更多记录送进训练,而是让每种记录以它真正携带的监督形式,改变正确的那一部分系统。
推荐阅读

×
右键可直接复制图片