 阅读时间大约8分钟(2839字)
2026-09-15 Skild AI 十个月做到 1 亿美元 ARR:部署才是机器人研究的隐形支柱
来源:豆包
作者:Marilyn 出品:具身纪元SkildAI在2026年9月9日宣布,公司年化收入运行率(ARR)越过1亿美元,距离第一...
作者:Marilyn 出品:具身纪元
Skild AI 在 2026 年 9 月 9 日宣布,公司年化收入运行率(ARR)越过 1 亿美元,距离第一次商业部署只有十个月,付费客户超过 60 家。两位创始人 Deepak Pathak 和 Abhinav Gupta 用同一篇文章讲了他们眼里更重要的那件事:部署不是研究做完之后的收尾动作,而是机器人研究本身的一根支柱。文章最后一句话是,演示的时代结束了,部署的时代开始了。
一、十个月,1 亿美元 ARR
今天,Skild AI 的年化收入运行率跨过 1 亿美元,距离我们第一次商业部署过去了十个月。
首先,感谢团队的每一位成员,以及让这件事成为可能的每一位合作伙伴。
这背后是很多优秀的人付出的大量努力。十个月里,我们扩展到 60 多家付费客户,业务覆盖货物搬运、配送、场地巡检、安防、餐食制备,也包括在仓库、工厂和数据中心内部作业。移动类应用占我们收入的 10%,Fetch 方案占 4%。
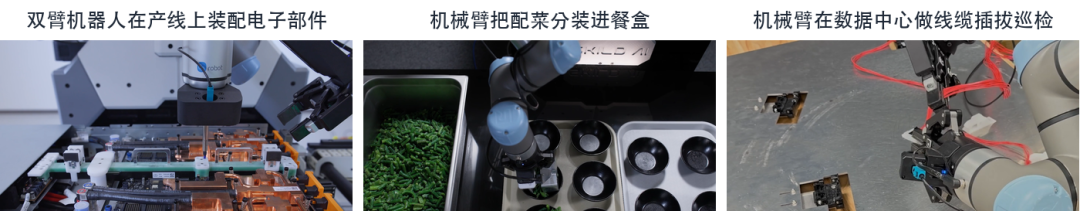
图注:Skild 官方视频里出现的产线装配、商用厨房备餐和数据中心线缆巡检三类现场。
我们和英伟达、富士康一起,把 Skild Brain 部署在双臂机械臂上,用于英伟达 Blackwell 系统的高精度装配。这类工作每换一个产品周期就会变一次,过去意味着要把产线上的每一台机器人重新编程。
在住友电装(Sumitomo Wiring Systems),我们正在推进把 S1 部署进线束制造,去自动化那些一直被认为“不可能自动化”的工序。
三井物产(Mitsui & Co.)的供应链每天在日本供应 140 万份餐食,我们和他们一起,在商用厨房里试点由 S1 驱动的通用机器人。
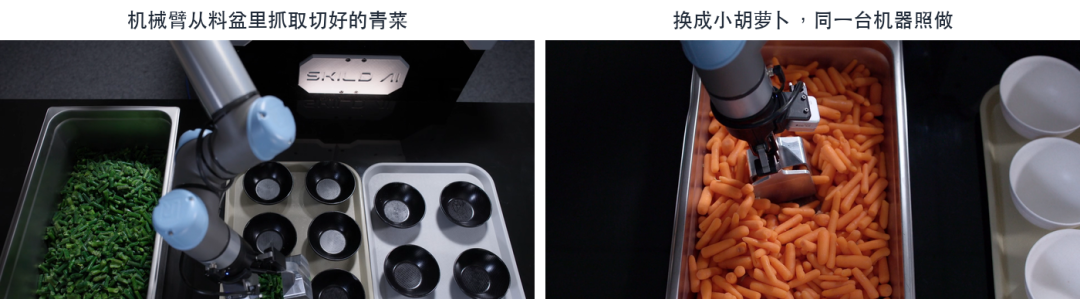
图注:机械臂在商用厨房里分装配菜,换一种食材不用换一套程序。
从一开始,我们就把部署当作技术本身的一部分,而不是技术的产出结果。
二、隐形的支柱
机器人行业里有一种想法大致是这样的:我们先训练出一个超级智能的模型,再造出超越人类的硬件,然后某一天——砰——机器人遍地都是。
用语言模型来类比,这听上去没错。多年研究,然后是 ChatGPT,据估计两个月内就有 1 亿月活用户。从外面看,部署好像是在难的部分做完之后,一下子全部到来的。
在机器人领域,你没法把部署留到最后。
供应链怎么理顺?谁来安装?谁负责集成?坏了谁修?流程变了谁来更新?这些问题,不到现场就没法真正搞清楚。
部署是机器人研究的隐形支柱,因为机器人是在部署里发生的。这件事没有替代品。
部署也在反过来决定 Skild 的前沿研究方向。下面举几个例子。
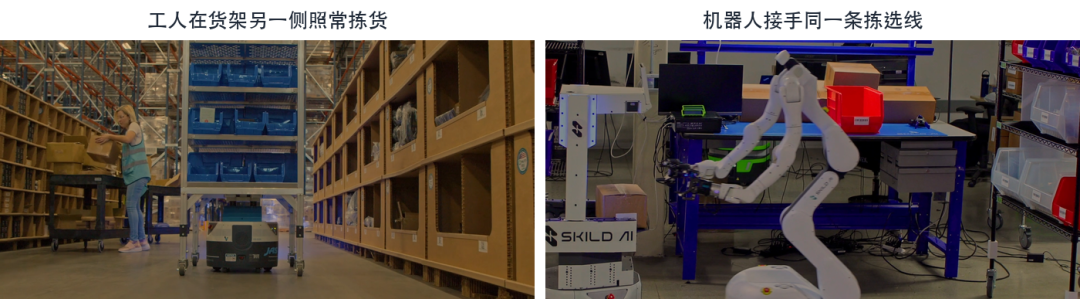
图注:G10 的仓库现场,工人和 Skild 的移动机器人在同一条拣选线上作业。
三、演示与部署,看着一样,差得很远
看演示视频,已经成了衡量物理 AI 进展的常见方式。你看完一段视频,会觉得“看起来它能用了”。
问题在于,一台准确率 5%、10% 或 99% 的机器人,剪出来的成功片段可以完全一样。哪怕只有 10% 的准确率,你也可以一直拍到成功为止。
我们去年教模型做鸡蛋。做出第一个鸡蛋用了一周,而要让它在不同的鸡蛋、不同的场地里都稳定工作,又花了两个月。
所以在机器人这件事上,眼见并不为实。真正算数的是部署。把最后 5% 的性能做出来所需的努力,远远超过前面 95%。
3.1 速度与准确率
从研究的视角看,准确率像是那个主要指标。从部署的视角看,你立刻要追问一句:在这个准确率下,机器人能干多快?
设想一条有十个工位的产线,五个由机器人操作,五个由人操作。每个工位都必须在大致相同的节拍时间内完成。只要有一个工位更慢,它就会限制整条线的产出。
一台准确率 99.9% 但慢了十倍的机器人,不是“接近可以部署”,而是不能部署。
部署优先的公司,从一开始就在时间约束下优化成功率。
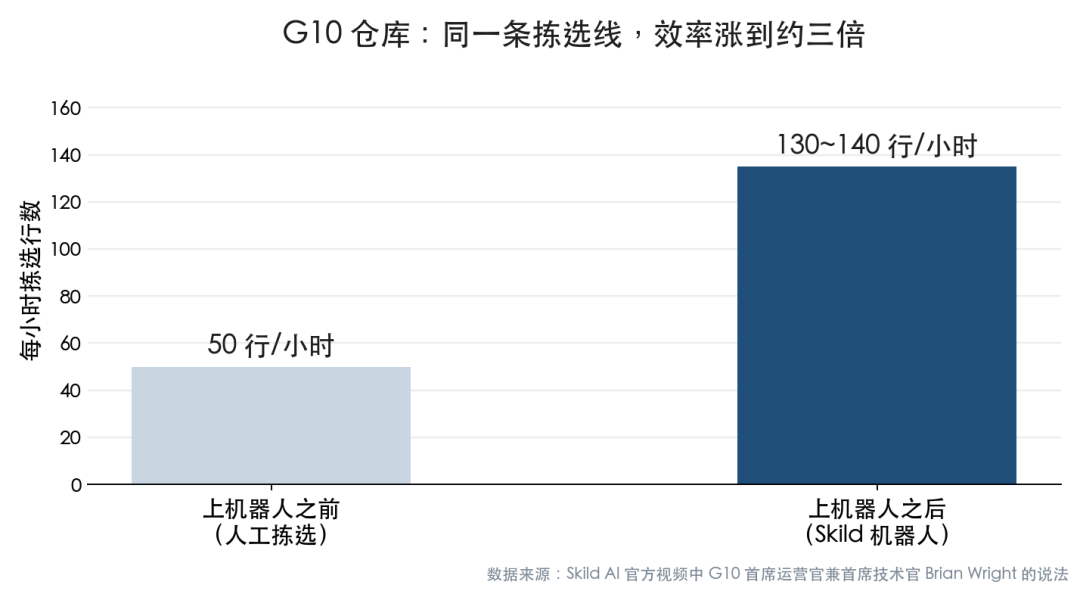
图注:G10 首席运营官兼首席技术官 Brian Wright 在官方视频里给出的数字,按其说法重绘。
3.2 适应变化
部署早期我们学到的一个硬道理:变化才是唯一不变的事。
供应商换一个零件。工厂重排一个工位。客户改一次装配顺序。你部署下去的系统必须跟着变。
如果每一次变化都要重新采集一份数据集、再跑一轮后训练,那就等于承诺:只要这台机器人还在现场,这套活就要一直重做。这不可扩展。
这些在部署里付出代价才学到的东西,让我们把研究精力集中到了两周前发布的最新模型 S1 上。
我们把 S1 做成可以从单个视频示例中通过上下文学习来学习。操作员录一段新的示范,把它作为提示交给机器人,不需要更新模型权重。S1 建立在英伟达 AI 基础设施之上,这给了我们在多样化机器人数据上做大规模训练所需的加速计算基础。
Skild AI 官方 X 账号在 8 月 25 日发布 S1:一个从一个例子中学习的新基础模型,可以通过一段视频提示学会此前从未见过的、长达 10 分钟的任务,不做任何微调。
如果我们一直待在研究的世界里,这件事会成为这么高的优先级吗?我们认为不会。是部署让我们向自己提出了这个问题,S1 是我们的回答。
四、演示文化和部署文化,只能选一个
演示也可能是有害的。在同一家公司内部,同时维持一种演示文化和一种部署文化非常困难。
从一台准确率 50% 的机器人身上,你可以挑出一段漂亮的演示。而要部署,你必须去处理另外那 50%——那要难得多。
如果你公开庆祝这些“先进”的演示,做演示的人会受到鼓励。做那被低估的 50% 的人得到的关注更少,尽管正是他们的工作让机器人真正有用。
有资源把两件事都做,并不会让这种激励消失。
你可以在内部通过奖励真实的部署工作来对抗它。但接着聪明人就会问:“既然真正的工作在部署,我为什么要把时间花在演示上?”——于是演示文化还是死掉了。
公司奖励什么,人就会做什么。我们选择奖励部署。
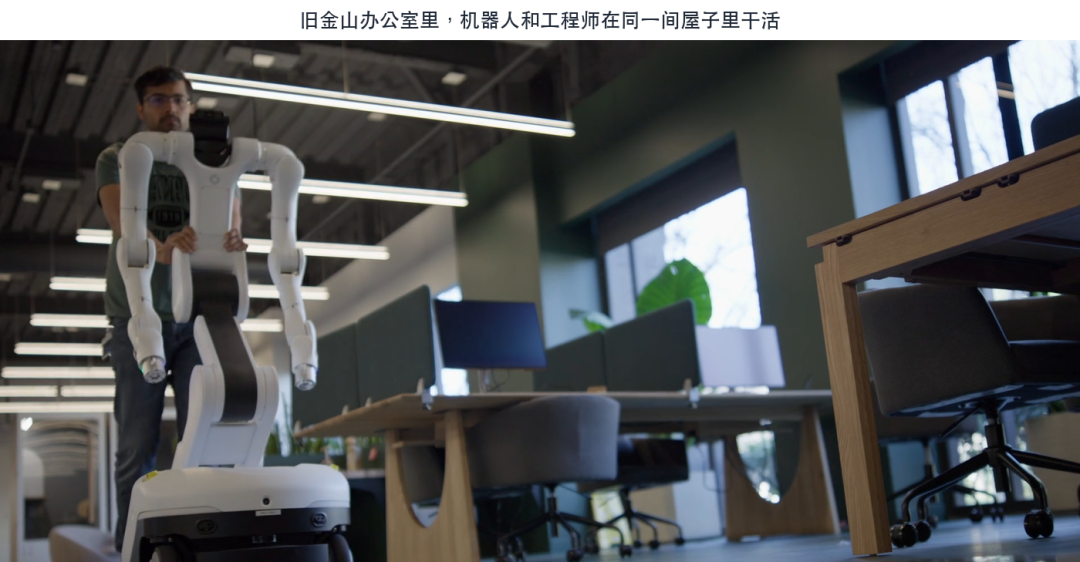
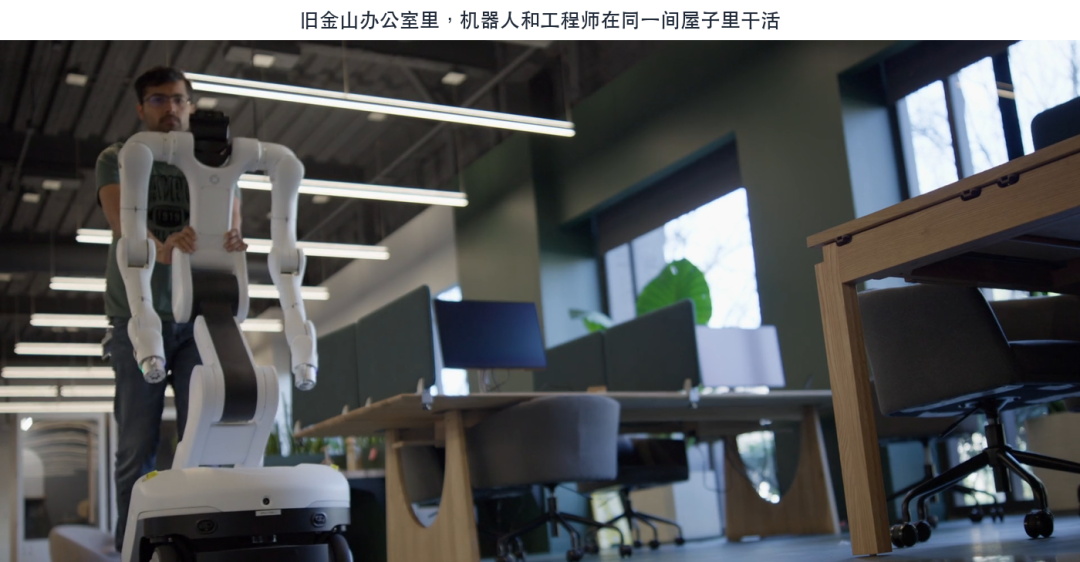
图注:Skild 旧金山办公室,机器人和工程师在同一间屋子里工作。
五、物理世界的递归自我改进
部署是研究的一根支柱,也是评估的一根支柱。它还逼着我们直面那些会让公司偏离有用工作的文化激励。
它同时也是我们思考物理 RSI(recursive self-improvement,递归自我改进)的方式。
关于部署数据有两种常见看法。一种认为部署将成为机器人训练数据的终极来源。另一种认为部署数据太窄,无法改进通用模型,因为一台部署中的机器人只是一遍遍重复同一个任务。两种看法都对了一部分。
如果一台专用机器人已经能可靠地拧开某个瓶盖,再收集几千个同样成功动作的样本,可能带来的增益很小。这个专用系统已经掌握了它的任务。价值出现在把许多专用系统学到的东西带回通用基础模型的时候。
先从一个跨不同机器人、任务和本体训练出来的基础模型开始。它广泛可用,但在任何一件事上都不完美。
把它部署到不同的应用中。上下文学习让它在适应变化时不需要为每一次改动重新训练。在需要进一步训练才能达到生产级速度和可靠性的地方,部署数据可以帮助系统专业化。每一个部署都会在自己的任务上变得更好。
再把这些部署里的数据带回通用模型。那些对已经掌握单一任务的专才增益很小的经验,对一个正在学习许多不同任务的通才仍然有价值。下一次部署,就从一个更强的模型开始。
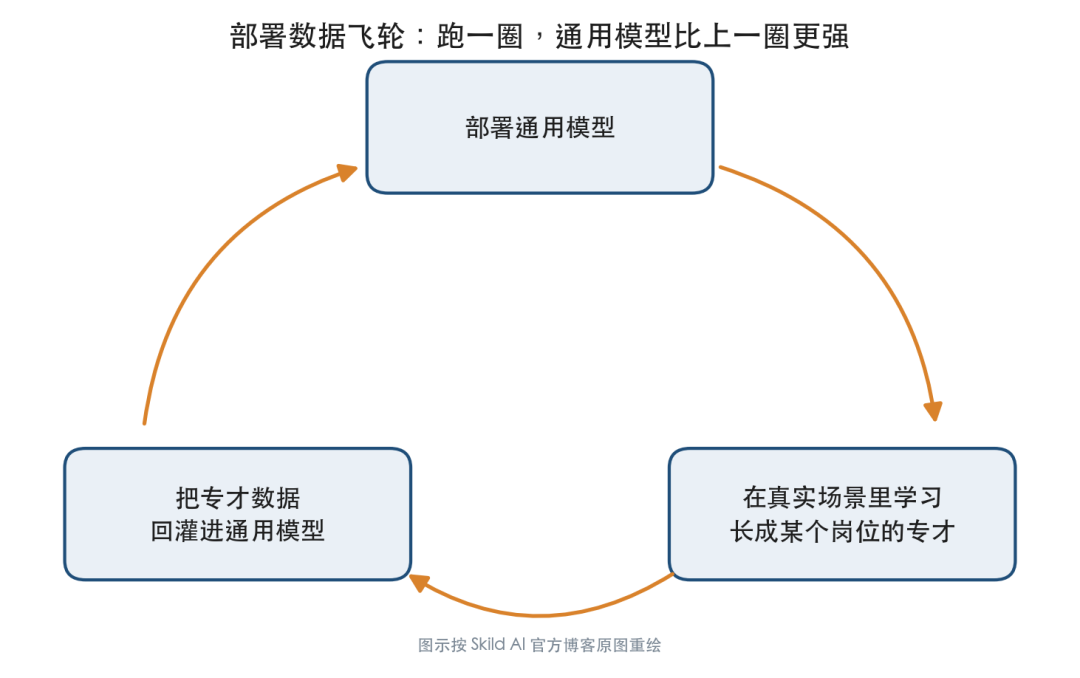
图注:Skild 官方博客里的部署数据飞轮,按原图重绘。
我们用的类比是我自己受的教育。
在高中,我们把物理、化学、数学都学到了不错的水平。之后我们专攻 AI。今天我们对 AI 的了解远超高中时的自己,但当年会的化学,已经忘掉了很多。
现在设想,我们可以把高中时的自己拿出来,在一个平行宇宙里去读一个化学博士,另一个宇宙里读物理,再一个宇宙里读数学。然后把所有这些专业知识,重新蒸馏回我们最初的那个学生身上。
这就是我们的策略。通过部署,我们让那个“高中时的自己”——S1——越来越强。通才学到的越多,下一次部署需要的专业化就越少。这就是部署数据飞轮。
六、演示的时代结束了
演示的时代结束了,部署的时代开始了。
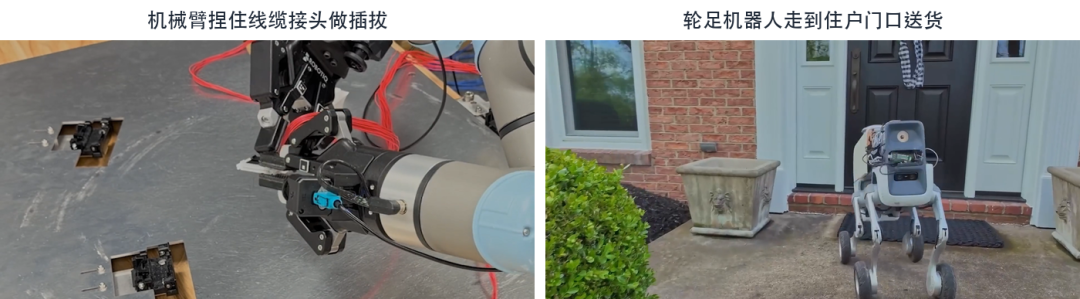
图注:Skild 部署的轮足机器人走到住户门口,以及机械臂在数据中心做线缆插拔。
——Deepak Pathak(Skild AI 联合创始人兼 CEO)、Abhinav Gupta(Skild AI 联合创始人兼总裁)
视频里还有三段客户自述:G10首席运营官兼首席技术官 Brian Wright 说,过去人工拣选大约每小时 50 行,用上机器人之后涨到差不多每小时 130 到 140 行;三井物产的 Takayuki Hota 说,旗下 AIM Services 每天提供 140 万份餐食,摆盘是其中最耗人力的工序之一,所以他们需要一台足够通用的机器人;STN Inc. 创始人兼 CEO Sabur Mian 说,随着数据中心越建越多,需要持续进行的巡检工作量很大。视频结尾的说法是:走到这个里程碑,又是第一天。
推荐阅读

×
右键可直接复制图片