 阅读时间大约10分钟以上(10181字)
2026-09-16 数据规模跨过百万小时之后,具身智能开始真正考验 AI Infra
来源:豆包
作者:杨正 出品:具身元点从确定这一轮用哪些数据,到第一个训练批次真正开始,DynaRobotics原先需要约48小时;改造之...
作者:杨正 出品:具身元点
从确定这一轮用哪些数据,到第一个训练批次真正开始,Dyna Robotics 原先需要约 48 小时;改造之后是 1 分钟以内。数据导入吞吐提升到原来的 31 倍。这些数字背后不是某一处优化,而是整套 AI Infra 被重新做了一遍。
本文基于Dyna Robotics围绕Dyna-2发布的三篇公开文章,从AI Infra视角做一次技术解读。Dyna Robotics在百万小时数据规模和大规模GPU集群训练条件下完成了整套 AI Infra的重建,并把完整的过程、问题和改造方法公开写了出来。这类实践在行业里并不多见,对其他正在扩展具身智能训练规模的团队有参考价值。
本文望帮助读者理解:在这样的规模条件下,这些工程问题背后揭示的行业变化是什么。具身智能继续扩展,不能只依赖更强的算法、更多的数据和更多的GPU,还需要一套能够把三者稳定转化为训练与部署产出的AI Infra。
01.
三篇文章分别回答了什么
2026年8月,Dyna Robotics连发三篇文章:《Dyna-2》讲模型,回答的是这个模型为什么能越训越好;《Training Dyna-2 at million-hour scale, repeatably》讲支撑它的训练基础设施,回答的是这样的模型怎么才训得出来,以及这套训练路径如何变成可重复使用的基础设施;《Not Just a Model, But a Product》讲产品与部署,回答的是训出来之后怎么在客户现场一直达标。三篇的完整标题与地址列在文末。
第一篇给出的结果是这样的:Dyna-2的预训练用了100万小时人类第一人称视频,这一阶段一条机器人数据都不用,在39个它从没见过的机器人任务上,模型对机器人动作的离线预测随人类视频规模持续改善。Dyna Robotics声称,据其所知,这是首次证明人类视频到机器人的迁移存在scaling law,也就是人类视频喂得越多,模型在它从没见过的机器人数据上表现越好。
for the first time, proves the existence of a human-to-robot transfer scaling law.
https://www.dyna.co/dyna-2
Dyna-2是一个世界动作模型(world-action model,简称 WAM),目前已经在客户现场投入日常生产运行。就具身智能当前的状态而言,这是一个相当扎实的结果。上一代 Dyna-1 是视觉语言动作模型(vision-language-action,简称 VLA),也是过去两年具身领域最主流的那一类。
第三篇讲的是从模型到产品这一步:合格标准由客户定,机器人在现场产出的每一条作业记录都要照这个标准评一次,一直评下去。他们由此说了一句,评估首先是一个基础设施问题,其次才是研究问题。
That turns evaluation into an infrastructure problem before it is a research one.
https://www.dyna.co/research/scaling-customer-deployments
评估要进入真实部署现场,首先需要把机器人一整天的作业记录传回来,逐条判断是否达标,并持续跟踪每台机器的状态。研究结论能够成立之前,这些基础设施问题必须先被解决。
三篇里,本文要往下讲的是第二篇。它把一件很少有人分享的事情完整披露了:为了把这个世界动作模型(WAM)在百万小时的语料上训出来,这套 AI Infra 是怎么重新做了一遍的。
文章从数据怎么存、怎么收开始,一直讲到数据如何编目、筛选、送到GPU,再讲到优化器状态如何在多台机器之间切分,以及作业中断后如何从训练检查点(checkpoint) 恢复。六个模块逐个展开,分别交代了原来的瓶颈和改造方法,其中多处给出了改造前后的量化结果。更值得注意的是,这次重建发生在上一代模型已经部署到客户现场之后。
这次AI Infra重建换来了什么,他们给了三个数字:数据导入吞吐从每周1.4万采集小时(episode-hours)提升到44万,是原先的31倍;按这一吞吐折算,处理100万小时语料所需的时间从约16个月压缩到3周以内;
从确定这一轮用哪些数据,到第一个训练批次真正开始,耗时从约48小时缩短到1分钟
以内。第二篇的引言里是这么写的:机器人领域的讨论往往更关注模型和数据,而不是它们底下的基础设施,而我们从一开始就把重心放在了另一边。
Robotics discussion tends to focus on models and data more than the infrastructure underneath them. We have weighted our focus the other way from the start.
https://www.dyna.co/research/dyna-2-infrastructure
他们说的就是一件事:AI Infra的重要性被低估了,而他们从一开始就把重心押在了这一侧。 对其他团队来说,它带出的问题,人人都能拿回自己公司问一遍:已经到位的算力,最后有多少变成了有效的训练。而且这不是只有走到百万小时的团队才需要关心的事。更多团队根本没走到那个量级,就已经被AI Infra卡住了手脚:一个方向本来值得一试,却因为数据喂不动、实验跑不起来,还没等到验证就被划掉了。
这里要先向Dyna Robotics表达敬意。 第二篇给出的不只是漂亮的结果,还有走到这个结果之前的大量工程过程,包括失效的旧做法和问题定位过程。这一篇的细节密到别人可以拿自己的情况逐条对着看,这也是这篇文章对整个具身行业最有价值的地方。
当具身训练数据从万小时级扩大到百万小时级时,四种在较小规模下可能成立的工程判断开始失效。这四种判断在万小时级数据和较小集群上可能暂时成立:模型上线之后,AI Infra会逐渐稳定;机器没有报错,就意味着GPU正在有效工作;存储和分发配置可以独立于模型设计;实验跑不出结果,就说明方向不可行。这四条失效,牵动的是一家公司的资源投向、团队分工,以及它该不该相信自己跑出来的实验结论。
这四条失效指向的是同一件事:买回来多少算力,和这些算力最后有多少变成了有效训练,是两个数,而中间隔着的正是下文要讲的那套AI Infra。第四条还要多走一步:规模不够的时候,受影响的不只是训练快慢,还有实验结论本身可不可信。
02.
模型上线,不等于 AI Infra 就此定型
多数团队给AI Infra的定位很清楚:把 GPU 配好、环境装好、训练跑起来,剩下的交给算法。这个定位正在失效。
这类训练的原始素材不是图片,也不是一段视频,而是一条一条的作业记录(episode):机器人完整做一次任务的全过程,里面同时装着几路相机的画面、机械臂各个关节的角度和电流、下发的控制指令、以及应用层的事件,全部按同一根时间轴对齐。所谓一万小时、百万小时,量的就是这种记录的累计时长。
当这个时长从一万量级涨到百万量级,Dyna Robotics给出的结论是:这不是等比放大,而是一次从头到尾的系统重构。他们的原话是,一万小时阶段行之有效的做法,在百万小时基本上都没能扛住。
Most of what worked at ten thousand hours did not hold up at a million.
https://www.dyna.co/research/dyna-2-infrastructure
「扛不住」具体指什么:数据导入原先每周只能处理1.4万采集小时,照这个速度,一百万小时要跑一年多;开训之前光是把这一轮要用的记录列成取数清单(training manifest),就要约48小时;清单列出来之后还要装进内存,这一步在 10 万小时的时候还不成问题,到百万小时就装不下了。这里没有一处是「慢了一点」,全部是「不成立了」。
这些失效不集中在某一处,而是散在整条链上。他们先给这条链划了四个阶段(four stages):采集、导入、编目、加载,讲的是数据从现场到GPU的那一路。
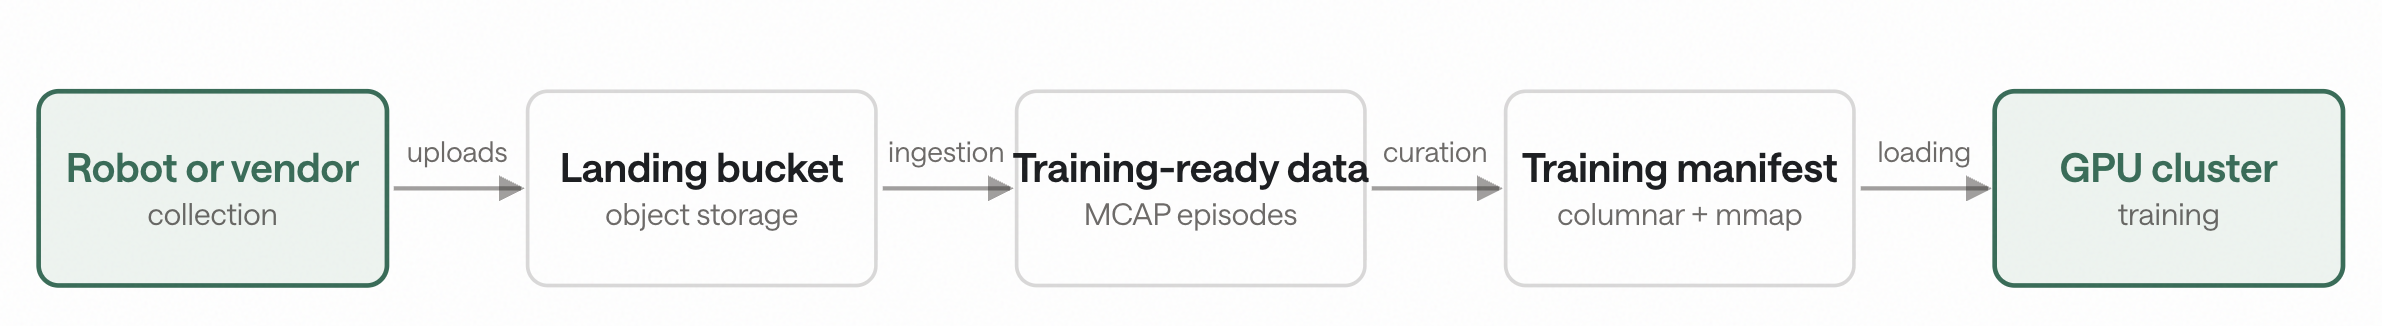
正文则讲得更细,分成六个模块(原文里各占一个section,2.1至2.6)逐个交代,在数据链路之外,另外纳入了训练和容错恢复。
机器人在现场执行任务,每完成一次落下一条作业记录。这条记录怎么离开机器,写在第三篇里:先落到本地盘上,再看网络状况异步传回来,确认上游那份没问题,才删掉本地的副本。从这条记录进来,到它被送进训练,中间要经过的就是下面这六个模块(括号里是它们在原文里各自的标题):
任务封装(episode container):把一次任务里的多路信号按统一格式装到一起、把画面压缩掉,这一步决定了这批数据往后好不好读。
数据导入(ingestion):把海量记录成批处理好再进中央存储,中间要把各路信号对到同一条时间轴上、过一遍质检、补上派生信息;它每周能处理多少,决定了「一百万小时」是几个月还是几周。
编目与挑选(curation):站点、任务、时长、成败、质量这类元数据(metadata)单独进一张表,开训之前按条件查一次,挑出这一轮要用的记录,列成取数清单。
分发(delivery):把数据送到计算节点上,并让每台机器把自己反复要读的那部分留在本地盘上,这就是缓存(cache)。
训练(training):优化器状态采用拓扑感知的混合分片,在单个节点内的多张 GPU 之间分片,在不同节点之间复制,从而把高频同步通信限制在节点内部。
容错与恢复(job resilience):坏机器在分配作业之前被挡住,作业中断后自动接着上一个 checkpoint 跑。
六个模块里,文章的重点放在数据侧:从数据进入系统,到最终送到GPU前,这条链路展开得更充分;训练与运行保障侧则各挑了一处最能说明问题的改造来讲,一处是优化器分片,另一处是容错恢复。
他们在文章最后一段做了总结:百万小时训练不是一个单点的规模问题,而是一次端到端的纵向系统重设计,每一个阶段要考虑的东西都不一样。
Million-hour training is not a single scaling problem. Instead, it is an end-to-end vertical system re-design with different considerations at each stage.
https://www.dyna.co/research/dyna-2-infrastructure
第二篇里还有一句话,分量比任何第三方的论断都重,因为它出自一家刚刚跑完百万小时训练的公司:过去一年里的大部分时间,限制他们能做多少实验的,不是想法不够,而是每个实验要等它的数据等多久;而光靠加机器解决不了这件事,加GPU不行,加 CPU也不行。
For most of the last year, the number of experiments we could run was limited not by a shortage of ideas, but by how long each experiment had to wait for its data. More compute would not have fixed that on its own, whether GPUs or additional CPU workers.
https://www.dyna.co/research/dyna-2-infrastructure
下次听到「训练慢了,再加一批 GPU」,值得先问一句:慢在哪个模块。如果慢在等数据,加GPU只是把等待摊到更多机器上,账单涨了,实验并不会更早出结果。
还有一件事和常识不同。一个团队的模型跑通、产品上线,并不意味着支撑它的AI Infra就此定型。Dyna-1在2025年已经跑通并进入客户现场。为什么产品上线之后还要重新设计AI Infra,第三篇给了一个具体的客户现场案例。
客户要求单台机器人在18小时班次内产出1500条可以直接上桌的餐巾。Dyna-1上线时,每小时完成约 35 条,其中约 75% 达到上桌标准,按一个班次计算,每天约有480条达标,距离客户要求还有很大差距。这条沟后来跨过去了:Dyna-2每小时完成 95 条,93%达到质量标准,一个班次约有1590条达标。
Dyna Robotics将这一进步归因于更强的预训练、新的模型能力、更强的工具,以及围绕它们建起来的系统,而不是针对现场问题的一次性工程。随着预训练数据扩大到百万小时,模型读取数据的方式也发生了变化,原先围绕 Dyna-1 调整的存储、分发和训练配置不再适用,AI Infra 因此需要重新设计。
这里要区分两件事:这次需要重做的,是上一代模型对应的具体配置;真正要留下的,则是一套能随着模型变化重新推导、重新落地的能力。
03.
机器坏了会告警,算力空转不会
机器多了、单次训练又要连跑数周,出故障就是常态,这一点并无争议:每多一台机器就多一个可能拖住所有人的地方,一旦出故障,丢的是上一个checkpoint之后的全部进度。Dyna Robotics把这件事单独写成了六个模块里的一个。
文章记录的几类关键故障不会被常规健康检查捕获。
第一类是报告健康的退化机器。所有常规检查全过,作业却一直在这台机器上失败。他们做集群预检时有一个细节很见功力:不看累计的错误计数,改看开机之后重置的计数器。理由是有些GPU的累计计数清不掉,用它来判断,会让一段陈年故障把一台完全健康的机器永久判为不可用。
另外两类反过来,坏的不是机器,是调度系统里那条记录。一类是节点被隔离之后没有人恢复:物理状态健康且空闲,记录上是已隔离,而已隔离被系统当作正常状态,所以不告警,机器一直空转。另一类是控制器中途重启,节点回来时是空闲的,却还挂着上一次作业的占用,什么都报健康,调度器就是不往上面派活。
机器是不是健康,和机器能不能被分配作业,得分开看。 前一类坏在健康上,后两类坏在调度记录上,只盯前一个,监控面板可以全绿,算力仍然在流失。
到了这个规模,健康检查、断点续训、自动恢复就不再是锦上添花的可靠性功能,它们本身也是有效算力(goodput)的组成部分。花在稳定性上的钱和花在买GPU上的钱,买的是同一样东西:能真正用于训练的卡时。
04.
换一代模型,同一套存储配置就从最优掉到不划算
4.1. 七个问题,没有一个是在报警的那一层解决的
把第二篇里的每一处修复,对上它当初的症状和真正的原因,排出来就是下面这张表。
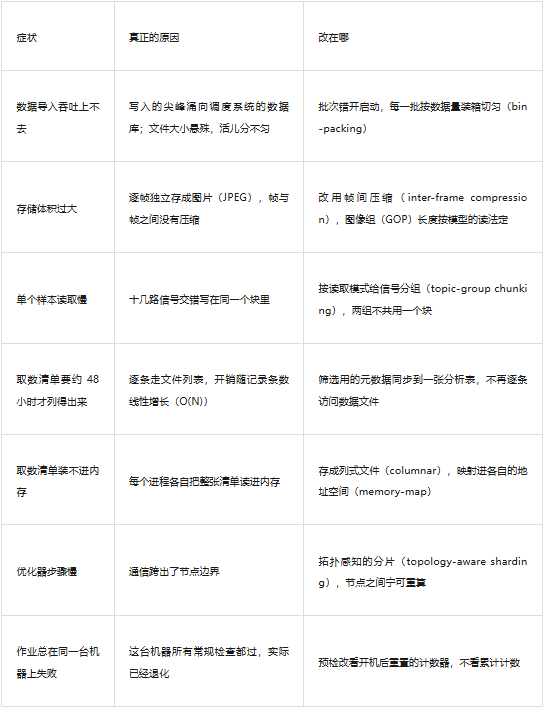
七行里没有一行的原因和症状落在同一层,也就没有一行是在报警的那一层解决的。
其中数据导入那一行,原文写得最完整,可以顺着看一遍。这个模块的吞吐长期卡在每周 1.4 万小时,最直觉的解法是加机器,而他们的结论是加了也不会线性提升:
throughput does not improve linearly by simply throwing more compute to the pool. There are two problems at scale. First, when millions of runs happen concurrently, the scheduler becomes the choke point, because bursts of writes flood the scheduler database and stall the whole process.
https://www.dyna.co/research/dyna-2-infrastructure
两个原因都不是数据处理算力不足。第一个是同时在跑的处理任务数以百万计,各批次的同一个步骤几乎在同一时刻完成,写入成片涌向调度系统的数据库,把调度器堵住了。第二个是数据文件大小相差悬殊,任务负载分配不均,一部分机器早早跑完,之后一直空闲。
两个解法也都不在算力上:把不同批次的启动时间错开,让相同的步骤不再同时结束,写入的尖峰就被抹平;再把每一批按数据量尽量均分,切成大小接近的块(bin-packing),交给数量合适的进程并行处理,让网络、磁盘、节点、存储和数据库都不越过各自的物理上限。这个模块的吞吐,最后是由任务的启动时刻和每一批切得匀不匀决定的,如果监控只覆盖任务状态和节点资源,这两个问题很容易被遗漏。
其他几行也是一样的道理:不知道模型每次读多长的画面,就想不到去动编码参数。这些问题横跨存储、调度、数据格式、分布式训练和硬件可靠性,难的不是专业本身,是把相邻两层的信息放到同一个人面前。
4.2. 模型怎么读数据,决定了底下每一层该怎么建
第二篇里最值得注意的一句话是:读取模式本身成为一个训练超参数,且因模态而异。
the read pattern itself becomes a training hyperparameter that differs across modalities.
https://www.dyna.co/research/dyna-2-infrastructure
它讲的不是数据配比,而是数据的读法。而这两代模型读得完全不一样:VLA每次取的是时间轴上很短的一小段,跳着取;世界动作模型(WAM)一次连续读很长的一段。
第一个例子是视频怎么存。 视频压缩的基本做法是隔一段存一张完整画面,中间那些帧只记录与前一帧的差别,两张完整画面之间的这一组帧叫一个图像组(GOP,group of pictures)。图像组拉得越长,体积就越小;代价是想取中间任意一帧,得先找到上一张完整画面,再把中间的差别一帧一帧叠回来。他们原先存的是逐帧独立的图片(JPEG),每一帧自己压过,帧与帧之间没有压缩;换成帧间压缩(inter-frame compression)之后体积立刻大幅下降,而在此之上,他们又把这个间隔调得比较大。
这一步之所以划算,直接来自世界动作模型(WAM)的读法:一张完整画面的代价,被它后面连续的许多帧摊掉了。而同一个设置换成 VLA 那种跳着取帧的读法就反过来了,每取一个样本都要多付一次解码代价:要哪一帧,前面都压着一长段必须先解开的画面。换一类模型,同一个编码选择立刻从最优掉到不划算。存储格式的对错,不写在存储这一层里,写在模型架构里。
第二个例子是数据怎么分块(chunking)。 一条作业记录里并排装着十几路信号:左右相机、腕上相机、各关节的角度和电流、控制指令、事件日志。默认的排法是按时间把所有信号交错着写下去,于是为了取其中几路,整段都得读进来。他们改成按读取模式分组(topic-group chunking):几路相机归一组,关节状态和控制指令归另一组,两组不放进同一个块。这样一来,同一组里再多接一路相机不会多出一次读取,而这一轮只用得上其中几路时,也只触碰对应那一组的块。
按读取模式分组,真正省下来的是计算节点本地盘上的缓存空间。这块盘上的缓存是按页存的,不是按整个文件存:一条作业记录里只有真正读到的那些页会留下来,淘汰的时候也是一页一页地丢,而不是把整个文件丢掉。一次采样触碰的块越少,需要驻留的页就越少,同样容量的本地盘因此能覆盖多得多的作业记录。原文写的是:
This is where the chunking work earlier pays off again: grouping topics so a sample touches few chunks means few pages go resident per sample.
https://www.dyna.co/research/dyna-2-infrastructure
分块方式选对了,本地缓存这一层的加速才成立;分块方式不对,同样大的缓存能覆盖的记录就少得多,加速也就大打折扣。
两个例子其实是一路推下来的:模型一次要预测多长的动作序列,这是模型设计;它决定状态序列要读多长、画面要解几帧;再决定存储该按多大粒度切块;再决定一次采样触达几个块;最后决定有多少数据片段能留在计算节点的本地盘上。这条链上任何一环变了,其余各环都要重新校准。所以这几层没办法分开评估,只能当成一件事来看。
4.3. 不存在与模型无关的最优 AI Infra
前面两个例子共同说明:不存在脱离具体训练负载(workload)的最优AI Infra。GOP长度、数据分块和缓存策略本身没有绝对的先进或落后;模型如何采样、一次读取多长的序列、会触达哪些数据块,才决定一套配置的实际效率。
这也重新定义了AI Infra的组织边界。传统意义上的基础设施通常集中在集群、调度、训练框架和通信系统,数据处理则由另一个团队负责。但在具身训练中,存储格式、分块粒度和缓存策略一端连接模型的读取模式,另一端连接数据的物理布局,很难由任何一侧单独决定。真正需要建立的,是模型团队与数据、存储和训练系统之间,共同描述和传递训练负载及数据访问特征的机制。
为什么具身尤其如此,第二篇里给了原因,而且把结论直接写成了一句话:结果就是,训练消耗数据的速度可以快到让数据加载本身成为瓶颈。
As a result, training can consume data quickly enough for the dataloader itself to become a bottleneck.
https://www.dyna.co/research/dyna-2-infrastructure
语言模型读的是文本,一个样本很小而模型很大,一份数据能摊到的计算量很高,喂数据一般不是训练时的第一瓶颈,卡住的地方更常在算力本身和上游的数据处理。具身把这两头倒了过来:一条作业记录是多路传感器同时录下的连续信号,一个训练样本要跨这些信号按同一时间轴对齐截出一段;而模型因为最终要装进机器里跑,反而必须做小。一份数据能摊到的计算量因此低得多,喂样本的时间预算就跟着紧。于是让 GPU 空等的往往不是算力不够,是数据送不上来。瓶颈换了位置,落在数据这一侧。
AI Infra必须围绕负载来设计,这一点在语言模型上同样成立,区别只在于瓶颈落在哪里。 语言模型的瓶颈长期落在算力这一侧,围着它积累起来的那套经验,主要覆盖的是算力怎么切分、通信怎么组织。
算力那一侧同样不轻松。多模态与具身模型自己怎么训,难点一样多:模型和优化器状态怎么在多台机器之间切开、机器之间的通信怎么组织、长的视频序列怎么放得下、算子怎么调,每一项都够单独写一篇。
Feeding the GPUs is one problem. What runs on them is another, and an optimization tuned at one scale does not necessarily survive the next. We made many changes on that side of the system, and rather than walk through all of them, here is the one that shows the pattern most clearly.
https://www.dyna.co/research/dyna-2-infrastructure
优化器分片这一处说明的是,在多机训练中,显存占用和通信开销必须放在一起权衡:随着模型和优化器状态增大,由每台机器完整保存一份状态的方式不再适合,但分片之后又会引入状态同步开销;Dyna Robotics的做法是在单个节点内的GPU之间分片、在不同节点之间复制优化器状态,从而把高频同步通信限制在节点内部。
推理那一侧的工作,他们在第一篇里写了一处。世界动作模型(WAM)本身就能把接下来会发生什么以视频的形式预测出来,这也是它与VLA的一处分别;有了这个能力,机器人可以先让模型生成多种候选动作轨迹再挑一种去做,也可以拿它来评判一个动作做得好不好。难处是这种视频原先要把网络反复跑很多遍才出得来一段,慢到无法用于这类环节。他们的解法是拿原来那个多步的模型当老师,训练出一个只跑一遍就出结果的学生模型(蒸馏,distillation),生成一段视频的耗时降到约九十分之一。代价他们也写明了:一步学生模型的生成保真度尚未达到多步教师模型。
对Dyna-2这类负载来说,最先暴露出来的瓶颈更多落在数据侧,恰恰是那套经验里最薄的一块:存储格式怎么定、数据怎么分块、本地盘上留什么,在语言模型上很少需要跟着模型架构重新推导一遍。同一套经验搬过来,最先接不住的就是这一段。
05.
实验规模不够的时候,跑不出来不等于走不通
第一篇里有一个容易被跳过的结果,而且它是他们自己在正文里下的判断:有几个任务看起来需要预训练量先达到某个阈值,才变得可解;其中最清楚的一例是开锁盒的钥匙转动。10万小时及以下的所有检查点,没有一个转动过钥匙;到100万小时,钥匙被成功转动的比例是 90%。
Several tasks appear to require a threshold amount of pre-training before they become solvable at all. Lockbox Key Turning is the clearest case: no checkpoint up to 100,000 hours turned the key. At one million hours, the key was successfully turned 90% of the time.
https://www.dyna.co/dyna-2
从这些检查点的结果看,提升并没有表现为平滑的线性过程。
把这个结果放到行业处境里看:一个只能在10万小时规模上做实验的团队,可能会得出「这个方法完不成这个任务」的结论,并因此放弃这个方向。而对确实存在这种阈值的任务,这个结论可能是错的,原因只是实验规模还没跨过门槛。
AI Infra决定的不只是算法跑得多快,还决定一个团队能不能判断它究竟行不行。 规模不够的时候,拿到的不是一个偏低的分数,是一个方向相反的判断。
但这件事的另一面,Dyna Robotics 在最后一段里自己说了出来:这套可复用的AI Infra能力建立起来之后,研究员可以在大出几个数量级的数据上完成导入、编目和实验,而不必每一次都把整条路径重建一遍,于是迭代周期被缩短,值得设计的实验,范围也跟着变宽。
researchers can now ingest, curate, and experiment with orders of magnitude larger data without rebuilding the path each time, which accelerates our iteration cycles and widens the range of experiments worth designing.
https://www.dyna.co/research/dyna-2-infrastructure
这句话里有两件事:迭代变快了,而且原先不值得提出的实验,现在值得提了。后一件才是重点:有些方向不是被实验否掉的,而是因为实验成本太高,根本没有真正跑起来。等这条路被打通,它们才第一次有机会接受验证。AI Infra能支撑多大规模,团队就能设计多大范围的实验。
06.
所以,AI Infra 应该成为一种什么能力
第二篇的结尾只有短短一段,说的是这一年下来真正留下的是什么:临时写的脚本能把这一次跑出来,下一次仍要重写一遍。
Ad-hoc scripts get one run out the door, then have to be written again for the next.
https://www.dyna.co/research/dyna-2-infrastructure
在AI Infra的数据这一侧,他们的选择是把这条管线建成一套能反复使用的东西,而不是每一次靠临时脚本应付过去。 做法是把整条管线拆成一步一步,每一步单独定义、单独申请自己需要的资源,步骤之间只声明谁要等谁跑完。好处很实际:管线里有的步骤很占资源,有的几乎不占,整条管线如果捆成一个整体来跑,每台机器都得按最占资源的那一步来配;拆开之后就不必了。在这个前提上,有三处安排值得单独看。
第一处,同一套处理步骤,三种跑法。现场每落下一条记录就立刻处理一次,要的是快;把数以百万计的存量记录重新处理一遍,要的是吞吐。这两件事在多数团队里是两套代码,一套跑实时、一套跑批量,改了一边,另一边必须记得跟着改。他们只留一套步骤,由一个运行模式(run profile)决定这一次哪些步骤开、哪些关:整条跑一遍是一种,只把元数据补一遍、不动数据本身是一种,只把标注重做一遍又是一种。
A run profile decides which of those steps actually run (full processing, a metadata-only backfill, a re-label pass), so neither a new trigger type nor a partial rerun needs a forked pipeline.
https://www.dyna.co/research/dyna-2-infrastructure
第二处,质量检查不写在处理代码里面,而是单独立成步骤,排在处理动作的前面和后面。差别落在要不要改代码上:检查逻辑如果嵌在处理代码里,想换一套检查就得动这段代码,动完还要重测一遍;单独立出来之后,这一批过哪几道检查,运行时在配置里选定就可以。原文把理由写得很直白:开始接外部供应商的数据之后,每一家的数据类型、格式和质量问题都不一样,处理需求一直在变。
第三处,每个步骤被分成关键与非关键两类:格式转换、数据校验、时间对齐属于关键路径,分段、特征抽取这类标注产物属于非关键。这条区分省的是重跑的代价:原先只要有一步失败,整次运行就被取消,前面已经跑完的部分跟着作废;改完之后,非关键的那一步失败不再牵连全局,每一步的状态都能单独看到,从失败的那一步接着往下跑,不必整批从头再来。
统一管线的多种运行模式、独立配置的质量检查,以及关键与非关键步骤的分级,这三处安排回答的是同一个问题:下一次处理要求发生变化时,需要调整的是配置,还是重写一段代码。
上面这三处解决的,都是处理要求发生变化时,怎样不用重写整条管线。还有一种变化,它们管不到:要求没变,但数据自己一直在长,这条管线会不会跟着越来越慢。取数清单的改造,针对的正是这一点。
这个问题在前面已经出现过:到了百万小时,开始训练之前光是生成取数清单,就要约 48 小时。原先每判断一条记录能不能进这轮训练,都要访问四次数据文件:先确认文件是否存在,再读取附属文件获取质量标记,打开文件头查看时间范围,最后再打开一次,统计其中包含多少个时间步。百万小时的语料有4300万条记录,每条都要这样检查四遍。
每次实验的筛选条件又不一样,取数清单因此必须每次重新生成。预训练只生成一次清单,这个成本还可以接受;但如果每个实验都重新检查4300万条记录,清单生成就会反过来拖慢实验迭代。改造之后,他们把这些用于筛选的元数据提前抽取出来,单独存成一张表。之后生成清单时直接查询这张表,不再逐条访问数据文件。
他们特意强调:这一处的变化不是同一件事做得快了几倍,而是这一步的开销不再跟着记录条数涨。查询直接在一张表上完成,不必把文件一个个走一遍;在已经过了5000万行的整张表上筛一次,几秒钟就返回结果。
What changed is not just the constant. The query plans over a table instead of walking a file list, so its cost no longer tracks the number of episodes the dataset holds, and a curation over the full table, now past 50 million rows, comes back in a few seconds.
https://www.dyna.co/research/dyna-2-infrastructure
这比任何一项加速都值钱。加速改的是这一次快多少,而这里改的是往后:数据继续增长时,这一步不会重新变成瓶颈。
这正好接上第二节末尾那句话。既然最优解由模型定,一套 AI Infra 会不会过时就不看硬件用了几年,而看模型换没换代:这一代调到最优的布局,换一代模型可能整体作废。所以真正要留下的不是上一代模型对应的那套具体配置,而是模型一变就能把配置重新推导一遍的能力。
第二篇的标题里放了「可重复地」这个词,指的就是这件事。他们在结尾处说,可复用的基础设施让每一次实验从上一次结束的地方开始,正是这一点使这个规模可以重复,而不是只成立一次。
Reusable infrastructure lets each experiment start where the last one finished, and that is what makes this scale repeatable rather than a one-off.
https://www.dyna.co/research/dyna-2-infrastructure
AI Infra在这里不是搭完就拆的脚手架,它和模型一样,是这一轮要留下来的东西。
这套能力可以压成三条标准,数据与算力两侧都适用。第一,能复用:换一种跑法、补一次元数据、重做一遍标注,可以通过配置组合既有步骤,不必为每种情况另建一条管线。第二,负载感知(workload-aware):存储格式、分块粒度、缓存策略跟着这一代模型的读法走。第三,扛得住数据长大:换一代模型该重调的是配置,而语料大出几个数量级,这条路径不该跟着重建。
07.
下一次预算评审,问题该换成什么
以前问:今年要买多少张 GPU。以后至少要多问一句:这些 GPU 能转化成多少有效算力。
以前问:训练平台稳不稳定。以后要问:一个模型从数据准备完成到有效训练开始,实际需要多久。
以前问:AI Infra团队有多少人。以后要问:模型规模再翻十倍的时候,这套AI Infra是跟着项目重做一遍,还是能直接接上。
还有几个更具体的,适合放在评审现场直接问一遍。
上一次实验,是从上一次结束的地方开始的,还是把数据准备重新跑了一遍。
最近一次「训练变慢了」,最后是在哪一层修好的。 如果每次都修在报警的那一层,多半还没有碰到真正的问题。
我们当前的实验规模,够不够让一个负面结论成立。 上一次判定某个方向走不通的时候,用的是多少数据。
一个训练作业占用的卡时,最后有多少变成了有效算力,这个数字有没有人负责。
模型侧改了动作序列长度或者采样方式,存储和缓存这一侧知不知道。 这两件事现在是不是由两个团队分别决定的。
上一个现场问题解决之后,留下的是一个补丁,还是一件下一次能直接用的东西。
这套AI Infra,接得住下一批新任务、新部署吗。 第三篇的最后一节讲的就是这件事:部署得越多,真实场景里的数据越多,而这些数据能不能被AI Infra收上来、标出来、喂回模型,决定了下一代模型拿什么去训。转得起来是复利,转不起来就是每个新场景都从头再来一遍。
这几个问题有一个共同点:没有一个能用「我们再多买一些 GPU」来回答。
08.
结语
Dyna-2 留下的核心启示,不是百万小时训练需要一套更大的基础设施,而是随着模型和数据规模变化,系统瓶颈会不断迁移。模型的读取模式约束着数据如何编码、分块和缓存;数据管线与容错能力决定采购的 GPU 有多少真正转化为有效训练;基础设施能否支撑更大规模的实验,又影响团队是否有足够证据判断一个研究方向。
因此,AI Infra 的衡量口径需要从资源和运维指标转向研发产出:不只看集群可用率、作业成功率和峰值吞吐,还要看数据准备周期、端到端 goodput、故障恢复成本,以及模型和数据规模变化后,整条训练路径能否继续复用。AI Infra 最终交付的不是一套稳定运行的集群,而是把算力、数据和算法持续转化为有效实验的能力。
Dyna Robotics 在第二篇文章最后把这一点概括得很直接:
As the data grows, the bottleneck keeps moving: first the storage format, then the ingestion pipeline, then the training manifest. The work is finding the current bottleneck, not simply adding machines behind it.
https://www.dyna.co/research/dyna-2-infrastructure
真正重要的,不是让某一层的指标看起来足够漂亮,而是持续找到此刻限制有效训练的那个环节。这也是我们在百度百舸一直在处理的问题。
推荐阅读

×
右键可直接复制图片