 阅读时间大约10分钟以上(5525字)
2026-09-18 大模型数据的百亿“兴衰史”,具身数据的未来路
来源:豆包
大模型数据的现状,具身数据可能的未来。
具身行业缺数据已经是一个老生常谈的话题,也让行业诞生出了许多数据玩家。
与此同时,LLM数据市场规模已经达到了百亿美金。具身的数据行业未来会怎么走,或许有了他山之石。
本文主要梳理:
- 在大模型叙事背后的,大语言模型数据厂商“兴衰史”
- 具身数据的竞争格局是否会按照大语言模型数据行业发展和变化?
- 具身数据又有什么不一样数据这门生意,我们到底应该怎么理解
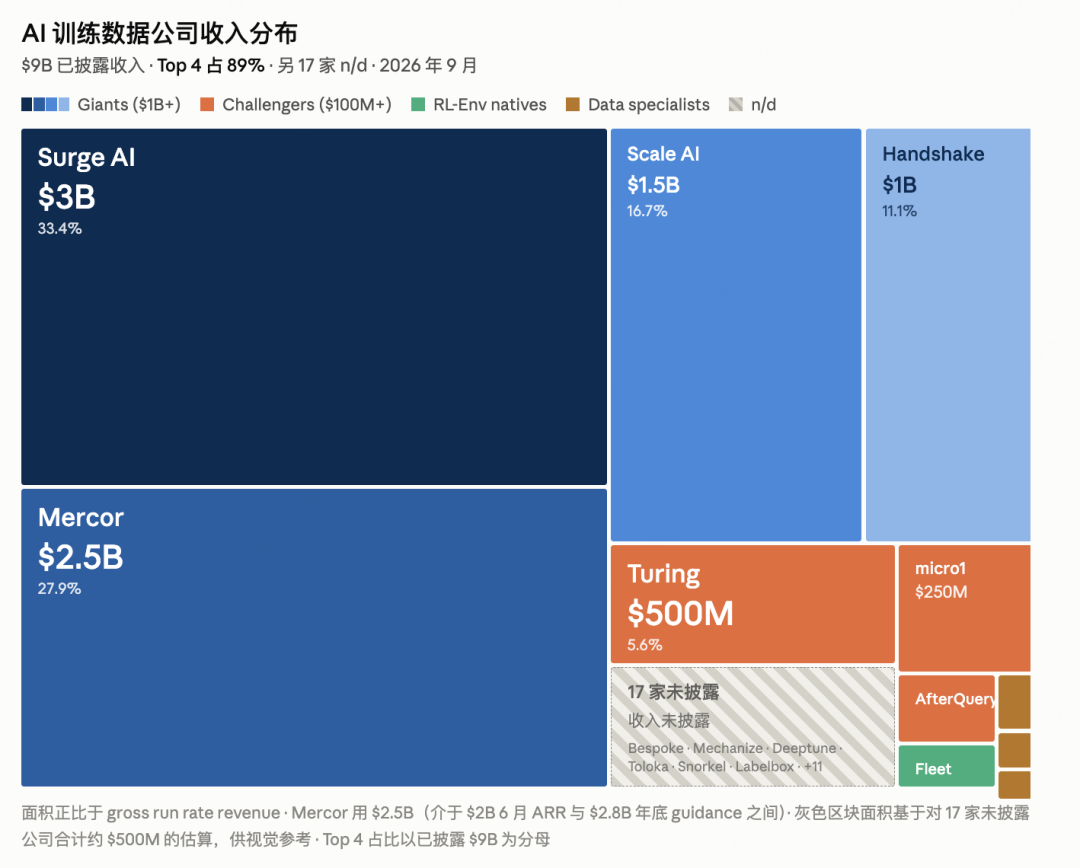
根据Menlo Ventures在26年7月的数据统计,2025 年以来涌入这个赛道的创业公司超过 50 家,当前LLM行业三方数据公司的整体市场规模已经达到百亿美金。
这个市场有一个很高的集中度。Top 4合计占据了约 75% 的市场份额,分别是Surge AI($30亿)、Mercor($25亿)、Scale AI($15亿)、Handshake($10亿)。
2025 年以来,头部数据公司的增速普遍在 100% 到 300% 之间。Surge AI 2024 年营收 $12 亿、2025 年 ARR$14 亿,26年最新营收数据是 $30 亿,Mercor 9 个月内收入从 $5 亿涨到 $20 亿,Handshake 一年内从月收入 $1000 万涨到年化 $11 亿,
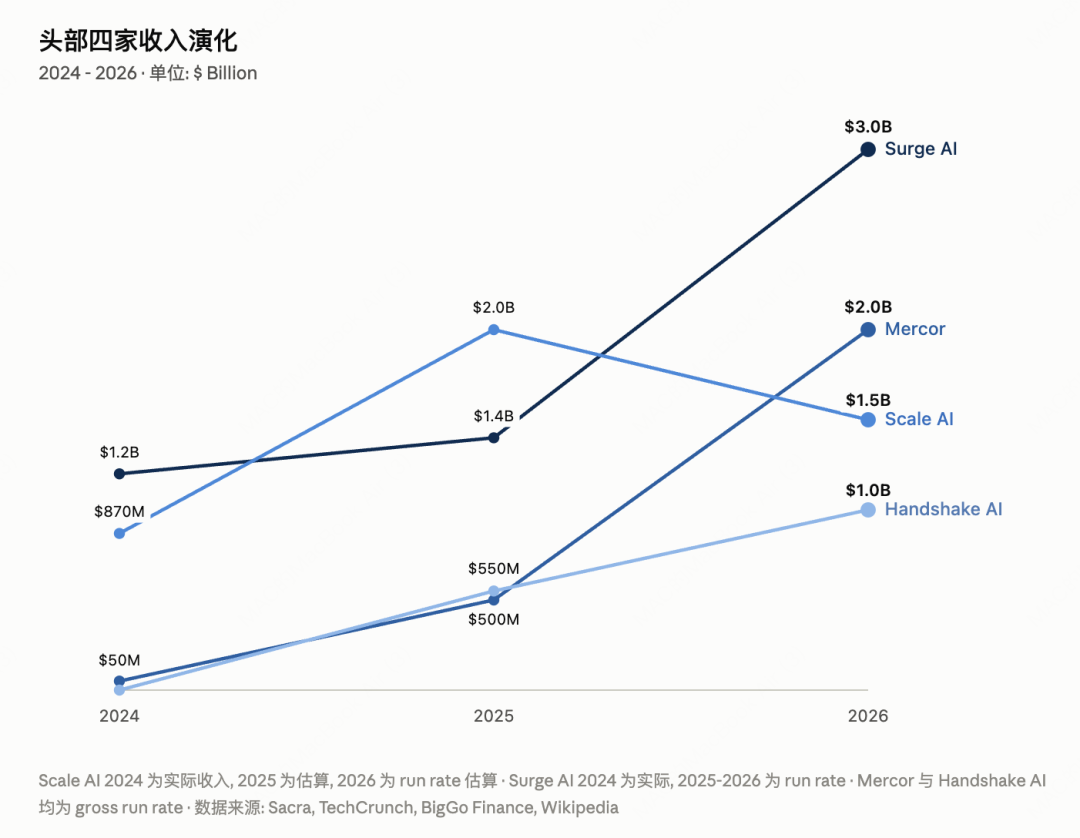
这四家里,只有 Scale AI 是“上一代”就存在的玩家。Surge 成立于 2020 年,Mercor 2023 年才成立,Handshake 的 AI 数据业务 2025 年才开始。
一代版本一代神。
每次算法能力的大跃迁,都会带来一代数据公司的机会
Pre-LLM,通用标注时代(2016-2022)
“Garbage in, garbage out”是机器学习行业的第一常识,模型质量的上限由数据质量决定。
随着 2015 年后深度学习在图像识别、语音、NLP等领域全面爆发,第三方数据标注市场也进入了持续上升期,2018 年市场规模约 $1.5 亿,到 2023 年突破 $10 亿,五年增长 6 倍以上。
这一代有两种需求,一类是互联网大厂的消费级 AI 需求,另一类是自动驾驶公司的感知系统训练需求。不同采购特征的两类买家,催生出了两种性质不同的头部公司。
互联网大厂是这一代最大、最稳定的一类买家。Google、Microsoft、Meta、Amazon、Apple 持续采购搜索、广告、信息流的内容打标与安审,以及语音识别、NLP 模型的训练数据。这类需求单价低、订单量大、需求稳定,本质上需要的是一个可稳定调度、覆盖多语言多文化背景的百万级外包人员网络。
这个需求形态对应的公司是 Appen。Appen 1996 年成立于澳大利亚悉尼,靠为 Nortel、AT&T、微软、诺基亚提供语音数据采集起家,2000 年代中期就建成了跨国众包 contractor 网络,在深度学习爆发之前,已经积累了二十年的规模化外包经验,21年峰值收入6.16亿美金。同期与 Appen 体量类似的还有 Lionbridge AI,年化收入约 $2.33 亿美元,最大单一客户是 Google。
自动驾驶是时代叙事最鲜明、增长最快的一类买家。Waymo、Cruise、Lyft Level 5、Aurora、Zoox 这批自动驾驶公司需要采购感知系统的训练数据,包括2D/3D 图像标注、LiDAR 点云、多传感器融合、场景切片等。这类需求单个项目金额大、增速快,跟随自动驾驶产业周期波动剧烈。
这类需求下跑出了 Scale AI。它成立于 2016 年,靠自动驾驶感知标注单点切入,2019 年估值达到$10亿,成为独角兽公司,2021 年 Q4 达到 $1 亿 ARR、估值升至 $73 亿。
Scale AI 之所以能在 Appen 二十年的规模化优势下长成独角兽,是因为它把感知标注从“纯人力外包”升级为“ML pre-labeling + 人工 QA + 平台化交付”的组合流程。这套流程把交付速度从周压缩到小时,也能维持50%+以上的毛利率,是传统 BPO 玩家难以企及的。
Scale AI 靠自动驾驶起家,也意味着它绑定了自动驾驶的产业周期。2021 年是全球自动驾驶融资的历史峰值,此后连续两年腰斩,到 2023 年跌到 6 年最低点。Argo AI 2022 年 10 月宣布关闭,Cruise 2023 年 10 月因旧金山行人事故失去运营许可、事实性停摆,Scale 的最大客户群同步进入收缩期。
这个时点,Scale AI 开始把公司重心切向政府/国防。2022 年 1 月 Scale AI 拿下 DoD Joint AI Center 的 $2.49 亿 ceiling BPA,为它 2022-2023 年扛过自动驾驶退潮期提供了关键现金流。这条政府线后来持续放大,2025 年扩到 $1 亿,2026 年再扩到 $5 亿,也为 Scale AI 后来第二次转身切向 LLM留出了时间。
除了大厂和自动驾驶两条主线,这一代还有一批规模较小的垂直行业需求,比如医疗影像、金融文档抽取、农业 AI、卫星与地理空间、工业质检、零售无人结账等。这类买家极度分散、单笔金额小、垂直 know-how 深,对应的垂直数据公司往往“小而美”,没有跑出头部。
ChatGPT 引爆的 RLHF 时代(2022-2024)
2022 年 11 月 ChatGPT 发布,数据行业迎来了分水岭。上游格局发生了两个关键变化。
第一个变化是,买家数量急剧收敛,上游需求方从分散的企业客户,坍缩到了十几家高度集中的前沿 AI 实验室。
第二个变化是数据质量的快速提升。Pre-LLM 时代对标注员要求不高,时薪也低,评估的是搜索结果打标这类简单任务。RLHF 时代的标注员需要更高的学历背景,单次任务需要通读几百字的模型输出、评估多个维度。
Invisible Technologies 披露, RLHF 数据厂商的计费模式是,向 AI 实验室收 $30-45/小时,付给标注员$15-20/小时,客户单价是 Pre-LLM 时代的 3-5 倍,标注员时薪是2-3 倍。
Surge AI 是这一代最漂亮的公司叙事。创始人 Edwin Chen 是 MIT 2008 届数学、计算机与语言学三专业毕业生,先后在 Google、Twitter、Dropbox、Facebook 与 Peter Thiel 的 Clarium Capital 对冲基金做过机器学习工程师与数据科学家。
2020 年,Edwin Chen 创立了 Surge AI,从第一天起就为 LLM 的 RLHF 需求设计,核心全职团队维持在 110-130 人这个量级,维护 5 万到 10 万人规模的专家标注员池。
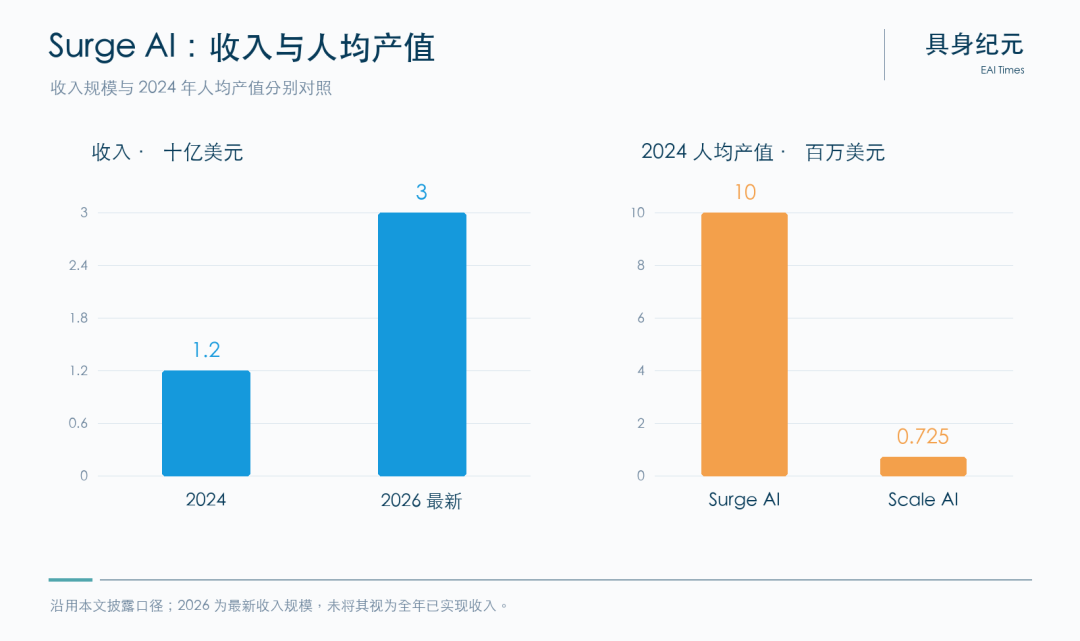
Surge AI 的收入曲线在 pre-LLM 时代任何一家老玩家都无法想象,2020成立,2024 年收入达到 $12 亿,24年人均产值 $1000 万美元量级,约为 Scale AI($72.5 万/人)的 13.7 倍。26年最新披露收入达到 $30亿量级。
Surge 早早绑定了Anthropic。Anthropic 2022 年 4 月发表的奠基性论文《Training a Helpful and Harmless Assistant with RLHF》,使用的偏好数据就出自 Surge。这个时点比 ChatGPT 时刻还早了 7 个月。
等到 2023 年 OpenAI、Google、Microsoft、Meta 陆续开始寻找专家级 RLHF 数据的供应商时,Surge 已经在 Anthropic 身上打磨了两年多的 rater 池、质控体系和产品流程。
Scale AI 是少数完成跨代迁移的老玩家。它的转身发生在 2022 年下半年到 2023 年上半年这个窗口,AV 融资退潮击穿了 Scale 的核心收入盘,Alexandr Wang 在 2023 年决定放弃继续加码自动驾驶,把公司重心整体切向 LLM 后训练。Scale AI 裁员20%,FDE 团队从服务自动驾驶客户现场调去服务 LLM实验室。23 年 8 月,OpenAI 官宣其为 GPT-3.5 微调的“preferred partner”,成功拿到大结果。
Scale AI 的收入曲线在这一转身之后出现了历史性跳升,从2022 年 $2.9 亿到2024 年 $8.7 亿。
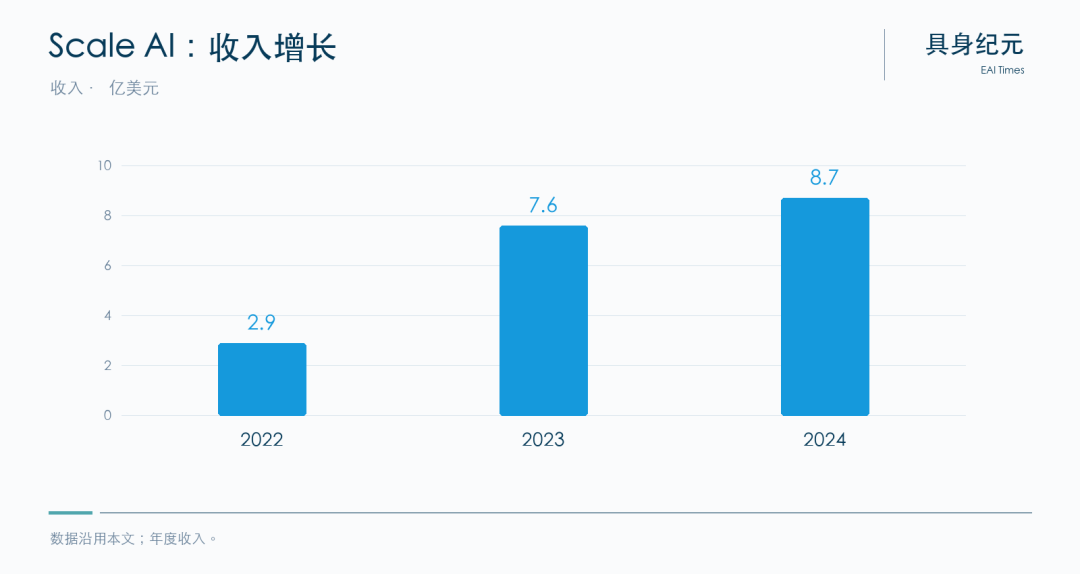
据行业媒体估算,Scale AI 2023 年的 $7.6 亿收入里,来自 LLM 实验室的收入已经超过了自动驾驶业务收入的历史峰值。2024 年 Meta 从资本角度介入之前,Scale 把自己定位为“AI 领域的瑞士”,同时服务 OpenAI、Google、Microsoft、Meta、Amazon 五大 LLM 阵营,保持中立性以最大化客户覆盖。
并不是所有老玩家都能完成跨代迁移的。
上一代的数据龙头 Appen 做了数据标注30年的公司,峰值时期几乎垄断了英语世界大厂对 AI 数据的采购,2020 年 Appen 收入是 Scale AI 的 6 倍,2021 年是 2.5 倍。三年之后,Appen 收入从 $6.15 亿澳元跌到 $2.49 亿澳元,市值蒸发 99%。
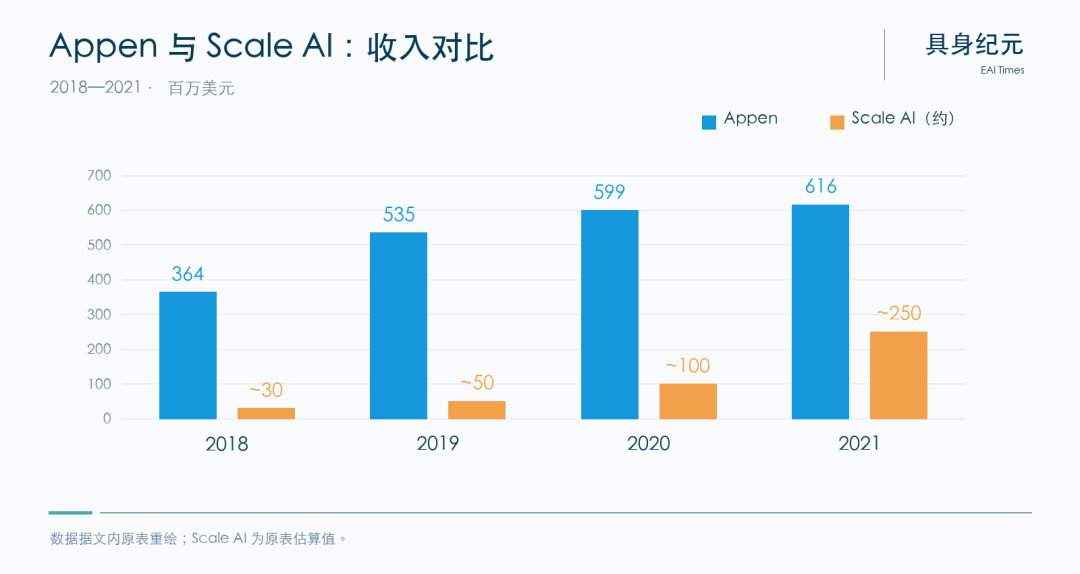
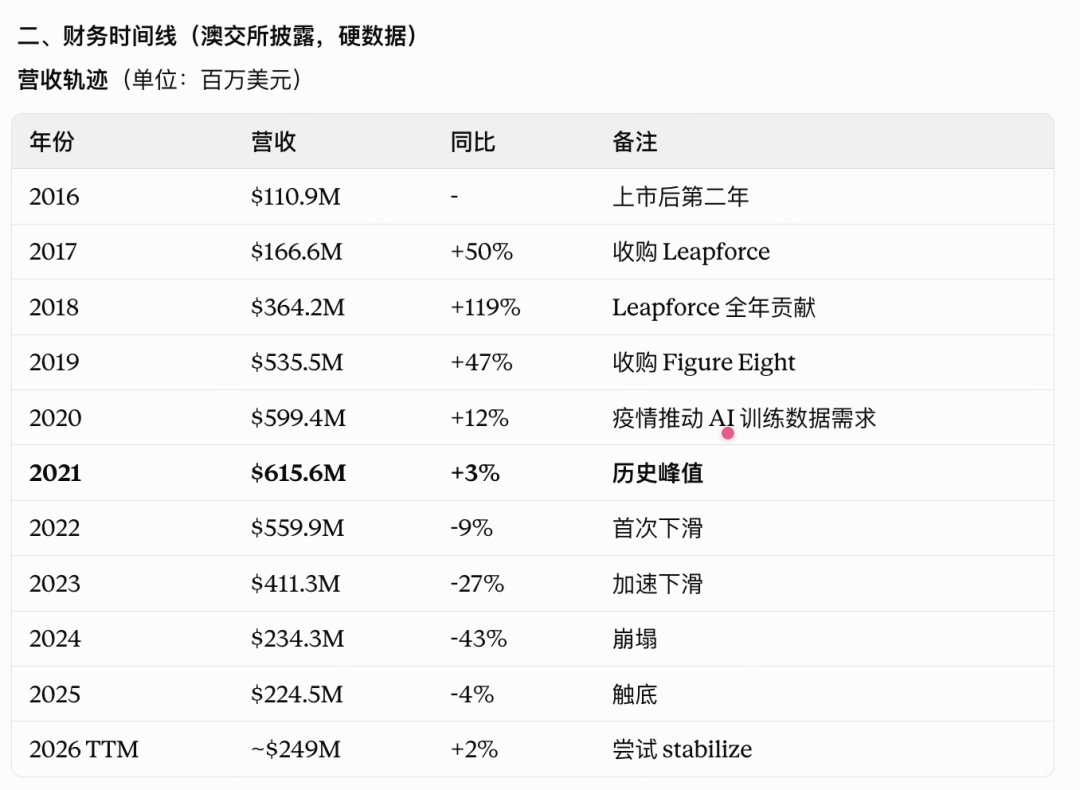
Appen与Scale AI 对比
Appen 也努力过转型 LLM 数据产品线,但结果不佳,老客户 Google 把 RLHF 和高端评估工作全部给了 Scale AI 和 Surge,反而在 2024 年 1 月为了节省成本,砍了 Appen 原本承接的 Search Quality Rater 需求,规模 $8280 万美元,占 Appen 当年总收入的 26%。
Appen 转型失败的直接原因是组织能力错位。contractor极其低的时薪水平(低于Google要求的$15/h 因此被点名要求涨薪了),原有数据业务的组织方式本身不适合管理RLHF类contractor,徒增转型负担。
o1 引爆的推理与 Agent 时代(2024-2026)
2024 年 9 月 OpenAI 发布 o1,标志着“推理时代”的开始。
o1 的核心突破在于,验证了通过RL训练模型的推理能力也可以大幅提升模型智能水平。因此,不同于RLHF时代相对简单的偏好对齐,RL需要真正的专家(数学家、律师、医生、程序员)写出的高质量推理演示,以及可复现的 RL 环境让模型练习复杂任务。这一波催生出了两类公司。
第一类是Mercor 和 Handshake AI。这两家都不是传统 AI 数据出身,之前都是做人才市场的。
Mercor 2023 年成立,最初做的是针对高端知识工作者的 AI 招聘和面试平台。2024 年 AI lab 对专家数据的需求爆发后,Mercor 开始把 marketplace 的匹配能力转向“给 lab 对接律师、医生、数学奥赛得主写训练数据”。
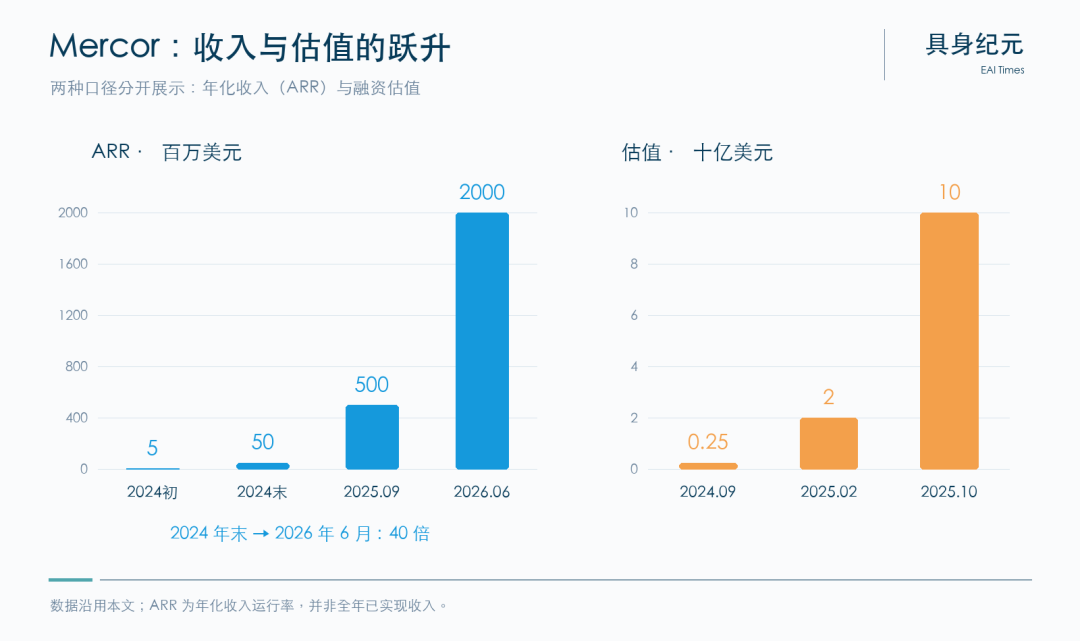
从2024年ARR 约 $500 万,到2026 年 6 月 $20 亿,18 个月增长 40 倍。
估值同步跳升。2024 年 9 月 Series A $7500 万,估值 $2.5 亿,2025 年 10 月 Series C $3.5 亿估值 $100 亿。创始人成为历史上最年轻的亿万富翁。
另一条线是 RL 环境。
RL 环境本质上是一个可交互的模拟系统,定义了:agent 能看到什么(state)、agent 能做什么(可用的 actions)、做完之后如何评估(reward)。agent 在这个环境里反复尝试,通过大量试错自主学习出策略。
到了 o1/Agent 时代,模型需要学会在复杂多步任务里做出正确决策。硅谷老牌VC Mayfield 在 2026 年的观点是,AI 行业的护城河正在从模型转移到环境上,高质量的 RL 环境未来可能会像预训练时代的高质量数据集一样值钱。
一个可训练的 RL 环境需要三层能力的深度协作:软件工程师把企业软件、开发环境等真实系统高保真复刻出来,领域专家定义什么是“正确行为”和“错误行为”,评估工程师设计出可自动执行的奖励函数。
过去一年内,硅谷做 RL 环境的小而精的初创公司层出不穷,例如Mechanize,2025 年由前 Epoch AI 研究者创立,为前沿实验室构建可验证 RL 环境,覆盖代码、数学、复杂推理任务。Fleet AI,高保真度复刻CRM、ERP、Spreadsheet等企业软件。
RLHF 时代的头部玩家也在积极补 RL 环境这一课。Surge AI 2026 年 2 月发布了 EnterpriseBench,一整套 agentic RL 环境的benchmark。
其中CoreCraft 是首个环境,agent 需要扮演客服,在一家虚构的高增长电商初创公司里处理真实业务问题,环境包含 14 类实体、2500+ 个对象、23 个专属工具。在这个环境里,GPT-5.2、Claude Opus 4.6、Gemini 3.1 Pro 这些前沿模型都只能完成不到 35% 的任务。
Scale AI 也在2026 年 2 月正式推出 Scale RL Environments,一整套覆盖 tool use、computer use、coding 的模拟世界集合,跨消费级、企业级、领域专项等多种应用场景。
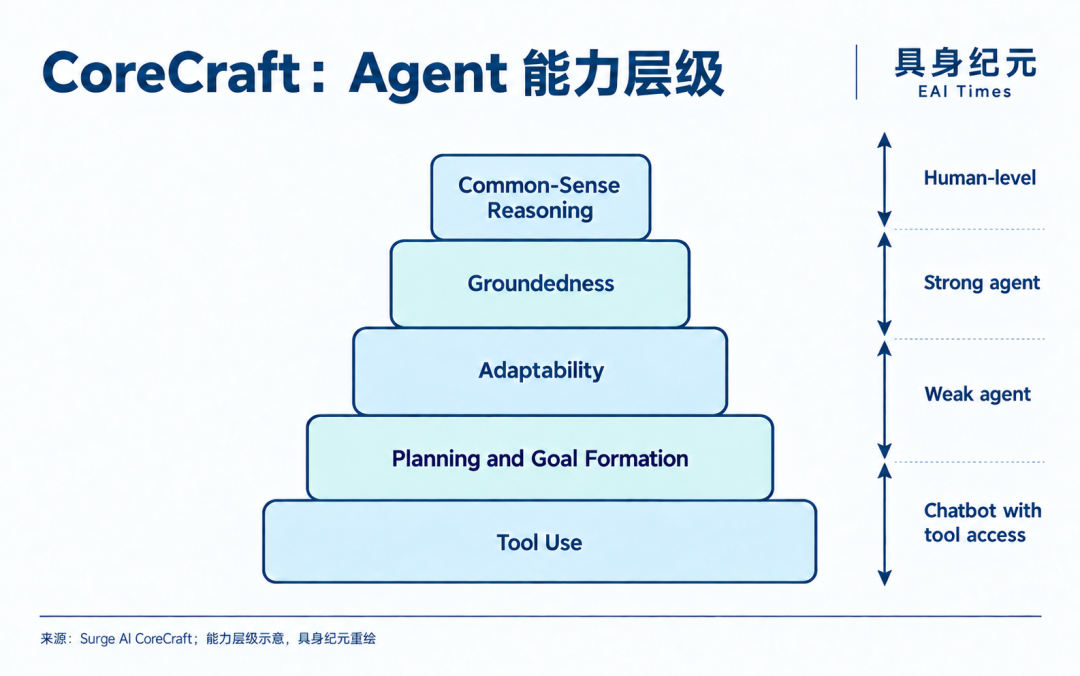
CoreCraft 以及能力层级。来源:Surge AI,surgehq.ai/benchmarks/enterprisebench-corecraft
他山之石,具身的相似之处
对于具身来说,大模型已经给到了一个可能的用来判断方向的依据。
分阶段来说,具身还处于预训练阶段,但给第三方的机会更多了
相比于大模型来说,具身还处于预训练阶段,整体参数量在大语言模型面前就是小虾米,决定数采玩家的是大家对预训练数据recipe的押注。
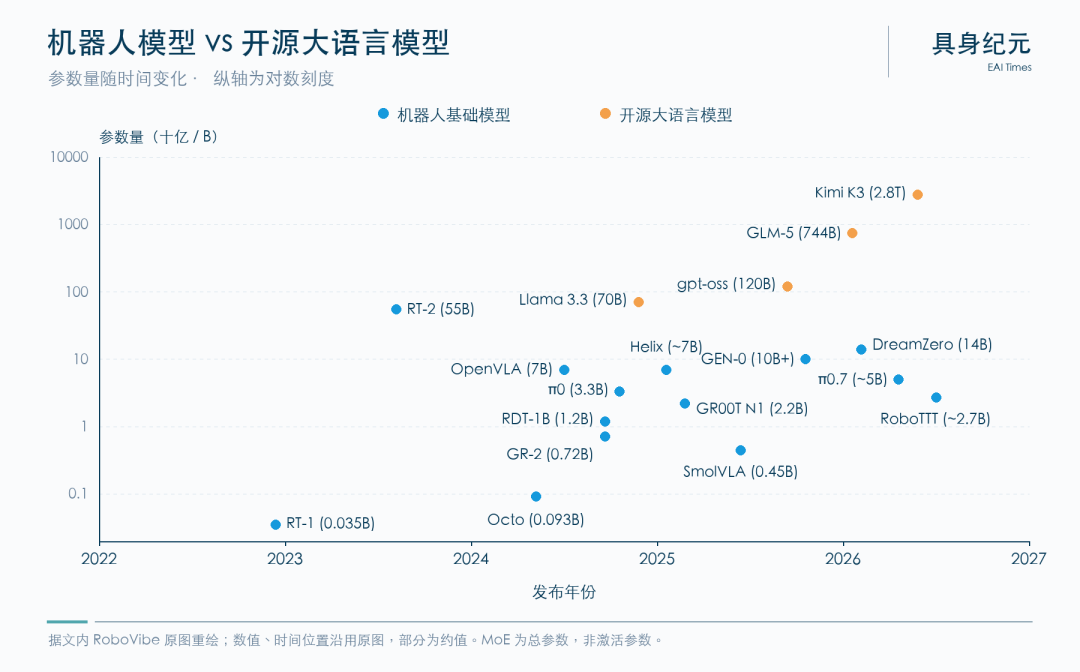
来源SeminAlysis
比如由aloha,PI带出来的真机数据采集,带出了Xdof公司的发展,以及国内的数采商业模式。
25年开始的UMI和Ego分布式采集,让更大范围的人力、设备和采集的运营,也涌现了mecka,Maxinsights,觅蜂,光轮(切入人类数据)这类玩家。
但相比LLM的公开网页爬取,物理世界的数据采集需要从硬件到人员、场地的运营等工作,与模型厂商的组织模式不同,因此会分出来单独的产业,来承接需求,具身的预训练阶段会出现能做到一定规模的数据公司。
随着模型发展阶段,具身数据还会出现新的玩家,且依旧存在投资机会
就如前文所提到的Fleet、Deeptune交付高质量的 RL 环境供后训练的环境,因而取得了细分领域头部的位置。
对于具身的后训练来说,LLM Agent 的 RL environment 可以复制 Salesforce、Excel 或浏览器,因为这些数字系统的状态转移规则基本是确定的;但物理世界不是这样,这样的一个后训练环境,不但要复刻当下的世界,还要复刻世界的变化,包含流体、柔性一些复杂的物理仿真,以及操作后物理世界的后果,保持环境的一致性。甚至要能够在物理世界进行遥操作接管,所以我们看到了MirroS, Current Robotics, ScienX等玩家。
对比估值,具身数据公司还有新的可能性。
对比已经出现百亿美元级公司的 LLM 数据市场,具身数据公司的估值还有明显的量级差距。以头部xdof,mecka的估值在十几亿美金、几亿美金为例,具身数据还有更多的增长空间。
随着预训练的数据需求扩大、后训练逐渐起步,能够持续交付高质量数据或训练环境的公司,仍有机会长大。
由于上游模型厂商的收敛,抱紧大厂的大模型数据厂商的格局也形成寡头垄断。算力和金钱也可能会让具身模型收敛,具身数据厂商也很有可能形成寡头垄断,而非一盘散沙。
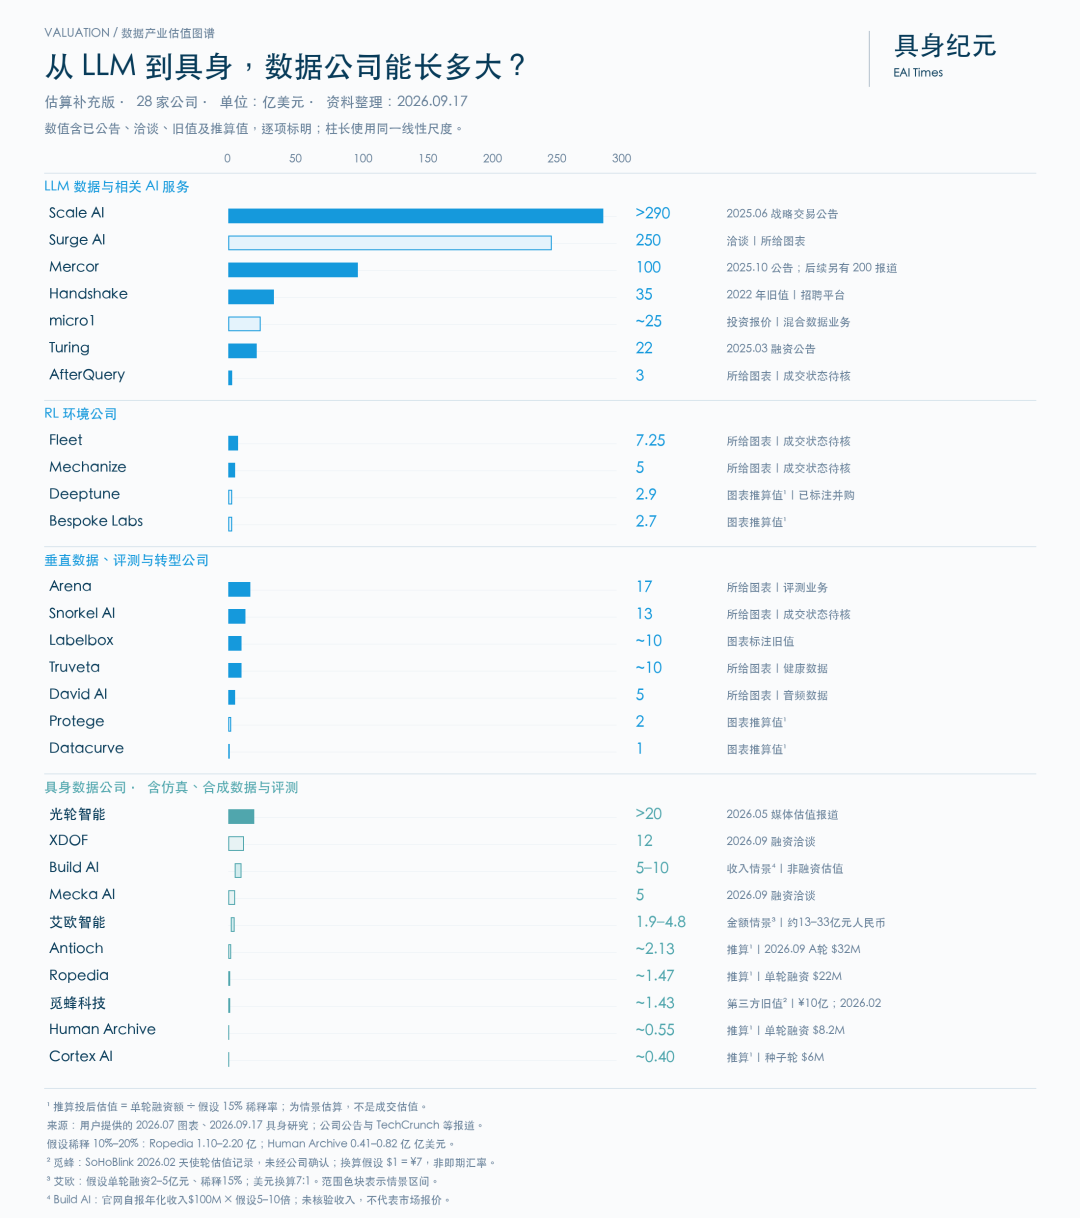
具身和大语言模型的不同之处
但我们依旧觉得,不能用大语言模型数据的发展去反推具身模型就是一个顺理成章的逻辑。具身数据发展我们觉得有以下不同。
推断一:具身的数据玩家的国内国外几乎处于同一起跑线
大语言模型层,海外和国内存在着一定的时间差,但由于具身数据其实是全球化人力运营以及以来真实的采集硬件,我们看到很多国内公司以及玩家很早就参与进了数据的分工。
推断二:具身的后训练环境有可能更早起步
如果我们看大模型从预训练到后训练的发展的时间,具身的后训练环境会更早出现。
即便通用预训练还没有完成,模型一旦进入评测,就会面临场地、真机以及安全约束的限制。需要一个虚拟但是能客观衡量模型效果的场域,来提升评测的效率。但目前的仿真器确实还不够好,所以有更多的迭代空间和
因此,具身的强化学习环境不仅是评测工具,也可能在具身产业更早期就成为后训练的主要场域。
推断三:具身后训练的玩家划分逻辑可能与大语言模型不同,大语言模型是纵深,具身需要的是场景闭环。
除了仿真环境之外,大模型存在垂类的专家数据提供商,例如金融、法律。垂类领域的人类专家称为大模型蒸馏的来源。
具身智能的划分逻辑可能不同。
许多物理任务并不需要从业者接受数年的专业教育,一名产线工人可能经过数周培训即可完成基本操作。但这并不意味着任务本身缺少专业知识。它的知识往往没有被写进教材,而是隐含在身体经验、工具、工位、材料、生产节拍和异常处理流程中。
因此,具身领域真正稀缺的能力,可能不是找到某一类“专家”,而是理解一个场景,并将其转化为可训练的环境。
那么具身的专业知识在哪里呢?它们更可能按照工位、物理过程、机器人本体和部署场景分化。未来重要的玩家,交付的也不只是一批遥操作数据,而是:一套高效围绕特定场景构建、能够训练模型、验证能力,并通过真实数据持续校准的强化学习环境。
推断四:具身数据公司的禀赋是软硬协同的系统性工程
具身数据最重要的是捕获真实的物理直觉和操作常识,这涉及到从采集设备的硬件搭建,分发,场景洽谈,数据管线的搭建。对于UMI这类采集端与部署末端同构的数据品类来说,对硬件设计的考验不仅仅是能采出来高质量稳定的数据,而且要闭环到模型的训练和部署。
大家都在说大模型会吞噬一切的时候,一个容易被忽视的事实是:模型可以压缩算法栈,却不会自动消除物理世界进入计算系统的接口成本。
写到这里,我们想聊聊数据行业的本质是什么
数据行业本质上是跟算法强耦合的。
每一次算法能力的代际跃迁,催生出新的数据需求和下游新的数采方式。是否出现新的大的科技公司,决定上游的客户关系是否可以积累。
当下游的数采方式和上游的客户格局同时发生剧烈变化的时候,行业就会产生能孵化出新的龙头公司的系统性的大机会,抓住了这波机会的人就会拿到大结果。
纵向看数据行业过去的发展,winner 总会呈现出一些共性画像:
抱大腿是重要的,Scale AI 抱紧了 OpenAI,Surge AI 早早绑定了 Anthropic,跟上游算法的密切交流,有助于数据厂商更了解技术路线。更早布局,押对了头部厂商,也会,同时,在数据质量相对后验的特点下,客户关系的维系也是决定订单规模的重要
高质量地扩大规模非常重要。在上游需求爆发式增长的时候,是否在尽可能快速的时间内用高质量且规模足够的数据去供给,也决定了是否能抢占市场先机。
但也非常客观理性地讨论:Business 和 Startup 是不一样的。
这其实是在硅谷话语体系里讨论过十几年的基础问题。Steve Blank 2010 年提出,Startup 是search,是探索,是寻找还没被验证的商业模式,Business 是 execute,是执行,是识别稳定的需求缺口,赚可预测的现金流。
数据行业本质上还是一个针对头部客户,提供人力服务的服务型business
好事是,上游是快速增长且需求集中的来自frontier lab的需求,下游不同的数据厂商依赖自己的不同禀赋,构造并交付不同垂类的数据。上游模型厂商的收敛带来了下游数据供应商行业开始收敛到3-4家寡头的趋势。
但一个“不太好的”判断是,上游需求不断变化也始终让那些具备对应领域数据生产能力的玩家,始终有进入行业的机会。
数据行业会有“台积电时刻”吗?自Scale AI 以降,数据厂商总以台积电自比,但从 Business 进化成 Startup ,产能需要有能够非线性扩张的路径,真正的技术杠杆在哪里,还需要观察。
推荐阅读

×
右键可直接复制图片