 阅读时间大约10分钟(3697字)
6小时前 北京首家训练中心停运背后:具身智能数采告别“拼小时数”时代
来源:豆包
作者:毛不毛 出品:具身智能前沿北京首家训练中心停运:具身数采的标志性转身近日,成立刚满一年、位于北京石景山区的首家人形机器人...
作者:毛不毛 出品:具身智能前沿
北京首家训练中心停运:具身数采的标志性转身
近日,成立刚满一年、位于北京石景山区的首家人形机器人数据训练中心调整停运。
一年前启动仪式上,各方曾对这座“数据工厂”寄予厚望:标准化布景、批量部署人形机器人遥操工位、通过人工采集清洗打造可交易的数据资产。然而仅仅运行一年便悄然退场,在具身智能领域引发了不小的震动。
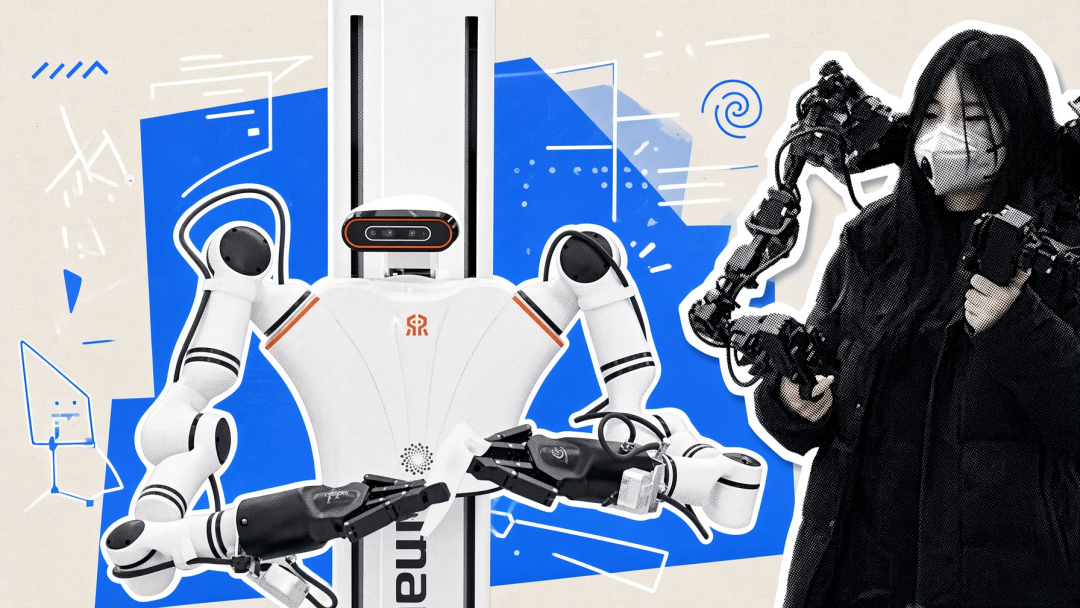
图片说明:北京石景山区首家人形机器人数据训练中心现场标牌 图片来源:智能纪元 AGI 报道
这并非孤立个案。根据调研机构 Interact Analysis 统计,截至 2026 年 4 月底,国内已有超过 90 个人形机器人数据采集和训练中心处于在用或规划建设中。真机遥操作(Teleoperation)几乎是这些数采中心最标配的数据生产方式。
当初大家一窝蜂涌入集中式数采,逻辑看似很顺:大语言模型(LLM)有 Common Crawl,多模态视觉有海量互联网图文,而具身智能面对的是物理世界的数据荒漠。许多团队直觉地把互联网时代的“数据标注工厂”模式照搬过来,试图靠堆人、堆场地、堆机器,暴力堆出具身智能的“ImageNet”。
但现实很快给行业泼了冷水:靠人工在封闭实验室里搭建标准化场景,到底能不能产出支撑真机泛化的大模型数据?当数采硬件不再稀缺,我们真正缺的究竟是什么数据?
北京首家训练中心的停运不是某个单一项目的偶然挫折,而是具身智能行业从粗放“攒数据”走向深度“用数据”过程中的必然转身。
集中式数采工厂的三重死穴:为什么“拼小时数”走不通?
在具身智能发展初期,“无真机数据可训”是核心卡点。实验室真机遥操通过操作员远程控制机械臂或人形本体,完整保留了接触刚度、摩擦力、重力扰动与人类的自适应纠错过程,确实为动作基模的冷启动立下了汗马功劳。
但当模型规模向数十亿甚至数百亿参数演进、行业试图从 Demo 走向生产时,集中式数据工厂的三重深层死穴彻底暴露:
1. 成本账算不过来:缺乏自我造血机制
真机遥操作是极度重资产、人力密集的生产模式。在实际运营中,操作员每日 8 小时工时里,扣除机器复位、传感器标定、机械臂过热冷却与通信调试,有效动作采集时长通常仅有 2 到 5 小时。
折算下来,单台机器人单小时的有效数据成本常年高于 500 元,单日单个遥操工位消耗数千至数万元。
更严峻的是下游训练的账本。极佳视界联合创始人、首席科学家朱政曾披露过一组测算:以几十万小时真机数据训练数十亿参数的具身基模,当前训练成本约在 1 亿元左右;若数据量扩大至千万小时、模型扩大 10 到 100 倍,单模型训练成本将飙升至不可承受的天文数字。
实验室数据工厂只产出训练数据、不承接实际商业交付,完全依赖研发预算与融资输血。下游模型公司买单意愿有限,一旦资本热度降温,重资产模式便率先陷入停摆。
2. 硬件强绑定与数据孤岛:动作空间无法复用
真机遥操数据与机器人的硬件本体高度耦合:机械臂自由度(6DoF vs 7DoF)、末端夹爪或灵巧手构型、RGB-D 相机安装基线与外参、驱动电机的扭矩曲线……任何一项硬件迭代,都会导致之前采集的轨迹在新的 Action Space(动作空间)下直接失效。
这种强绑定使得数据资产极难跨本体沉淀与复用。换一批机器人或升级一次构型,历史数据几乎面临全盘报废的风险。
3. 封闭环境的伪泛化:“训练场满分、现场失灵”
传统数采工厂多在恒定光照、规则台面、摆放整齐的标准化隔间内采集。
然而,真实物理世界的复杂性恰恰来自于无穷无尽的长尾扰动:窗外光照渐变、反光材质干扰、地面微小沉降、被操作物体的微小形变与滑动。在实验室无菌环境里采出的“干净数据”,往往导致模型过度拟合特定坐标,看似在训练场上行云流水,一旦被扔进真实工厂或家庭,面对微小扰动便立刻抓瞎。
突围路径一:真实业务派,用“真干活”形成正向飞轮
面对集中式数采的死穴,行业分化出的第一条突围路径是:把机器人直接部署到真实业务现场,让数据成为“真干活”的副产品。
这套思路的核心在于解决两件事:经济性与长尾扰动。数据采集不再是一项纯烧钱的研发支出,机器人在承接商业业务的过程中自然赚取服务收入,从而把昂贵的数采成本大幅摊薄。
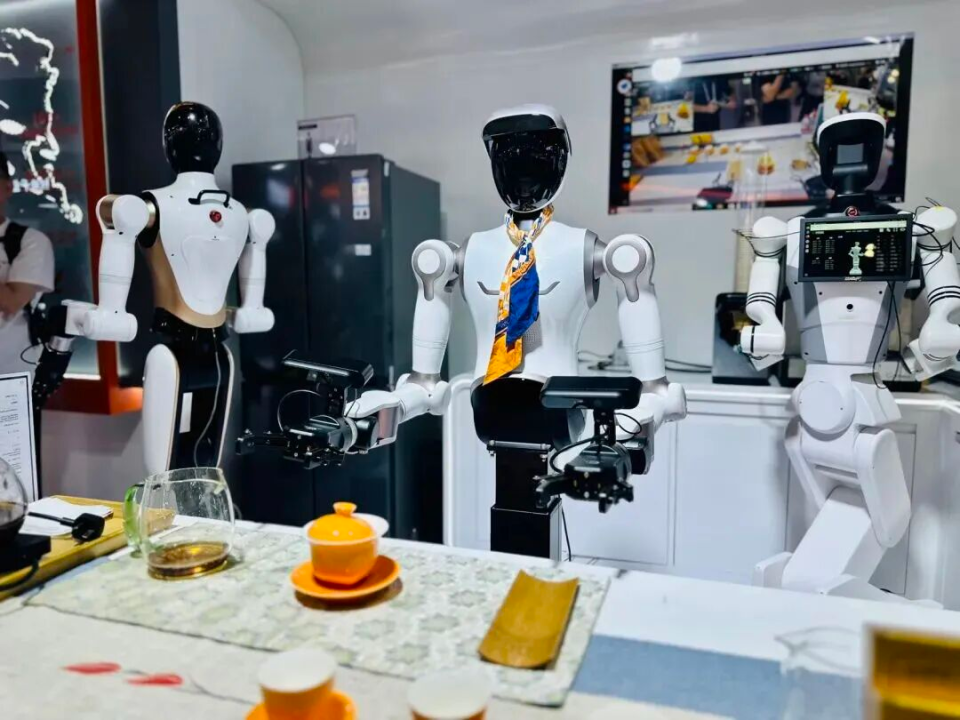
图片说明:RealBOT 机器人在药店、配电室等真实业务场景作业 图片来源:智能纪元 AGI 报道
国内具身智能企业睿尔曼智能推出的 GLN(Global Labor Network)全球远程作业网络便是典型代表。通过毫秒级低延迟远程操控,专业操作员跨地域调度部署在真实场景中的 RealBOT 机器人,直接在药店完成夜间拣药补货、在变电站配电室执行仪器巡检,乃至协助非遗师傅制作月饼。
正如其团队在 2026 世界机器人大会上总结的逻辑:“实验室遥操解决的是‘有没有数据’的问题,而到真实作业环境中远程遥操,解决的是‘数据好不好’的问题。”
当机器人真正进入近千个实体业务节点运转,“业务作业 → 真实长尾数据沉淀 → 模型闭环迭代 → 更强作业能力”的正向飞轮才具备成立的商业前提。
突围路径二:经验工业化派,从模型训练逆向重构第一视角数据
与真机业务遥操并行的另一条技术主线,则是以人为中心的第一视角(Ego)多模态数据采集。
相比真机遥操,以人为载体佩戴数采设备具有显著的低成本与高并发优势:无需购置与维护数十万元的机器人本体,便能让普通人在真实家庭、商场、工厂中海量采集人类的一手物理交互经验。
但 Ego 路线同样面临一个本质瓶颈——人到机器人的“具身鸿沟”(Embodiment Gap)。人类手掌拥有 20 多个自由度和精细的柔性运动学,而下游执行任务的机器人可能是二指夹爪、三指手或不同关节限位的机械臂。人手动作无法 1:1 直接充当机器人的电机控制指令,必须依赖算法在运动学层面做动作重定形(Kinematic Retargeting);同时,Ego 采集天然缺失真实机器人关节电机的输出力矩(Torque)与接触刚度等逆动力学(Inverse Dynamics)反馈。
这意味着,Ego 路线不仅要求硬件设备足够轻便以便于大规模佩戴,更倒逼数采系统必须在硬件底层实现极致的多传感器同步,并在前端直接解算出高精度的 3D 空间位姿与动捕关键点,才能最大程度弥合具身鸿沟。
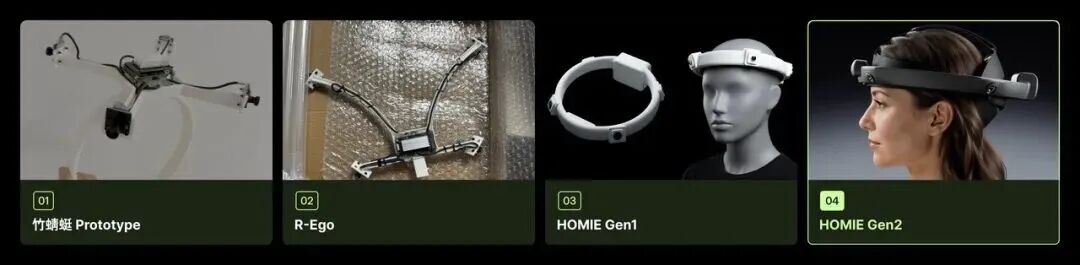
图片说明:Ropedia 从简易原型机到 HOMIE Gen2 的数采硬件演进历程 图片来源:AI 前线报道
开源数据集 Xperience-10M 背后的 Physical AI 数据基础设施公司 Ropedia(由南洋理工大学刘子纬教授、Meta 背景的陈昭熹与洪方舟联合创立)近期发布的新一代轻量化第一视角头戴数采设备 HOMIE Gen2(整机仅重约 380g,支持 13 小时连续离线采集与最高 2TB 本地存储),展现了从“模型训练需求逆向定义硬件”的工程化解法:
1. 360° 空间视野与空间音频:补齐交互上下文
人类在物理环境中的操作决策绝非仅依赖眼前的局部视野。身侧的障碍物、身后的声响、环境光源的变化,都在影响动作的执行。HOMIE Gen2 采用 4 目全景相机实现 360° 空间视野覆盖,并结合 4 路空间音频,使模型不仅能看见双手动作,更能理解整个物理场前后的完整上下文。
2. 硬件级微秒同步:消除运动时空错位
当操作员快速转头、伸手抓取时,如果视觉传感器与惯导(IMU)之间存在毫秒级的时间抖动,图像特征与位姿加速度就会发生错位。HOMIE Gen2 将 4 路视频、4 路空间音频与 200Hz 6DoF IMU 做到 50 微秒精度的硬件级时间同步,彻底消除了动态交互中的时空对齐误差。
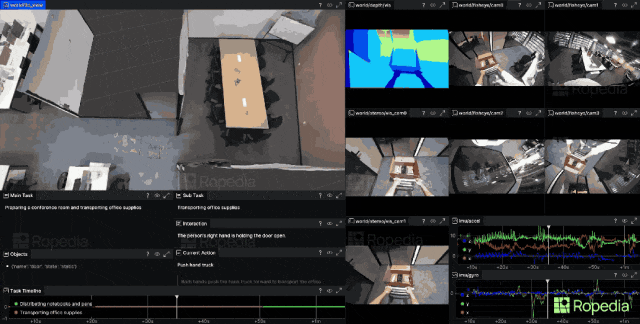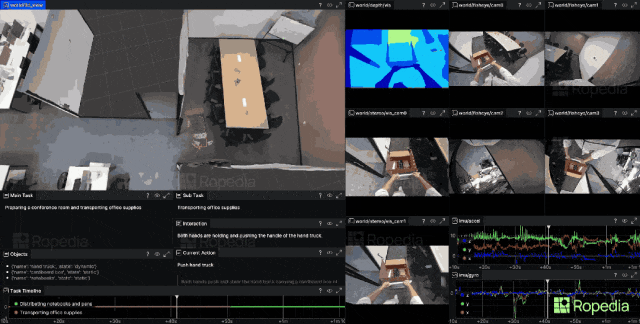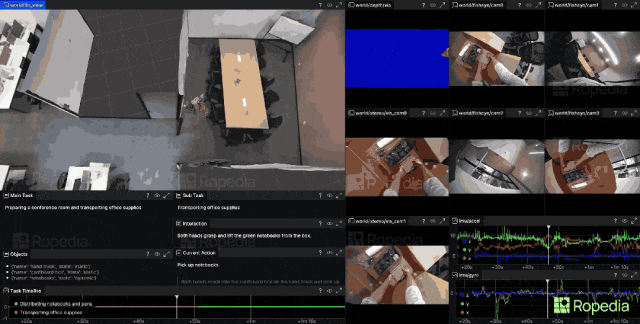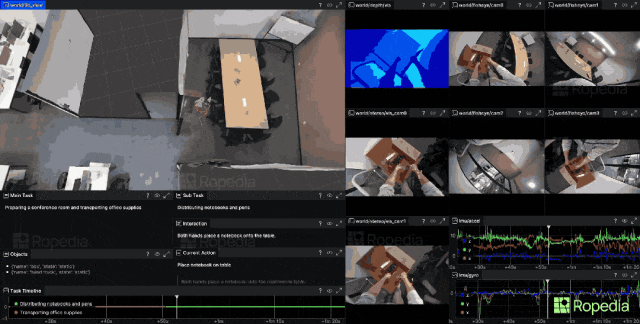
图片说明:HOMIE Gen2 采集并处理的结构化多模态数据展示 图片来源:AI 前线报道
3. 开箱即用的结构化数据:前端阻断清洗成本
算法团队最痛苦的往往不是拿不到数据,而是买来上千小时原始视频后,还要耗费数月做繁琐的手部标注、滤波去噪与位姿恢复。如果只向大模型喂入纯 2D 像素视频,模型需要自行盲目推算空间深度与运动学规律,训练收敛极慢且极易产生物理幻觉。
真正能够直接喂入具身基模与 VLA(Vision-Language-Action)模型的,必须是时空对齐的结构化动作轨迹(Trajectory)——即 [多模态观测 (Observation), 空间动作 (Action), 任务语义 (Language)] 的统一时间序列。
HOMIE 链路在前端直接完成了这套工业化封装,输出开箱即用的结构化 Xperience 数据:
显式空间与几何先验:包含精确标定的双目视频、稠密深度图、相机 6DoF 位姿轨迹,甚至支持输出 3D 高斯(3DGS)与 4D 物体跟踪,直接赋予模型三维空间感知;
高精运动学与姿态监督:手部 21 关键点动捕平均误差仅 4.68mm、全身 52 关键点,直接为大模型生成精准的空间 Action Token 提供显式运动学几何监督信号;
分层语义对齐:任务、子任务、原子动作三层文本语义标注准确率达 96.0%,使视觉、语言与控制信号在底层完全对齐。
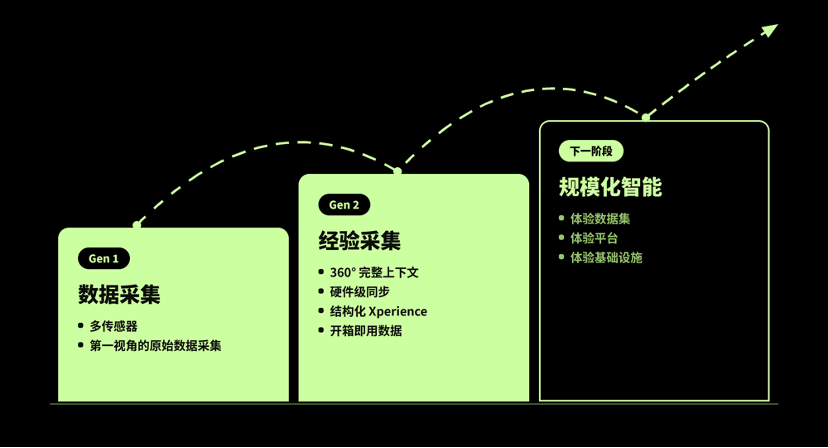
图片说明:具身数据基础设施演进的三阶段路线图 图片来源:AI 前线报道
具身数据的下半场:从“攒数据”到“物理世界经验的工业化”
从北京首家数据训练中心的停运反思,到真实业务遥操与多模态经验数采的并行演进,具身智能的数据竞争正在全面切换赛道。
面向下一阶段的技术与工程选型,行业正在形成三个核心判断:
1.有效性重于小时数:未经严格标定、缺乏多模态时钟同步、充斥无效停顿的“脏数据”,即便堆到 10 万小时,也无法训练出鲁棒的具身大脑;
2.算法理解重于硬件拼装:数采设备本身已无秘密,真正的壁垒在于从模型训练和 Action Space 逆向设计数据格式、提高结构化信息密度的能力;
3.自我造血重于纯研发投入:无论是走向真实业务现场做“真干活”的分布式遥操,还是以低成本设备规模化并发采集人类高维物理经验,能够跑通自身经济账的路线才能穿越周期。
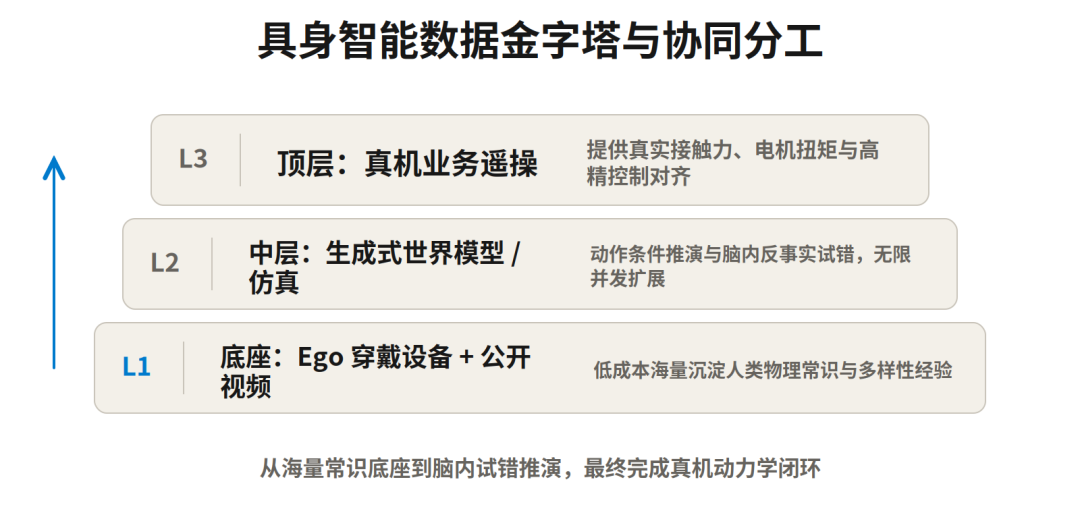
具身数据金字塔:从互联网视频、世界模型到物理数采
放眼更长远的具身数据技术版图,行业也正在明确不同数据源的分工边界:
互联网数十亿小时公开视频(被动常识底座):负责让模型通过海量真实人类视频(如烹饪、手工、日常活动)被动学习物理世界的客观常识与环境多样性(如重力、遮挡、材质属性)。其优势是 100% 真实物理、绝无穿模幻觉,但痛点在于“缺少电机动作标签(Action-less)”,无法直接驱动关节执行;
生成式世界模型(主动脑内推演):负责让机器人在“脑海”中进行动作条件推演与反事实试错(即推演“如果我施加这个力矩,下一秒画面会如何演化”)。其优势是支持数百万次无需毁坏真机的虚拟强化学习与无限并发,但挑战在于如何消除视频生成中的“物理穿模与自回归误差累积”;
物理世界真实数采(高精对齐与闭环):以人为中心的第一视角(Ego)穿戴设备以极低成本规模化沉淀人类运动学经验,真机业务遥操则提供最终的高精度逆动力学与接触力闭环。
从海量公开视频学习物理常识,到世界模型脑内试错,再到真实数采的高精动力学对齐,共同构成了下一代具身大脑的数据金字塔。
当人形机器人从“展厅里的机械表演”走向“真实世界里的自主干活”,告别盲目烧钱的集中式数据工厂,回归业务实效与数据质量工程,具身智能才算真正找到了通往产业化的坚实地基。
推荐阅读

×
右键可直接复制图片