 阅读时间大约10分钟以上(4287字)
5小时前 Figure 03进了30个陌生家庭,活干砸了一半,但我还是要夸
来源:豆包
终于有真实数据被放出来了。
作者:北野五 出品:人形大讲堂
Figure 03推开一扇陌生人家里的门,进门叠毛巾、铺床、把散在地板上的玩具收进篮子。房子是Figure在旧金山湾区租的,30套,租金照付,沙发、床、折叠台面都是人家的,毛巾堆着,被子摊开没人叠。它进门之前,没在这些房子里采过一帧数据,也没见过这批玩具、这批毛巾、这套床品。
9月17日,Figure发布Helix 2.5。视频配的宣传文案很短,说美好的机器人未来正在到来。行业里转的是它会叠毛巾、会铺床。这次发布跟过去两年真正不同的地方不在这,在于它把题目、判分标准和没做成的那部分一起交了出来。
铺床140次试跑成94次;叠毛巾成87次;收拾玩具成56次。三项合起来,420次里成功237次,成功率56%。
剩下183次没成,这44%长什么样,比56%更值得看。
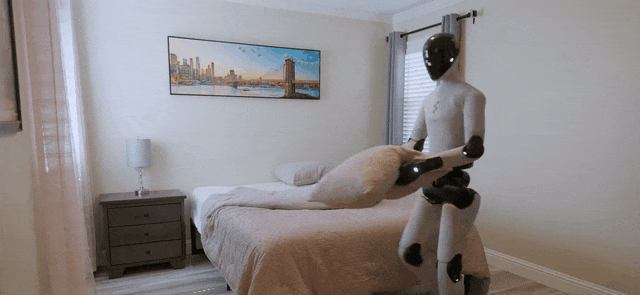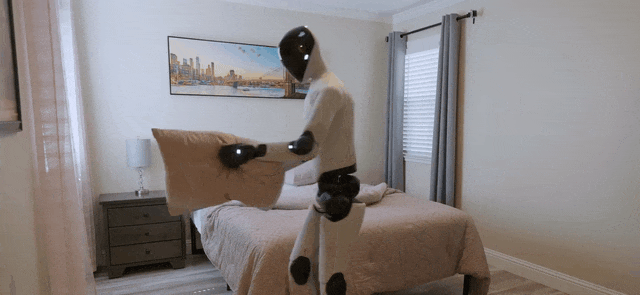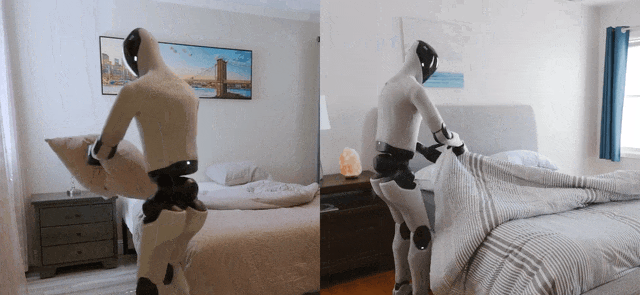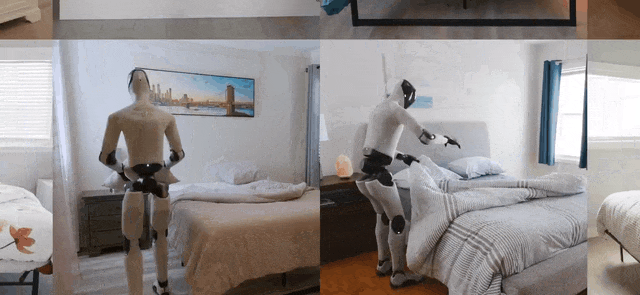
图注:官方素材里,Figure 03在湾区一户租来的房子里铺床。图片来源:Figure官方发布视频
PART 01
房子是租的,干活是真的
先把「零样本」这个词的边界划清楚,后面的讨论都站在这个地基上。
零样本指的是环境,还有被操作的物体。30个家都在湾区,没有一家进过训练数据,评测用的玩具、毛巾、床品也没在任务微调数据里出现过,Figure说这批东西事先封存,先用模型筛了一遍,再由人工复核。三种行为机器人本身是学过的,微调数据在别处采,这不是一台没受过训练的机器人走进陌生人家、当场学会了干家务,Figure在官方博客里把这一层写得很直白,用的是“任务由别处采集的微调数据指定”这个说法。
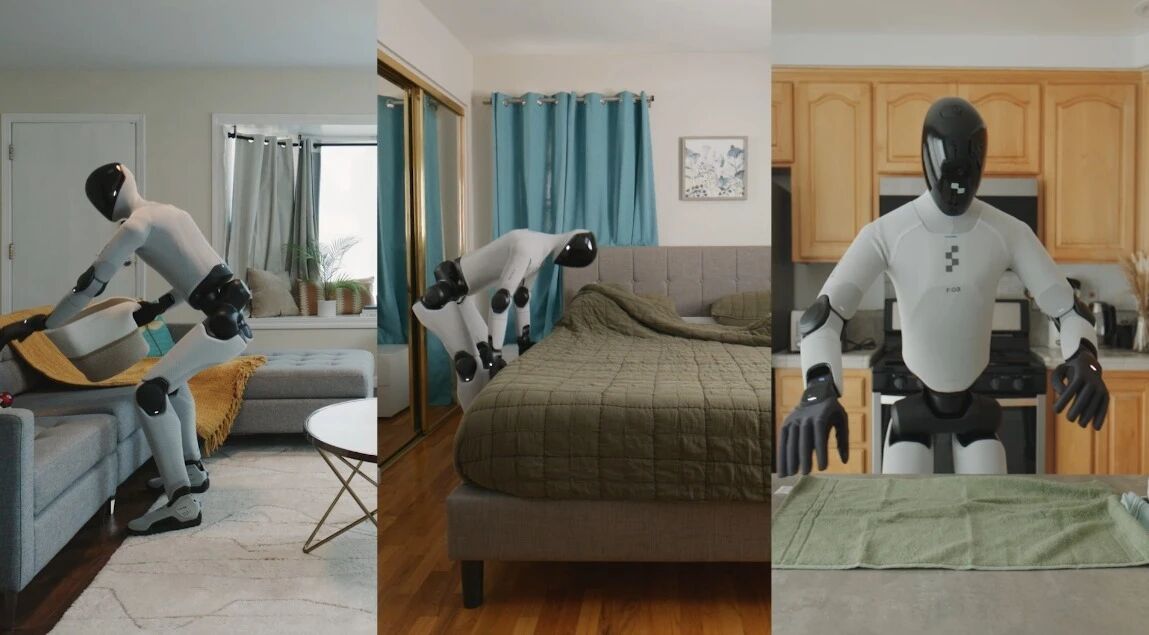
图注:官方发布里的三项任务,从左到右是收拾客厅、铺床、在厨房台面上叠毛巾。图片来源:Figure官方发布素材,IT之家转载
进了门之后,机器人用的是现成的东西。人家的沙发,人家的床,人家的折叠台面。三个任务各用一个固定的模型权重,跨30个家通用,没有针对任何一户调过参数,评测跑出来的数据也没有回头用来挑权重。每一次试跑都从各自的初始状态重新摆过场,出于安全的人工介入,这一轮直接判失败。
同一天,其创始人Brett Adcock放出了将近四小时的原始素材,画面里Figure 03在不同房子里干活,他跟AI负责人Corey Lynch在视频里说,每个实验家庭都拿到过成功去完成的任务数据。这句话说的是覆盖面,不是完成率,合起来看还是56%。四小时素材的价值在于能自己看,它不等于420次试跑的完整记录,中间剪掉了什么,外人无从核对。能核对的只剩纸面上那几行规则,而这几行,恰恰是同行很少肯写的东西。
图注:Figure创始人Brett Adcock在发布视频里讲解测试。图片来源:Figure官方发布视频,IT之家转载
PART 02
56%是一道严题,严在规则
规则写得挺细。计分是全任务制,不给部分分。
收拾客厅要把场上散落的13到15个玩具全部收进篮子,漏一个就不算;叠毛巾要把所有毛巾叠好放进篮子,叠的质量还看四个角对不对得齐,最高一档要求四个角几乎碰到一起,误差控制在一英寸以内;铺床要求两个枕头和被子两个角都到床的上三分之一,被子拉平,枕头另外看朝向。超时也算失败,每个玩具给一分钟,每条毛巾给三分钟,每个枕头和被子的每一侧各给一分钟,走完时钟这一轮就结束。
评分标准在评测开始之前就定死,评分的人照着执行。
于是即便是同一个56%,换成部分计分的口径会高出一大截。数字本身没问题,问题在于它得先被放回规则里才有意义。这次发布值得认真对待的地方也在这里,Figure终于把规则写出来了,谁都能自己算一遍。
有一处小账要算平。官方正文给的基线是9%,同一份材料里的图表画的是420次里成功35次,算下来8.3%,中文转述里有写成8%的。自家材料内部口径不齐,在这类发布里不算罕见,方向不受影响,两条线还是差了六倍多。读者碰到8%和9%两种说法时,值得知道差在哪。
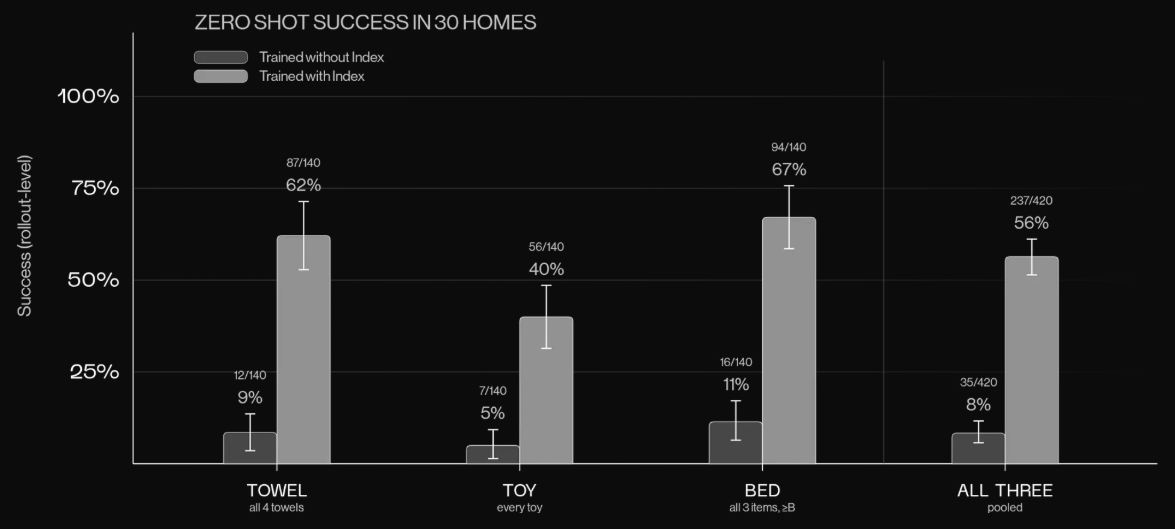
图注:官方发布里的成绩图。深色柱是没用Index预训练的对照组,浅色柱是Helix 2.5。四组数字都标在柱顶。图片来源:Figure官方发布材料
六倍能站得住,靠的是实验设计。两个策略用的是同一批任务专用数据,架构、优化器、超参、下游训练和评测全部锁死,唯一的变量是初始化,一个从随机权重开始,一个从Index预训练好的Helix 2.5开始。
既然只有这一个变量在动,差距就可以整段记在预训练头上。Figure另外做了一次代际对比,上一代Helix 02做同一件任务,用的是在部署现场采集的数据,Helix 2.5只用一半的适配数据就追平了它的成功率,还把行为搬到了30个没见过的家。两代模型的起点也不一样,Helix 02从一个预训练好的视觉语言模型出发,Helix 2.5是纯随机权重,整个在Index上生长出来。
差距这么干净地落在预训练头上,就得看看预训练吃的是什么。
PART 03
怎么训练的?数据哪来的?
所有Figure 03吃的是Index,Figure自己搭的人类行为数据平台。8月25日公开上线,之前用Project Go-Big这个名字悄悄跑了四个月,做法是付钱给普通人,让他们拿手机拍自己干活,第一视角,叠衣服、擦厨房、整理房间、仓库分拣、餐厅后厨,什么都收。
截至9月4日那一周,周活跃贡献者69,943人,上线时这个数是四万四;上传速率也在涨,现在是全球每秒有35分钟视频进来,上线时是30分钟。按每秒35分钟算,一天进账的素材相当于5.7年的人类活动。
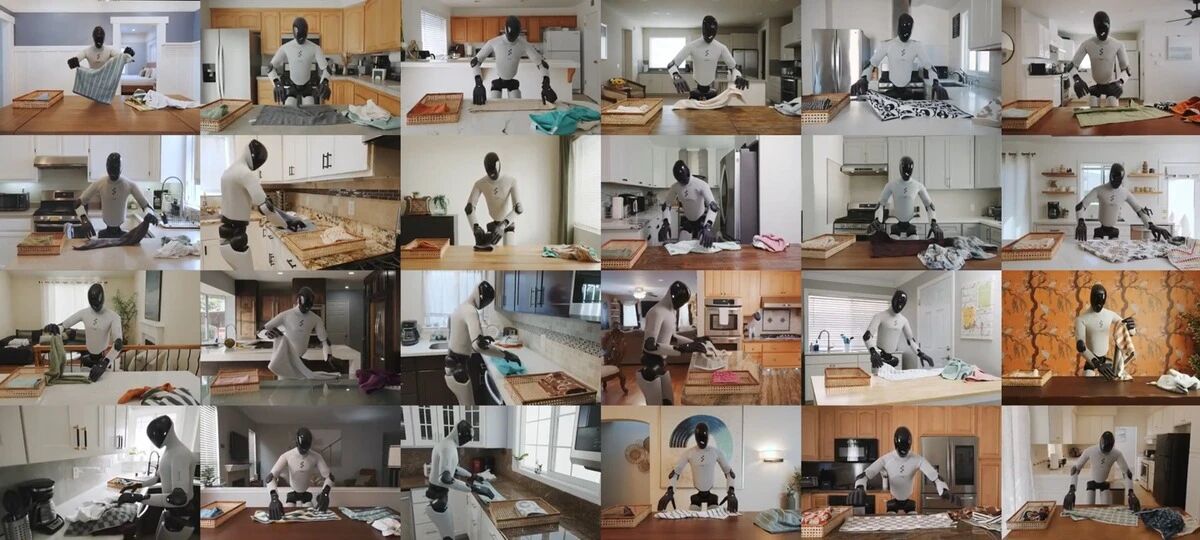
图注:官方素材里,同一个模型在30个不同家庭的台面上叠毛巾。图片来源:Figure 官方发布素材,IT之家转载
素材的多样性有具体口径,每一千小时里平均装着373种任务、1146种被操作的物体、116种环境。这些数字决定模型见过多少种叠毛巾的手法、多少种床的软硬。素材还要过五道自动化处理,技术过滤、欺诈筛查、去重、任务重新配比、分层文本标注,然后才进训练管线。
Figure已经付给贡献者1500万美元,未来一年承诺在数据和算力上投入超过10亿美元,算力那头跟Nscale签了多年协议,锁定最多10万块英伟达下一代GPU,2027年底开始交付。
人类视频喂给机器人,中间隔着一整个物理世界。视频里是一副人骨头、人的体重、肌肉的发力方式,机器人是另一副身体,关节数量、力矩范围、手掌尺寸全都不同。它从视频里学到的东西更接近任务该怎么走,而不是这只手该使多大力,抓取打滑、接触受力这些,摄像头拍不出来。Figure赌的是规模能把这层差距磨薄,那六倍就是眼下能看到的第一个证据。
这道差距到底有多宽?看看曾经吃过亏的GPT-6 Astra就知道了。
PART 04
会理解不等于手稳
在第三方项目Robocurve的一组测试里,“把红色方块放进碗”这个指令,GPT-6 Astra 20次完成了19次;换成把拼图零件嵌进对应凹槽,20次只完成2次。同一个模型,同一只机械臂,差别全在最后那一厘米。
RoboDojo官方团队9月16日出的报告量得更细,GPT-6 Astra直接当策略用,双臂任务成功率26%,平均分37.81;让它跟具身模型π0.5搭班子,π0.5先出50步候选动作,Astra只负责判断沿用还是修正,成功率升到48%,平均分62.60。搭塔这一项,Astra单打拿12分,接上π0.5之后64分;麻将杠牌从0分到40分。
这份报告里最容易被跳过的是后半句。混合架构里,Astra只改了全部控制步的 14.4%,剩下85.6%的动作照旧由π0.5出。那48%的成功率,大头是具身模型扛的,通用大模型像个偶尔出手的裁判。搭塔、杠牌、插嵌这类活,难的地方不在“知道该放哪”,在落点、摩擦、碰撞和连续接触。这也是家庭场景比工厂难的原因,家里的每样东西都不标准,毛巾的软硬不一,床垫的回弹不一,篮子的位置每户都不同。
那56%就是衡量完成最难指令的能力。收拾玩具只有40%,是三项里最差的,官方没解释为什么,从规则上看原因不难猜,13到15个玩具,形状材质各不相同,目标位置每户不一样,还得一个不漏。这一类“行活儿”,恰好也是国内演示里出现得最多的。
9月16日,智元发布远征A3 Ultra的商用落地实景案例视频,场景是4S店、酒店和零售便利店。
酒店那一段,机器人铺床、叠毛巾、整理客房,跟Figure挑的三项任务几乎重合;便利店那一段是理货、巡逻、补货、搬大件。智元给出来的信息集中在硬件和场景,头上装的是360度全域感知,定位靠UWB加RTK融合,算力700 TOPS,末端是一对20个自由度的全向触觉灵巧手,能自己充电也能极速换电,整机走完了千台级车规量产验证。
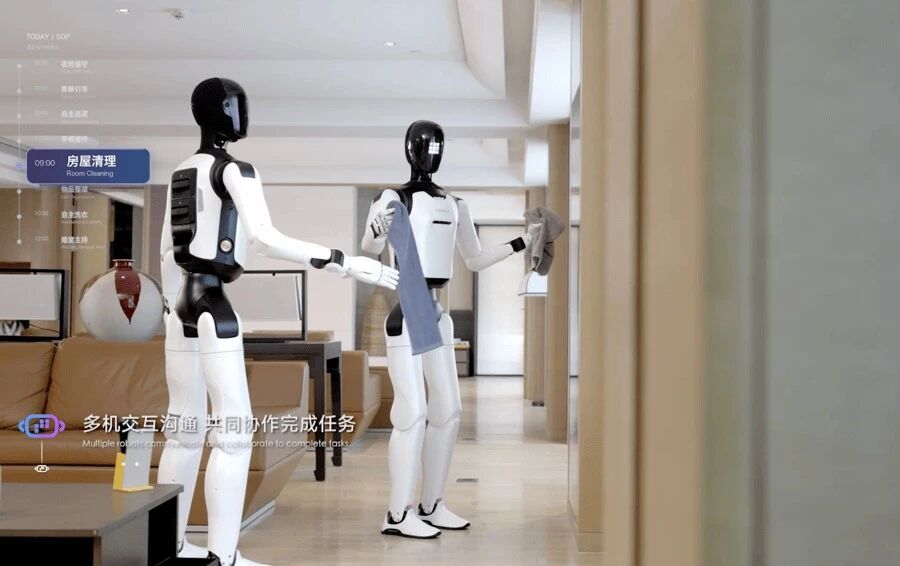
图注:智元远征A3 Ultra的商用落地视频里,两台机器人在酒店客房整理织物。图片来源:央广网
公开材料里没有成功率,没有试了多少次,没有评分标准,也没说不成功的那些长什么样。这不是智元一家的习惯,国内这类演示的通用格式就是精选片段加参数表加落地场景名单,成功率通常不在其中。Figure这次真正稀罕的地方也在这儿,它肯把分母拿出来,数字不好看,但可以被讨论。
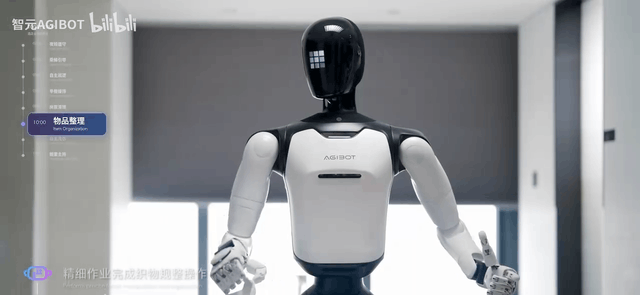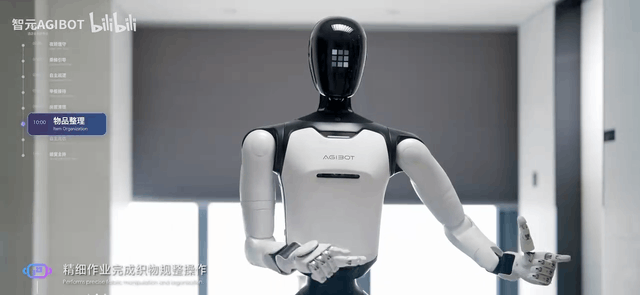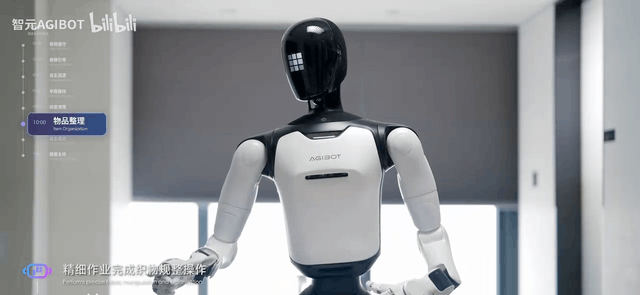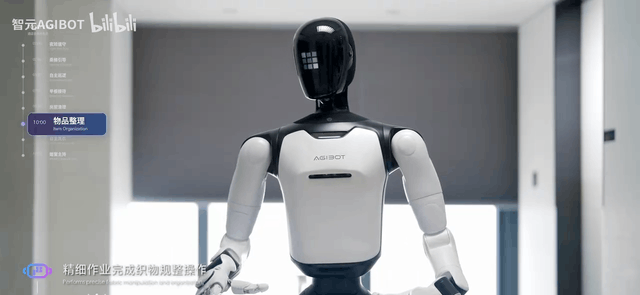
图注:同一支视频里,机器人在桌边把织物叠好。画面里的时间轴和字幕是视频自带的。图片来源:智元官方演示视频
押人类数据的还不止Figure。同一天,北京的LiberAI公布了Liber-0 Preview,在RoboDojo榜单上以平均分30.74、平均成功率25.52%排到第一,超过GPT-6 Astra。
这个榜由港大、伯克利、清华等近20家机构联合搭建,42项仿真任务加18项真机任务,覆盖泛化、记忆、精细操作、长程执行和开放语义五个维度,同一个榜上π0.5的平均分是11.41,成功率6.91%。LiberAI的技术路线跟Figure是一个方向,人类数据加大规模预训练,自研数据采集手套以毫米级精度捕捉手部动作,把本体信息当作一个可以放大的维度。
国内主流走的是另一条路,遥操。人穿着动捕设备,或者手持控制器遥控机器人,直接采真机数据。好处是数据天然带着机器人本体的力矩和接触信息,不需要跨越大脑和手之间那道鸿沟;代价是产能,一台设备、一个操作员、一小时,采出来的就是一小时。
两张成绩单没法相加。56%量的是三类家务,在真家庭;25.52%量的是42项通用任务,在仿真和真机混合的基准上。题目不一样,环境不一样,评分规则也不一样,数字不该对齐着读。
能放在一起看的是另一件事,人类数据这条路线第一次同时有了两张成绩单,一张在家务上,一张在通用任务上,两个数字差得很远,说明这条路远没到收工的时候。至少现在可以吵数字了,不用再吵视频好不好看了。
PART 05
剩下的44%和一份起诉书
100%减去56%,剩下的44%里有一半Figure是主动摊开的,包括机器人出错之后的样子。松手了会退开一点重新定位,够不着会换个站姿,被子铺偏了会绕到床的另一侧补一下,这些动作没有被单独训练过,Figure把它归到Index预训练的效果里。
家庭场景不可能被穷举,任何一台机器都会出错,能不能从错的地方爬回正轨,才是上岗和演示之间的分水岭。这一条比56%更有含金量。
能爬回正轨是一层,出错的时候会不会伤到人是另一层。第二层不是发布会上的话题,是法庭上的,而且比Helix 2.5早了十个月。
2025年9月,Robert Gruendel被Figure解雇,他的职位是首席机器人安全工程师。两个多月后,11月21日,Robert在加州北区联邦法院起诉公司。诉状里的说法是,他多次向高管报告实验室测试中观察到的危险行为,其中包括一次故障中机器在钢制冰箱门上留下约四分之一英寸深的划痕,他还向CEO Brett Adcock和总工程师Kyle Edelberg说明过机器具备致命能力。
他另外指控公司向投资人展示的安全方案在融资完成后被改动,并认为这可能构成欺诈。Figure的回应是,解雇原因是绩效不达标,这些指控不实,会在法庭上抗辩。他的律师Robert Ottinger对媒体说,这可能是第一批涉及人形机器人安全的吹哨人案件之一。
这些目前都是原告的单方指控,法院没有认定。截至写这篇稿子,我没有找到判决或和解的记录。十个月过去,两份文件问的是同一个问题。Figure让机器在30个陌生家庭里自主干活,明确规定人工介入算失败,这句话的另一面是,机器在别人家里松手、撞到东西、站不稳的那些瞬间,安全流程得自己顶住。
56%也不能换算成家庭可用程度。有独立媒体把这个数读成「离一台敢让它在没人的房子里自己跑的产品还很远」,这个解读是对的。Sunday Robotics的Tony Zhao说得更不留情面,他直接拿237比420说事,说这就是一半的时候干不成,并把公式写成「做有用的工作等于泛化加可靠性」。
话糙,但方向没歪。
回到那扇被推开的门。真正值钱的不是56%。是Figure顺手把卷子也交了出来,那张任务清单,写清楚全任务计分、超时判失败、人工介入判失败的那几行规则,还有那近四小时的原始素材。这两年的机器人演示视频通常只有镜头,没有试卷。
这三样东西决定一个数字能不能被复核。清单决定考的是不是真事,规则决定56%是严口径还是宽口径,失败片段决定有没有人替你把没干成的那些剪掉。
下一次再看到机器人干家务的视频,先别问成功率涨到多少。问三件事,任务清单在哪,规则谁定的,没干成的那些有没有放出来。三样齐了,那个数字才叫成绩。
推荐阅读

×
右键可直接复制图片