 阅读时间大约8分钟(3060字)
1天前 从摸到到抓稳:机器人触觉、力觉与控制怎样连起来
来源:豆包
触觉图像、六维力和动作策略各管什么?沿着抓杯与插接,讲清接触信息怎样变成动作调整。
作者:我不是毛毛 出品:具身智能前沿
夹爪合拢,杯子离开桌面,摄像头看起来一切正常。但杯壁可能正在指尖缓慢滑动,夹紧力也可能已经让薄壁杯变形。要继续搬运,机器人还得判断接触发生在哪里、物体怎样受力,以及这些状态有没有变化。
先按关注的信息区分。触觉与力觉有重叠,同一个传感器可能同时提供两类信息。
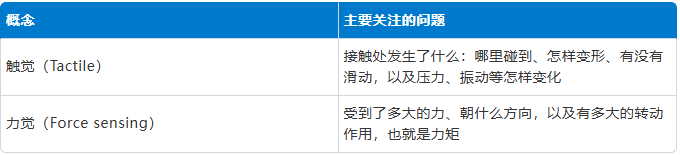
手指压住杯壁,接触在指尖左侧、接触区域正在移动,描述的是接触状态;压紧力是多少牛顿,描述的是受力。触觉传感器可以记录位置和形变,也可能通过标定或模型估计接触力,两种描述可以同时成立。
力是有大小和方向的推、拉、压等作用;力矩是力相对于某个点或转轴产生的转动作用。推门时,在门把手附近垂直门板推,比靠近门轴施加同样大的力更容易推开,因为力的作用线离门轴更远,力臂更大。两次推力相同,力矩却不同。力的单位是牛顿(N),力矩的单位是牛顿·米(N·m)。
点、面和安装部位不是这两类信息的定义。触觉可以来自单个接触点,也可以由阵列记录区域分布;六维力/力矩传感器输出三个方向的合力和绕三个轴的合力矩。这些作用可能来自整片接触面,整体读数不意味着只有一个点受力。
是否同时安装两类器件,要看任务需要。只装触觉传感器,也可能估计接触力;力/力矩传感器也可以配合视觉和机器人状态完成部分操作。以抓杯的一种组合为例,指尖触觉阵列观察局部压力与滑移,腕部六维传感器补充整体受力,但不能直接给出每根手指的压力分布。
本体感觉则提供关节位置、速度等身体状态,让系统知道手指张开多少、机械臂处于什么姿态。触觉和力觉也不限于手部:前臂或躯干可以覆盖触觉皮肤,腿部也可以配置力/力矩传感器。判断设备用途时,要看它实际测到或估计了什么,再看这些信息是否满足任务。
传感器首先交出的是信号
指尖碰到杯壁后,压力阵列在多个感知单元上产生读数;光学触觉传感器则用内部相机观察柔性接触层的形变。相机看到的是传感器表面的变化,外部场景相机负责的杯子位置与外观仍是另一类信息。
GelSight 的原始研究展示了这种处理:从图像中减去背景,再分割表面标记点、定位其中心。跟踪标记点怎样移动,可以为估计受力和滑移提供线索。其中,垂直于接触面的压紧作用称为法向力,沿接触面作用的称为剪切力;重建接触几何,则还要利用光照与表面形状的关系。
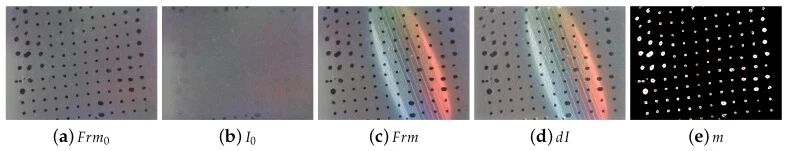
从无接触图像、背景估计到接触图像、背景相减和标记点定位;红点表示提取的标记中心 | 来源:GelSight,Sensors 2017,Fig.5
这里有一层重要转换:图像中的位移、阵列里的电信号,要经过标定或估计,才能成为具有物理意义的量。原始信号、估计的物理量、任务判断是三个不同层次。例如,标记点移动不直接等于已经测出了多少牛顿,更不直接等于杯子一定会掉。
刚度也需要进一步推断。它描述受力与形变之间的关系,通常要结合力和位移变化,或使用相应动力学模型。六维力传感器不会直接多输出一个“物体刚度”通道。
从接触变化,到可用的状态与表示
接下来,系统需要回答的可能是“杯子正在下滑吗”,也可能是“插头顶在孔的哪一侧”。不同任务需要从信号中保留的信息并不相同。
有些系统先显式估计接触位置、受力方向或滑移状态,再把结果交给控制器。以软接触为例,接触区域边缘可能先发生局部滑动,中心仍然贴住。GelSight 研究利用标记点位移分布的不均匀变化,识别这种局部滑移线索。
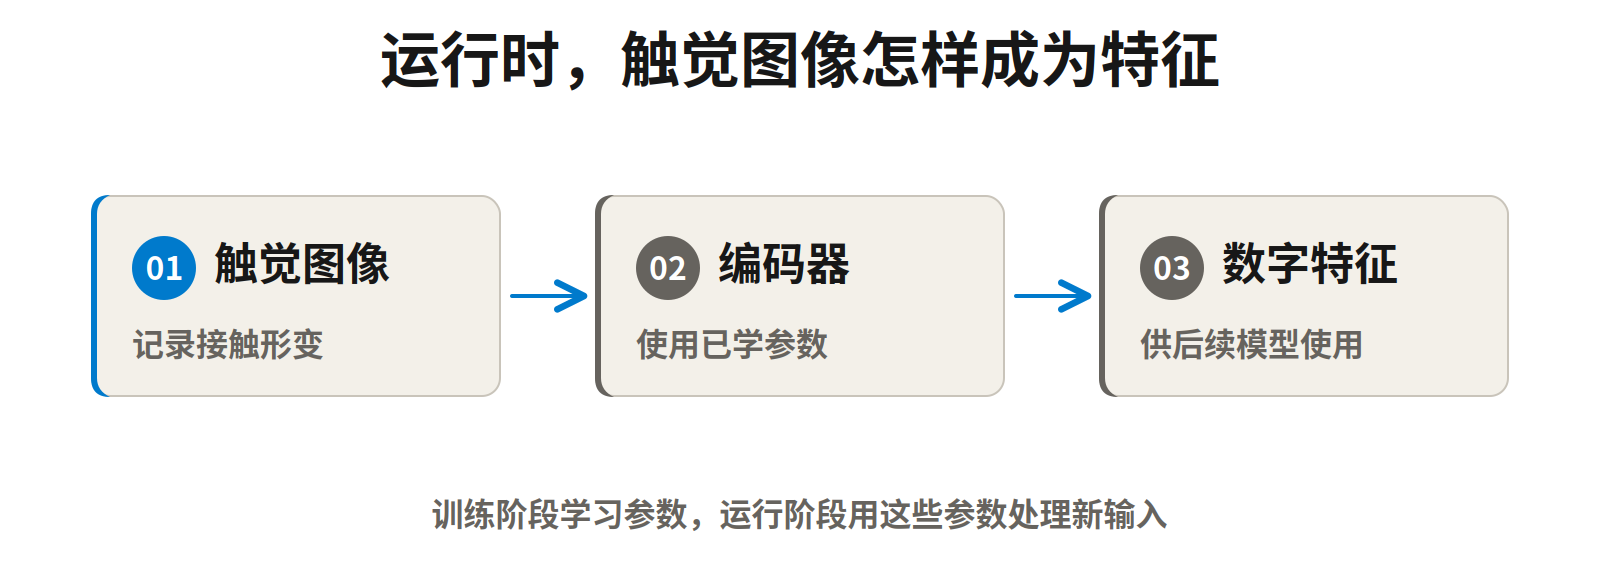
也可以先训练一个编码器,把触觉图像转成一组数字特征,供后续模型使用。这组特征称为“表示”;训练编码器提取有用特征,就是“学习表示”。单个特征不一定对应一个物理量,它们共同保留后续判断所需的信息。
训练时学习怎样编码,运行时用训练好的编码器处理新信号。特征可以交给较小的任务模型估计接触力、判断滑移,也可以与视觉、语言和身体状态一起输入动作策略,不一定需要大模型。学习表示因此也能服务于显式估计,两者可以组合。
Sparsh 就先用无须逐张人工标注的触觉图像学习编码器,再利用其特征训练力估计、滑移检测等下游模块。自监督训练可以从图像本身构造目标,例如遮住部分图像后让模型恢复缺失信息;下游任务再用具体标签学习如何判断。
预训练的价值在于,让不同任务有机会复用已学特征。照明、柔性材料、表面标记和磨损仍会改变输入,能否迁移要在目标设备和任务上验证。
触觉进入模型,怎样影响下一步动作
状态判断之后还需要动作选择。即使已经知道接触力变大,也要结合任务判断:是继续压紧、改变姿态,还是退出重试。
视觉语言动作模型,即 VLA,根据图像、语言指令等输入生成动作。接入触觉时,需要让接触变化参与动作预测;前面的学习特征是一种输入形式,下面这项研究展示另一种形式。
TAP-VLA 选择了一条直观路径。它从 GelSight 标记点相对参考图像的运动中提取剪切提示,再根据手指位姿和相机标定,把提示投影成外部相机画面里的彩色线段。训练时,模型接收带标注的图像、任务指令和机器人状态,学习输出动作。
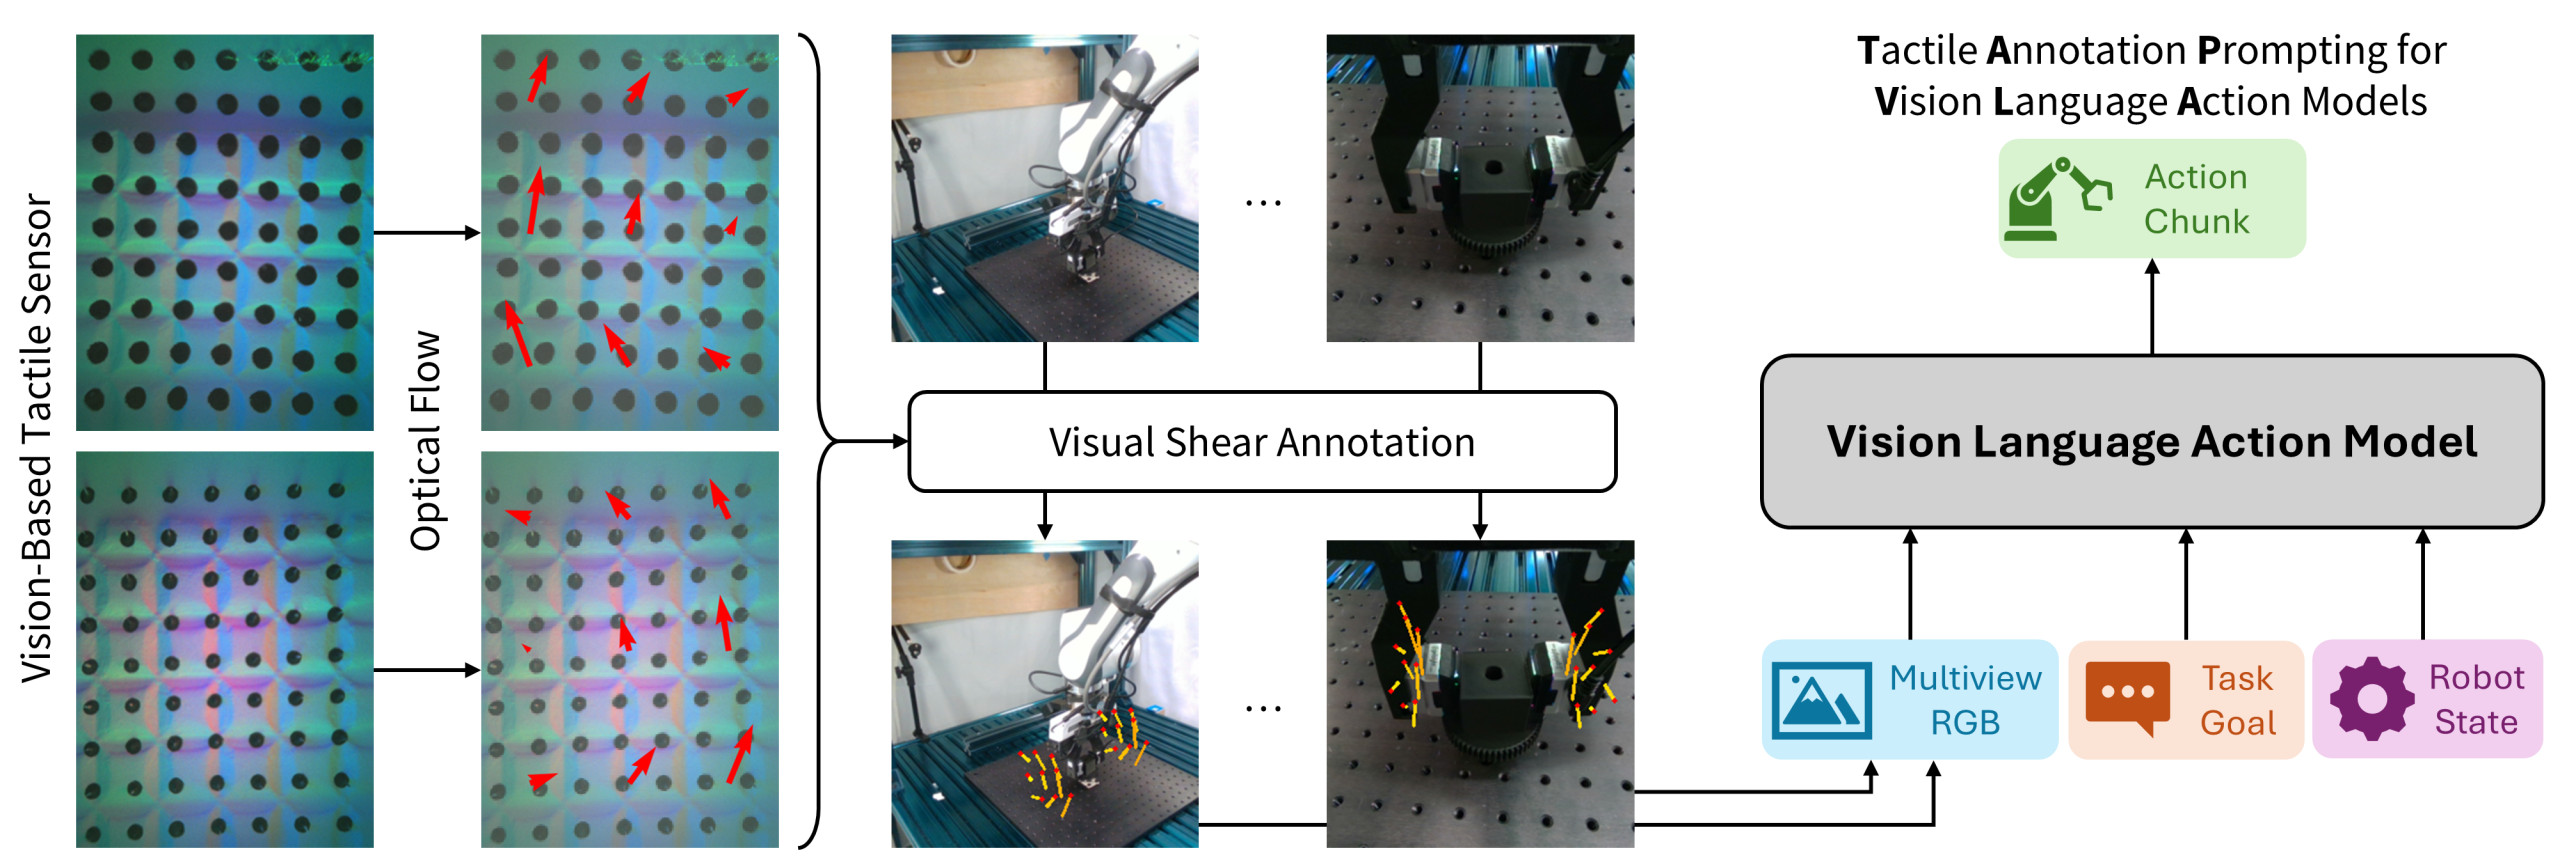
左侧从触觉图像提取标记点运动,中间把提示叠入相机视图,右侧由图像、任务目标和机器人状态共同生成动作 | 来源:TAP-VLA,arXiv v1,Fig.1
这样,接触信息沿用原有图像输入接口进入策略。它仍然需要任务示范微调,也依赖空间标定。图上的线段是从标记点运动得到的提示,并非直接以牛顿标定的力矢量;这条路线也没有使用前文的 Sparsh 编码器。
论文在 Franka Panda 与双指 GelSight 上测试药瓶分拣、重心相关摆放、齿轮插入和插头插接,每种方法每项任务各测试 30 次。TAP-VLA 成功 94/120 次;只用视觉、直接加入原始触觉图像、另设触觉编码器这三个对照的总体成功率都低于一半。这支持其在这些实验中的接入方式有效,不能推成所有机器人都该把触觉画进图像。
这项实验提醒我们,判断接入方式时,除了检查传感器提供了什么,还要看策略怎样使用这些信息,以及是否真正改变了执行结果。
策略给出调整,控制器还要真正执行
回到杯子。如果系统判断接触正在失稳,候选动作可能包括适度增加夹紧力、降低搬运速度,或者放下后重新抓取。对易碎物体,持续加力就可能把防滑问题变成损坏问题。
这些选择还要转成执行器能够跟随的命令。策略可以给出目标位置、速度、力或其他控制参数,控制器再结合机器人状态驱动电机;实际动作改变接触,传感器继续检查结果。
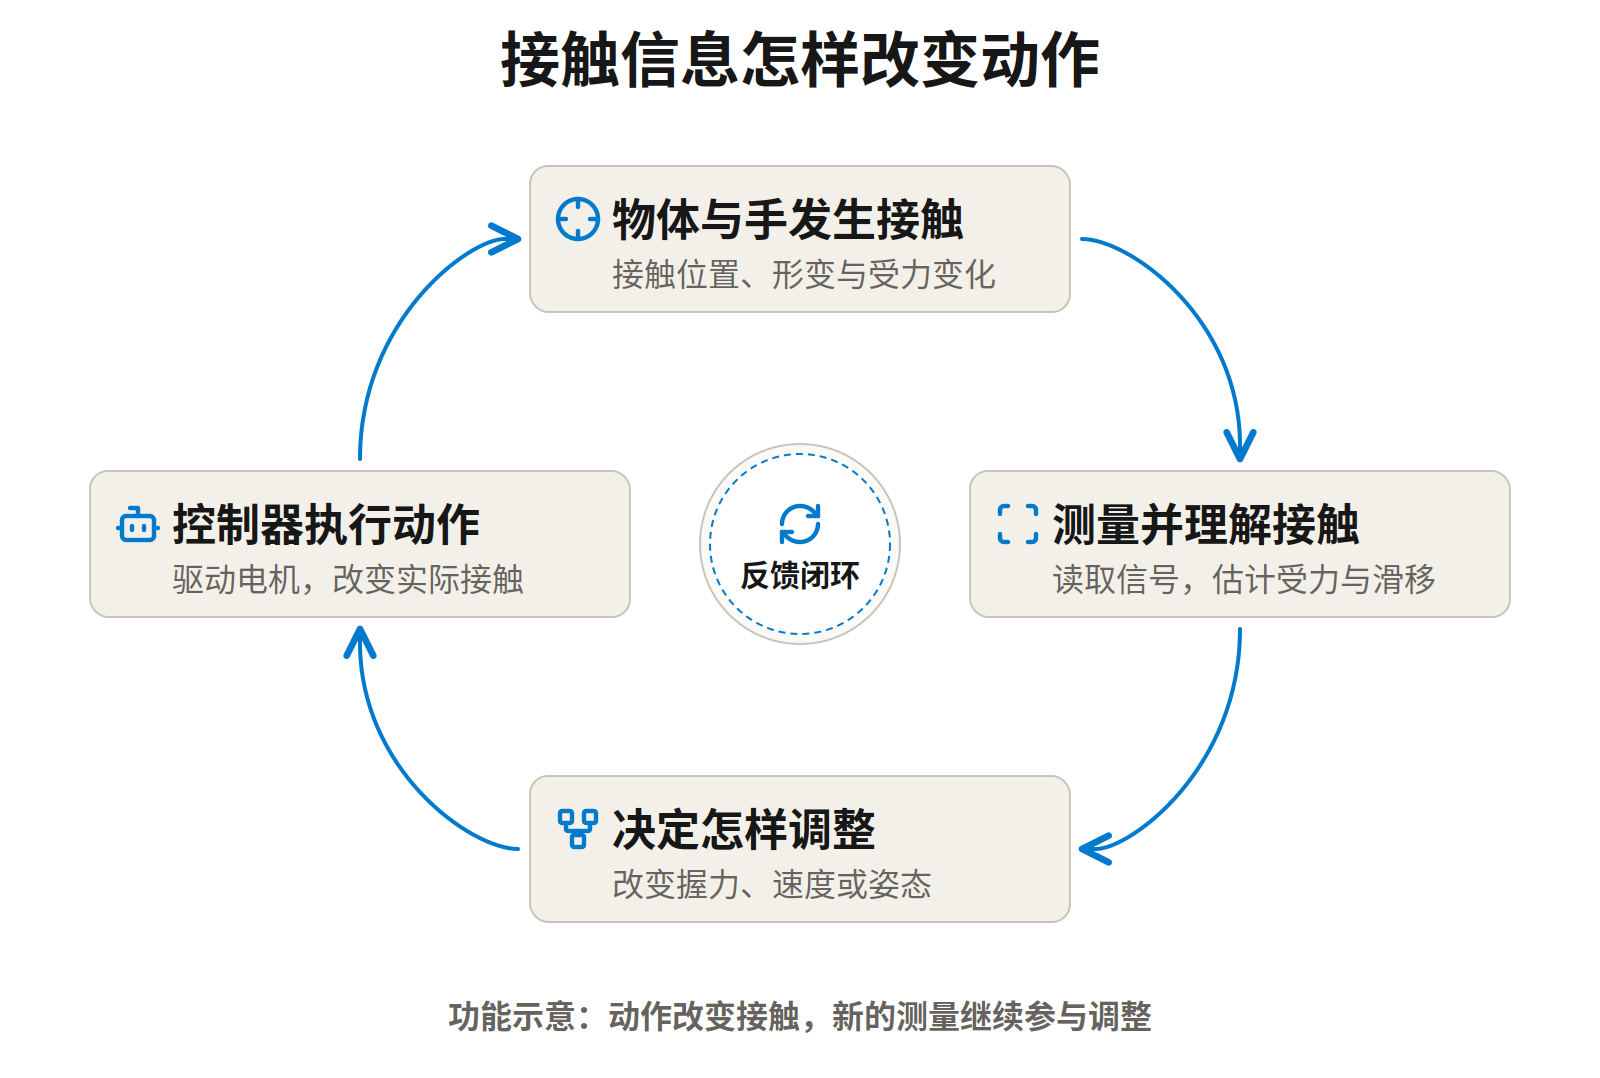
插接尤其能体现这种分工。插头接近孔口时,系统先利用视觉与身体状态对齐;接触后,若出现异常侧向阻力,就需要根据可用观测调整位置、姿态或退让方式,继续按原轨迹硬推未必能完成插入。
柔顺控制用来规定机器人在外力下怎样响应。以阻抗控制为例,可以把目标附近的行为理解为带弹性和阻尼的机械响应:偏离目标时产生恢复作用,同时抑制过快变化。沿哪些方向允许让步、阻力增大时怎样处理,要与任务匹配,不能把“柔顺”理解成越软越好。
Franka 的控制接口就区分运动目标生成与控制器,并允许配置阻抗、读取状态和运行实时控制。这个例子说明,上层规划一段动作与底层持续处理执行状态,可以承担不同职责。具体系统也可以把若干职责合在同一策略或控制器中。
反馈给机器人,还是反馈给操作员
上面的过程由机器人自身利用接触信息修改动作。遥操作还可以把这些信号转成手柄阻力、皮肤刺激等反馈,让操作员感受接触并参与调整。
Haptic 是触感相关的感知与交互概念,涵盖皮肤触感,以及与肢体受力、位置和运动相关的动觉。它可以用于遥操作,也可以用于虚拟环境;不能把它理解成必须同时安装触觉与六维力传感器。机器人测到了什么,与反馈最终传给谁,是两个不同问题。
抓稳一次之后,还要经得住变化
把这些环节连起来,最后要面对的是持续使用的条件。
首先是测量是否可信。换一块接触材料、调整安装位置,或者使用一段时间后发生磨损,信号就可能变化。标定、背景参考、坐标关系与时间同步,决定不同观测能否对应同一次接触。
其次是反应是否及时。传感器采样、传输、预处理、模型推理和命令执行都会占用时间。单个传感器刷新快,不能证明整个系统能及时纠正滑移;模型生成动作快,也不能代替对实际执行的检查。
最后是经验是否覆盖变化。不同杯壁、接触位置与夹持方式,可能产生不同信号。同一套策略需要验证自己能处理哪些情况,以及何时该减速、重抓或停止。人类采集与机器人自身交互可以提供训练数据,但迁移到新传感器、新身体和新任务后的效果需要分别验证。
再看一个插接系统,就可以沿同样的过程追问:它测到了阻力、局部形变还是只有位置偏差?这些观测怎样导致姿态或推进动作改变?调整之后,又根据什么判断已经对齐?如果资料只展示了一张压力图,就还不能判断它是否形成了有效的操作闭环。
推荐阅读

×
右键可直接复制图片