 阅读时间大约10分钟以上(5564字)
1天前 解读|预训练之外,后训练和部署后怎么 Scaling?
来源:豆包
后训练和部署后的scaling是具身要解决的难题。
作者:liuxjerry 出品:具身纪元
具身发展到今天,预训练的 Scaling 被讨论得最多:数据越多、模型越大,零样本能力越强,从 GEN-0、EgoScale 一路讲到 Dyna-2 的一百万小时。
具身智能也希望借鉴大语言模型的训练范式,发展自身的能力。所以预训练的scaling和泛化能力,当然是十分重要的。
但机器人要真正干活,终究得走进真实环境去部署,这点其实很长时间内都被忽视了。大家的注意力更多集中在预训练的scaling上,对于后训练的数据怎么用好,部署后的经验怎么回流,讨论的还不是很多。但在2026年快到年底的今天,这些正在变得和预训练一样重要。
11月2日,6台精灵G2在机器人便利店进行了24小时不间断直播,覆盖从午高峰到早餐冲刺的四个班次。在便利店场景的真实部署中,实现了从前台沟通,到取货买单的全链条工作任务交付。这些场景落地,恰恰是需要一套完整的后训练和部署后的管线,才能解决好的问题。
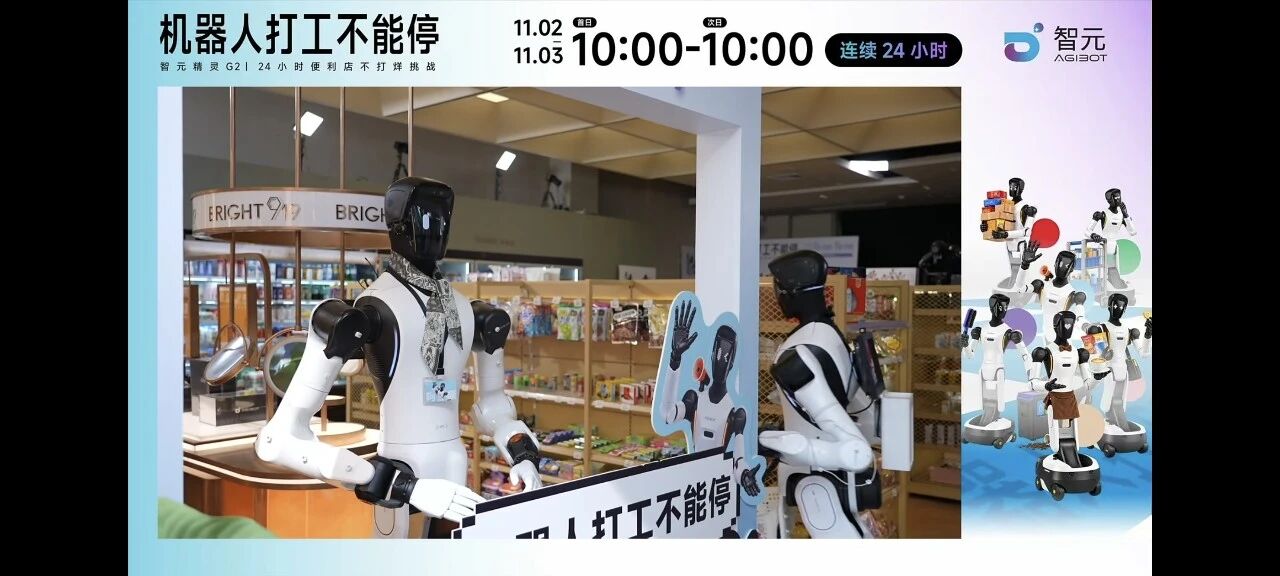
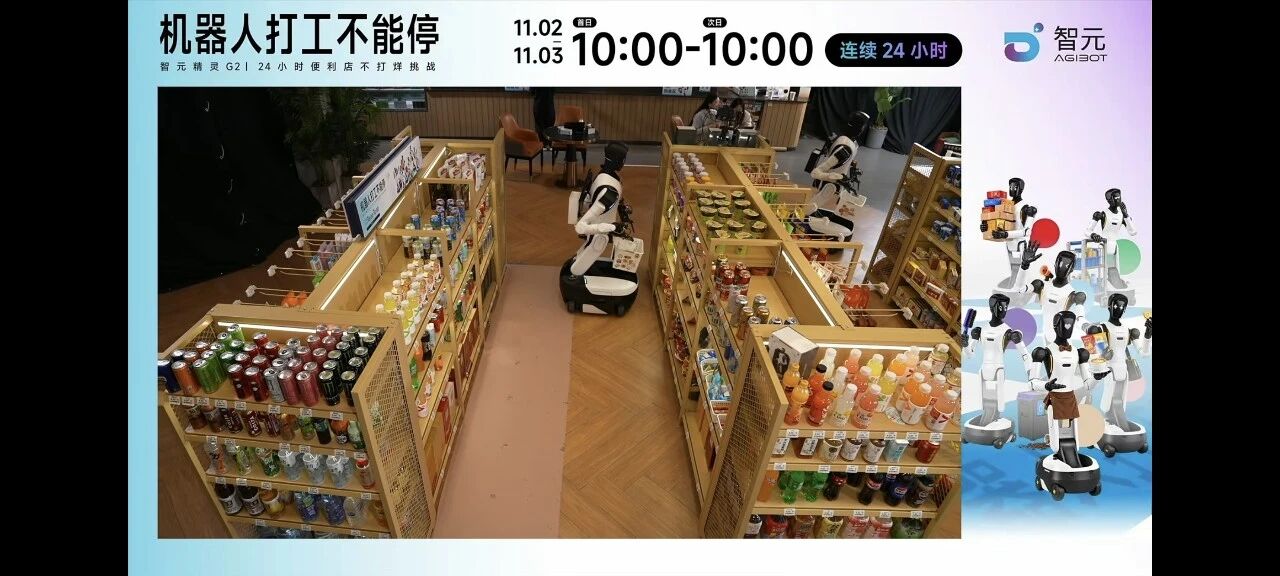
这几年,其实行业内在后训练和部署后Scaling所需要的经验来源、反馈信号、人的角色和学习基础设施上,都下了不少功夫,也有很多进展。但真实的卡点,越来越集中到数据效率上:经验攒得越来越多,进入训练的却还是很少。
先来捋捋行业的进展和瓶颈。
01
行业走到了哪一步
经验来源:真机、仿真和世界模型都在发展
后训练和部署后 Scaling需要的经验,来源于真机、仿真、世界模型这三个方面。
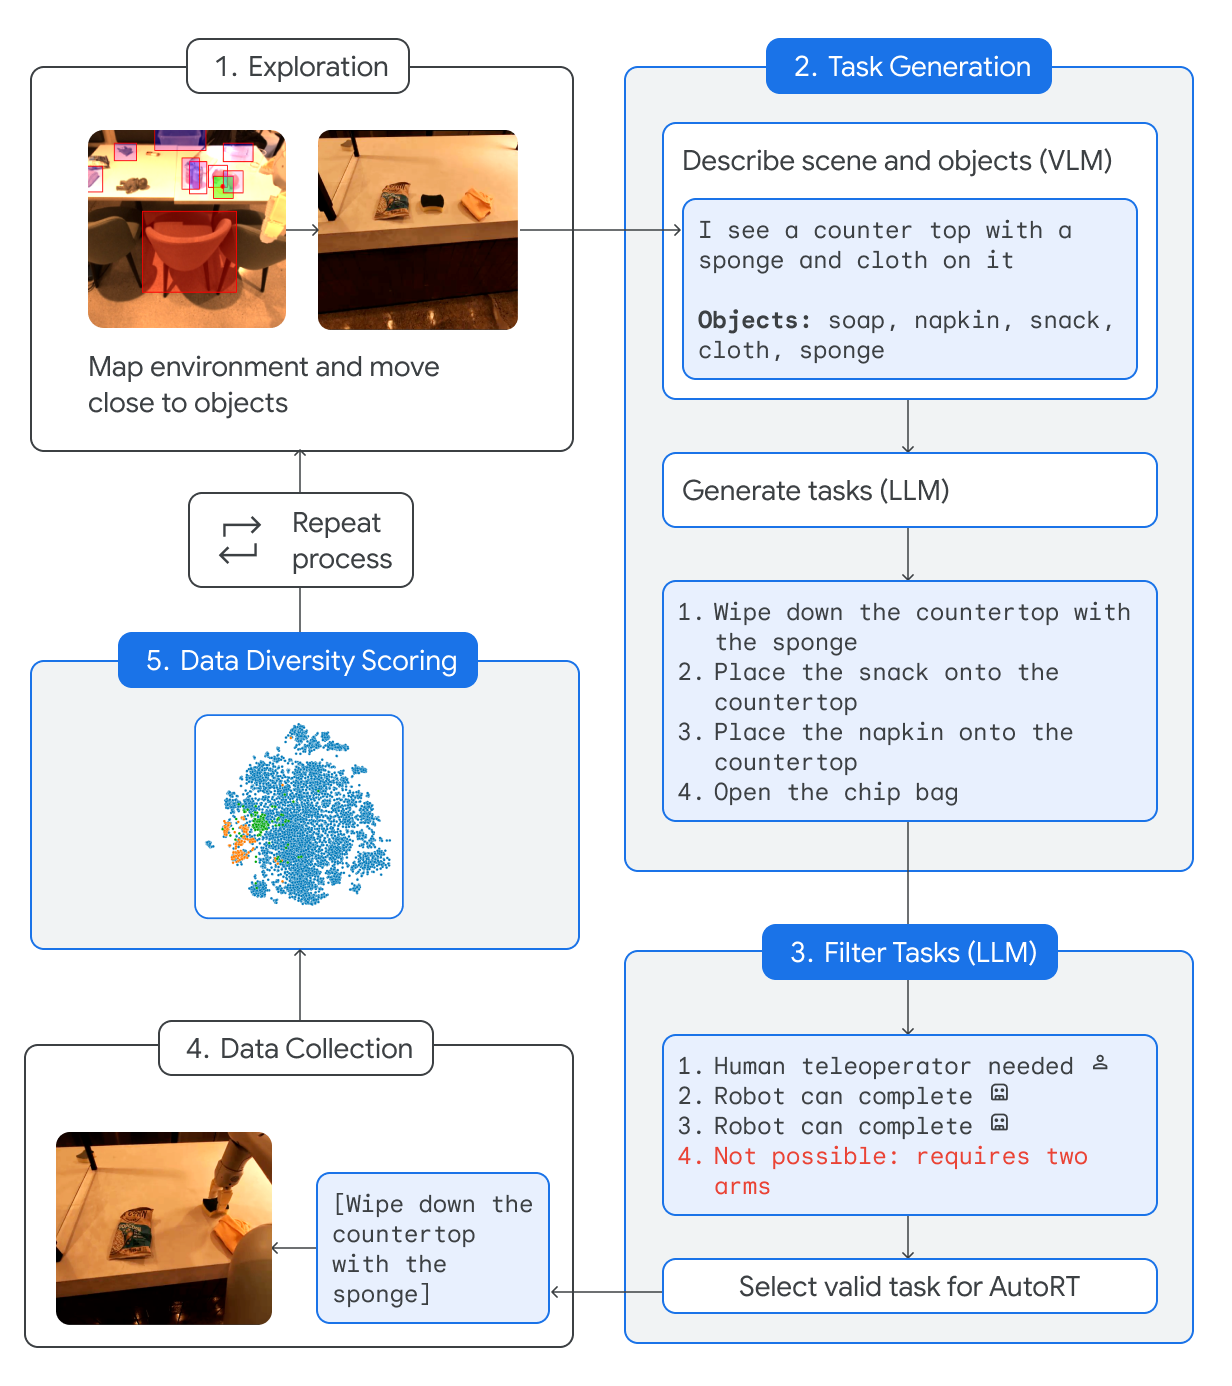
真机机队这条线很早就有。2018 年 Google 的 QT-Opt 用 7 台 KUKA 机械臂、4 个月做了 58 万次抓取,数据进入共享回放池反复学,再补充约 2.8 万次在线抓取,成功率从 87% 提到 96%。2024 年 DeepMind 的 AutoRT 用大模型给机队分配任务、做安全筛选,7 个月里 20 多台机器人跑了 7.7 万多次真机试验。
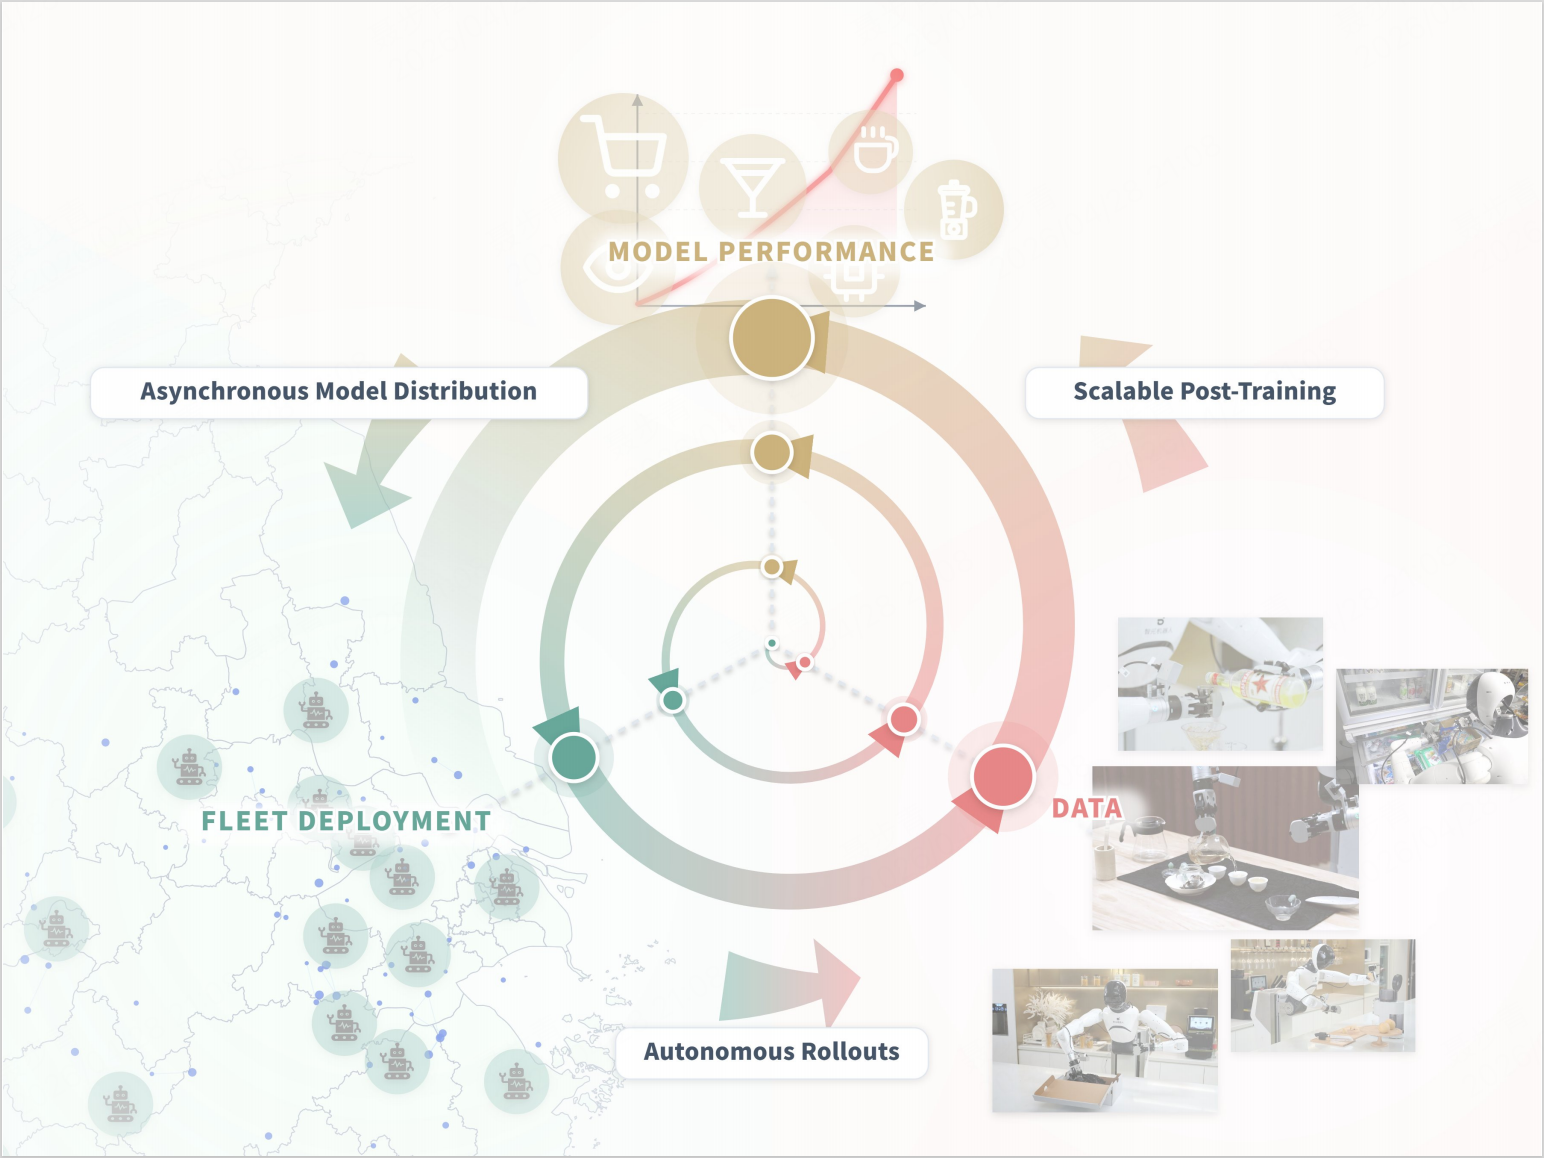
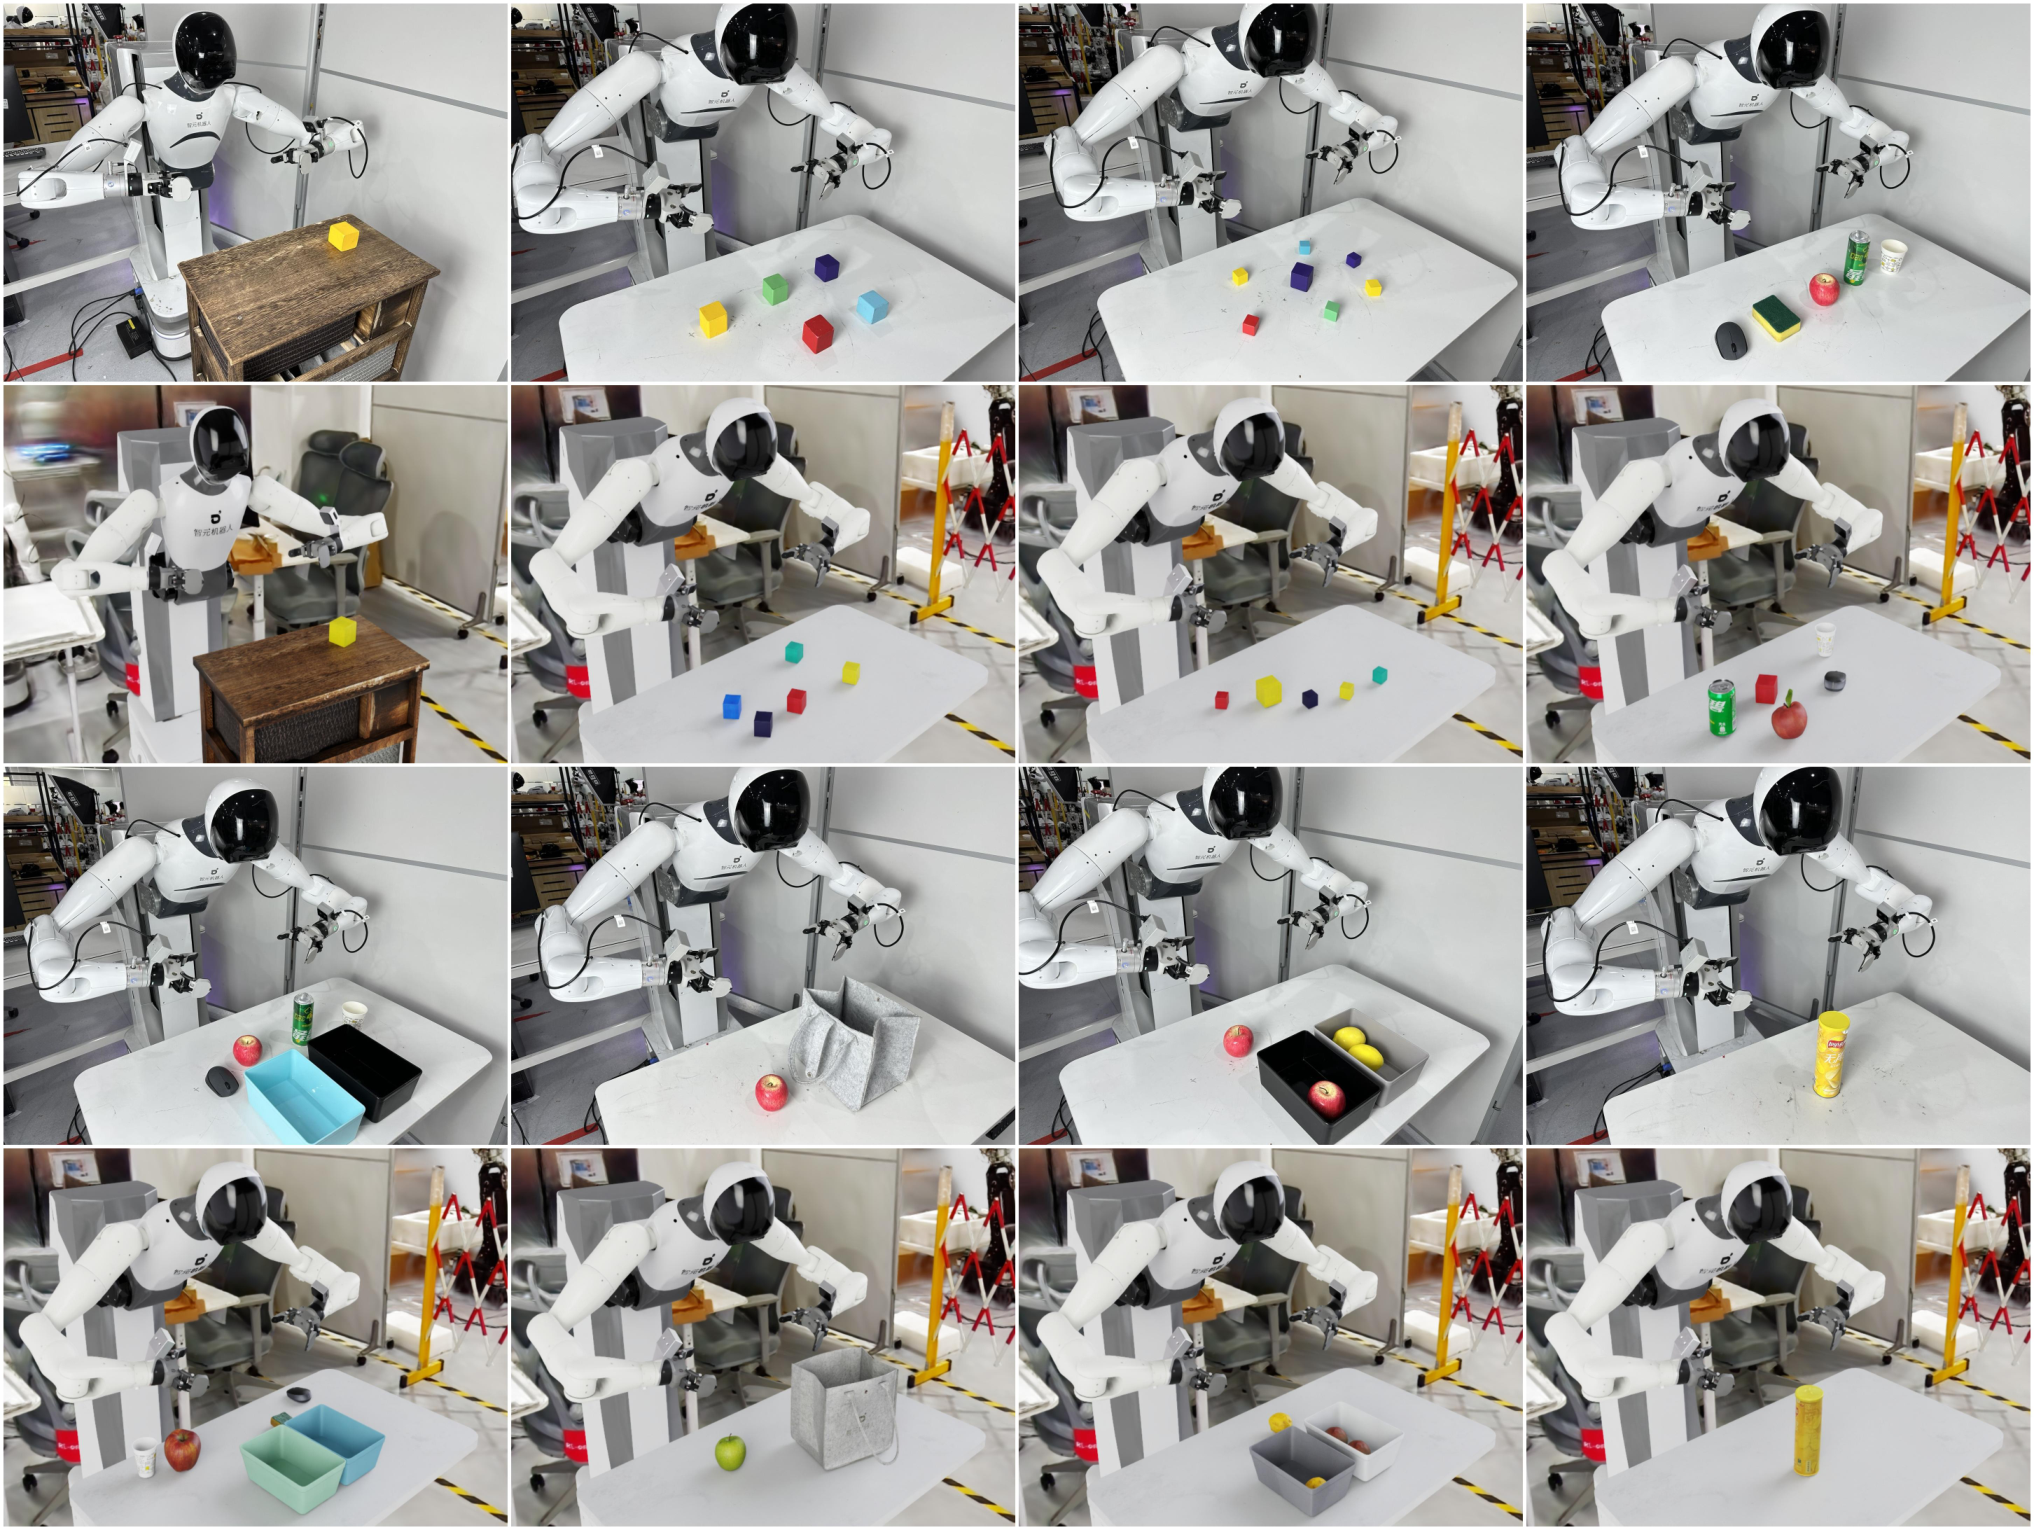
到了 2026 年,机队开始直接服务在线后训练。Learning While Deploying 基于智元 SOP 的部署设施,让 16 台双臂机器人共享经验,在补货、做果汁、调鸡尾酒、装鞋盒等 8 项任务上,平均得分从监督微调的 0.76 提高到 0.95。
仿真的优势是便宜、可控。Genie Sim 3.0 基于 Isaac Sim,用大语言模型解析指令、检索资产、生成场景,积累了 5140 个资产、上万小时合成数据。但单条样本的信息量还比不上真机:同样使用 500 条轨迹时,真机数据的训练效果更好,仿真要扩到 1500 条,四个测试任务才全部超过真机基线。
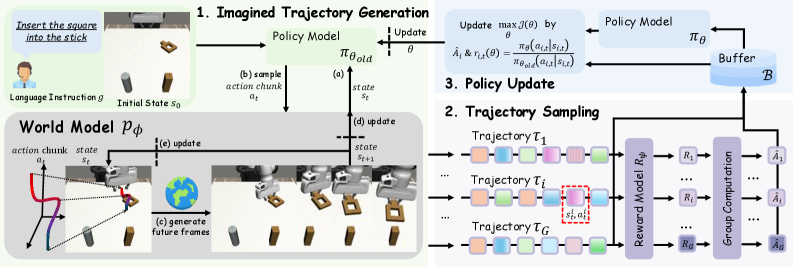
世界模型则把试错搬进了想象。2025 年 11 月的 WMPO 把 on-policy 的 VLA 强化学习放进动作条件视频世界模型,并用策略的真实执行轨迹微调世界模型,让它提前见过策略会犯的错。而 WoVR 针对的是幻觉:策略会钻世界模型的空子,把物理上不成立的“成功”也优化下去,它从关键中间状态开始想象来缩短误差累积,并定期用真实数据更新世界模型。
三种来源各有长短,而目前最可行的路径是取三者所长,例如后面会讲到的 Genie Evolver,已经开始将三者混合使用了。
反馈信号:从手写奖励,到模型自己判断好坏
QT-Opt 时代的奖励靠人设计,用抓取前后的图像差分判断有没有抓到,换个任务就需要重写。
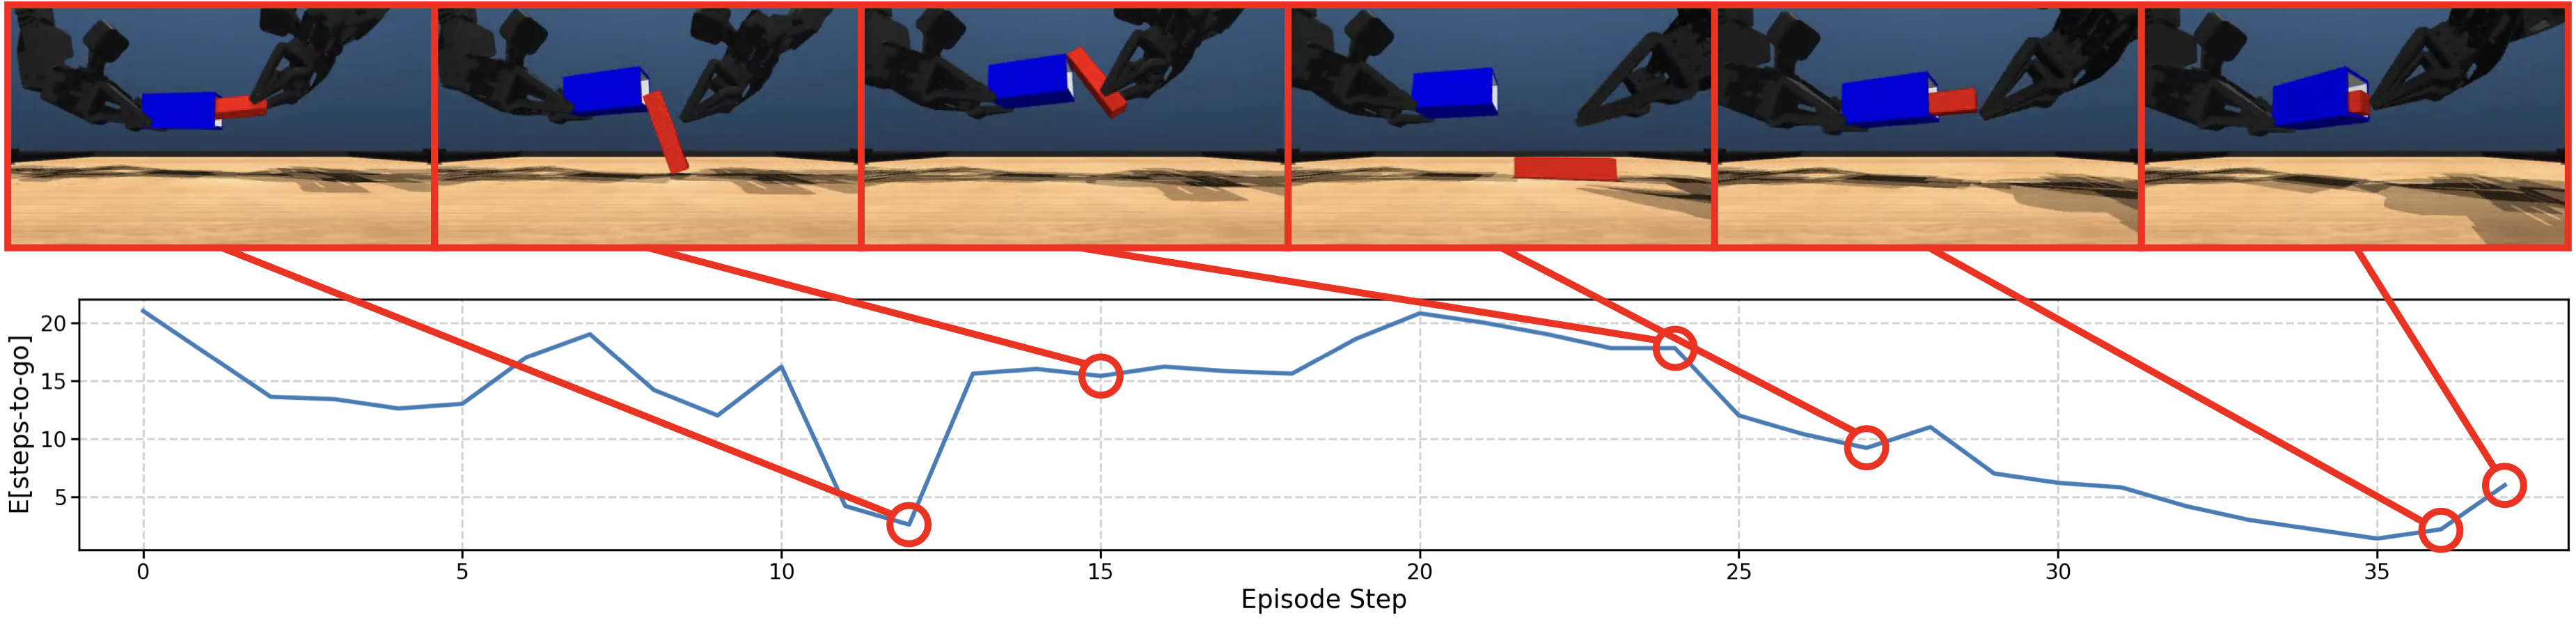
谷歌的 Self-Improving Embodied Foundation Models 让模型在监督微调时多学一件事,即离目标还有多少步,部署时前后两帧的剩余步数相减就是奖励。在 LanguageTable 真机任务上,只多练了约 3% 数据集规模的量,成功率就从六成出头升到 87% 左右。
之后的做法越来越多样。Dyna 用奖励模型估计进度,自动切分机队数据并标注成败,只把罕见失败交给人抽检。智元的 GE-Sim 2.0 用世界裁判逐帧判断子任务成败,从世界模型里筛轨迹做行为克隆,三项任务的平均成功率从 41.7% 提到 56.7%。Physical Intelligence 的 π*0.6 用 RECAP 训练价值模型,把价值变化换算成优势,给动作打好坏标签,在叠衣服、做咖啡等任务上每小时成功次数翻了一倍多,失败率约减半。
这条线的变化方向是非常清晰的:人写规则的部分越来越少,模型自己判断好坏的部分越来越多。
人的角色:从操作员到监督员,再到只判对错
AutoRT 里,一个人可以同时盯 3 到 5 台机器人,人从遥操作员变成了监督员。HIL-SERL 则把人放回训练闭环:机器人卡住或遇到危险时,由人来接管,纠正数据同时进入示范池和 RL 回放池,多项精细装配任务 1 到 2.5 小时就练到接近 100%。
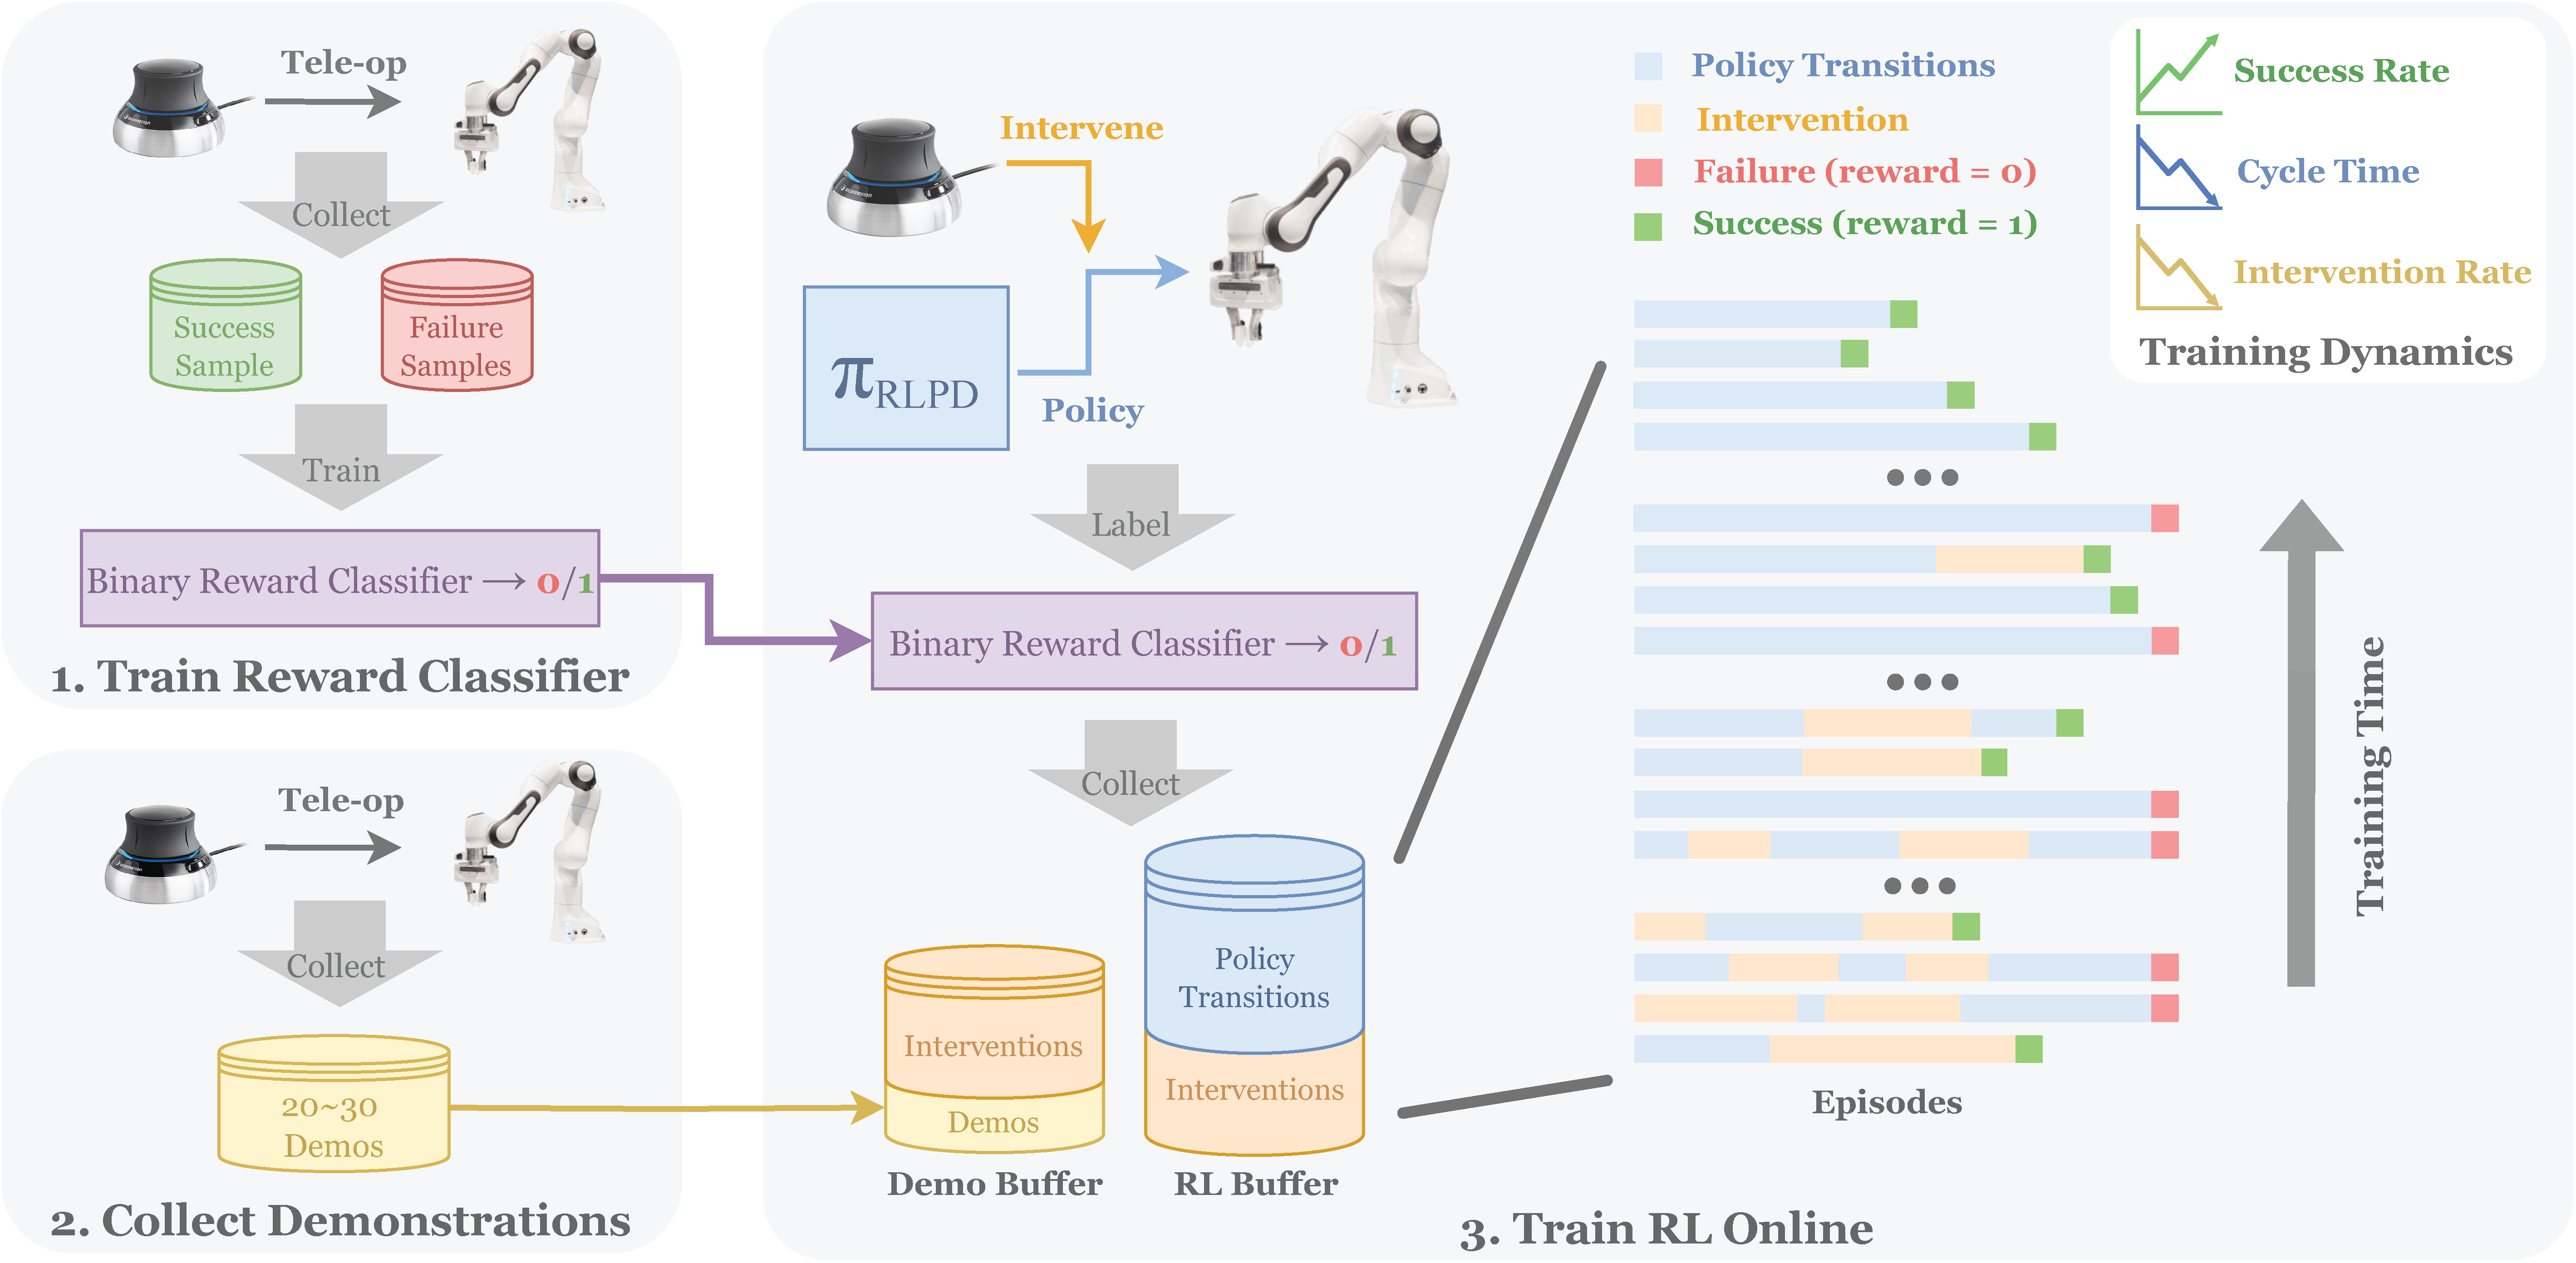
清华大学、智元与无问芯穹近期联合提出的群体经验学习(Collective Experience Learning,CEL)范式,也带来了真机后训练的新进展。在后续训练阶段,系统不再收集新的人工纠正动作,人只负责标记成败、复位环境和维护硬件。
可以看到,人对具体动作的直接干预越来越少。
学习基础设施:从单个学习单元,到共享的训练管线
早期的学习单元是按任务切分的。RoboCat 先用 100 到 1000 条示范为新任务微调出一个专用分支,分支自己练约 1 万次,产生的数据再回流去训下一代通用模型。
智元的 SOP 换成了 actor-learner 架构:多台机器人在边缘端干活,云端中心学习器持续更新同一个多任务 VLA,再把参数异步下发。训练到 80% 成功率,4 台机器人用了 71.7 分钟,而单台则需要 173.6 分钟。今年 4 月的 GO-2 可以支持数千台机器人分布式训练,训练效率提升约 10 倍。
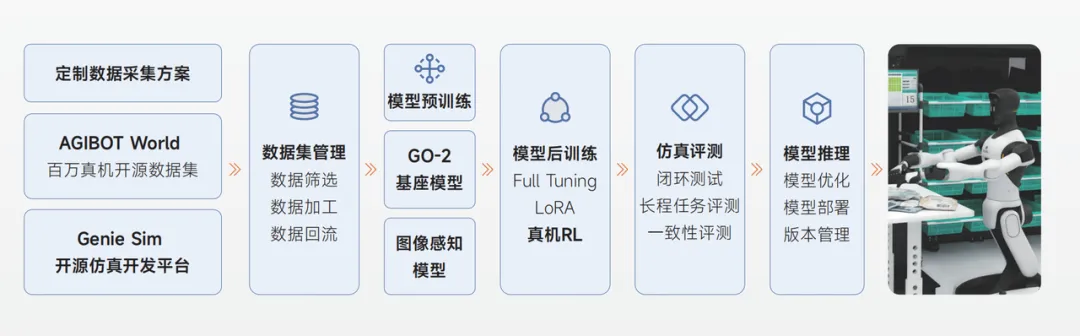
10 月 23 日刚刚发布的 Genie Studio 2.0,把整条管线做成了产品:Flywheel 管从采集、训练、仿真评测到真机部署和异常回流的模型迭代,Agent 管作业编排,Monitor 管机队运维。部署开始变成产品的一项特性。
02
还有哪些问题没解决?数据效率
四类组件都有很多进展,规模也持续提升,但后训练和部署后 Scaling 真正要解决的是数据效率问题:真正有用的经验,往往很少出现。
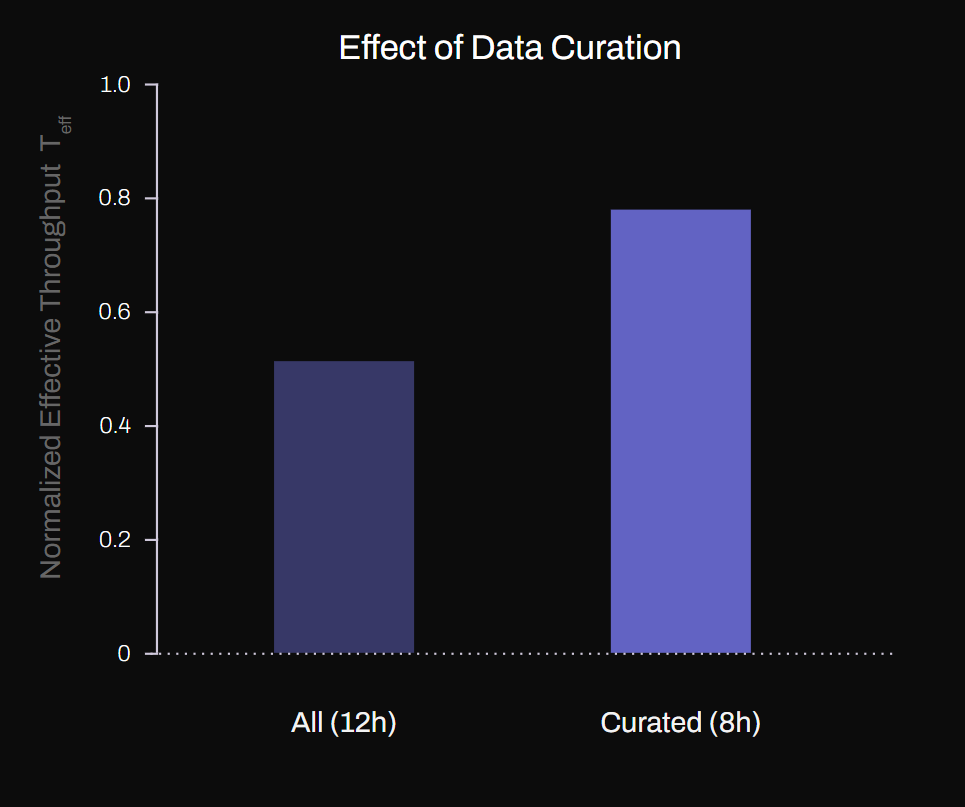
一方面,示教数据经过筛选,Figure 在 Helix 物流场景里就剔除了缓慢、失手和失败的示教,12 小时数据筛到 8 小时,有效吞吐量反而提高了 40%,因为行为克隆会把每个动作都当标准答案。
另一方面,策略越成熟,失败越少,成功率 95% 的策略跑 100 次只留下 5 次失败,而最能暴露短板的正是这几次。更根本的是,模仿学习其实只要回答“这一步该做什么”,失败轨迹恰恰无法提供这个答案。
于是,失败里最有价值的信息被挡在了训练之外,这带来几个问题。
第一,长尾覆盖不足。有研究统计了 19 个技能组,累计训练时长和零样本成功率的 Pearson 相关系数达到 0.80。数据时长仅有16.4小时的 Zip 类技能(一只手扶稳物体,另一只手捏住拉链头去拉),240 次试验全部失败。
第二,失败数据难以利用。没有指令的 play 数据、失败尝试和部署 rollout,在 VLA 常用的模仿学习目标下几乎派不上用场。
第三,信用分配粗糙。失败的轨迹最后只拿到一个 0,到底哪一步出了问题,这个 0 说明不了。今年 10 月的综述《Who Improves the Robot?》还指出,记忆、技能和工作流互相依赖,末端异常可能源于上游,归错了因,系统就会去修改一个本来没问题的模块。
除此之外,补救手段也没有完美的。人工纠正要人一直盯着,机队越大越难;真机探索慢而贵;世界模型有幻觉;自生成数据也会退化。
所以后训练和部署后 Scaling 的核心,是提升数据利用效率。
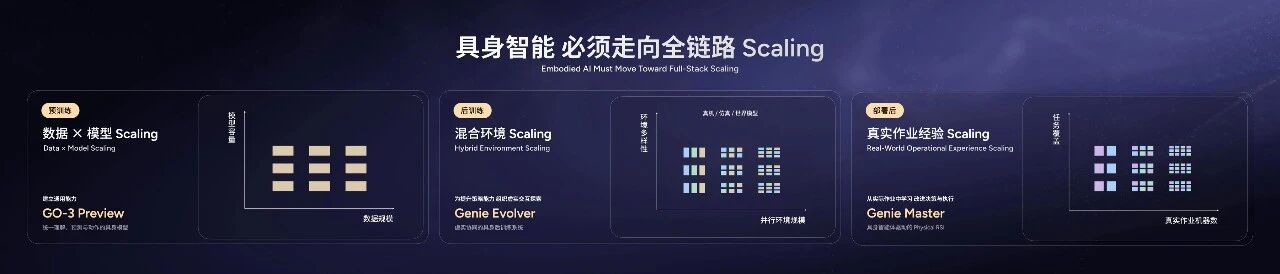
前几天,智元发布了 GO-3 模型,其中的实践值得仔细研究。
03
预训练:GO-3 Preview 让基座模型能利用失败数据
虽然本文的重点在后训练和部署,但预训练的部分也有值得学习的地方。
GO-3 Preview 采用智元提出的 WRAM 架构(World Reasoning Action Model),把任务理解、未来预测和动作生成放进同一个模型,预训练数据中,约九成来自人类第一视角视频。
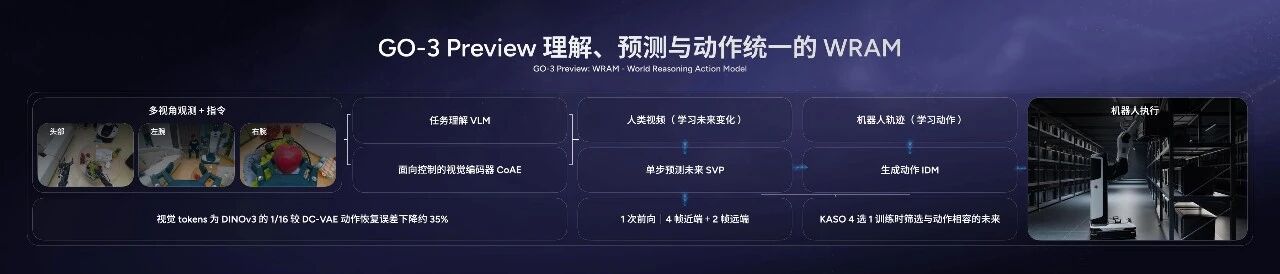
它大致可以分为如下四个部分:VLM 理解任务;面向控制的视觉编码器 CoAE 把多视角画面压成视觉 token,数量只有 DINOv3 的 1/16;SVP 一次前向预测 4 帧近端和 2 帧远端的未来;IDM 根据当前画面和预测的未来生成动作。
这里最值得说的是 IDM。逆动力学目标学的是“从当前状态到之后的状态,对应什么动作”,只要观测和动作对得上就能训练,轨迹成没成功、有没有语言标注都不影响。于是失败尝试和部署 rollout 终于能进入预训练,模型学到的是动作和物理变化的对应关系,也不会被教着去重复失败。
另一个细节是 KASO。同一场景、同一指令往往有多种正确做法,如果预测的未来是一种做法,记录的动作是另一种,硬配在一起训练,动作就会被平均成两边都不像。KASO 一次生成 4 组候选未来,只用和记录动作最相容的那组算损失,不同做法就都能保留。
04
后训练:Genie Evolver,让一次真实经历派上多种用场
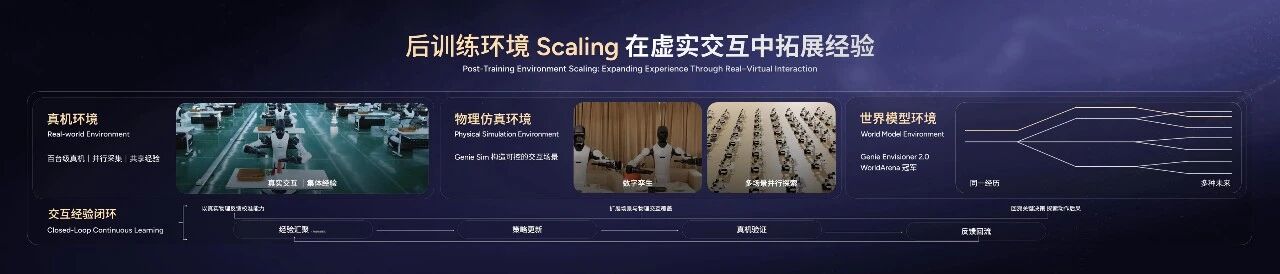
Genie Evolver 是一套分布式混合环境后训练系统:百台级真机并行采集、共享经验,Genie Sim 构造可控场景扩大覆盖,Genie Envisioner 2.0 世界模型回溯关键决策。
三部分的经验经过筛选和动态配比更新策略,新策略再回真机验证,验证结果再继续回流模型训练。
真机:从群体经验中学习
真机后训练首先要解决一个问题:一台机器人积累的经验,怎样帮助其他机器人一起进步?
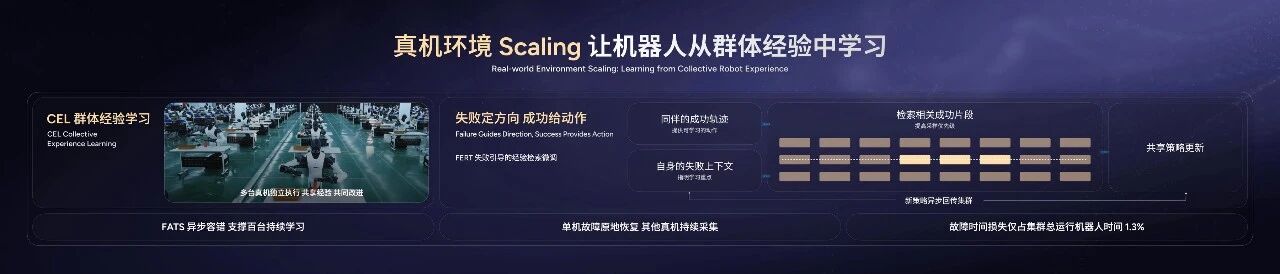
真机部分采用的是 CEL(群体经验学习):多台机器人共享执行经验,用这些经验更新同一个动作策略,再把新版策略返回机队。这样,一台机器人积累的经验,就能帮助其他机器人一起进步。
但把经验汇集起来,还需要决定哪些值得重点学习。团队为此设计了 FERT(失败引导的经验检索微调):用当前的失败找到策略的薄弱环节,再从机队已有的成功经历中检索相关动作,优先用于训练。
以手机包装中的盖盒子为例。一台机器人反复调整盒盖,最后还是没盖上。系统会截取失败结束前的一小段画面和关节状态,去共享的成功轨迹中寻找类似的操作阶段:在相近的物体位置和机械臂姿态下,其他机器人曾经怎样完成盖盒?
找到之后,系统提高这些成功动作片段被抽进训练批次的概率,用片段中记录的动作更新共享策略参数,再把新版策略返回机队。检索负责找到值得学习的经验,训练则把经验转化为策略的能力,使机器人下次遇到类似情况时,更有可能完成操作。
为了让检索结果真正有用,FERT 同时比较画面和关节状态,避免场景看起来相似、机械臂姿态却不同。查询片段会避开失败记录的最后几帧,减少失败标记延迟带来的干扰;匹配时允许动作快慢有所不同,并保留成功片段前后的动作,让策略学到完整的操作衔接。
训练重点也会随新的执行结果调整。某类失败反复出现,对应的成功片段就会获得更高的采样优先级;旧的检索记录影响逐渐衰减,让训练更多关注当前仍未解决的问题。
失败告诉系统该重点补什么,成功提供可以学习的动作。在 FERT 中,成功轨迹进入共享经验池,提供监督训练的动作目标;失败轨迹则提供检索线索,其中的失败动作不作为模仿目标。
这套学习建立在人类示范和多机 HG-DAgger 接管纠正形成的初始能力之上。进入 FERT 阶段后,不再新增专家示范或纠正动作,但仍需要操作员标记任务成败、复位环境。
效果上,最难的多阶段任务手机包装从 79.2% 提到 98.3%,120 次测试的失败从 25 次降到 2 次。手机充电流程从 60.0% 提到 97.5%,插花、叠衣、凳子装配也都有提升。
相同训练时间下,参与学习的真机从 4 台加到 96 台,手机包装成功率从 50.8% 提到 98.3%。
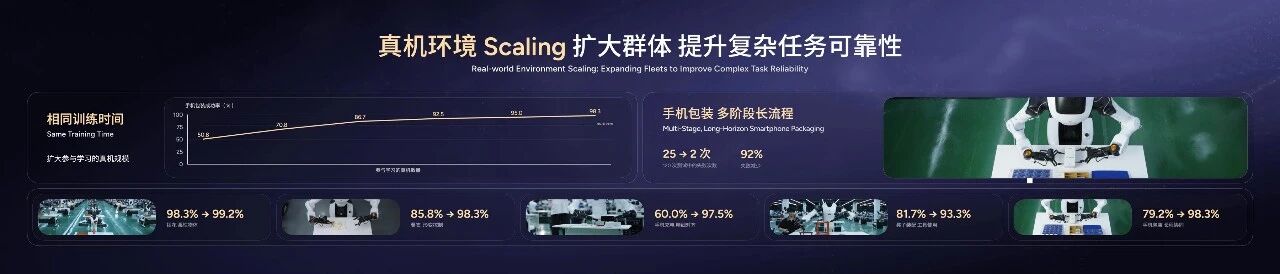
让成百台机器人同时学习,其实在工程上也并不轻松。智元为此配置了 FATS 异步容错系统,单台故障原地恢复,其他真机照常采集,故障造成的时间损失只占集群总运行机器人时间的 1.3%。
世界模型:回到关键决策点,换一种做法试试
真机经验能告诉我们相似情境下发生过什么;世界模型进一步允许从同一决策点尝试尚未执行过的动作,比较可能的后果。
这就是世界模型的特点:一次经历,多种未来。它从一条真实轨迹出发,成功失败都可以,在每个动作块边界保存上下文,随时能回到那个时刻。
回到某一刻后,让当前策略用不同随机噪声采几个候选动作,由世界模型预测之后的多视角画面和本体状态,奖励模型判断结局,结果沿着分叉树回传,决定下一轮在哪里继续展开。
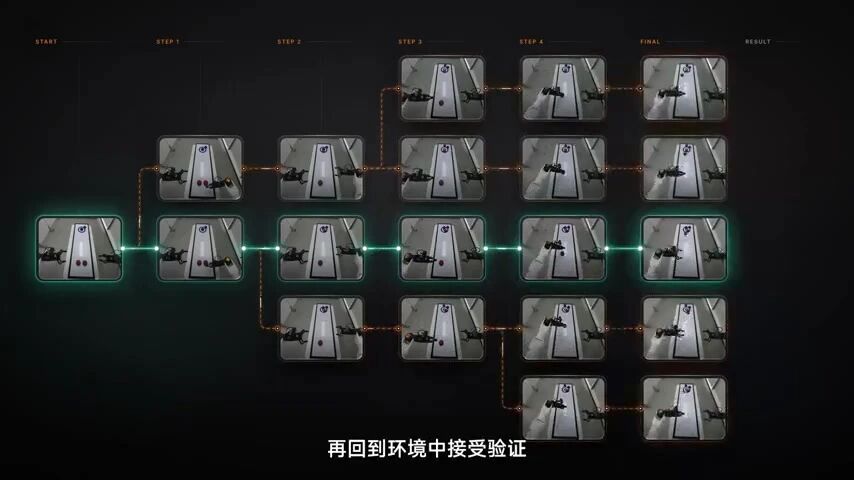
哪些决策值得反复探索,是系统在搜索中逐步发现的,不需要人工逐个标注。有些时刻,尝试不同动作得到的结果差别不大;另一些时刻,不同动作却会带来成功与失败的分化,系统就会围绕这些位置进一步探索。它汇总各个动作分支后续的成功比例,比较同一决策点上不同动作的好坏,再把这种比较转化为质量标签,用来训练策略。部署时,策略以最高质量档作为条件直接生成动作,不需要现场再跑这棵搜索树。
这套方法成立的前提,是世界模型预测的后果足够接近现实。比如机器人推了一下积木,真机上的塔已经倒了,世界模型却预测它仍然站着,搜索就可能把这个动作误判为成功,并用错误结果训练策略。
因此,动作策略和世界模型都需要持续更新,但两者学习的内容不同。策略从动作比较中学习怎样提高成功率;世界模型则用真机实际执行的动作和随后发生的变化,修正自己的预测。一次倒塔的失败记录,也能告诉世界模型:在这样的状态下执行这个动作,塔会倒。
世界模型学准了这种后果,下一轮搜索才不容易把同样的错误当成好办法。
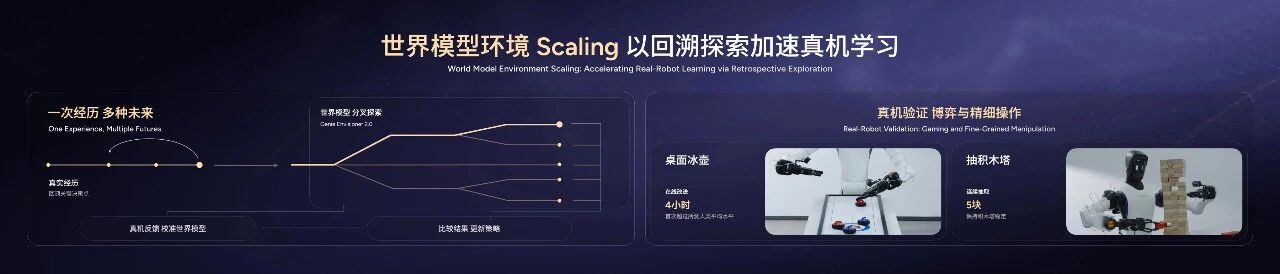
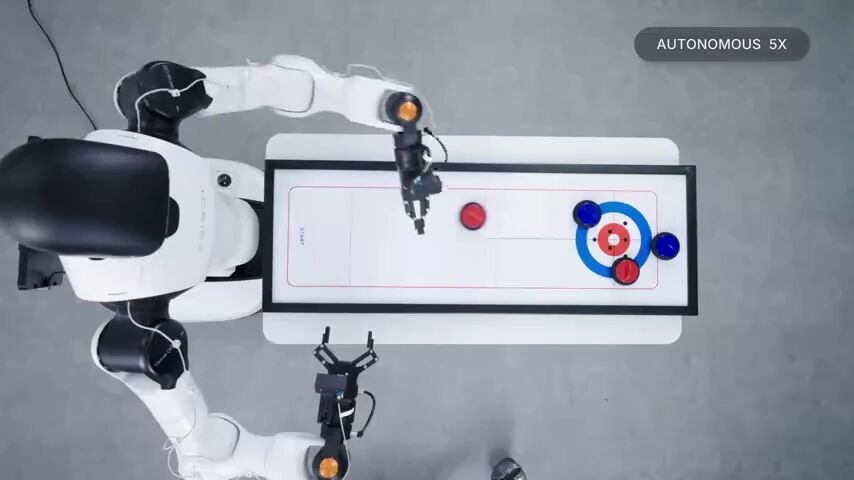
两个任务展示了真机验证的结果。桌面冰壶考验力度和角度,既要撞出对手的壶,又要留住自己的壶,机器人在真实世界和世界模型里练了 4 小时,就首次超过了所测的3名人类参与者的平均水平。训练8小时后,成功率从51.11%提高到64.44%;超过了同样使用GE-Sim 2.0的RISE复现基线的52.59%。
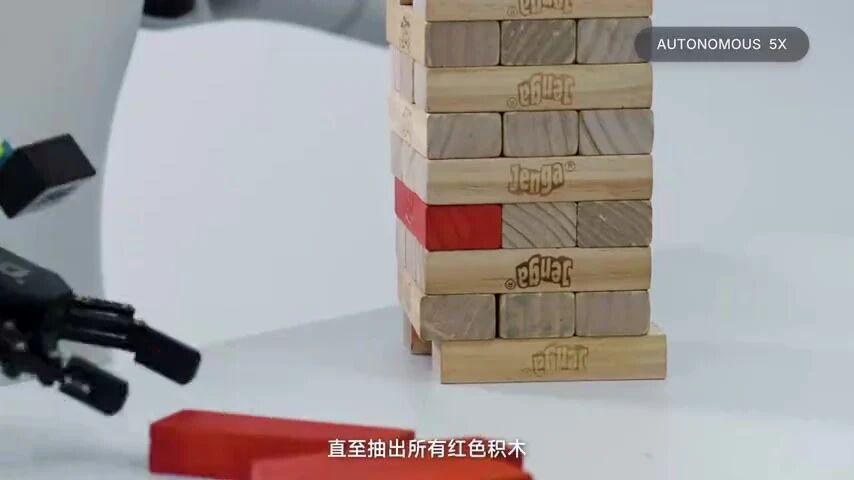
抽积木塔考验连续操作中的适应能力,每抽一块,剩下积木的位置和姿态都会变化,机器人能连续抽出 5 块而塔不倒。
05
部署后:Genie Master,让上岗变成持续学习
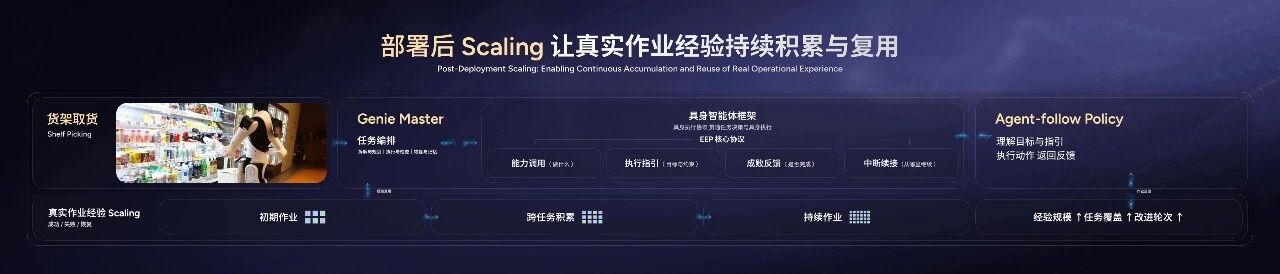
10 月 27 日,智元发布了具身 Agent 框架 Genie Master,这是一套部署后 Scaling 的方案。它首先要让 Agent 和机器人真正连起来,为此,它提出了具身执行协议 EEP,统一了能力、引导、反馈和连续性四类接口。
以便利店挂货为例。挂钩很小,又被标签牌挡住,头部相机看不清。如果 Agent 只说“把货挂上去”,策略拿不到足够信息,失败后的执行状态也无法反馈给 Agent。有了 EEP,Agent 会回溯失败记录,发现是头部视角分辨率不够加上遮挡,于是改为先让左手靠近、用腕部相机补近景,确认挂钩位置后再让右手挂货。
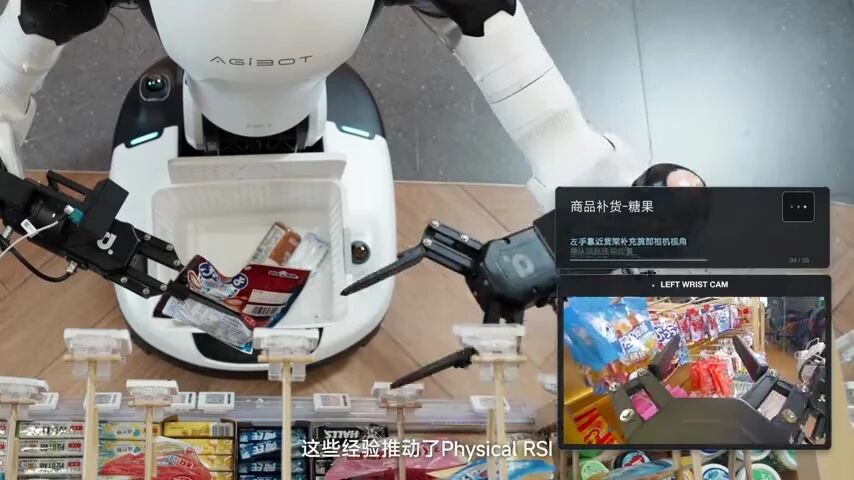
接下来要解决的是如何把经验保留下来,具体分为两个部分。
Harness RSI 不动模型权重和工具接口,机器人随做随记成功和失败案例,每天收工后总结成长期记忆。比如上面挂货的过程,就能变成一条可复用的动作指南。
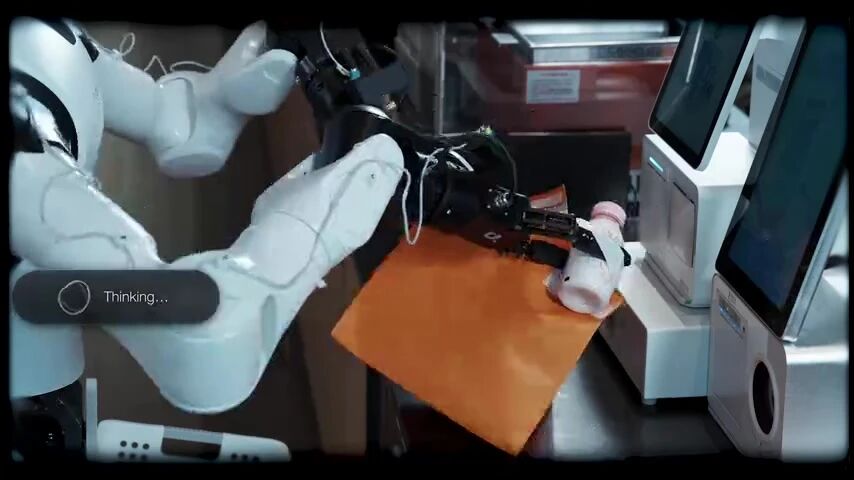
Policy RSI 则对自主执行、接管和恢复过程中产生的数据进行筛选、加权和目标重标,再用监督、模仿或强化学习更新策略。比如打包外卖时夹爪容易被白色提带缠住,Agent 引导夹爪先收回再重新放进袋子,这类恢复数据随后回流训练。
这两个部分可以更进一步,互相提供数据:Harness RSI 让系统减少碰撞,并在物品掉落后恢复任务,产出更有价值的轨迹,Policy RSI 把其中可学习的经验吸收到策略中,策略变强后又带出新的失败和新的记忆。后训练在机队和世界模型里做的事,在真实业务里又做了一遍。
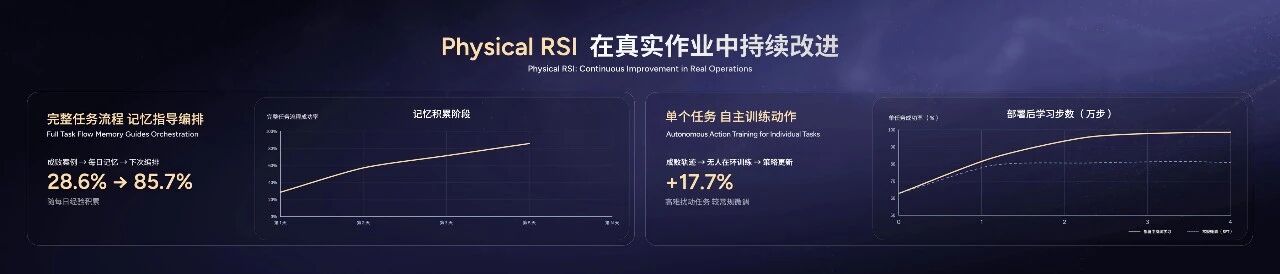
我们拿便利店场景来对比结果。靠每日记忆指导编排,完整任务流程成功率从第 1 天的 28.6% 提到第 5 天的 85.7%;在一项高难度扰动任务上,自主动作训练的成功率比常规微调高出 17.7%。
06
写在最后
回头看,GO-3 这一套全链条 Scaling 框架,是连在一起的一个统一体。预训练让基座能利用失败数据,并保留不同的做法;后训练让一次真实经历同时指导重点复习、提供换种做法的比较、校准世界模型;部署后让每次上岗都留下点什么,留在记忆里,也留在参数里。
做过真机实验的人大概都熟悉这个画面:机器人总在同一个地方失手,你走过去复位,再按一次开始。失败的视频存满了硬盘,进训练集的却只有那几条。动作卡在哪里、为什么会卡、换个做法行不行,这些最有用的信息,大部分都被删掉了。
但是,进入 2026 年,具身智能的考题,已经从会不会演示,换成了能不能部署。
演示,只需要成功一次。
但部署要面对的,是每天成百上千次的执行,以及藏在这里面的每一次失败。
一台机器人能不能留在岗位上,就看它能从这些失败里学会多少。而当失败开始被记住,部署这件事,才有了另一层意思。
机器人每多上岗一天,就多一天的经验。机队每多一台机器,就多一份能被别人检索到的成功。一家门店学会的挂货,可以成为一百家门店的起点。一台机器人摔过的跤,其他机器人不用再摔一遍。
智元在发布会上说,要让真实世界成为训练场。
演示只需要完美的瞬间,而部署需要直面漫长的笨拙。如果说曾经的机器人是在用“成功”证明可行性,那么今天的全链条Scaling,则是让它们在无数次真实的踉跄中完成进化。
机器人在真实世界里经历的每一次失败,终于都成了模型最稀缺的燃料。
推荐阅读

×
右键可直接复制图片