 阅读时间大约7分钟(2403字)
22小时前 算力大战,是具身智能最被高估的一个共识
来源:具身元点
抢算力的,都押错宝了。
先问你一个问题,你觉得具身智能这行,最缺的是芯片,还是数据?
先别急着说答案,我给你摆两个真金白银的事实。
Figure一家公司,2026年9月砸了35亿美元买算力,意向还要扩到60亿,一口气锁了10万张英伟达芯片。智元的彭志辉,一开口就是“我要堆一万张芯片”、“给机器人出三千万道题”。这架势,谁看了不脱口说一句算力大战来了。
大多数人也是这么想的。缺什么补什么,缺算力就抢算力,可我把数字从头到尾过了一遍,结论不是这么来的。
算力这条腿,早就已经在狂奔了。真正拖后腿的,是数据。
你可能会问,数据?互联网上不是要多少有多少吗?具身智能的数据,跟你想的不一样,它爬不了网页,只能一台本体一台本体地磕出来。
算力是钱能解决的,数据不是。这就是答案。
01.
物理AI的算力,到底有多重
先解释一个词。你平时用AI写文案、改代码,它吃的是文字,这种AI我们叫它大语言模型。它的胃口很小,你打一行字,它算一下就行。但机器人不一样,它每动一下手,脑子里都要先算一遍该往哪放、使多大劲。这种会动手的AI,才叫物理AI。
一旦AI开始动手,消耗就完全不是一个级别了。
小鹏给过一个具体数字。它家第二代车,20万辆开在路上,每天为开车这件事要消耗58.8万亿个计算单位。这是什么概念?把全国一天所有文字类AI的用量加一起,才0.737万亿。差了快80倍。当然两边的口径不完全一样,一个是车、一个是全行业,不能精确地除。但方向不会错,动一个动作,比写一句话,费得多的多。因为一个动作里要装进空间位置、力度大小,信息量比一段文字大得多。
这个方向,资本已经用真金白银押注了。2026年9月,做人形机器人的Figure,跟一家算力公司签了份合同,先掏35亿美元,后面还想加码到60亿,最多订10万张英伟达的顶级芯片。这是有史以来,给一家人形机器人公司开的、最大的一笔算力支票。Figure的老板说得更直接:现在卡住公司的,是训练模型要用的数据和算力,数据不够,只能先拿算力把机器转起来。
智元的彭志辉,说法几乎一样。他今年把训练用的芯片堆到了接近一万张,就为了喂饱三千万个训练任务。他把这比作给机器人办高考,还是三千万道题的全国联考。
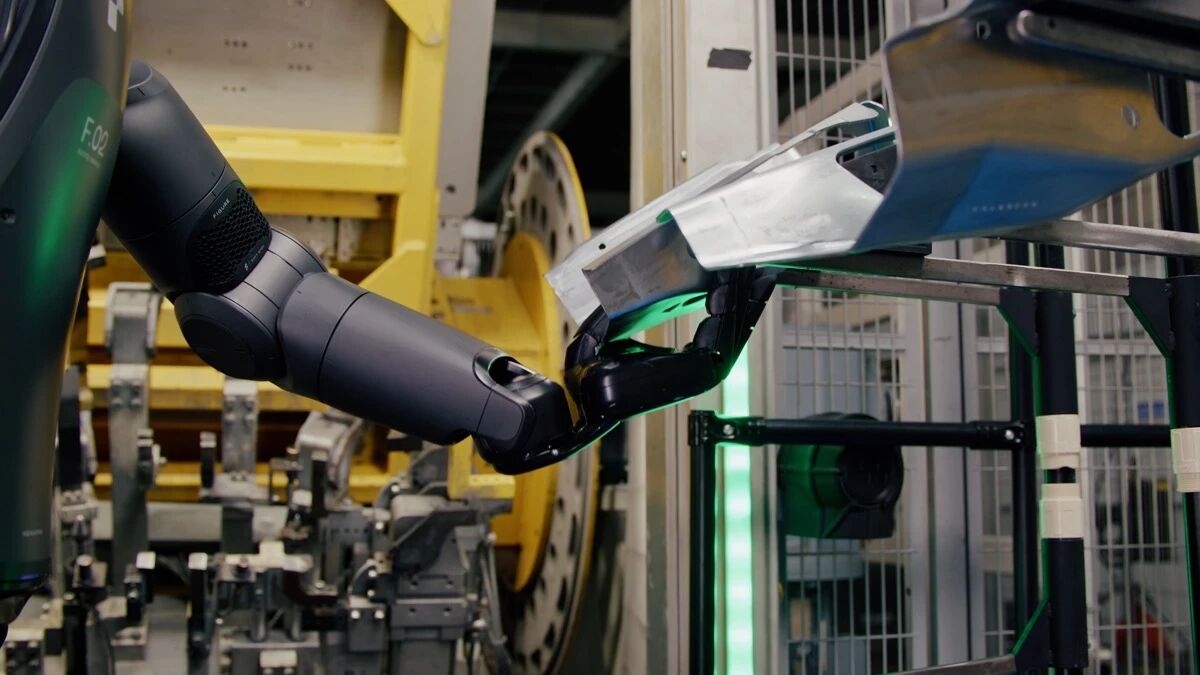
图注:Figure 02在宝马斯帕坦堡车身车间抓取车身钣金件放料。这台机器跑满11个月,放料准确率超过99%,可它的算力成本只占总成本3%到5%。图片来源:BMW Group Press
看起来,物理 AI 就是一场更狠的算力军备竞赛。
02.
可惜,算力不是瓶颈
把量产一台机器人的成本拆开看,军备竞赛这个说法就站不住了。
先看成本。Figure 02在宝马车身车间里,干的是把金属板放上夹具这种活,准确率超过99%,一干就是11个月。
你猜它这11个月里,花在让物理AI变聪明上的钱占多少?算力只占总成本的3%到5%,剩下95%是机器本身的折旧、日常维护、还有保险。另一家工业机器人厂纳诺算得更细,一台抓取机器人身上的算力成本,已经压到5000元以内,只占整机成本的5%到6%。不同的机构口径略有出入,但都落在3%到10%这个区间里。
一台已经能量产的机器人,芯片根本不是它花钱的大头。真正贵的,是从零开始训练一个会干活的模型。有测算说,完整训练一套机器人的大脑,要烧掉200万个GPU小时。GPU小时这个词不好懂,你可以简单理解成一块顶级芯片连轴转一个小时。折算下来,光算力就要上亿元人民币。算力最要命的地方,不在造机器人的时候,而在教机器人学本事的时候。
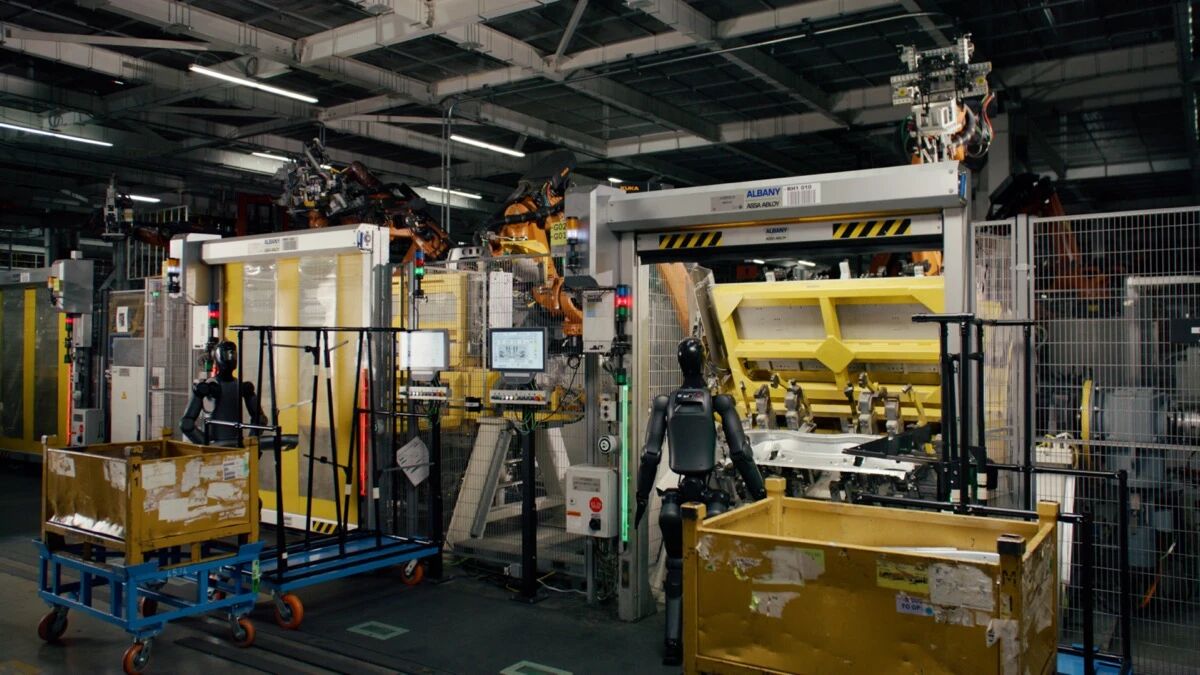
图注:斯帕坦堡车身车间里,人形机器人和六轴工业机械臂各干各的。机器人负责把钣金件放上夹具,焊接和搬运交给机械臂,谁也替代不了谁。图片来源:BMW Group Press
再看训练规模,结论更让人意外。独立研究机构Epoch AI在2025年8月发了一份分析,标题直接叫《算力不是机器人操作训练的瓶颈》。它把历年来训练机器人的算力,和训练最前沿大模型的算力摆在一起比,结果很扎眼,最大的机器人模型,用的算力只有同期大模型的1%。
一边是Figure砸35亿美元买算力,一边是Epoch AI说机器人算力只占大模型的1%。这两句话看起来打架,说的是两码事,Epoch讲的是单次训练花得不多,Figure砸钱是因为要反复训练、持续迭代,一年年累积下来才贵。合在一起看,算力这扇门早就被推开了,卡住人的不在门口。
03.
真正缺的是数据
Epoch AI那个1%的差距,根源不在芯片,在数据。
大语言模型能吃掉整个互联网的文字,一毛钱不花,因为字就在那摆着。具身智能没有这个便宜占,网上不存在随手就能下载的一亿条抓取轨迹。一个机器人要学一个动作,得有人握着它、带着它,真实地走一遍。一条轨迹就是一次真实的时间,不能快进,不能重放,只能一次一次地踩。
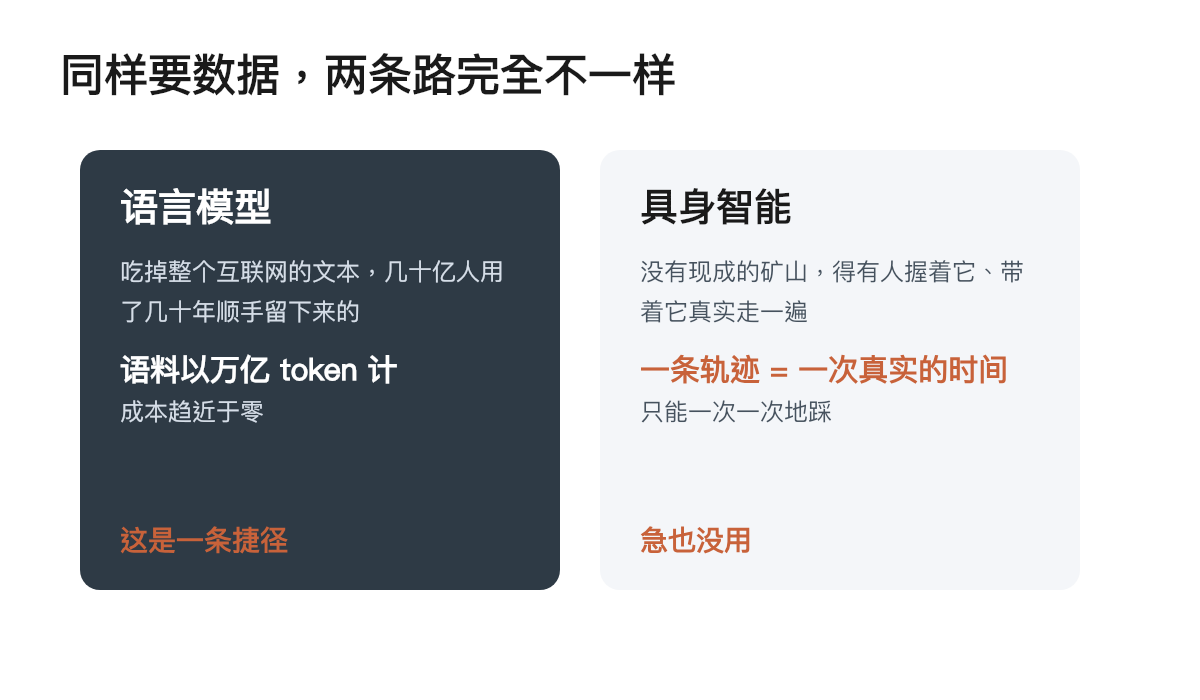
图注:同样需要数据,语言模型踩在互联网这座现成的矿山上,具身智能只能一条轨迹一条轨迹地踩。图片来源:依据本文公开数据绘制
这个差距有多大?把两边最丰富的数据集摆在一起,一眼就能看清。
具身智能这边,智元把自己采集的数据开源出来,一共100万条轨迹。另一个全球最全的机器人数据集,聚合了22种不同的机器,加起来也就100万到140万条,已经是全世界能凑出的极限了。
语言那边呢?是拿万亿来数的海量文字。百万条对上万亿,中间差着好几个数量级。而且具身数据还有个毛病,它认身体。一台机器人学会的本事,换到另一台不同型号的机器上,常常就失灵了。怎么让技能跨着身体通用,到现在也没人解出来。
数据稀缺这件事,资本已经用另一种方式在投票。做数据标注的Scale AI,Meta 2025年6月以143亿美元入股,估值推到290亿美元。国内做具身数据的独角兽光轮智能,估值20亿美元,2026年一季度新增订单5.5亿,超过了2025年全年。
GPU可以下单就买,数据只能一台本体一台本体地采。钱买不到的东西,才是真稀缺。
04.
两条腿在抢跑
算力这条腿在确实狂奔。机器人动个手要算的东西,比写一句话多出好几十倍,Figure一家就锁了35亿美元的算力,科技巨头一年的资本开支冲到近7000亿美元。钱和卡,这条腿都不缺。
数据这条腿还没学会走路。最丰富的真实轨迹,不过百万条,跟语言模型吃掉的文字根本不在一个档次,而且每一条都要靠真机器一点一点踩出来,成本怎么也压不下去。
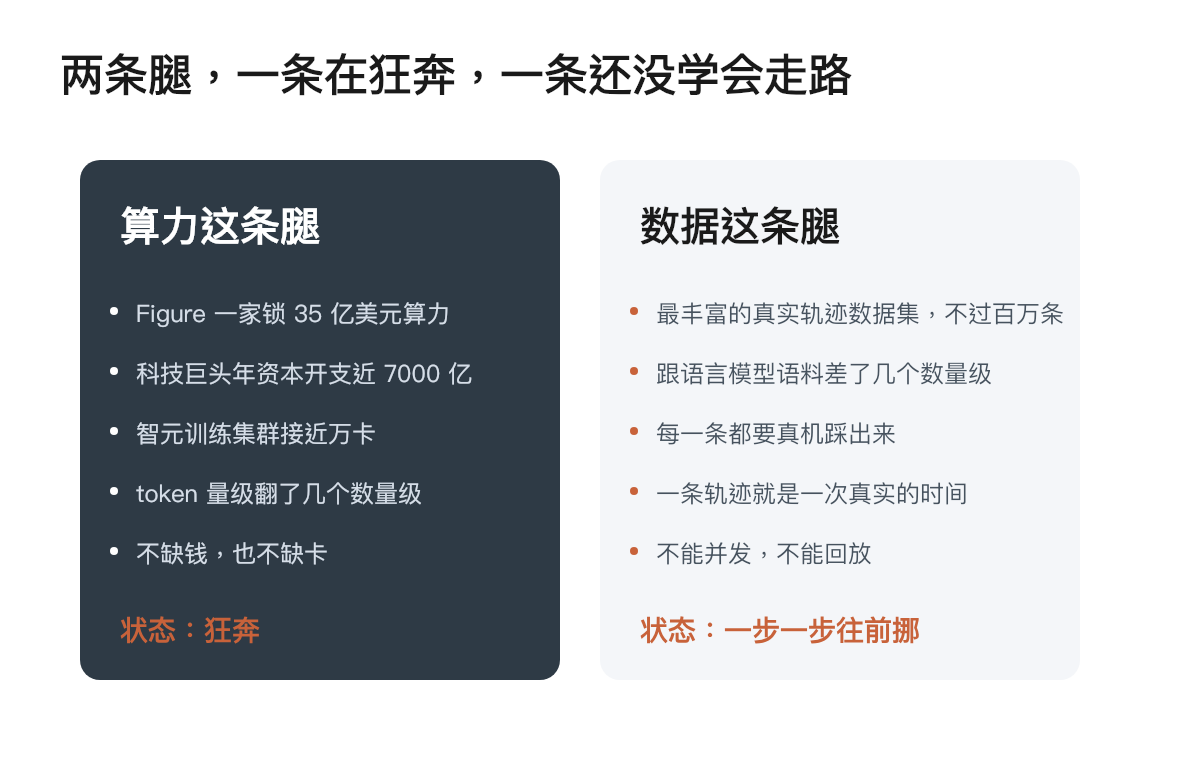
图注:算力这条腿在狂奔,数据这条腿还在原地,两条腿的差距就是物理AI和语言模型的差距。图片来源:依据本文公开数据绘制
两条腿的差距,就是物理 AI 和语言模型的差距。语言模型是先有海量的字,才练出会说话的模型;物理 AI 反过来,得先造出身体,身体才能采数据,采够了数据才能长智能。顺序反了,整个滚雪球的过程就转得慢。
这个慢,不是缺钱能解决的。互联网的语料,是几十亿人用了几十年,顺手留下来的。具身智能的数据,没有这个捷径,它得靠人一条一条地踩,踩过的那几秒钟,就是它拥有的全部。
别再问物理AI是不是算力之争。买GPU的钱已经有人替它付了,但没人能替它踩出那几百万条真实世界的轨迹。算力已经跑出去了,数据只能一步一步往前挪。
急也没用。这就是这件事本来的样子。
推荐阅读

×
右键可直接复制图片