 阅读时间大约10分钟以上(4141字)
15小时前 当大家都有百万小时的预训练模型后,什么才是壁垒。
来源:豆包
通过部署拿到的交互数据,才是真正的壁垒。
作者:天南 出品:天南具身公园
最近Ego的采集,已经深入18线小县城。
真的是一场为了具身的预训练大模型的全民大作战。
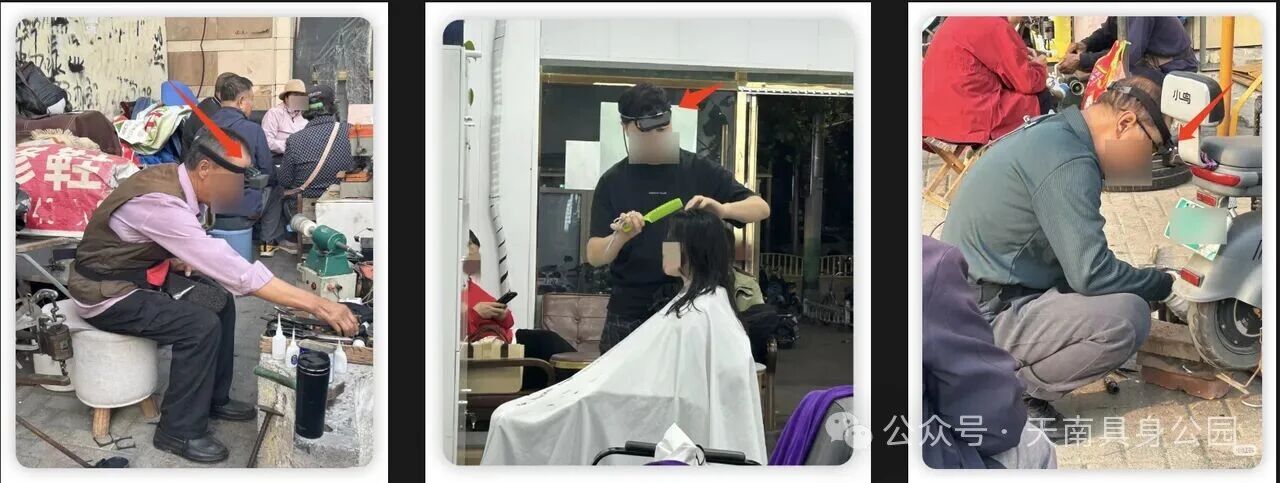
网上看到的各种ego数采。
沿着市场化的思路往下推演,大家获取预训练模型训练数据的成本和门槛会持续变低,那接下来ego数据会发生什么样的事呢?
1)私有化场景变得越来越贵(宁德、海尔等产线),即使数据量很少,但依然很贵。
2)形成了部署态数据飞轮,这部分数据不对外公开,参考自驾新能源车厂们。
那就会收敛出来模糊的结论:
预训练的数据不再稀有,但进到后训练和部署后逻辑就不一样了,部署越多,场景资产越丰富,壁垒越深。
前几天看到的智元Go3-Preview发布,听说数据就有百万,类似WAM架构,年底就要开源。
To be honest,百万小时的模型说开源就开源,还是非常有魄力。
以及再结合我们还看到一个百台真机部署数据飞轮的事情,按每台百万量级粗估,这支舰队接近一个亿的真机资产。
这个时间点直接上大规模真机部署思路的公司,除了智元应该没有第二家。
花这么大功夫做这件事,我想智元应该对「什么才是数据真正壁垒」这件事非常有心得。
其实不仅仅是数据未来布局上,以及在算法,还有多机调度infra等系统上肯定有非常多的KnowHow。
所以我们找到了这次的负责人,分别是智元具身研究中心副总裁任广辉老师,以及带着百台真机做在线学习的清华于超老师,聊了一个半小时。
在这个过程中,我们也获得了验证了这个非常重要的KnowHow:
静态采集的数据,很多可以花钱买到,通过部署拿到的交互数据,才是真正的壁垒。
今天把聊到的东西,和我们自己的一些判断写下来,也希望能够让大家明白未来多机部署的思路。
Enjoy~
机器人数量,可能是第三条 scaling 的路。
过去几年,具身的 scaling 基本就两条路:
1)scale 数据,从几千小时遥操到百万小时无本体数据
2)scale 模型,从 π 的 3B 到现在国内的 50B、百B。
那其实很容易想到第三条路:
除了数据和模型之外,就是在部署的情况下,机器人数量增加之后,看效果是不是能够持续地 scaling 上去。
这个想法其实不新鲜,自驾早就这么干了,特斯拉也想在人形上再干一遍。
但三家的做法差得挺多,我们也收集了一些资料。
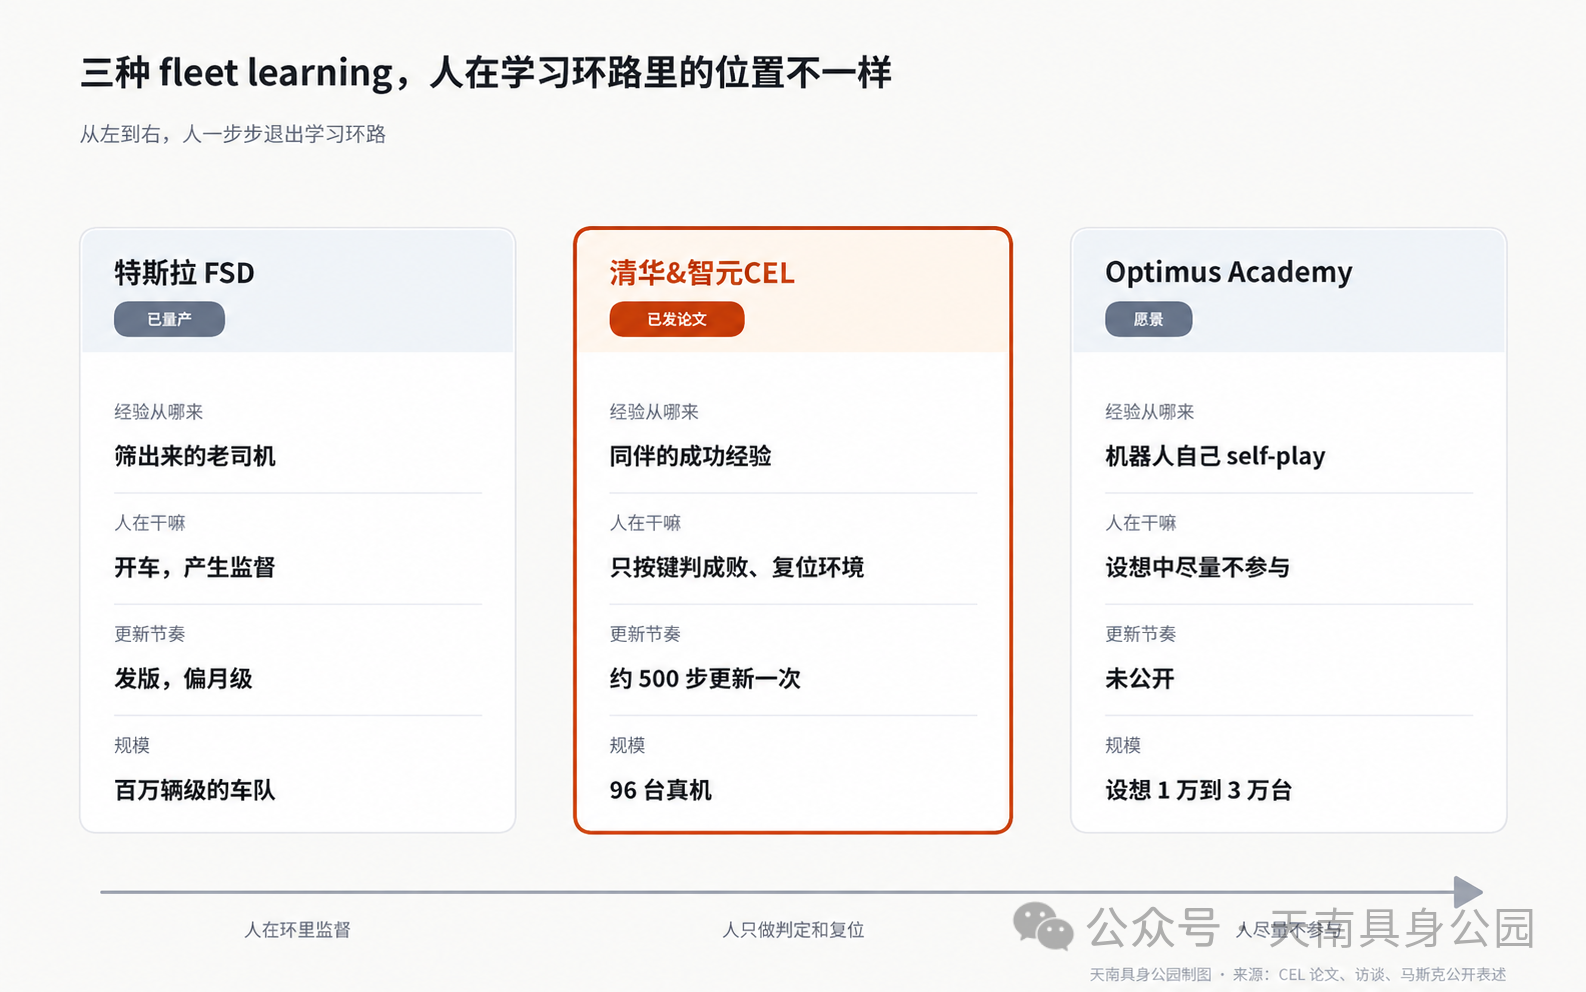
智元任广辉老师之前有自驾背景,我们也讨论了这三种不同的方式,他讲这个区别会讲得很透:
任广辉:智驾里边,每家车厂都卖了几十万辆车,然后在里面筛 TOP 5% 的老司机,有没有重刹、平不平滑,很多指标来判断开车水平。
经历过一轮筛选之后,这些老司机的开车轨迹就会一直回流给算法来学习。
问题在于,机器人其实没有老司机。
于超老师也提到,智元已经是他们合作过体系化管理最强的公司了,但在里面找能把任务全部稳定做好的数采员,凑不齐 8 个人。
人是无法规模化的,特别是专家无法规模化。
所以 CEL 换了个方向:尝试向同伴学。
再看 Optimus Academy。
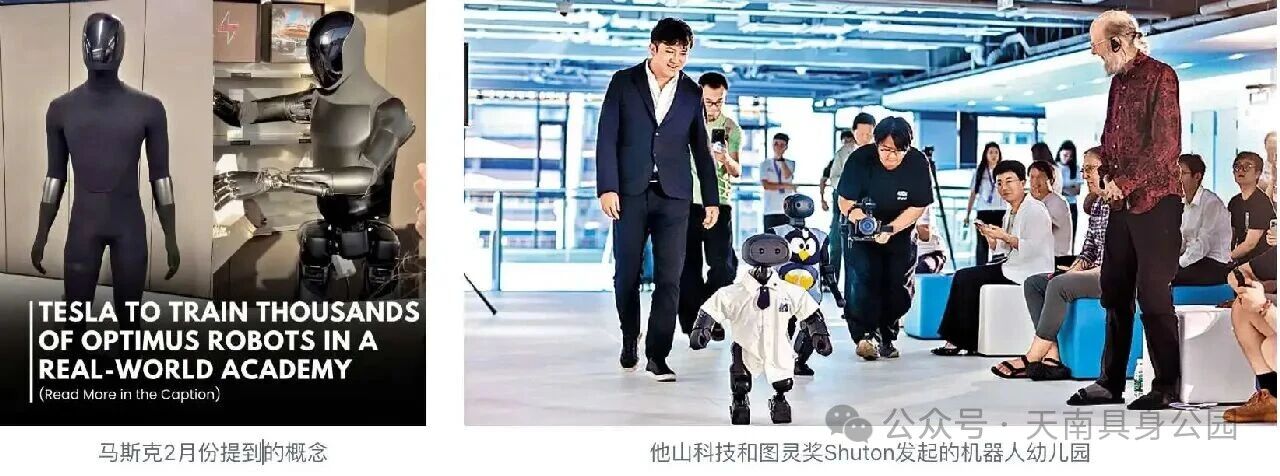
马斯克在财报会和 Dwarkesh 的播客里都聊过:至少一万台,可能两三万台 Optimus 在真实世界里做 self-play,再配合仿真里数以百万计的机器人。
这两个方向和 CEL 是一致的:让机器人在部署态里,用自己的经验把自己变强,把人从学习环路里慢慢拿出去。
区别在于,Optimus Academy 目前还是愿景,self-play 也更偏从零探索;而清华和智元的CEL强调需要人类经验先把成功率拉起来,再让群体接力。
于超:学习智能增长的最速曲线,就是先去向你能找到的最高智能的人去学习,把他蒸馏了,没有什么可蒸馏了,再去蒸馏你的同伴。
我们的判断是,两者终点一致,但今天这个时间点,CEL 走的是一条更现实的路。
还有一点跟最近的风向有关。
这一年大家对真机数据的态度一直在往下走,我们在访谈里也专门问了,任广辉老师的回答我觉得是这次最有行业价值的一段:
任广辉:UMI 也好,Ego 也好,构建了非常好的预训练。但有了冷启动能力之后,可靠性的数据必须是你的本体在真实作业中交互产生出来的。
静态采集的数据,很多可以花钱买到,通过部署拿到的交互数据,才是真正的壁垒。
无本体数据把模型拉到七八十分,剩下二十分的可靠性,要靠部署的真机一点点滚出来。
特斯拉自驾跑得快,也是因为海量的人在帮它开车,数据源源不断回流。
CEL 的核心思路。
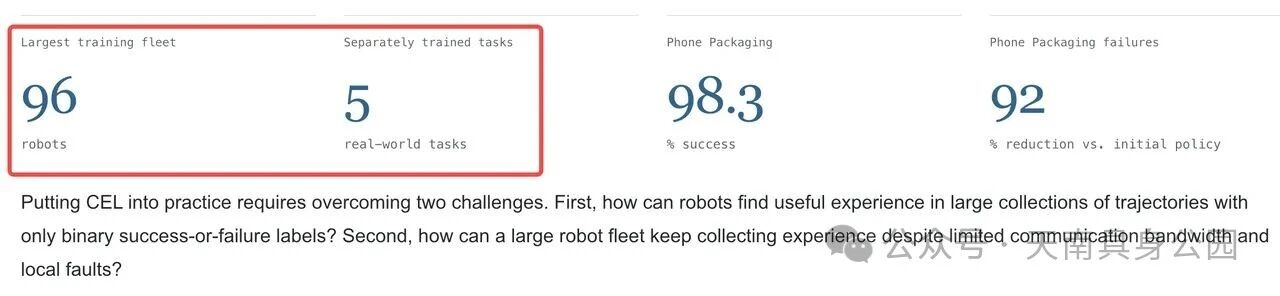
论文叫 Learning from Fleet Experience。
清华、智元和无问团队合作,方法叫 CEL,群体经验学习。
图源CEL主页。
于超老师先整体划了条线:零样本泛化是预训练的事,后训练要的是可靠性。成功率要到 98、99,工业场景要几个 9。
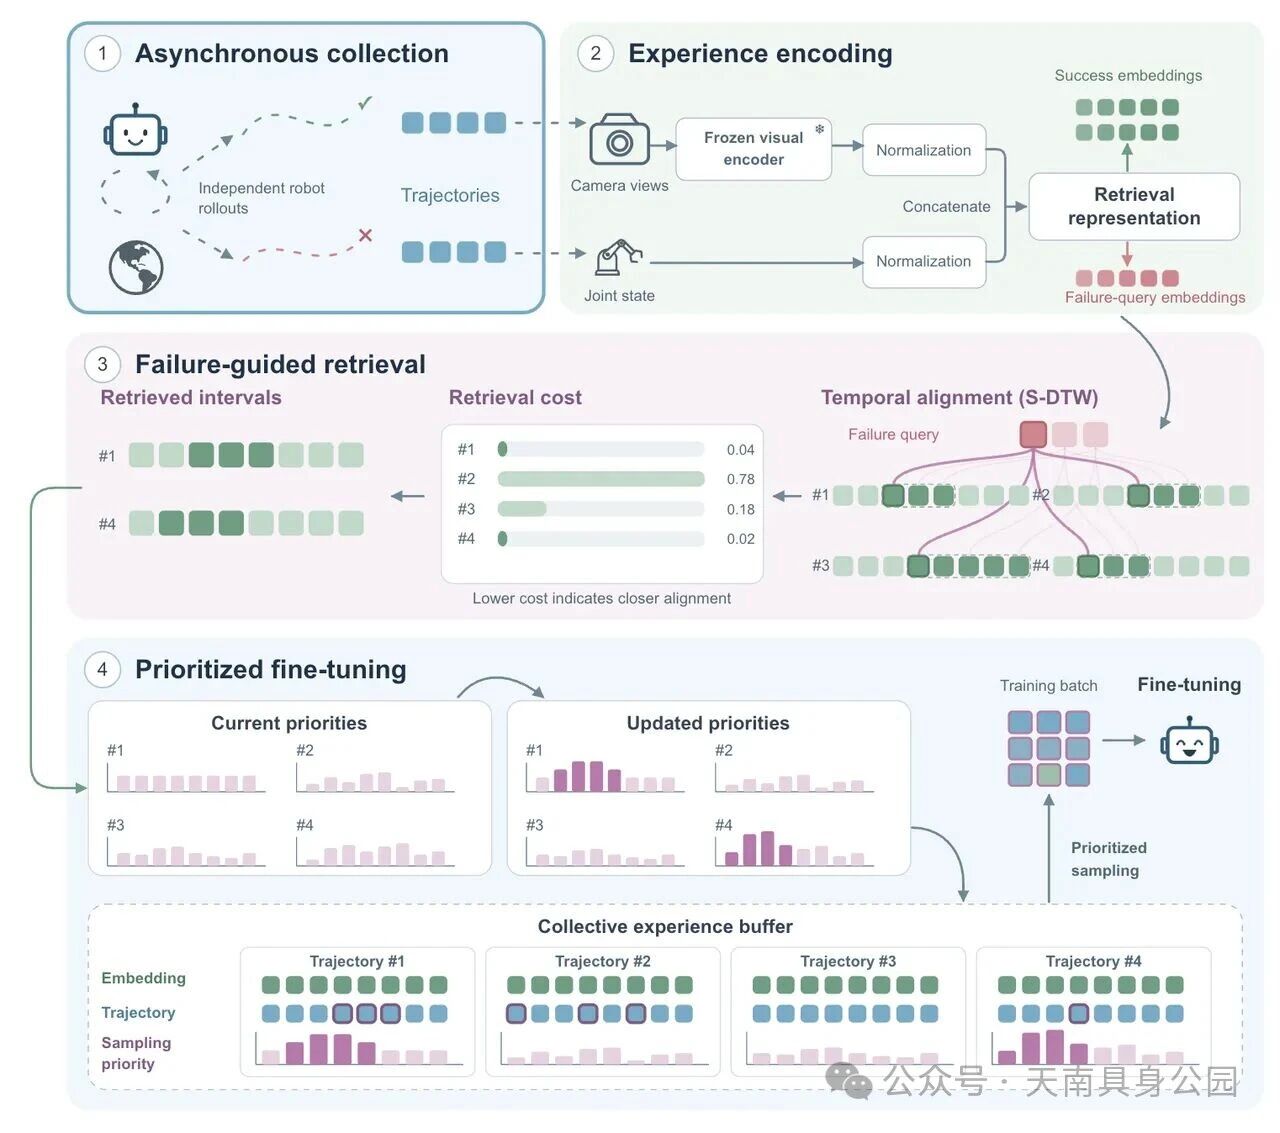
CEL 的流程上不算复杂,拆开就几步:
1)先用专家数据训一个初始策略,成功率要先过 50%。
2)部署到 96 台机器上干活。人不再遥操,只按键告诉系统成功还是失败,再把环境复位。
3)一条轨迹失败了,就拿失败时的上下文,去全体机器的经验池里检索相似的成功片段。
4)用这些成功片段里录下的动作做监督学习,更新策略,再下发。
CEL 整体流程图。
你可以理解成:哪里不会,就去看同伴在差不多的情况下怎么做对的,照着学。
于超老师给了个比喻说是点读机,哪里不会点哪里。
我接着问是不是 RAG 的思路,两位老师给了肯定的回答。
而且方法的每个细节背后,都是试过复杂方案后的朴素选择:
只打成败标签:检索类方法对标签错误很鲁棒,对的标成错,最多再检索一次;错的标成对,后面还有别的对的。以后换成能自动复位的流水线,上个八成准的奖励模型就够用。
不学 critic:他们试过用 value model 定位错误片段,规模一大反而不稳定,最后走了最朴素的 critic-free,而且规模上去后 credit assignment 的问题自然缓解了。
更新频率有甜点区:太慢,攒的经验已经学过了;太快,上一个模型没学会下一个又来了。最后定在大约 500 步一次。
交流的过程中,于超老师是这么解释的:“自古以来能够 scaling 的方法,就是最好的。监督的还是强化的,以及是不是 fancy 的词并不重要。”
广辉老师则分享了另一个视角:“如果没跳出来,确实可以设计非常多人类设计的东西,划分 stage、做精细。但为了解决主问题,你设计了非常多支线问题,又花很多时间解决支线问题,那就又把问题复杂化了。”
然后还有一个点,乍一看会觉得有问题的。
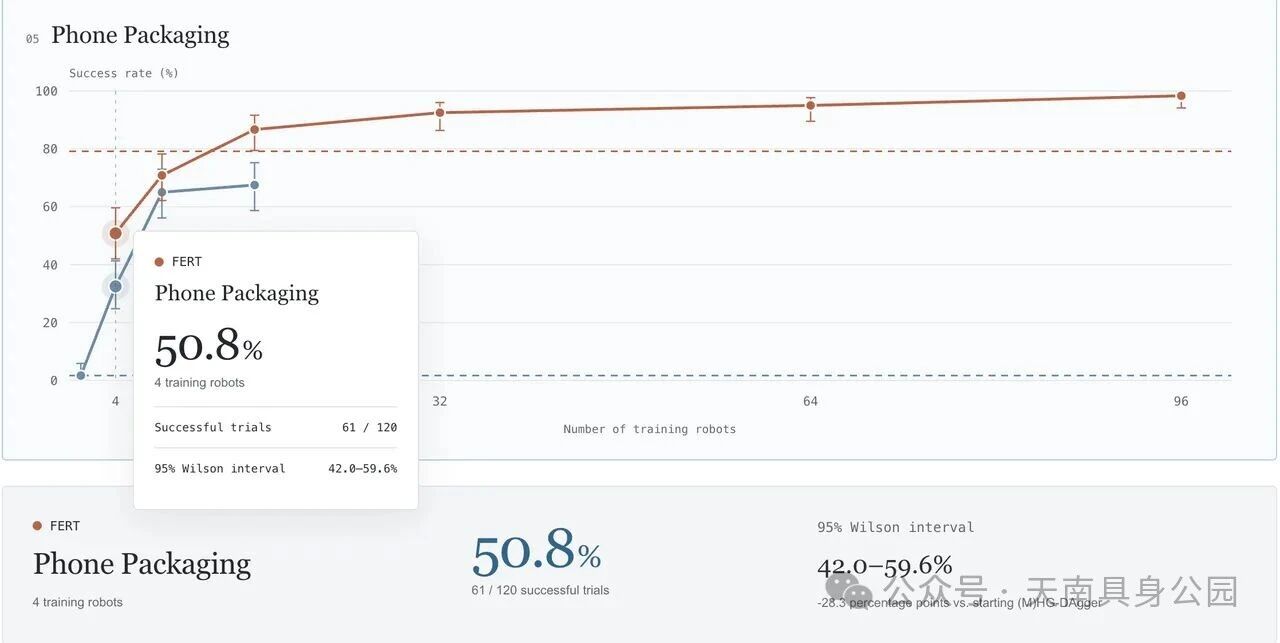
手机打包任务初始策略 79.2%,4 台跑完是 50.8%,比初始还低;16 台 86.7%;96 台 98.3%。
图源官方blog,手机打包的成功率曲线。
我当时也问到了这块。
于超:最开始给这个方法分了 4 台机器人,咋跑咋不 work,我们就放弃了。有一天排期出了点问题,空着一些机器人,说死马当活马医吧,拉起来跑一下,嘿,work 了。当时我们就蒙圈了。
既然效果做出来了,原因就可以解释为群体学习有一个规模门槛,过了门槛,集群经验才能取代人类经验。
这也意味着,小公司拿四五台机器大概率复现不出来,方法本身没问题,卡住的是规模。
其他的实验结果,大家也可以看看官方的 blog。
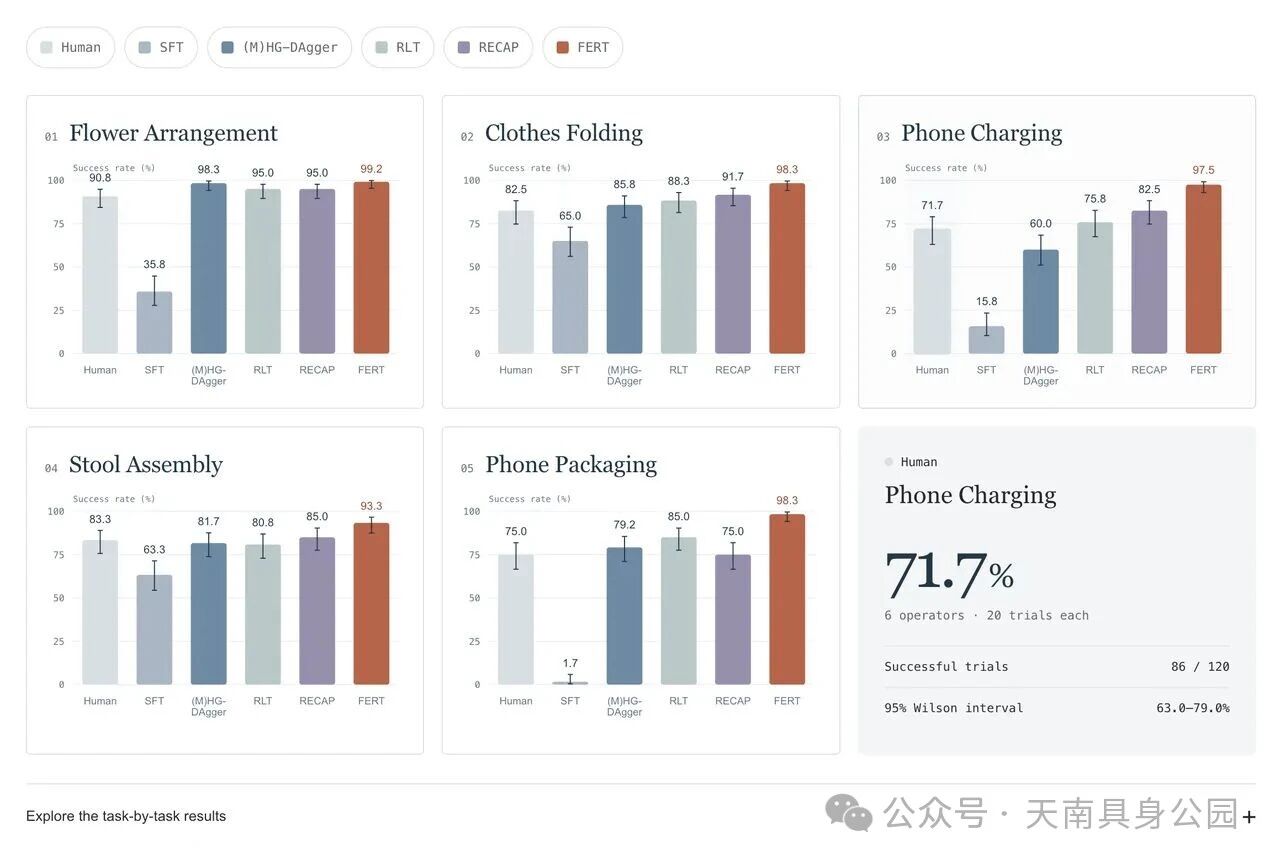
CEL 方法的边界也再强调下,初始的成功率大概要过 50%,低于这条线还是该先把人蒸馏好,不然没办法做后面的步骤。
百台不是一台乘以一百。
比起算法,我其实更好奇 infra。所以也请教了一些细节的信息。
1)每 22 分钟出一次故障。
于超老师他们借了 GPU 集群的思路,叫 Robot as GPU:让机器人像 GPU 一样被调度、能热插拔,在实现的过程中还借鉴了无问团队在算力基础设施的技术灵感。
于超:这次 96 台的实验里,每 22 分钟就会有一次故障。
有一次是同学们在场地来回跑,把电源线踢掉了,那一排机器人哗全部下线了。
还有没电的、触发安全保护僵住的。在线台数最低掉到 80 台左右,训练一次都没中断,故障导致的有效时间损失只有 1.3%。96 台一共跑了 9834 个回合。
2)推理放端上还是云上?
两套都做了。
推理在端,用稀疏压缩每次只更新约 4% 的参数,云端只发给一台,再由它广播给其他机器。
推理在云,靠专线加动态 batching。论文最终选了云端推理,实测下来会稳一些。
但毕竟之前没人这么搞过,他们也专门做了很多的工程。
先把整个场地做成了模拟器,定好 worker 比例、带宽、GPU 数再上真机,图传压到几十毫秒,诸如此类。。。
3)机器一致性,是看不见的门槛。
任广辉:学术界有几个比较火的平台,它不是一个标准化的工业产品。
一台两台可以圆一下,100 台都这样,机器之间差异就太大了。
所以一致性的问题对 CEL 来说,是非常关键的问题。
以及论文中的实验是在两台新机器上测试,相当于没有在某台单机上 overfit 调试,这一点还是值得肯定的。
我当时听到这里的时候,稍稍诧异了下,因为其实我之前部署模型还都是在同一台机器上。。。
也试过直接上新机器,会哐哐掉点。
同样的状态和指令,A 机器往左、B 机器往右,检索出来的经验就是噪声。所以我会觉得智元除了真的有钱,硬件端估计也下了不少的功夫。
长期来看,具身的供应链也会走向成熟的。
于超老师还提到,他们在仿真里调好的三四套算法,上真机 work 的没几个;反过来真机上 work 的,回仿真也 work。
这类东西,只有真的把一百台拉起来跑过才知道。
讨论几个问题,顺便聊聊行业。
最后再跟大家分享当时探讨的一些问题。
天南:少量机器跑很久,和很多机器跑一会,总时长差不多,效果上会有区别吗?
任广辉:效率上,100 台机器一小时采完,一台机器要四五天的量;分布上,100 台在不同背景、光照和物理状态里,探索得更宽。真实世界里,多台带来的分布多样性比总时长更值钱。
天南:台数继续加,还有收益吗?
于超:看任务。简单任务到一定台数探索就饱和了;任务越长越复杂,解空间越大,越需要更多机器。跟大模型很像,简单问答早就够了,长任务才需要更大的 scaling。
天南:Sutton 想搞的那种完全自主探索的「机器人幼儿园」,和 CEL 是什么关系?
于超:强化学习是一种非常低效的学习方式。模仿学习是直接给你答案学就行,强化学习你得先探索到答案再学。Sutton 那种更像要学一个 general 的人出来,没有目标。有目标的后训练,尤其是面向工业场景落地部署的后训练 pipeline,还是需要人类经验先把你领进门。
我们的理解是两者不冲突,CEL 解决的是领进门之后,怎么不靠人继续往上走。
天南:能不能用 GPT-6 这类大模型当裁判,把人彻底拿掉?
任广辉:CEL 其实对奖励精度要求就不高。如果环境复位也自动化,再上一个学出来的奖励模型,人就可以完全离开。 理论上,GPT-6如果效率在高一些,确实可以做一些尝试,我会觉得这是 RSI 搬到了物理世界。
上面这个问题,是我这次聊完最期待的方向。
天南:如果 GPT-7 把具身数据都吃下去了,具身公司还剩什么?
任广辉:客观来说是有压力的,它的 zero shot 能力确实很厉害。但速度上还要再快50倍才能满足需求。
压下来参数就要降,泛化还剩多少是个问题。它也得从头做软硬一体,也得找垂类场景去滚可靠性。倒杯水做不到三个 9、四个 9,你会觉得我花 1 美金让它倒杯水都给我洒了。
于超:我同意任老师的观点,具身公司做好垂类场景,降本增效也许是一个出路。大家其实也都是这么干的,Neo Lab确实风险太高了。不过蒸馏后如何维护一个长度适中的思维链仍然是个难点。
天南:对学术界呢的影响呢?
于超:我觉得是利好。预训练变成只有一两家能做的事,学生们被拉到了同一起跑线,开始卷怎么用好大模型。但它也担心,idea 变得很直白,谁有算力谁先做出来,怎么培养学生的批判性思维成了新问题。
天南:智元为什么愿意开源?
于超:我自己的看法是,它的壁垒已经不只在模型权重上了。 真机舰队、量产一致性、部署场景,这些开源了也拿不走。对行业来说,中小团队可以在百B级底座上做自己的后训练,不用每家都从头烧一遍预训练。
任广辉:具身智能还在早期阶段,我们希望通过开源开放,让更多人能上手尝试、验证不同的想法。大家一起把技术往前推,也能更快找到机器人真正有用的场景,这对我们(智元)同样有价值。
尾声。
今天差不多就和大家聊这些内容,在交流之前,我确实没想到还有机器人数量 Scaling的探索空间。
能在这个时间点掏出 96 台机器给学术团队跑实验的公司,国内也确实没几家。
这两个月,GPT-6 让很多人开始怀疑具身公司还有没有位置,可最近我反而觉得大家都更务实了。
模型能力可以被大模型追上,但部署、真机、一致性这些脏活累活,都还要一点点磨。
期待 Go3 开源之后有更多第三方评测,我们也会继续跟进。
以上。
推荐阅读

×
右键可直接复制图片