 阅读时间大约10分钟以上(6731字)
7小时前 对谈|LiberAI 林凡淇,大模型很难吃掉System 1
来源:具身纪元
Astra之下,Liber-0用220万小时的回答。
作者:Jane 出品:具身纪元
大规模预训练的灵巧手模型越来越多,Ego 数据也成为其中一个重要来源。人类第一视角视频能以较低成本覆盖丰富的物体、场景和操作,是机器人学习泛化能力的重要基础。
但一个现象值得关注:大规模 Ego 预训练的收益,并不等于模型已经能直接 Zero-Shot 到真机的精细操作。从看懂人怎么做,到让机器人的手把动作做出来,中间仍需要高质量的动作监督与本体对齐。
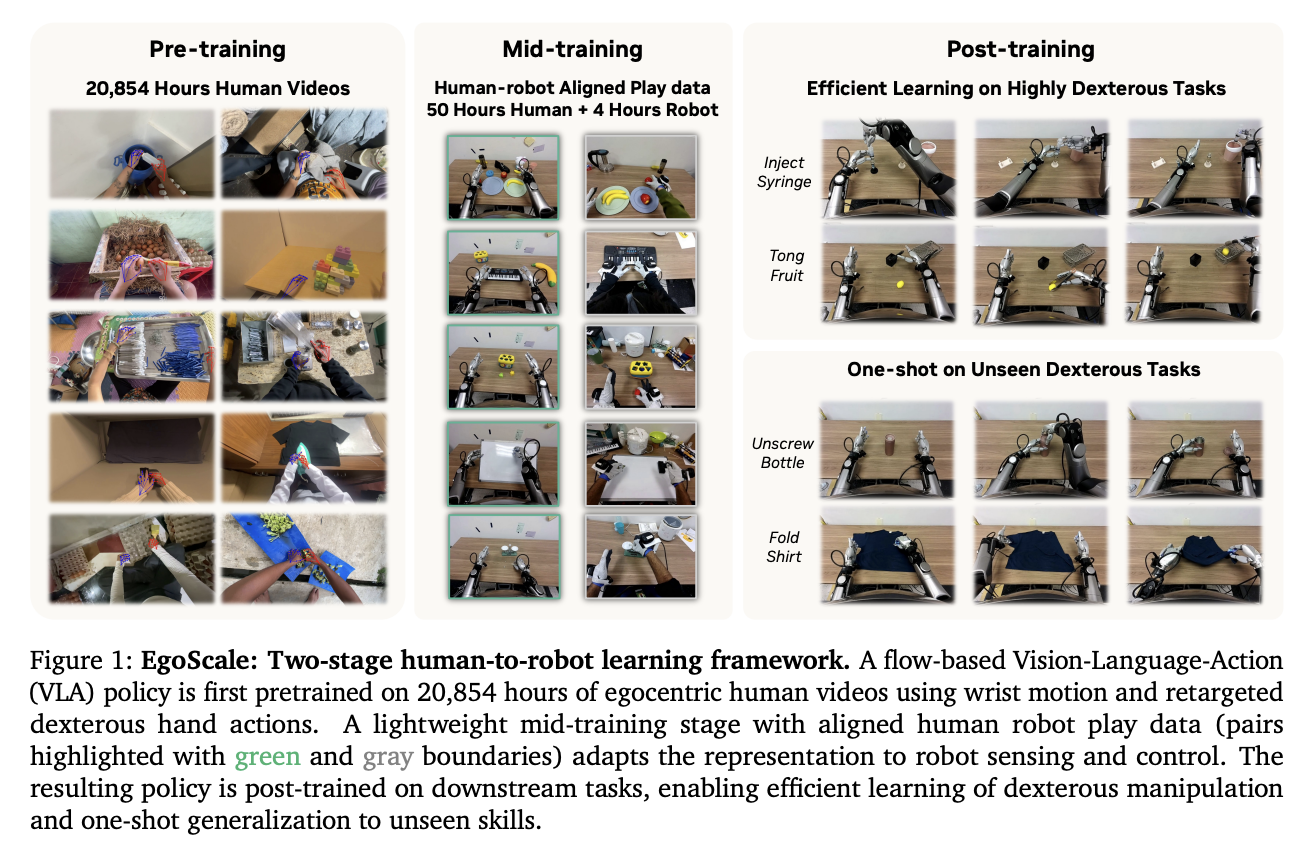
以英伟达 EgoScale 为例,它利用 20,854 小时带动作标注的 Ego 视频预训练之后,还加入了约 50 小时人类数据和 4 小时机器人数据做 mid-training,再进行下游任务的 post-training。手套的作用,正是在大规模视频与可执行动作之间,补上更精确的对应关系。
今天LiberAI发布了Liber-0的技术报告和demo 视频,有一些地方着实惊艳。
第一,Liber-0在预训练上使用了大比例的自有手套采集数据,第二,Liber-0在非pick and place的任务上实现zero shot,且能实现在真机长程任务上的泛化。
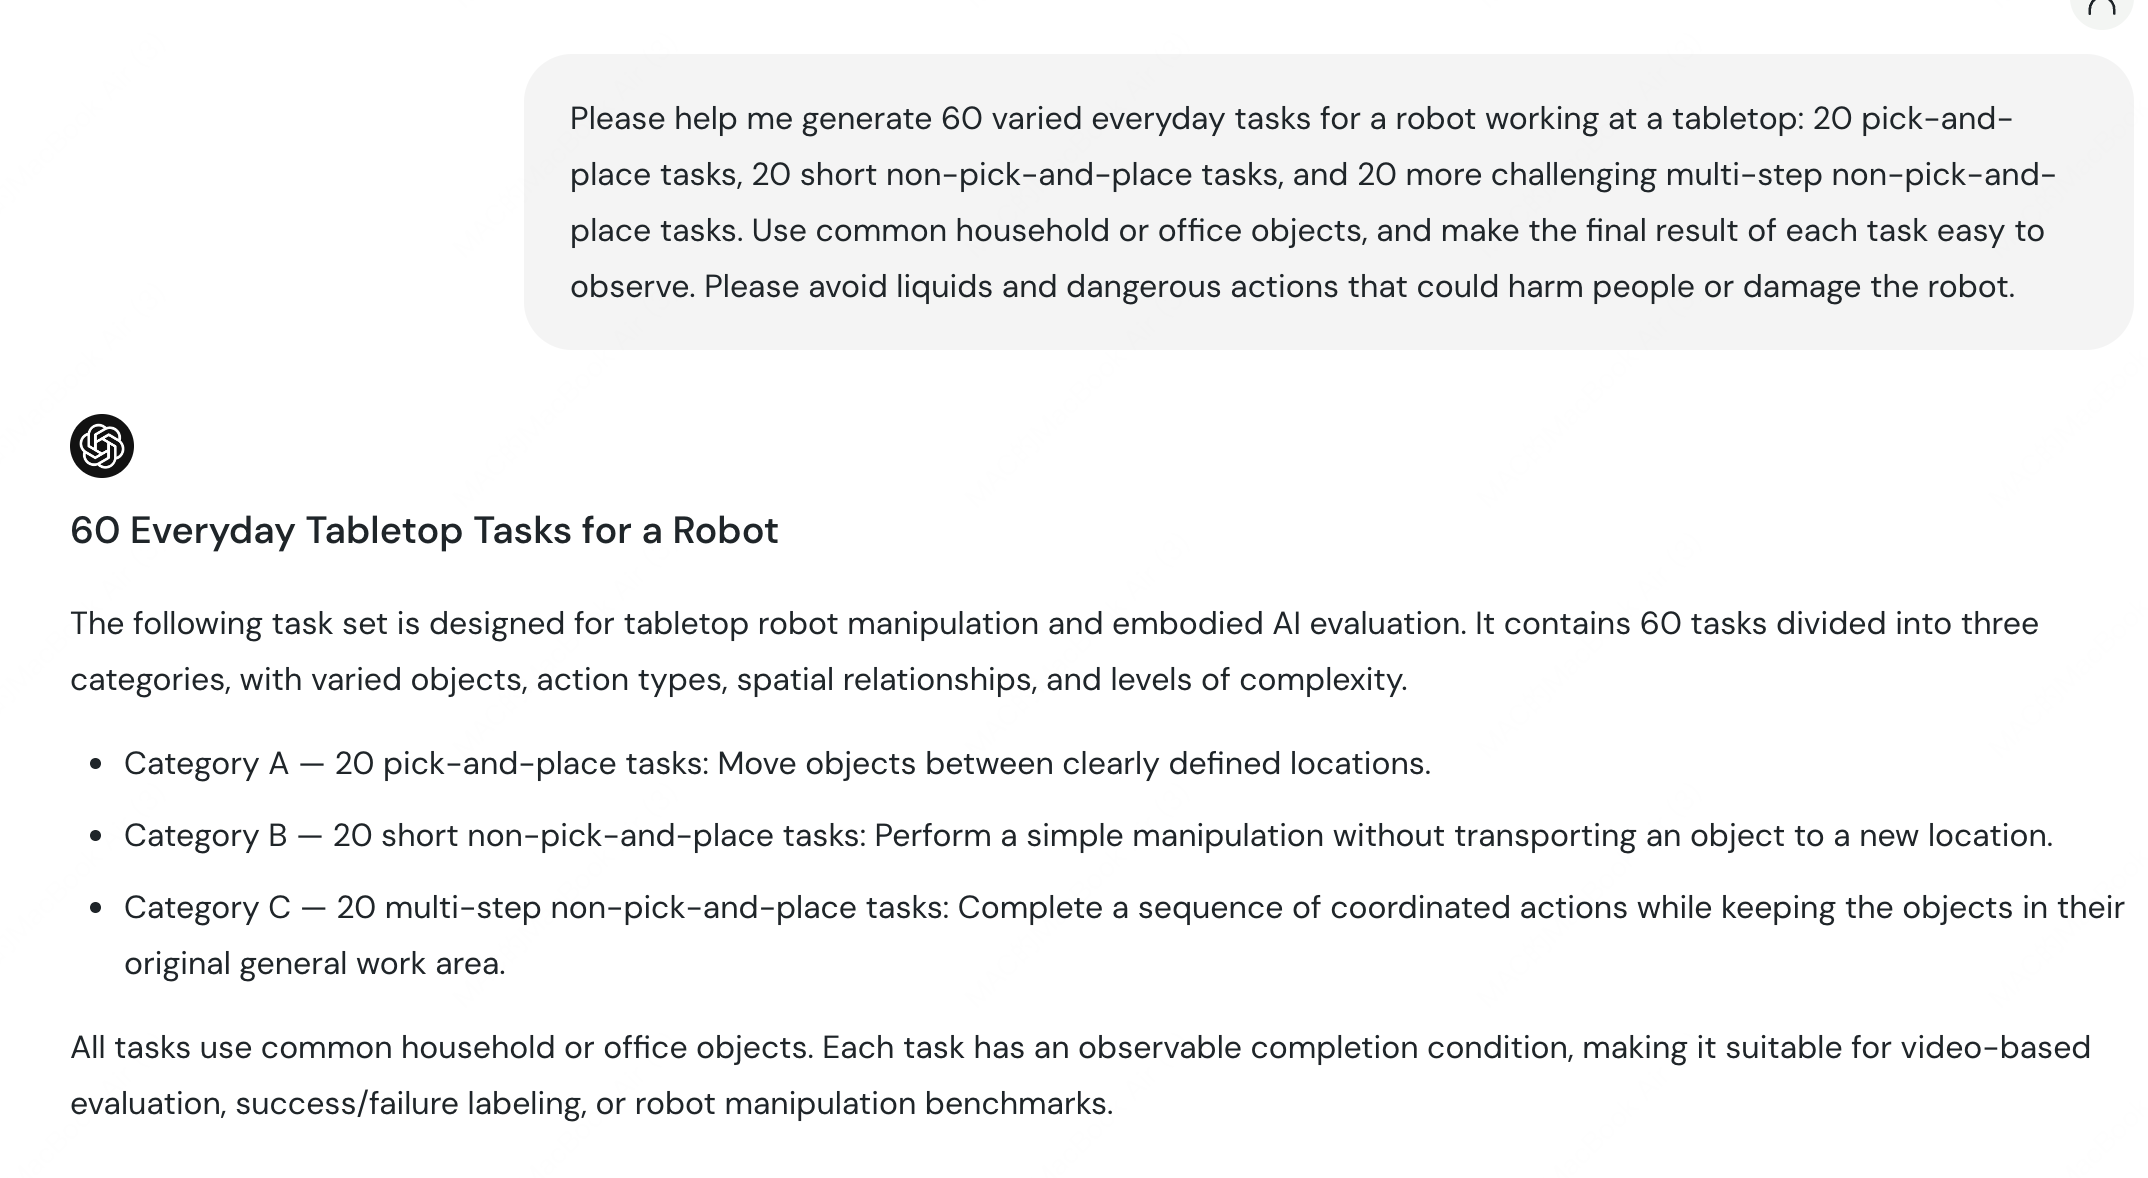
他们的方式是,通过GPT 随机生成了20 个 pick and place, 20 个非 pick and place,以及 20 个长程的、非 pick and place 的任务。
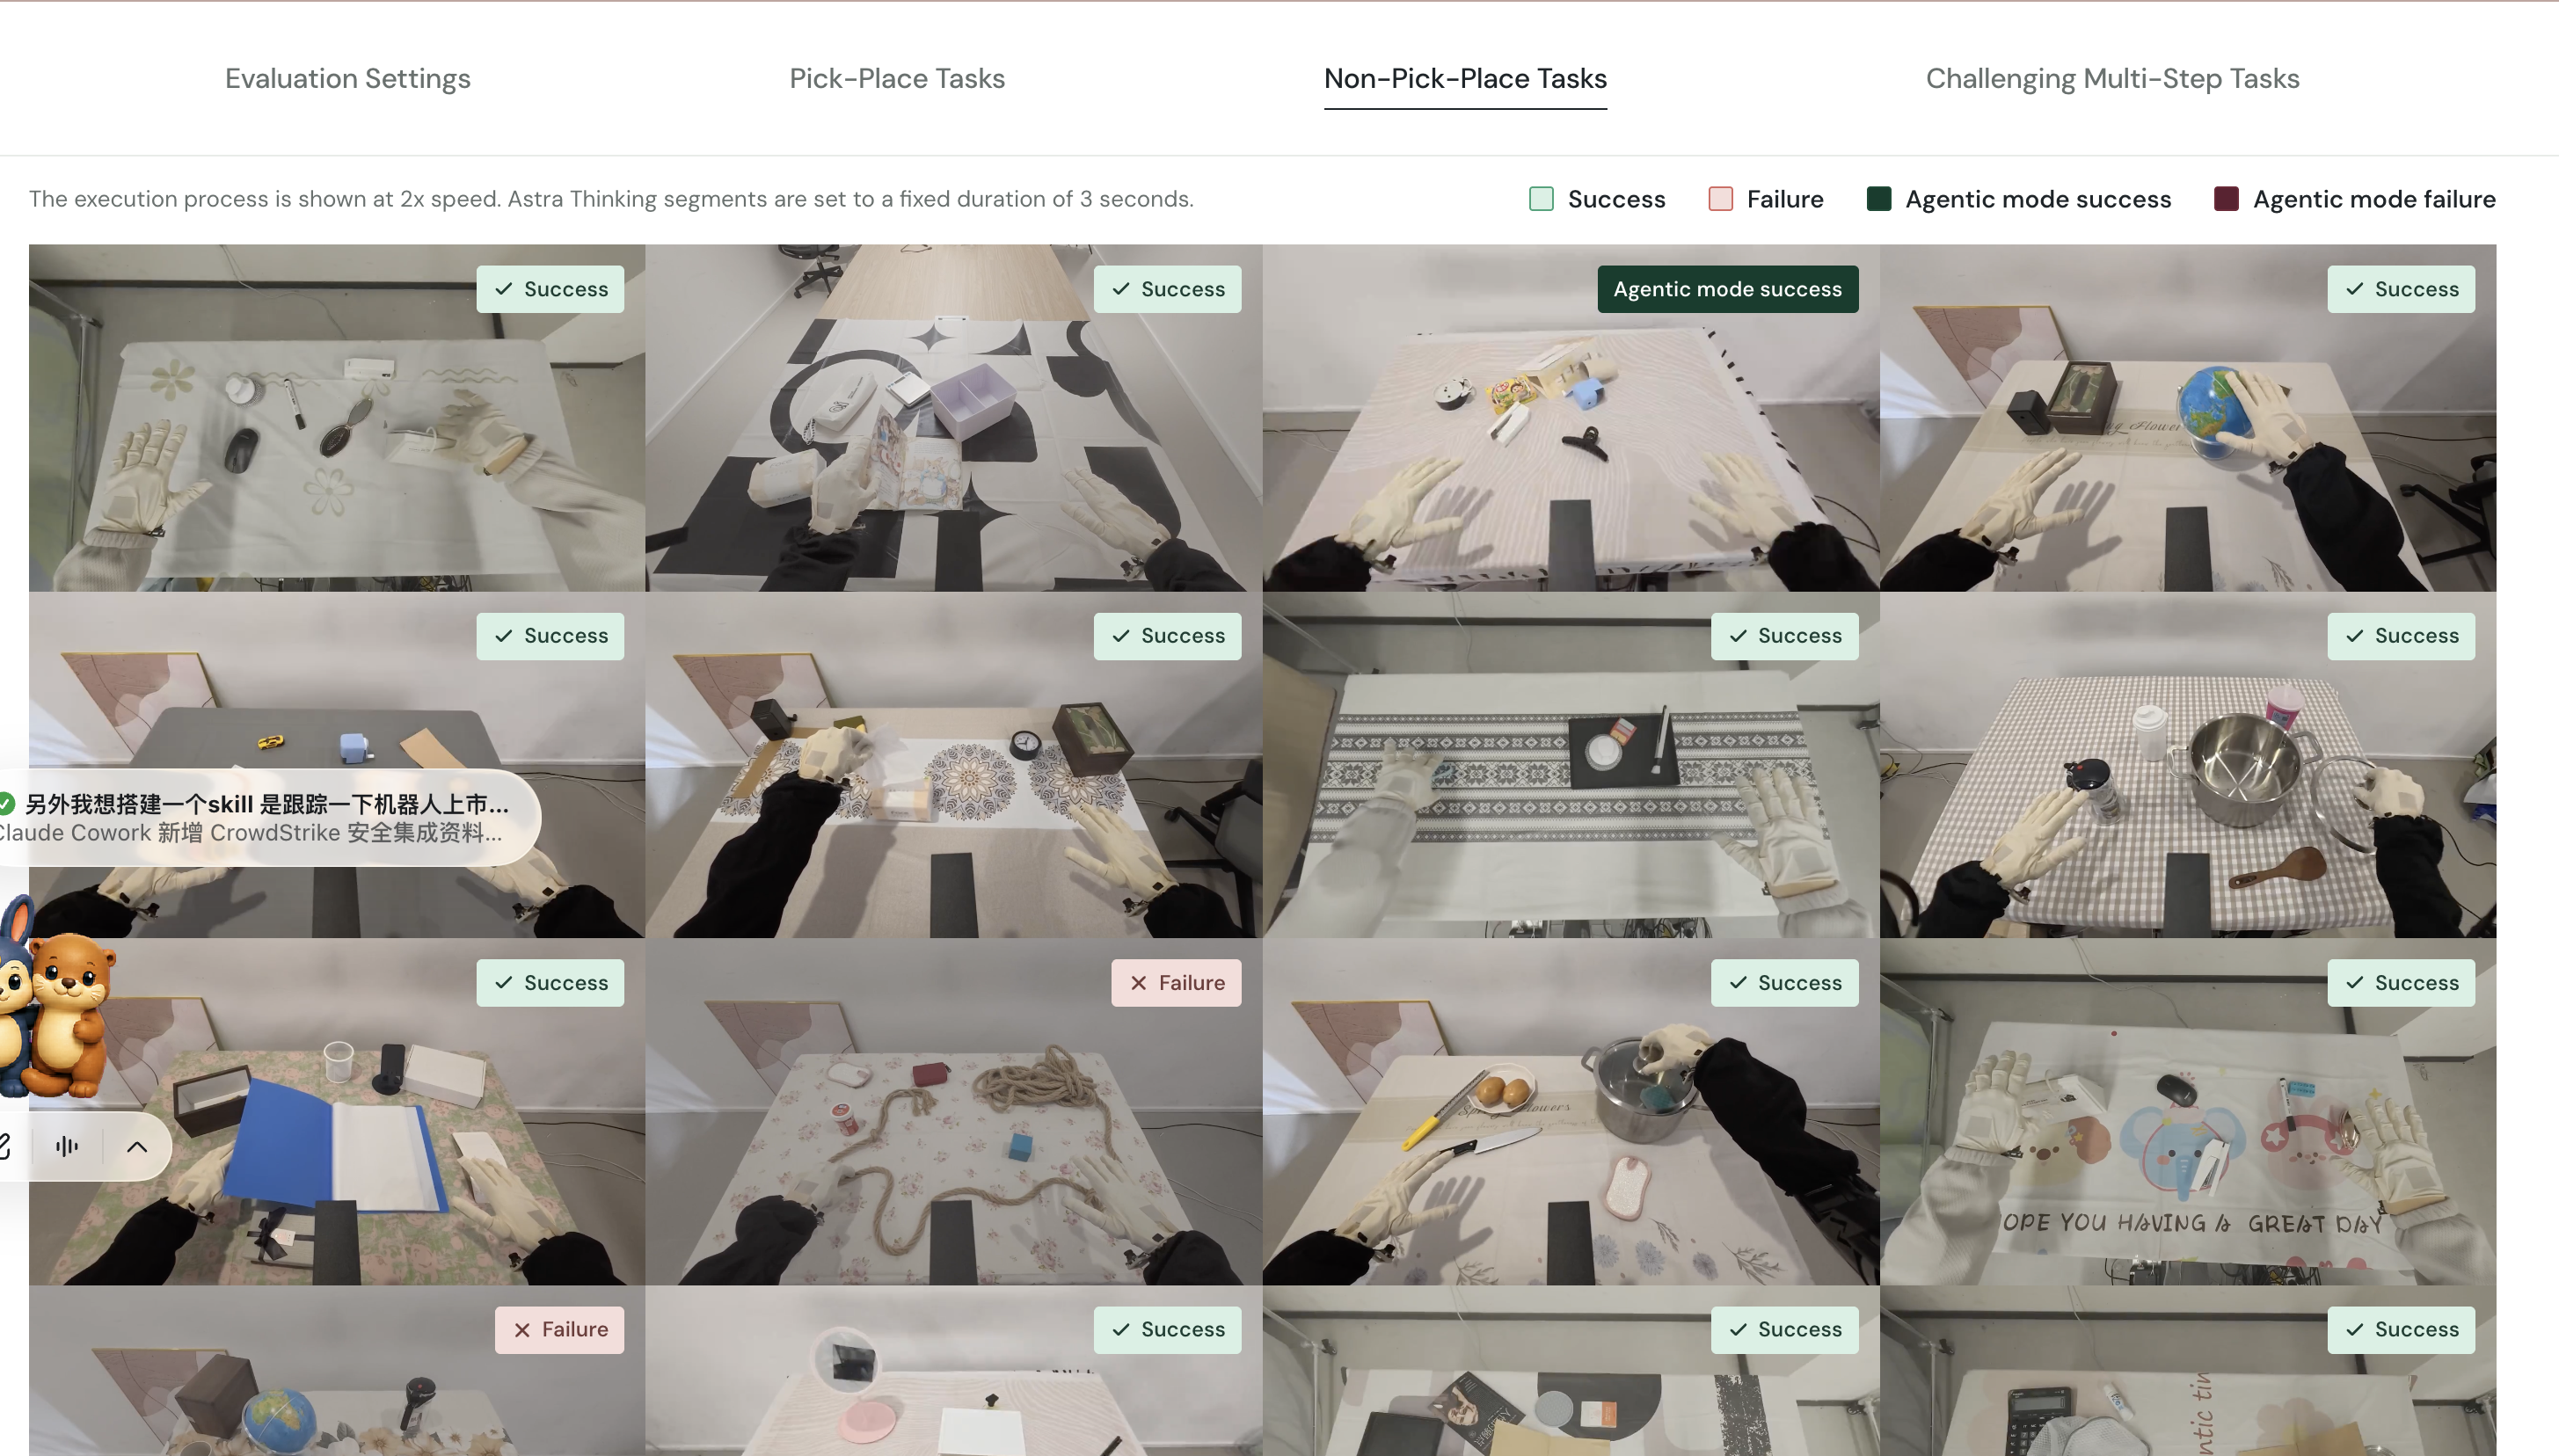
可以观察到,在抽纸这样柔软物体操作的case中,模型可以zero shot地成功完成。但是在绳子打结的任务上,失败了。
详细测评结果 https://reel.liberai.work/#/
在一个打包的 demo 中,机器人先撑开桌上的纸袋,一只手配合保持袋口张开,另一只手先后把包装盒、透明杯和香蕉放进去。装完之后,双手再收拢袋口,将纸袋上沿折下。
这里既有多步骤的任务衔接,也有双手配合:纸袋是软的,抓取和放入物品时,袋口形状会变化,机器人需要一边维持开口,一边把东西送进去,最后再完成合袋动作。
另一个demo是灵巧手机器人做奶茶,整个过程长达5分多钟,一镜到底。这个任务的复杂程度在于,做奶茶是一个子任务很多的场景,有很多步骤,需要选茶底、调冰量、组合小料,每个步骤也有很多选项。
在跟 LiberAI 的交流中,他们提到,奶茶场景经过了针对性的后训练,每个子任务的数据采集量级只有几百条。团队先采示范、部署,再将真机运行中的数据回传继续训练,并不是一次采完就能工作。强基模能把后续落地的数据需求降到什么程度,这进一步引发了我们的好奇。
“当基模的Zero-Shot能力已经不错,在这个基础上要进一步提高成功率、做真正的落地,其实不需要那么大量的数据,相对比较简单就可以服务到日常生活中。”
Liber-0 的技术报告中,最值得关注的是手套数据在 Non-PnP 上的 scaling。固定后训练使用的机器人数据,分别扩大各类预训练数据后,手套数据从 1,000 小时增加到 1 万小时,Non-PnP 平均进度得分由 46.8 升到 59.9,高出 13.1 分。这个增幅,明显强于图中其他数据源。
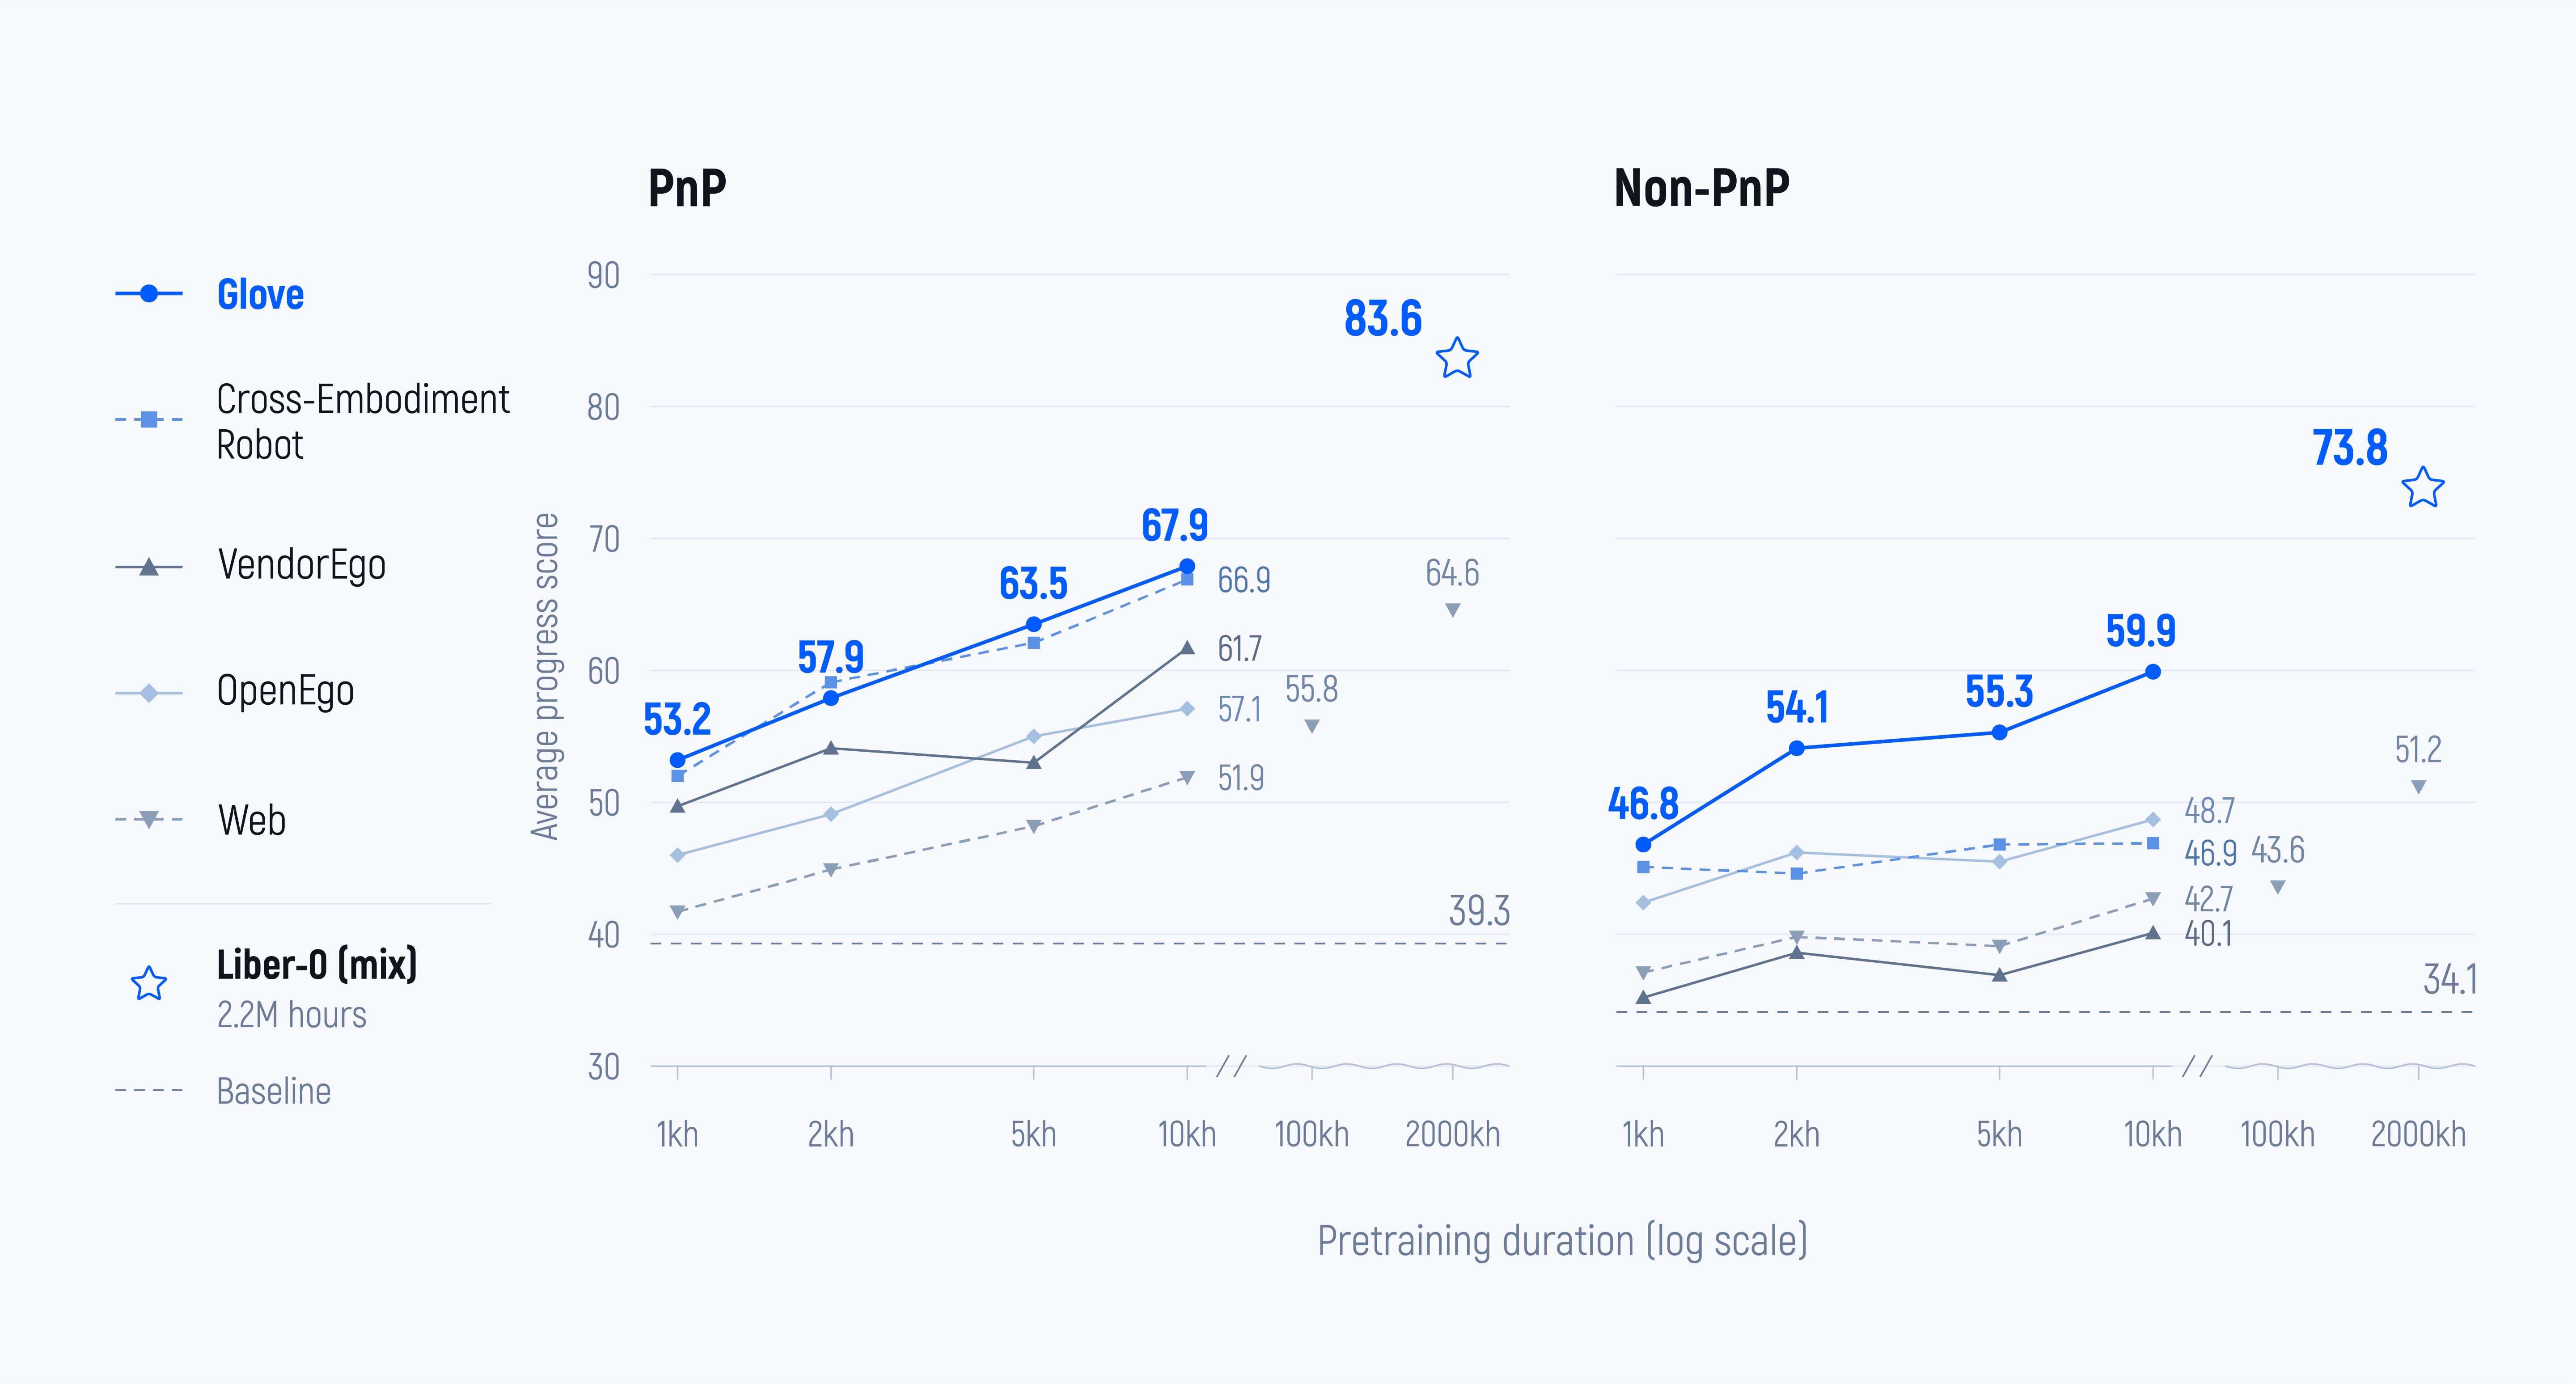
各数据源分别预训练后,使用相同机器人数据做后训练。Web 200 万小时的 PnP / Non-PnP 平均进度得分为 64.6 / 51.2;手套 1 万小时为 67.9 / 59.9。图中指标为 0—100 分的进度得分。
手套数据是机器人数据的有效补充。策略训练中,减少机器人数据,补充手套数据后,得分仍能达到全量机器人数据的水平。即使不使用机器人数据,手套数据也能支持有效的跨本体迁移。
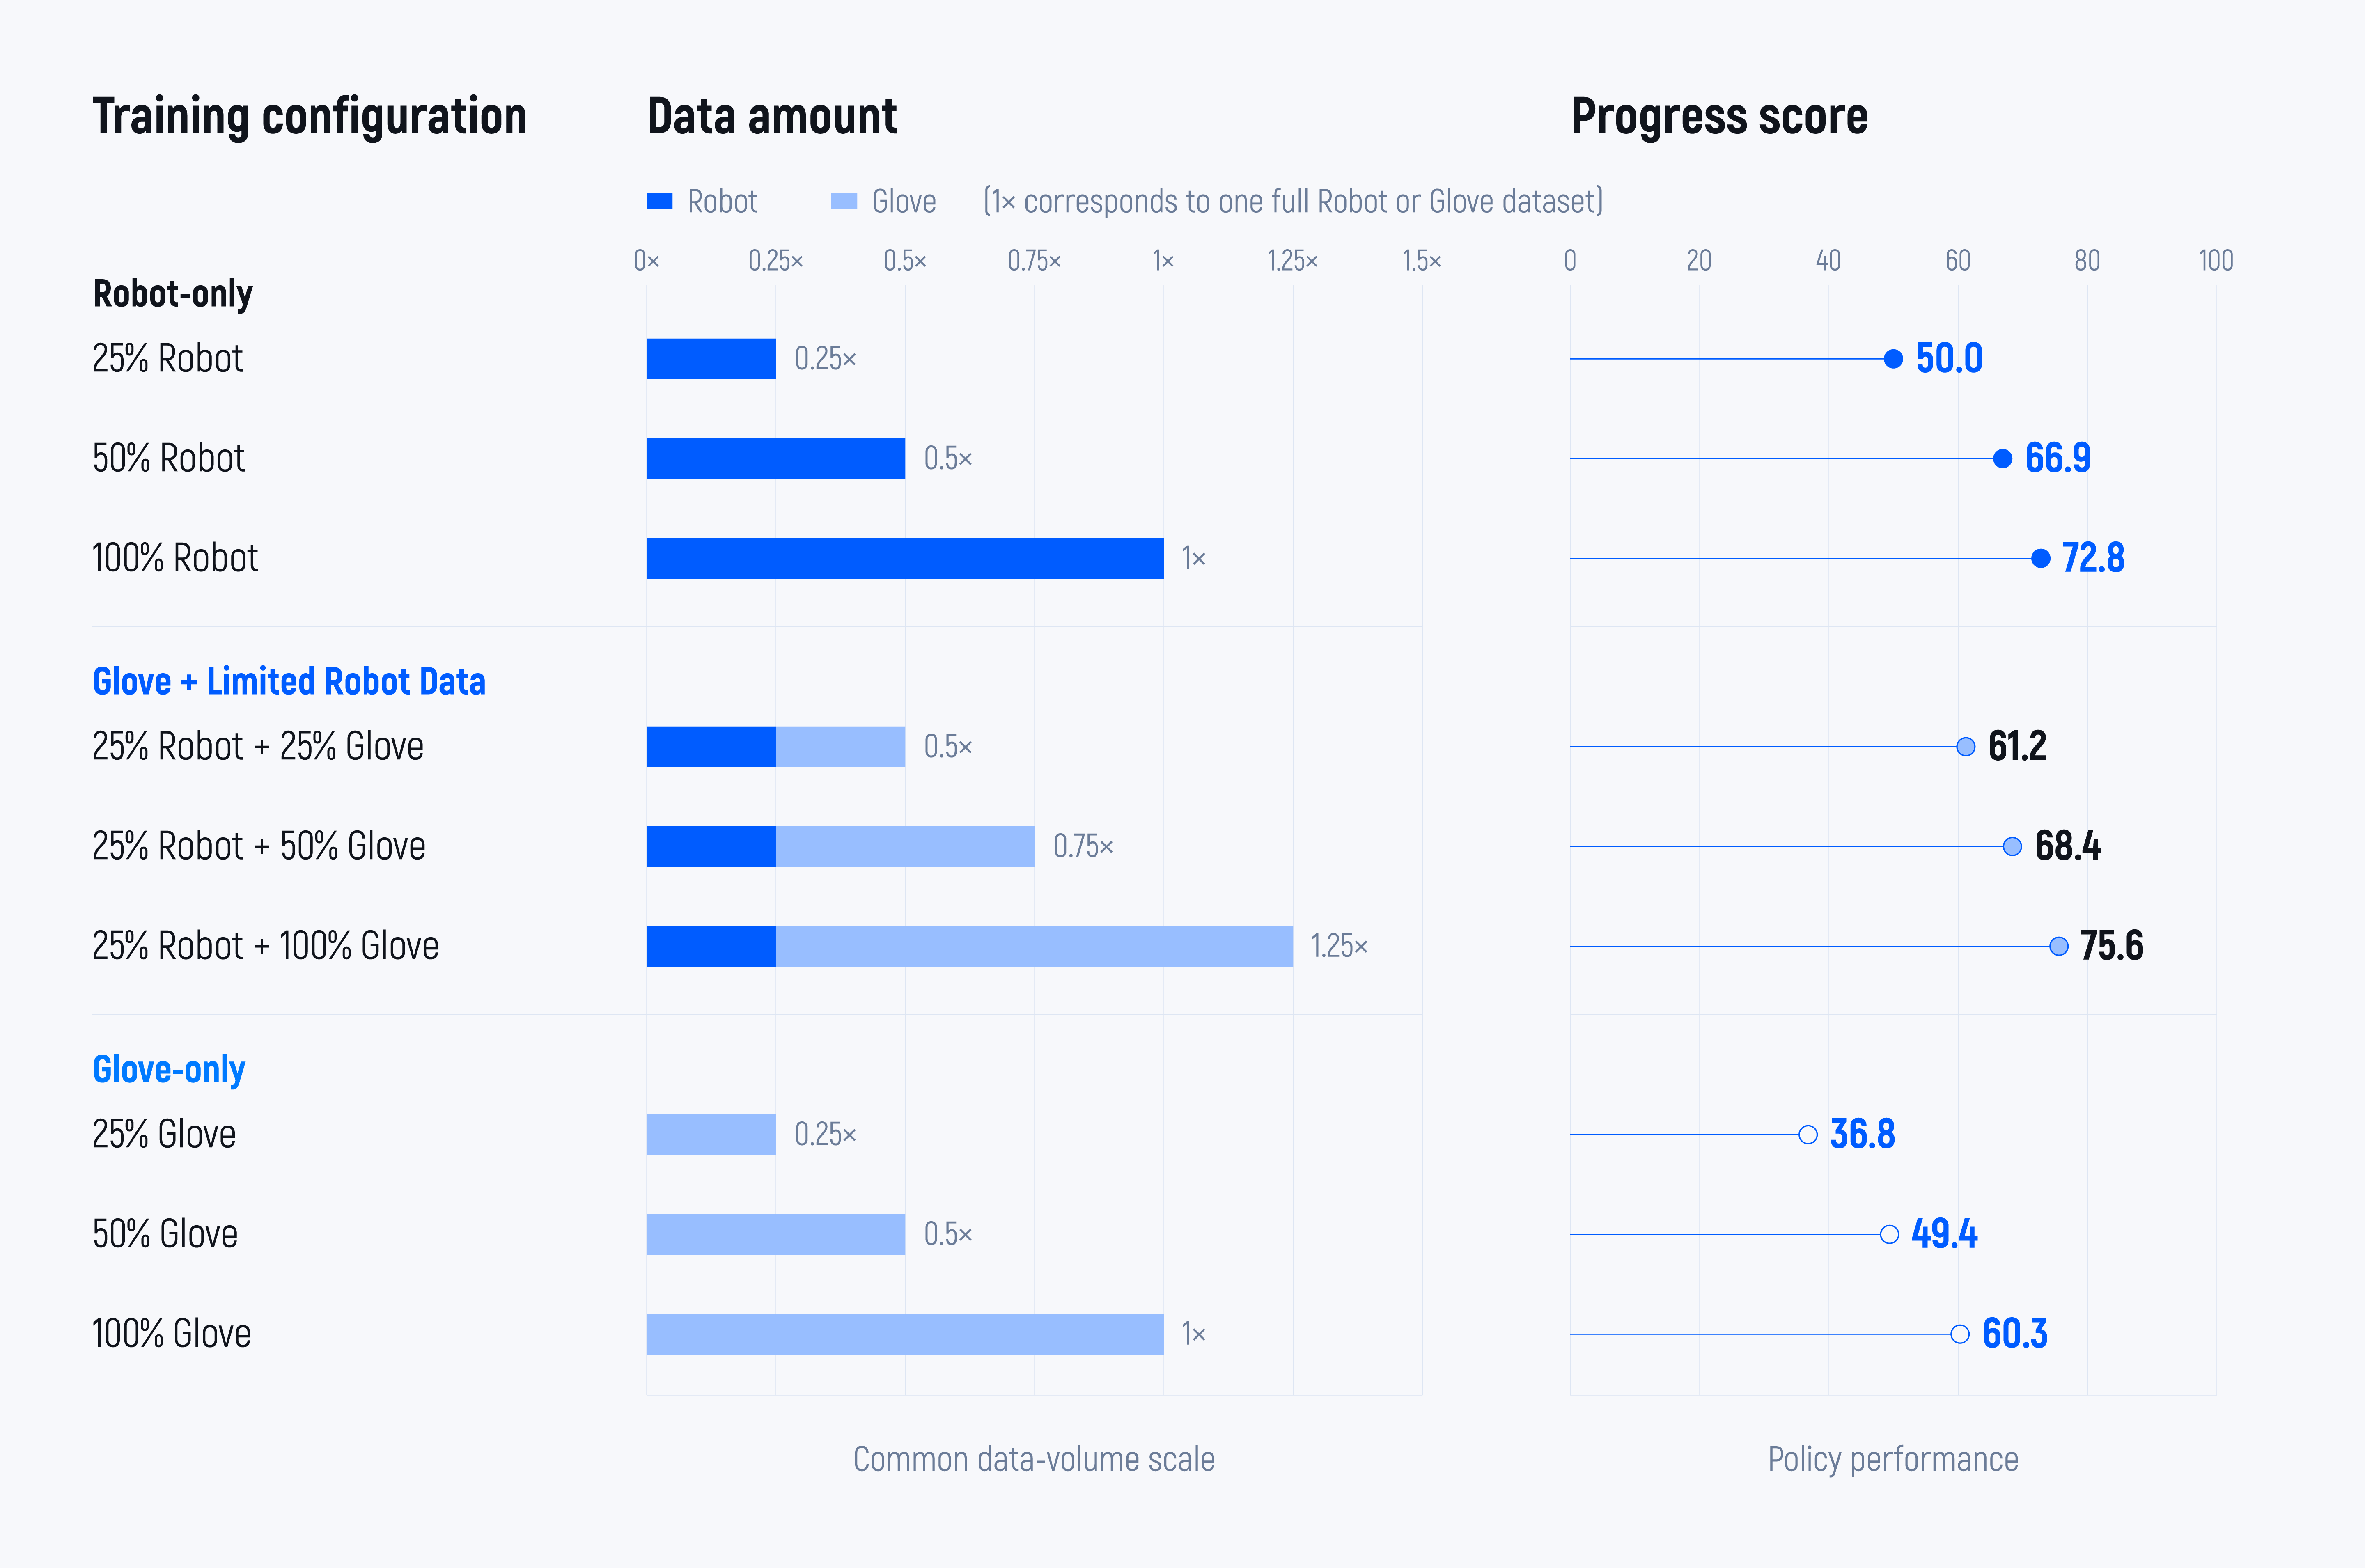
仅用手套数据训练时,使用手套数据池的50%,就能取得49.4的进度得分,接近使用25%机器人数据训练得到的50.0。将手套数据增加到100%,得分进一步提升至60.3,超过仅用25%机器人数据的结果。
更关键的是,当真机示范只有 PnP(拿起并放置)时,加入手套的 Non-PnP 数据,能让机器人学到真机示范没有覆盖的操作。这组实验考察的是动作能否从人迁移到机器人:相应动作出现在手套数据中,并不是训练时完全没见过。
我们跟 Liber-0 团队的联创林凡淇聊了聊,更详细地了解了他们如何做到的?数据路径背后的思考、硬件和模型的协同方式、以及在Astra之后,他们的壁垒是什么。
凡淇告诉我们,这样的数据表现源于高质量的手套数据。
“我觉得这说明了一个点,手套数据真的非常好用。它真的是可以去某种程度上真的去替代你真机的遥操数据的。未来我们通过手套数据更大量的 scaling,当我们把各种各样的人的动作都做了一遍之后,模型最后真的能学会各种各样的动作。”
“PnP 还是偏语义的理解,最后的结果就是所有数据其实都会scale得还不错。但Non-PnP要求不能停留在语义层面的理解,要去理解 action 的 pattern,gap要尽可能小才能做到更好的transfer。”
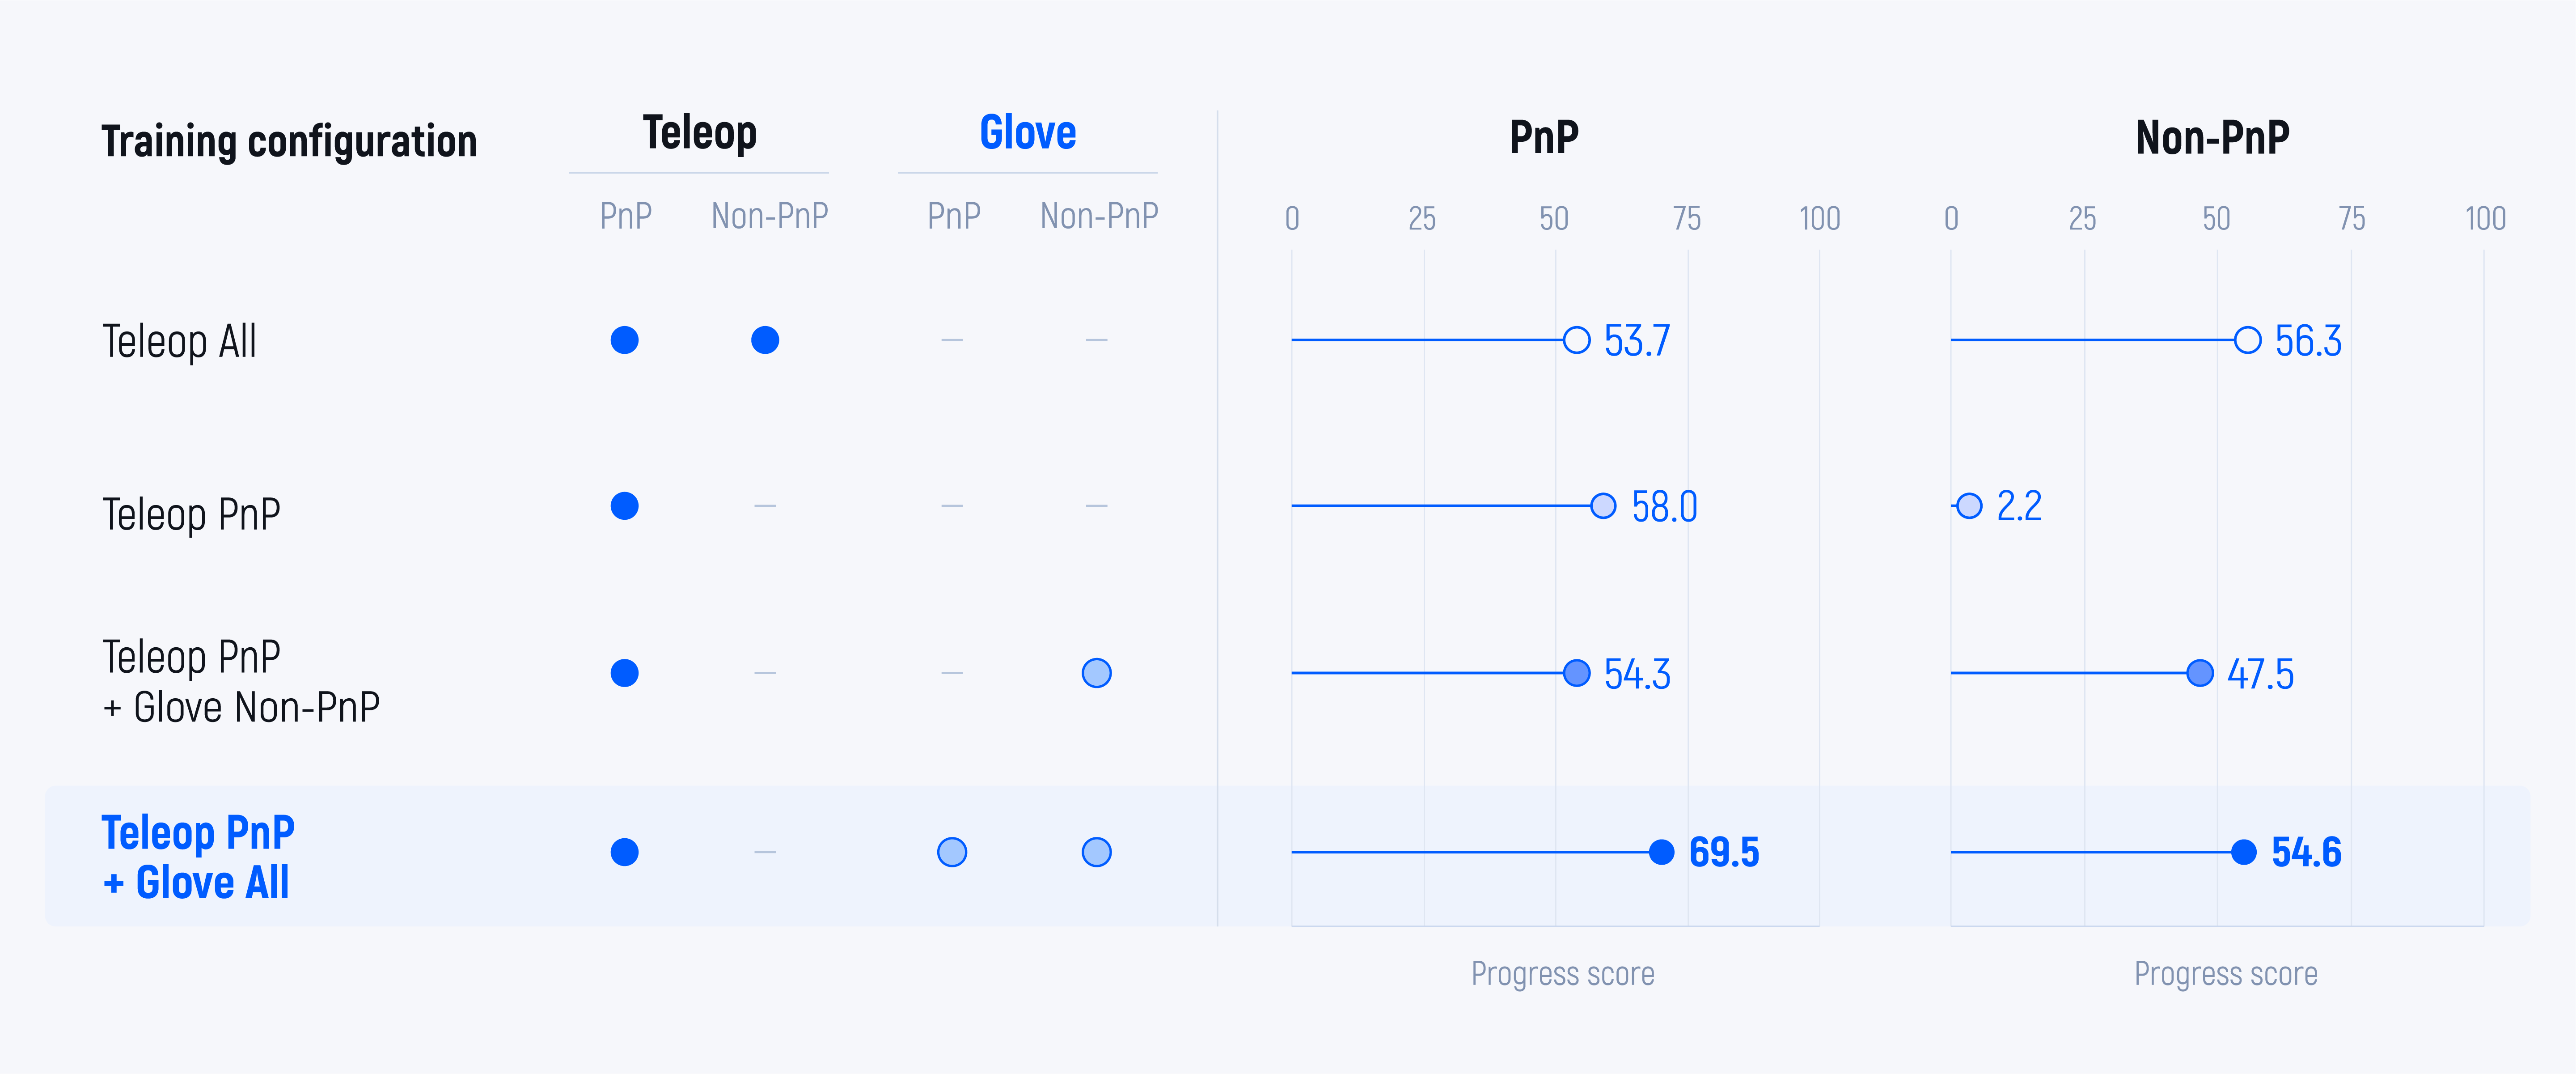
真机示范仅覆盖 PnP 时,Non-PnP 进度得分为 2.2;加入手套 Non-PnP 数据后升至 47.5,加入全部手套数据后为 54.6,接近完整真机示范训练的 56.3。
01
手套数据:Scaling 曲线最陡峭的高质量数据源
此前具身领域的数据路径的讨论集中在三个方向——Ego 数据、仿真数据、以及真机遥操 scaling。但这几种方式都存在各自的问题。
真机遥操是最直接的办法,但很难 Scale。人操作机器人,机器人把动作记下来,遥操夹爪已经不容易,遥操五指灵巧手更难,很多 In-Hand Manipulation(手内操作)几乎无法通过遥操完成。同时,单台机器人单天能产的数据量有限,规模化成本也是问题。
仿真的优势是便宜、可控,但Sim-to-real gap大。柔性物体、Contact-Rich 交互、灵巧手本体的物理精度,仿真都处理得不够好。大模型让 Sim-to-Real 和数据合成变得更有吸引力,但LiberAI 团队的判断是,“仿真需要更长期地去研究的事情,当下还没有那么work。”
Ego 数据是过去两年最被看好的方向之一。它的优势是数据量大、采集成本低,人日常戴着相机就能产数据。LiberAI 也测试过很多 Ego 数据,但团队判断,仅靠这类数据,还不足以解决他们要做的精细操作。
凡淇提到,“今年年初Ego数据这个概念被炒得比较火,我们其实也测试过很多Ego数据。”但测试完之后,他们判断,只用Ego数据无法 solve 具身智能的问题,核心原因是和机器人本体的 Gap 过大。
凡淇在访谈中具体谈到了相机、手的外观和本体运动方式的差异。技术报告还补充了一层关键问题:从视频估计出来的手部姿态和轨迹,会受到遮挡、深度估计和姿态估计误差的影响。视频量大,不代表每一帧都能提供可靠的精细动作监督。
先看相机数量和位置。凡淇提到,很多 Ego 数据只有一个相机,而机器人往往还配有腕部相机,精细操作会依赖这个近视角。单视角数据缺少这部分观测,模型预训练与部署时能看到的信息就不一样。
其次是相机视野。即便都有第一视角,相机的 FOV 和安装位置不同,物体在画面中的尺度、可见范围也会变化。
三是画面里的手。人戴着相机做事,画面里是真人的手;机器人工作时,画面里是它自己的灵巧手。模型训练时见到的手,和推理时见到的手,也是有差异的。
还有一层 Gap 来自本体。很多 Ego 相关工作用 Franka、UR 这类机械臂,它们的构型和人的手臂差别很大。这不仅让视觉 Gap 变大,从 Ego 数据里学到的轨迹模式也很难迁移。
凡淇认为,使用Ego数据的话,“模型的上限大概是知道应该怎么去动,但对精细操作的作用还是比较有限的。”
Liber-0 选择的技术路线是,柔性手套 + 硬件自研 + 与灵巧手本体做深度 Align。手套直接记录人手的姿态和轨迹,再通过相机配置、手的外观和本体设计,减少数据迁移时的差异。这些带动作监督的人类示范,与海量互联网视频共同进入预训练,让模型把观察到的交互结果和产生这些结果的动作联系起来。
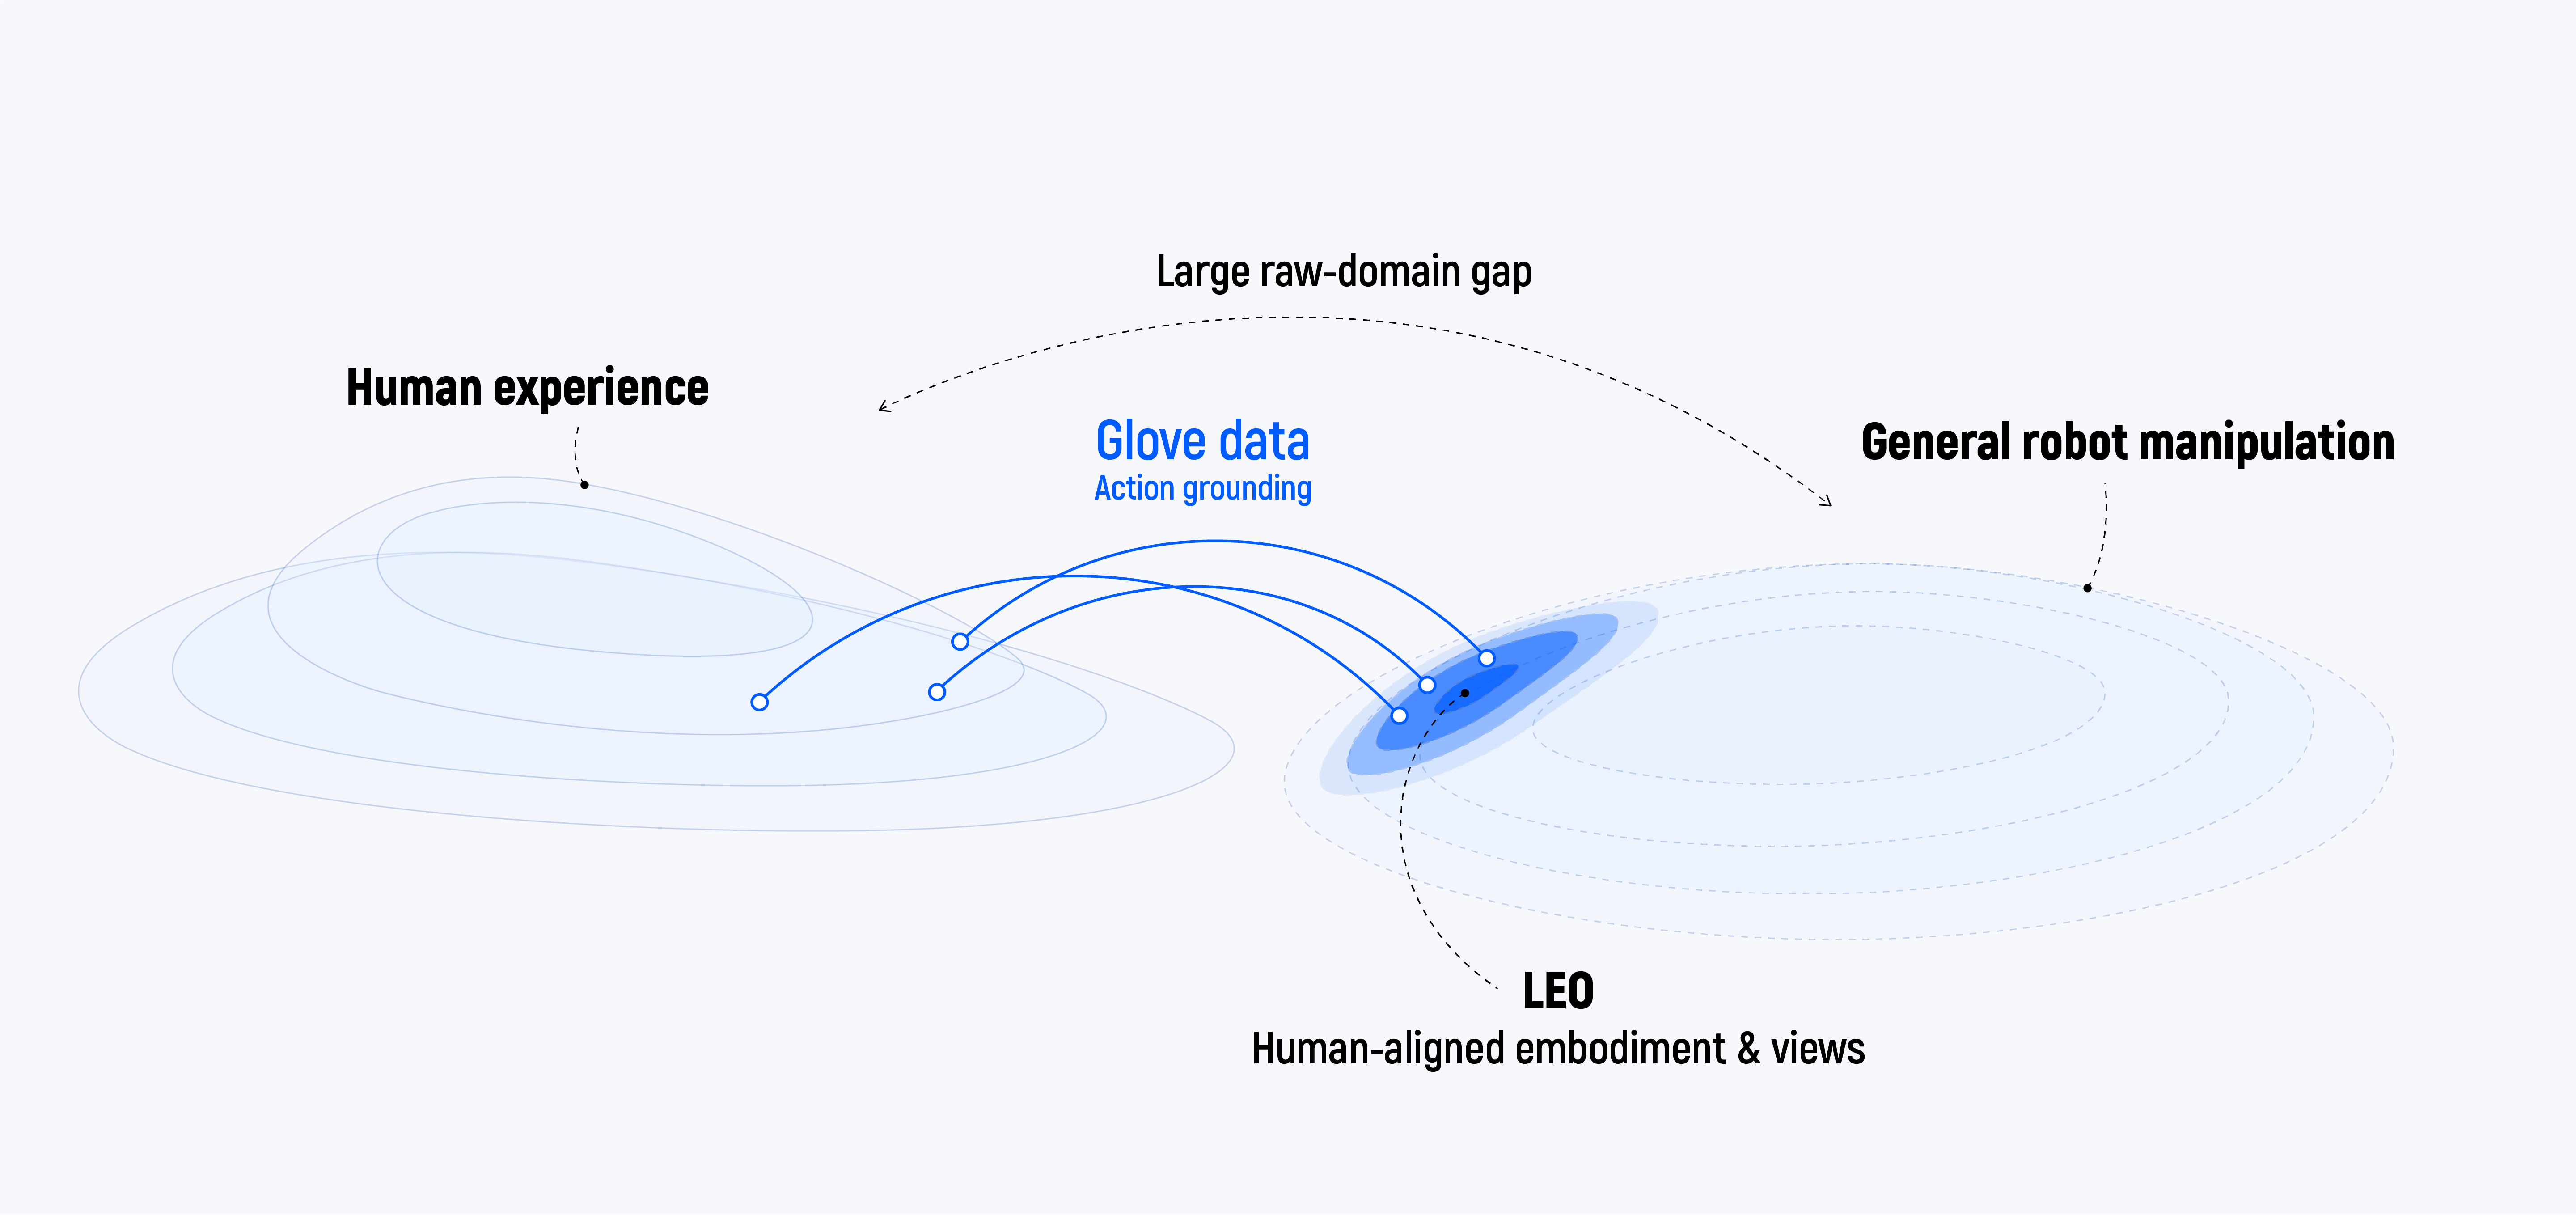
Liber-0 在技术报告中提到,手套数据为缺乏显式动作监督的海量人类视频,提供了可执行的动作标注(action grounding)。这是 Ego 数据和互联网视频本身缺失的信息。
手套这条路的难点在硬件:动作要采得准,设备又不能明显妨碍人做事,才可能长期、大规模地收集数据。为了提高测量精度而加上的结构,如果限制了手指活动、让人难以连续佩戴,最终也会限制能采到哪些动作。
行业内有主要两种方案。
一种是DexUMI一类外骨骼类手套,精度较好,且可以做到与末端同构。但Liber-0团队认为这类方案的问题在于“每个人的手的构型本身就不一样,强行去穿到一个硬质的、固定大小的壳子里面,是很难受的,肯定会影响日常生活,也同时会影响采集效率。”而且外骨骼的连杆结构暴露在外,防水也是个长期问题。
另一种是柔性手套。但软手套本身比较大的问题是传感器稳定性不够高。用EMF 追踪可能受到周围金属物体或电磁环境的干扰;用 IMU 则可能在持续估算姿态的过程中累积误差,出现随时间增长的漂移,需要比较强的产品设计和工程化的经验才可以解决。
不解决硬件约束,采集的数据就上不了规模。
LiberAI 选择自主研发一套能让采集员几乎无感佩戴的柔性手套。
“我们对比过当下的一些方案,其他的手套,还是觉得有一些问题。更多还是考虑用我们自己的,我们的自研方案可以保证比较小的视觉gap。因为我们最开始设计硬件采集设备的时候,就会考虑很多适配问题,尽量去减小 embodiment gap,这也是我们的数据可以很好transfer 的优势来源之一。”
凡淇认为,在手套的方案设计上,“第一个要点就是 Scalable 采集”,可以理解为,人穿上这个设备几乎不受影响,还是正常生活,同时能把数据采了。“在 Scalability 的前提下,我们自然会提出一些要求:尽量不影响人的使用,尽量不影响人手构型,同时不能被金属、电磁之类的外界物体干扰。”
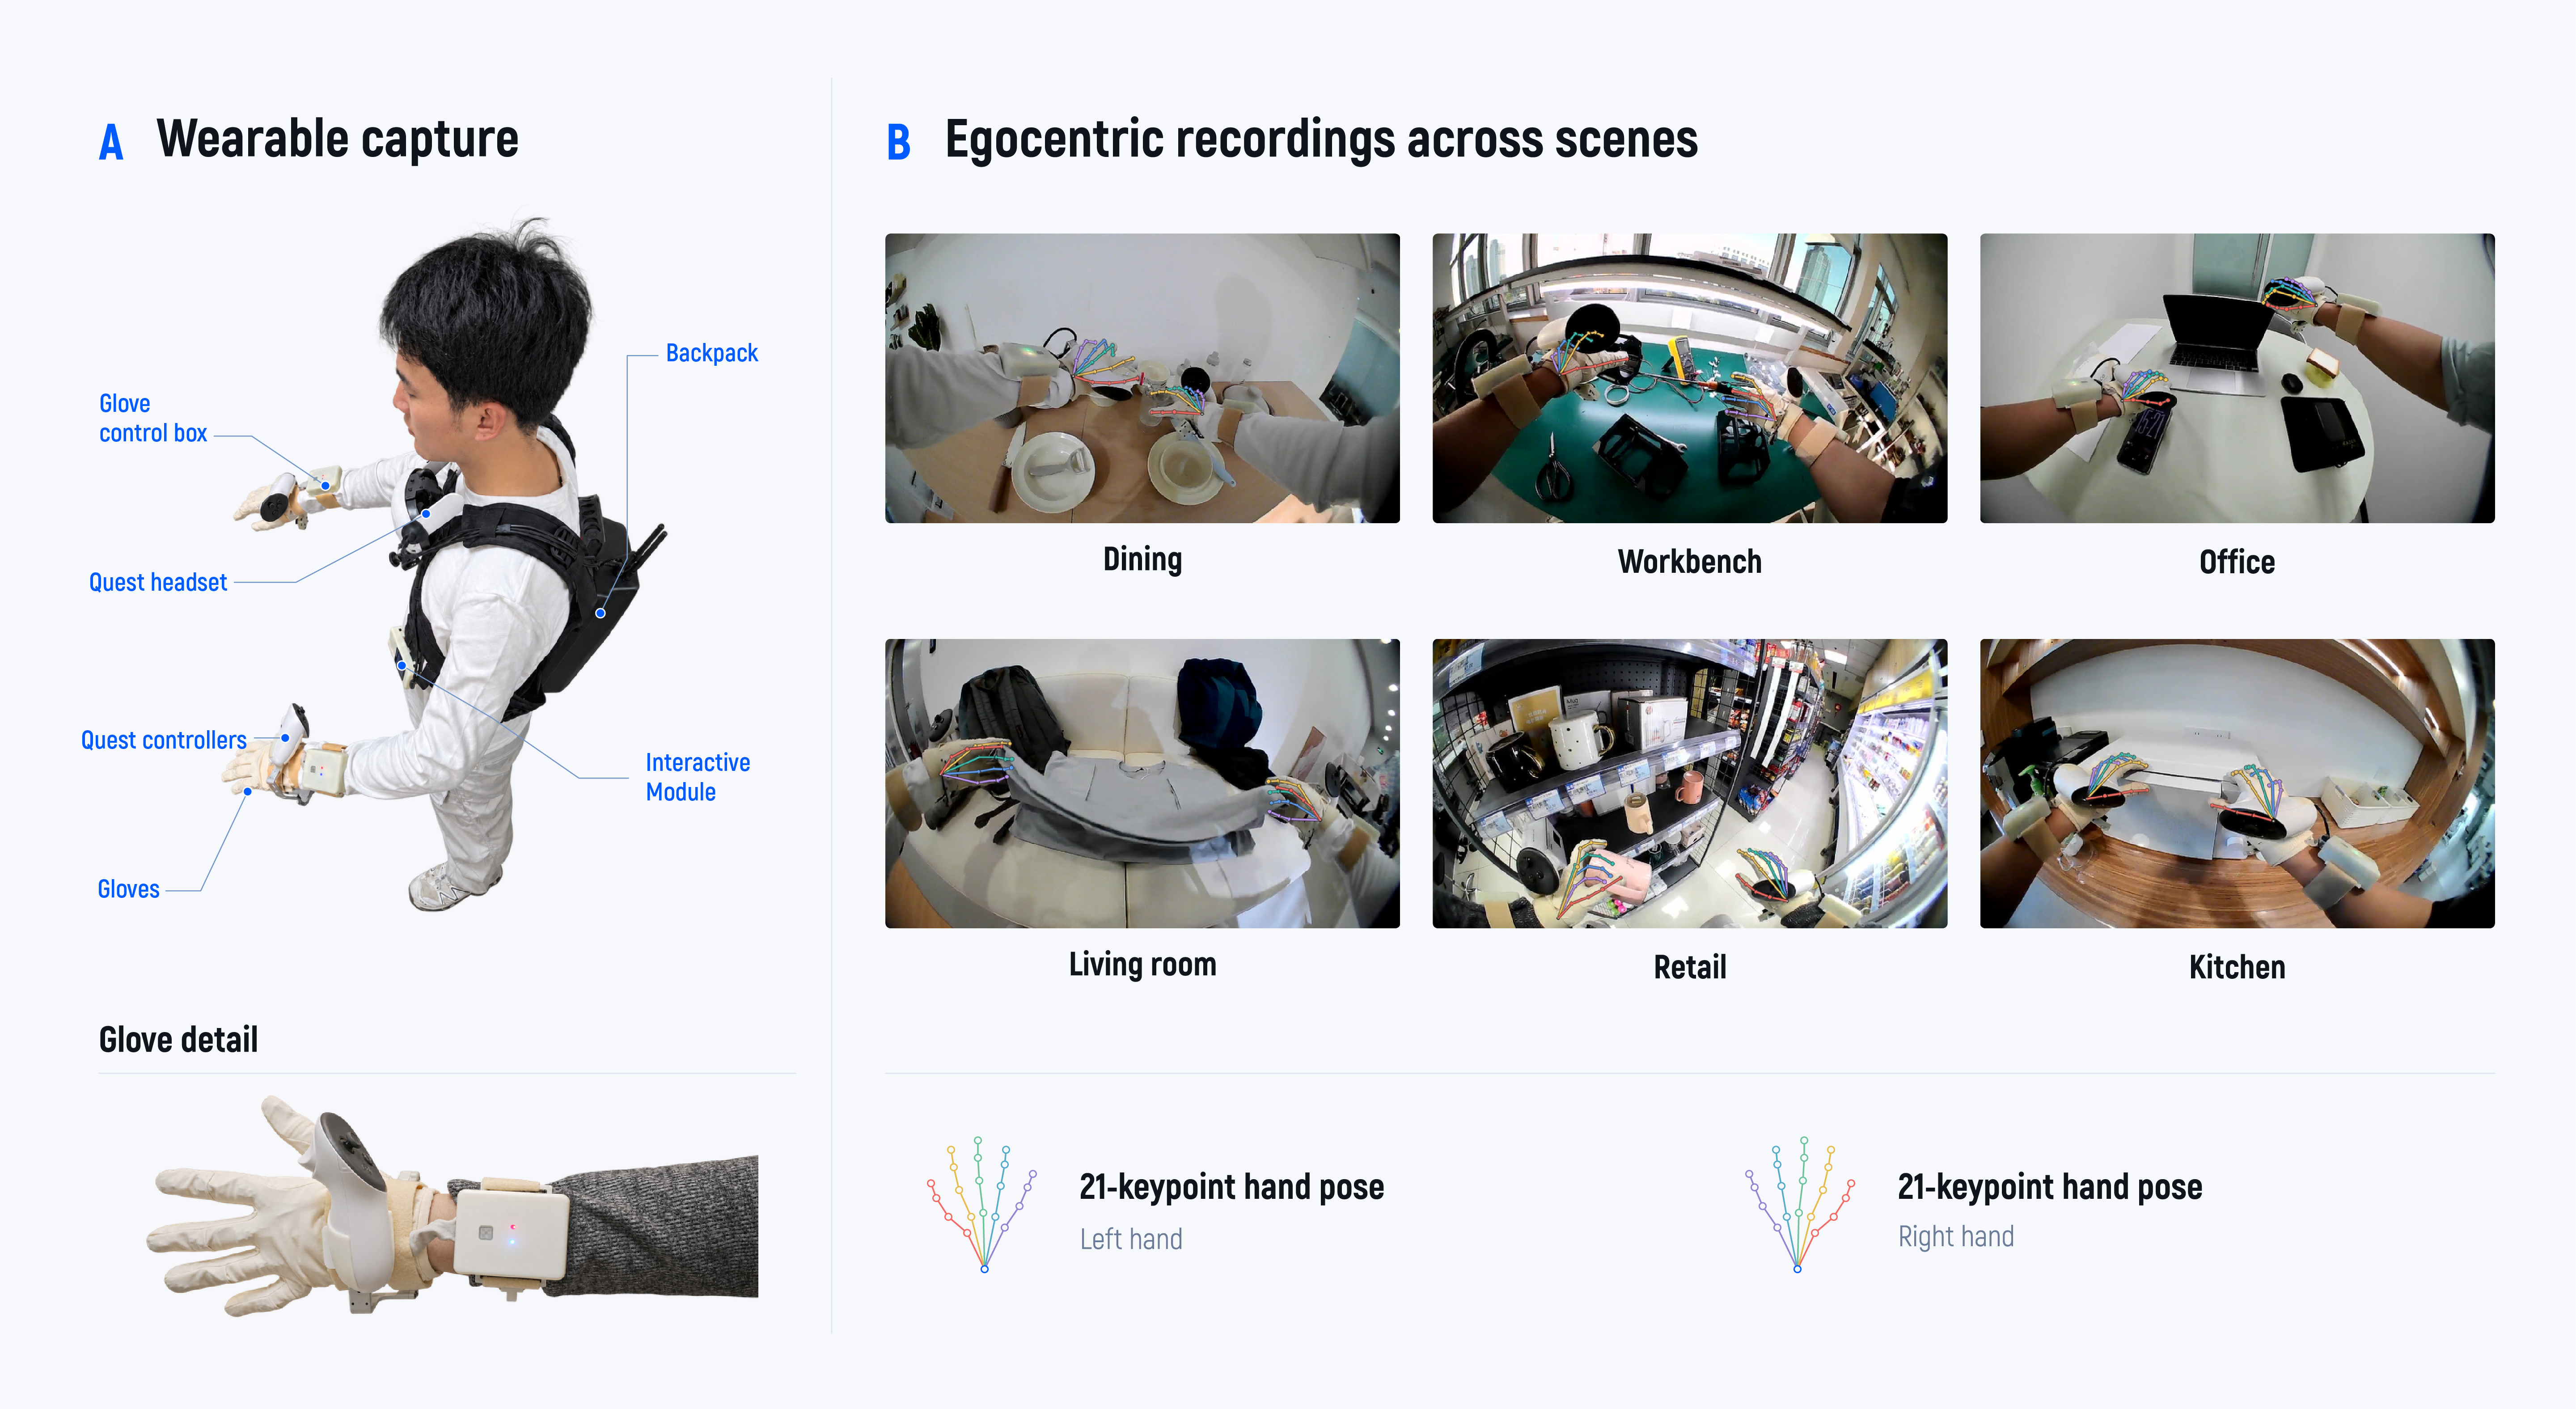
在技术报告里披露的具体硬件参数里,我们看到,LiberAI的手套厚度 0.3mm,重量 131g,肤色外观,目的是让画面里的手套接近于裸手,和互联网上海量第一视角视频里手的样子更一致,视觉上的gap变小。
视觉gap有多小呢?大家可以看看这个视频。
虽然团队没有直接给我们披露手套的方案,但我们还是可以做一些推测。
从配图看,采集员胸前固定着 Quest 头显,双手手背上绑着 Quest 控制器,腕部另有手套控制盒。推测Quest 这套设备主要用于追踪手部的位置和朝向,再通过标定换算为腕部位姿;
头显固定在胸前而非随头佩戴,也有助于减少转头造成的视角变化。这样的布置有利于缩小采集视角与部署视角之间的差异。
腕部控制盒可能负责手套信号的采集、处理与传输;背包可能容纳计算、存储或供电设备;腹部的 Interactive Module(交互模块)则可能用于启停采集、查看状态等操作。
手掌下还搭配了两个腕部相机。不过手套本身的方案确实无从而知了。
不需要机器人在场,人戴着手套在任何环境里都可以采,能规模化地在不同人、不同任务、不同场景下积累数据。
在采集的数据上,LiberAI 保留了原生数据与手部构型表征。
人手与机器人灵巧手的大小、指长和关节配置不同,采下来的动作究竟怎么用?我们问到如何保证 retargeting,也就是把人手动作重映射到机器人时的精度,凡淇给出的回答有些出乎意料:
“首先我们的一个想法就是不做 retargeting。”他随即补充,遥操作仍然需要重映射,这里指的是采下来的手套训练数据。把一只小手完成任务的轨迹强行转换到大手上,可能出现穿模或接触不到物体的问题;保留原生数据,可以避免这一步额外引入的精度损失。
保留原始动作之后,模型还需要知道:这个动作是由一只什么样的手完成的。LiberAI 将手的形状作为 embodiment context(本体条件)显式输入模型。手掌大小、宽窄、手指长度等由标定系统获取,再用连续的几何参数表征,并非简单分成“大手”“小手”几类,也不是把张手、捏握这样的手势当成构型。
技术报告中的统一本体表征进一步覆盖身高、臂长、身体配置和手部几何,以及机器人手臂、灵巧手的几何与运动学信息。训练时,模型将这些条件与画面、当前物理状态和指令一起用于动作预测;部署时,则输入目标机器人的本体表征。这样,同一个任务在不同身体上应该怎样执行,就成为模型需要学习的关系。这背后的假设是,当模型见过足够多种人手,且目标灵巧手足够拟人时,它有机会落在已学过的构型范围内,通过内插利用相近手型的操作经验。团队保持手套示范总量近似不变、任务和环境一致,只增加采集者人数:在仅用手套数据训练策略的设置中,1 人到 100 人对应的平均进度得分从 12.7 提升到 40.1。这说明,除了多采动作,覆盖更多身体差异本身也能帮助迁移。
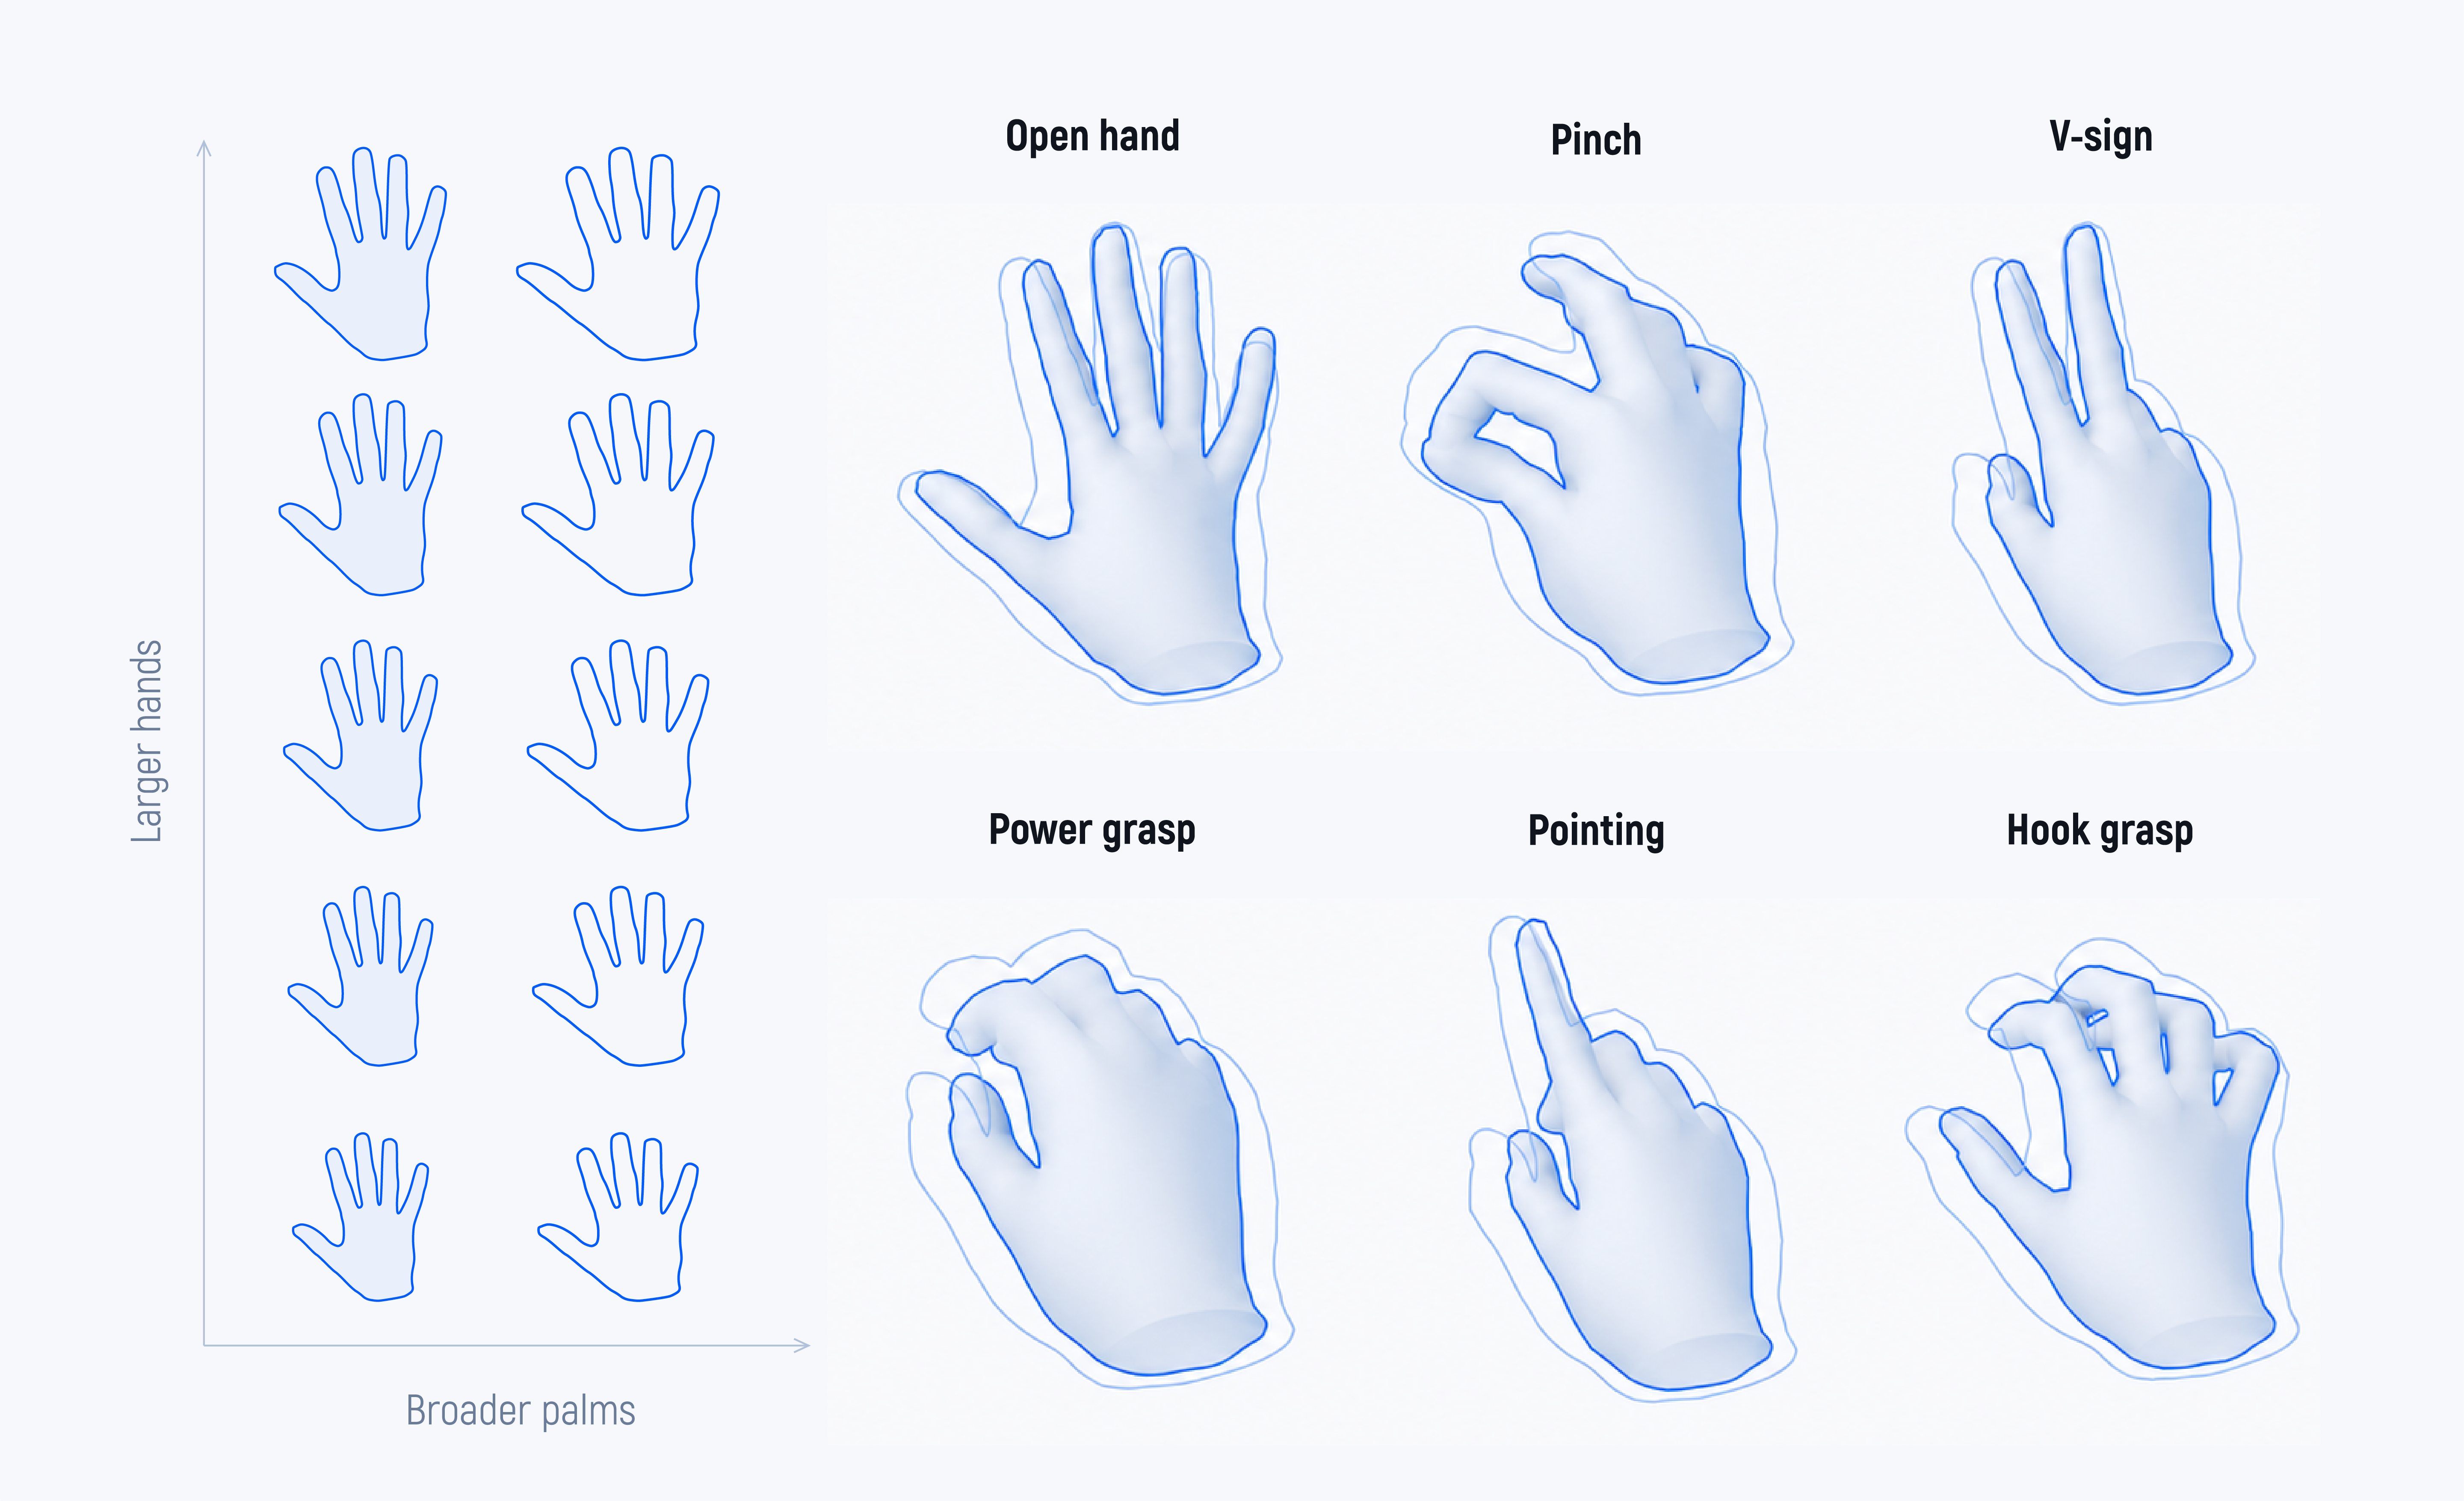
保持手套示范总量近似不变、任务与环境一致,采集者从 1 人增至 100 人。仅手套数据训练的平均进度得分从 12.7 升至 40.1;加入固定少量真机数据的设置从 60.6 升至 69.5。
另一个重要的 Co-Design 决策在机器人本体上。
除了手套之外,LiberAI还深入参与了机器人本体和灵巧手的设计。技术报告提到,Liber-0的三大设计原则里有一条是,“Bring robots closer to human data distribution”——不要让人类数据去迁就机器人,而是让机器人长得像人。
和默认机器人硬件已经确定(例如 Franka、UR 这类工业机械臂),想办法把人类数据“翻译”成这个机器人能用的格式的Retargeting做法相比,Liber-0 的做法是,在设计机器人本体时,就按照“人类数据长什么样,机器人就长什么样”的原则来做。Liber-0 的机器人本体 Leo 具有几个具体特性:五指灵巧手(匹配人手)、人类对齐的腕部和腰部关节(匹配人的运动范围)、匹配的第一视角相机配置(匹配手套采集时的相机位置)。
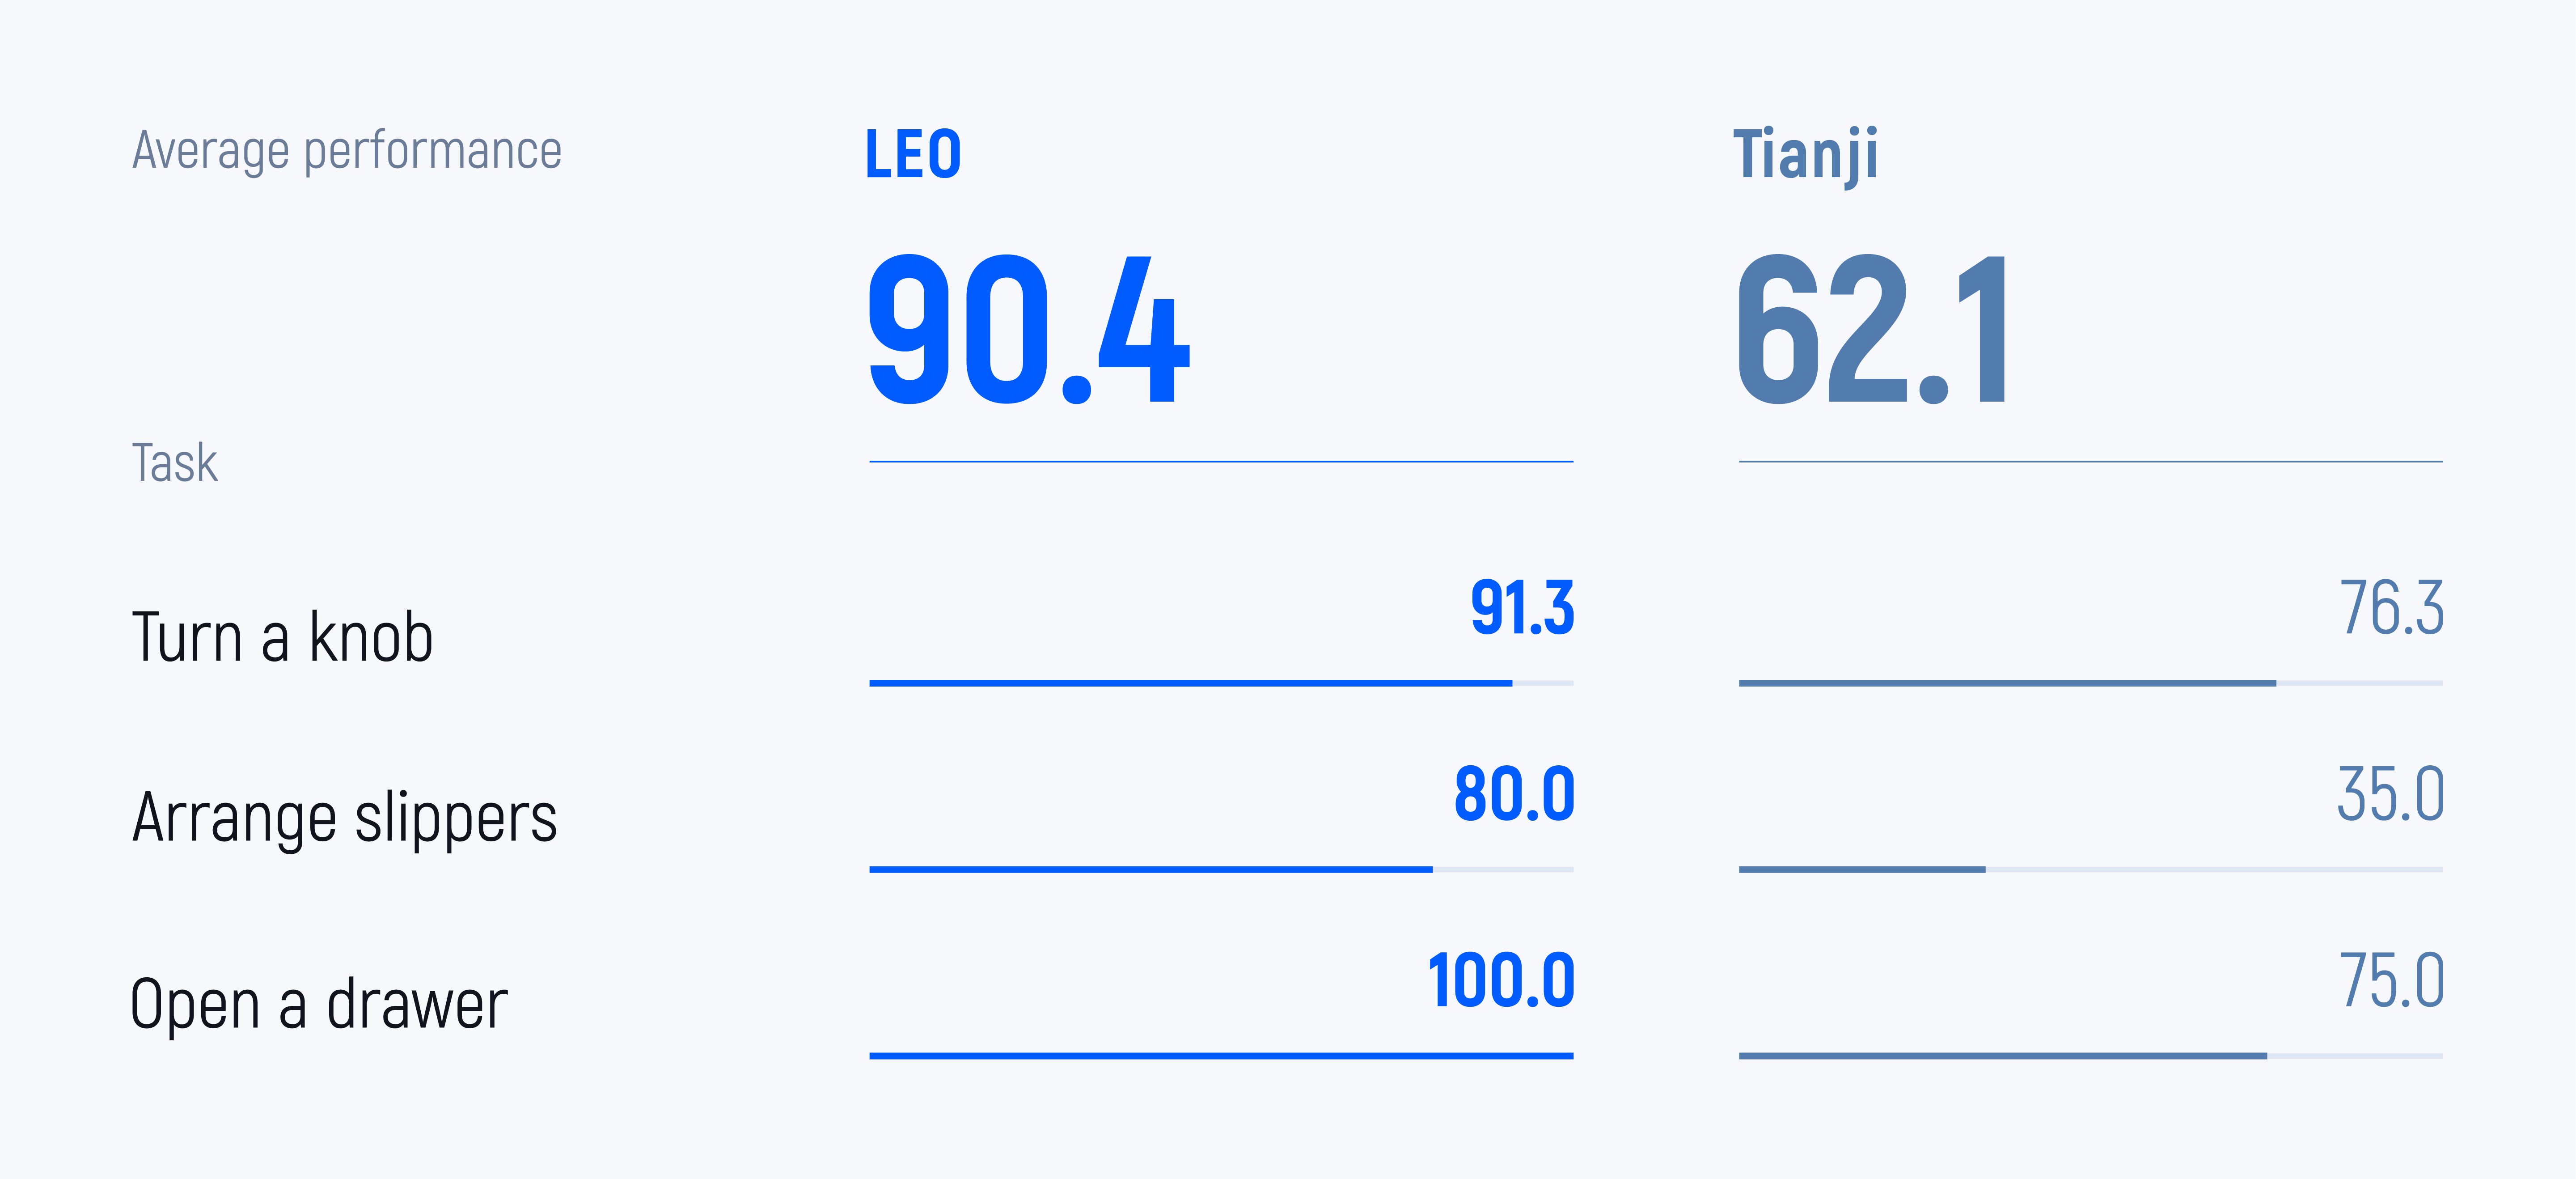
用相同的手套数据、等量的平台特定遥操数据训练,在转旋钮、整理拖鞋和开抽屉三个任务中,LEO 的平均进度得分为 90.4,和对照组相差 28.3 分。这些任务分别考验大幅转腕、低位触达和有限空间内的手指操作;这里采用的是 0—100 分的进度指标。
02
模型、架构与数据的协同设计
这些不同精度、不同本体的数据,最后如何放进同一个模型?凡淇给出的量级是:约 200 万小时互联网人类视频、十多万小时开放及供应商 Ego 数据、小几万小时跨本体机器人数据,再加上几万小时手套数据和几千小时自有遥操数据。数据池的时长,并不等于训练时每类样本被看到的比例。
Liber-0 的预训练分三个阶段,逐步改变学习目标和数据采样配比。互联网数据提供广泛的场景与行为覆盖,手套和遥操数据则随着训练推进获得更高权重,强化动作生成。
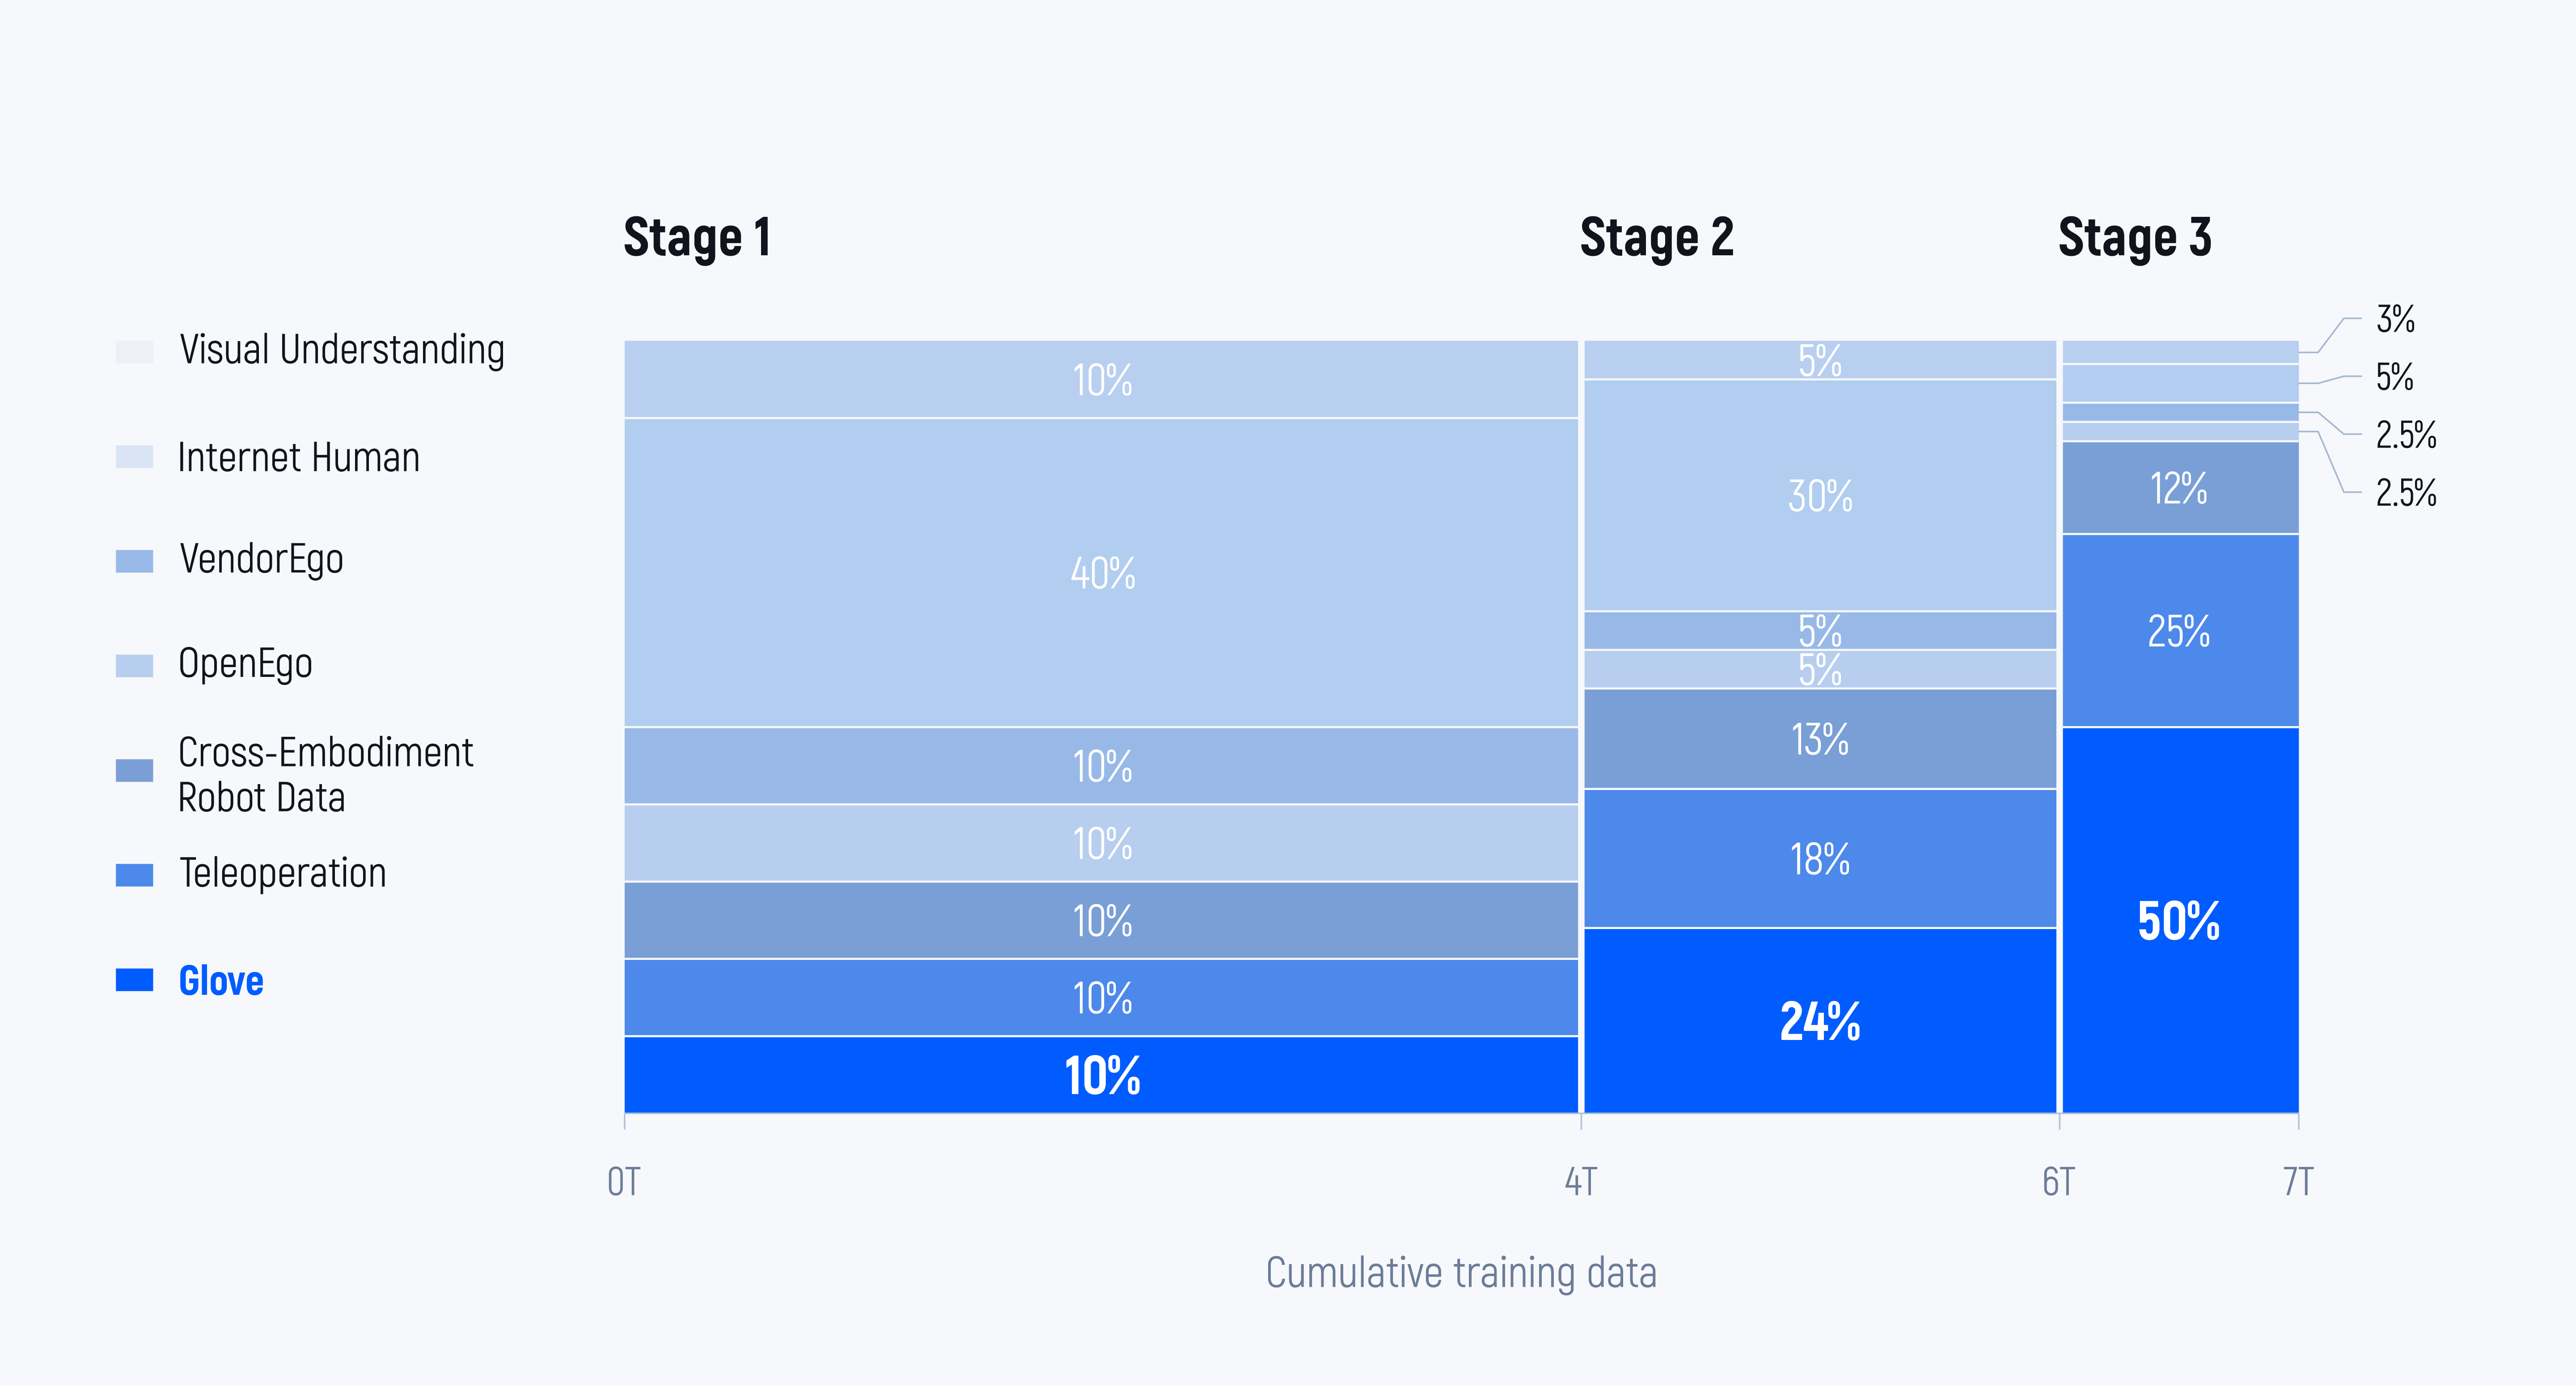
第一阶段先学视觉预测,不设置动作训练目标。互联网人类视频的采样占比为 40%,模型通过预测交互中的后续画面,学习物体、环境和动作结果之间的关系。凡淇解释,配比的制定既参考各数据源的原始规模,也参考它们在 scaling 实验中对最终能力的贡献。
第二阶段加入动作目标,联合预测未来画面与动作。手套数据的采样占比从 10% 提高到 24%,遥操从 10% 提高到 18%。有动作标注的样本提供动作监督,没有动作标注的视频仍用于视觉预测,让模型在学习如何动手的同时,继续保留广泛的视觉经验。
第三阶段进一步聚焦精细操作,手套和遥操的采样占比分别提高到 50% 和 25%。凡淇认为,前两个阶段建立的理解能力,需要通过更高质量的动作数据细化到实际执行。在这一阶段之后,模型直接部署的表现已明显提高,再用机器人数据做任务特定后训练,增益就小了很多。
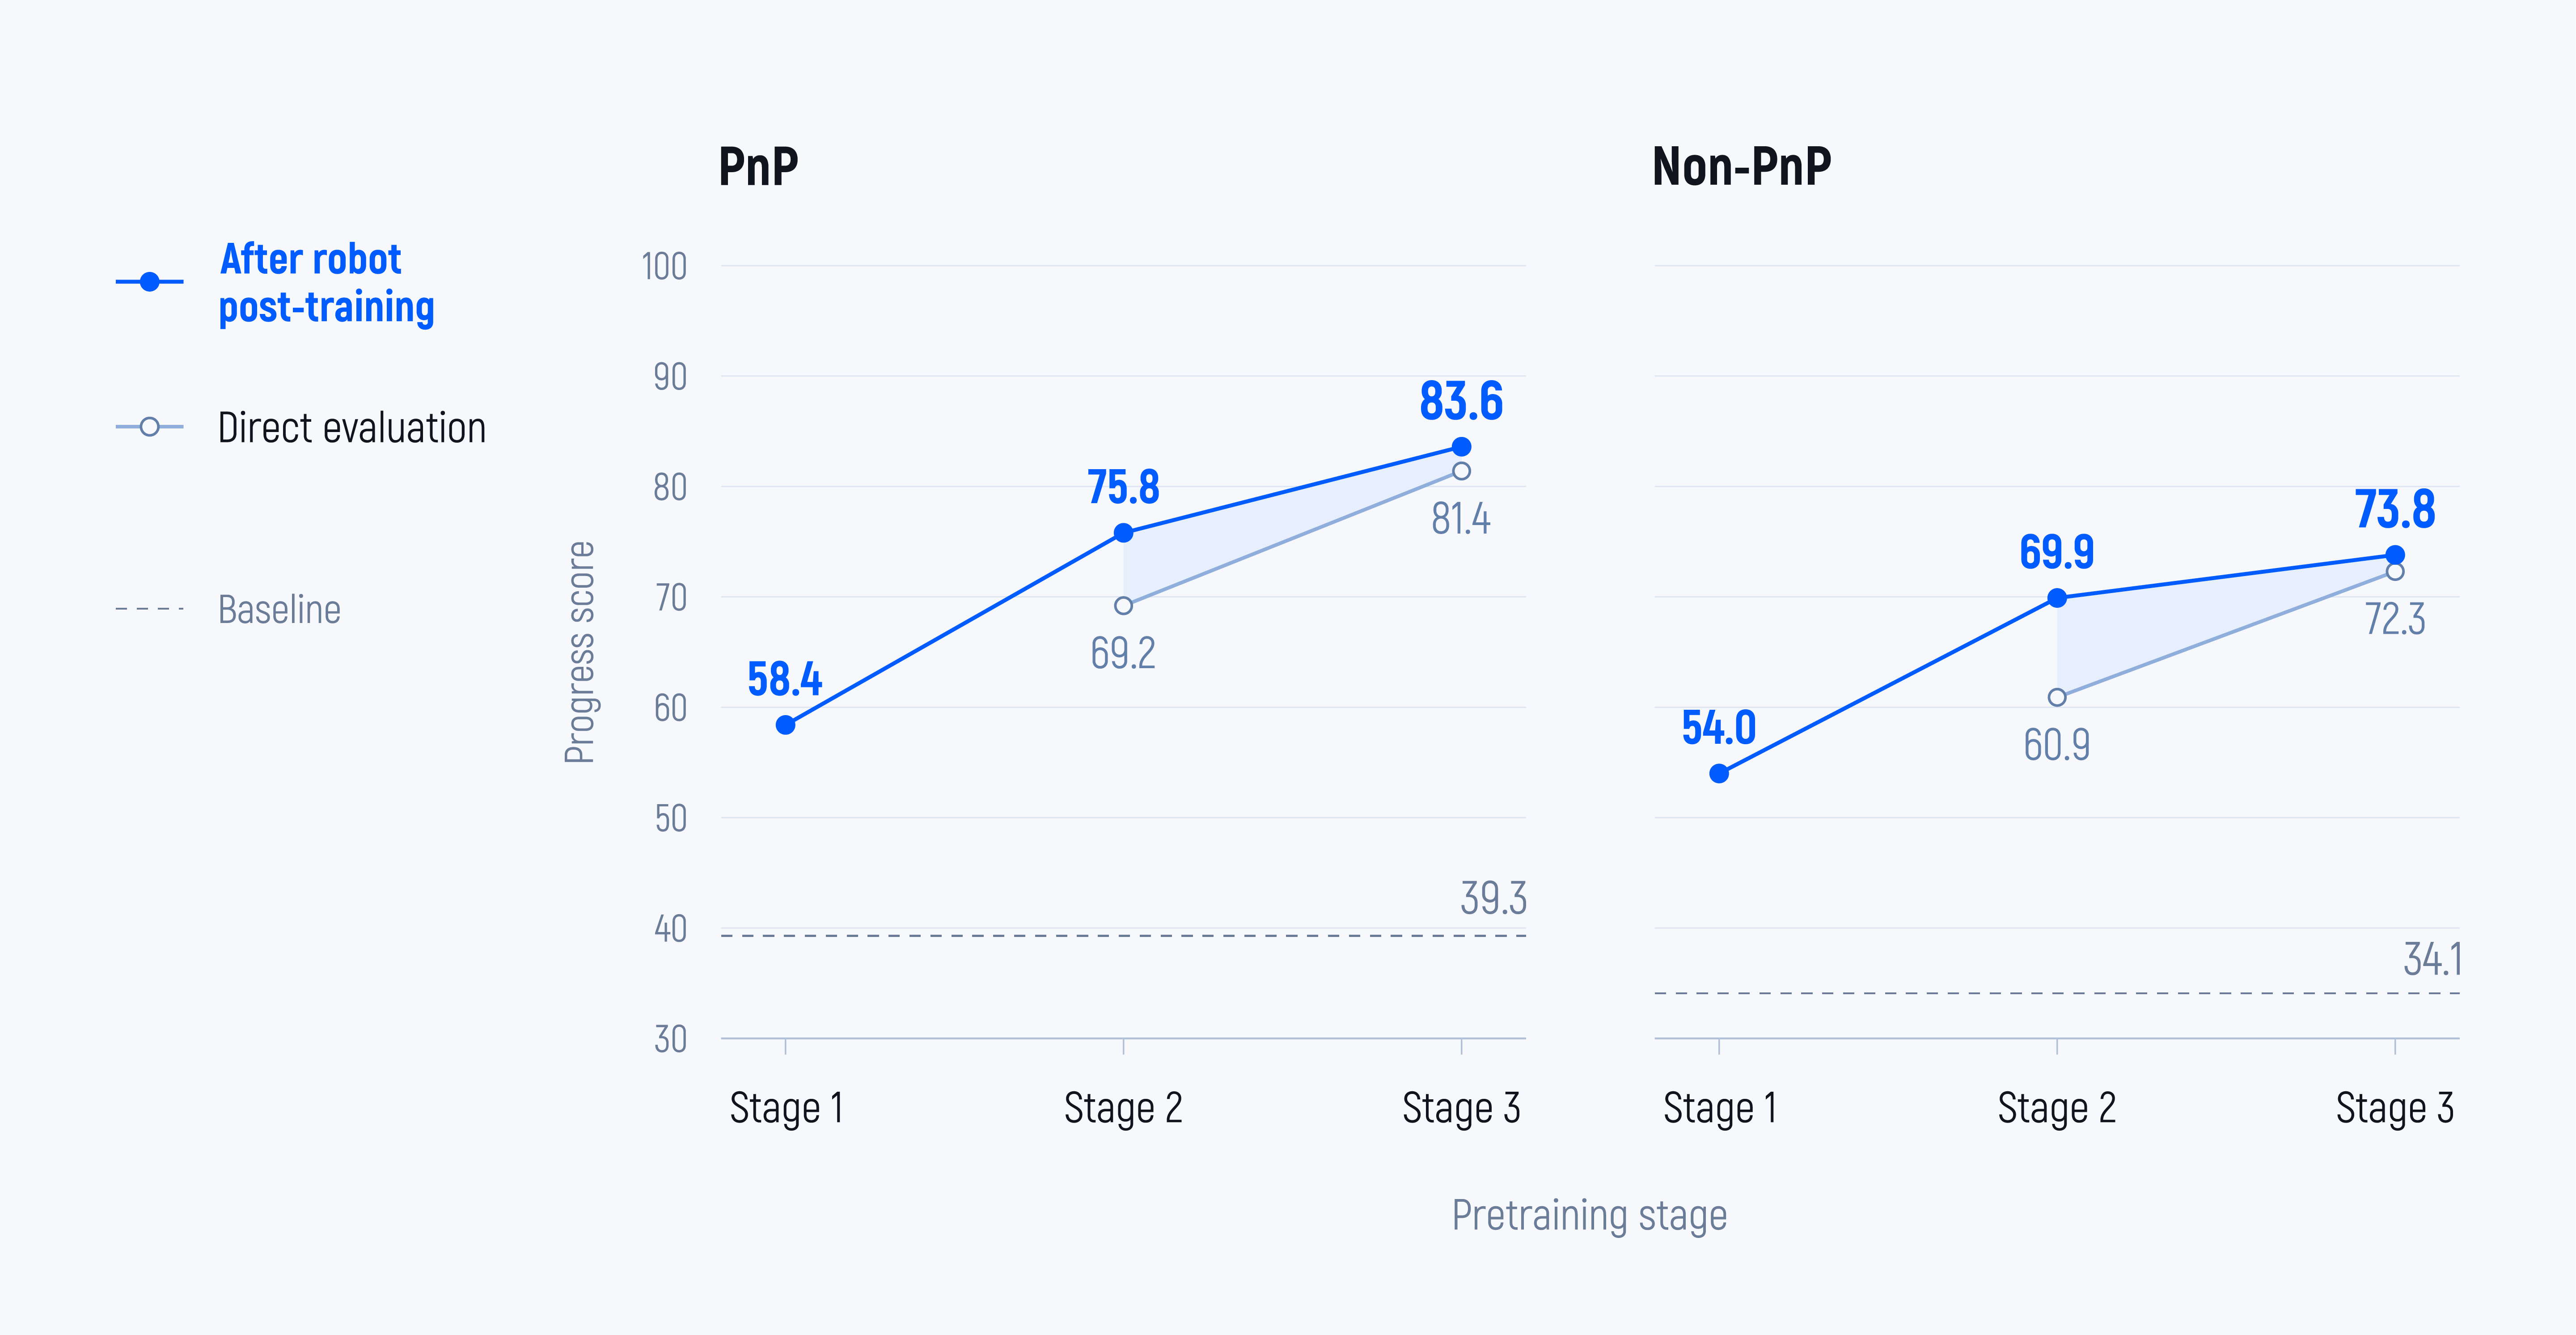
Stage 3 后再进行机器人后训练,PnP 进度得分从 81.4 升至 83.6,Non-PnP 从 72.3 升至 73.8,分别提高 2.2 分和 1.5 分。
Liber-0 整体是一个三流架构,语言流(处理指令)、视觉流(处理当前帧、历史帧、噪声未来帧)、动作流(处理机器人物理状态、本体信息、噪声动作)。三流通过 Multimodal Attention 连接,保留各自的模态处理能力,同时实现联合预测。
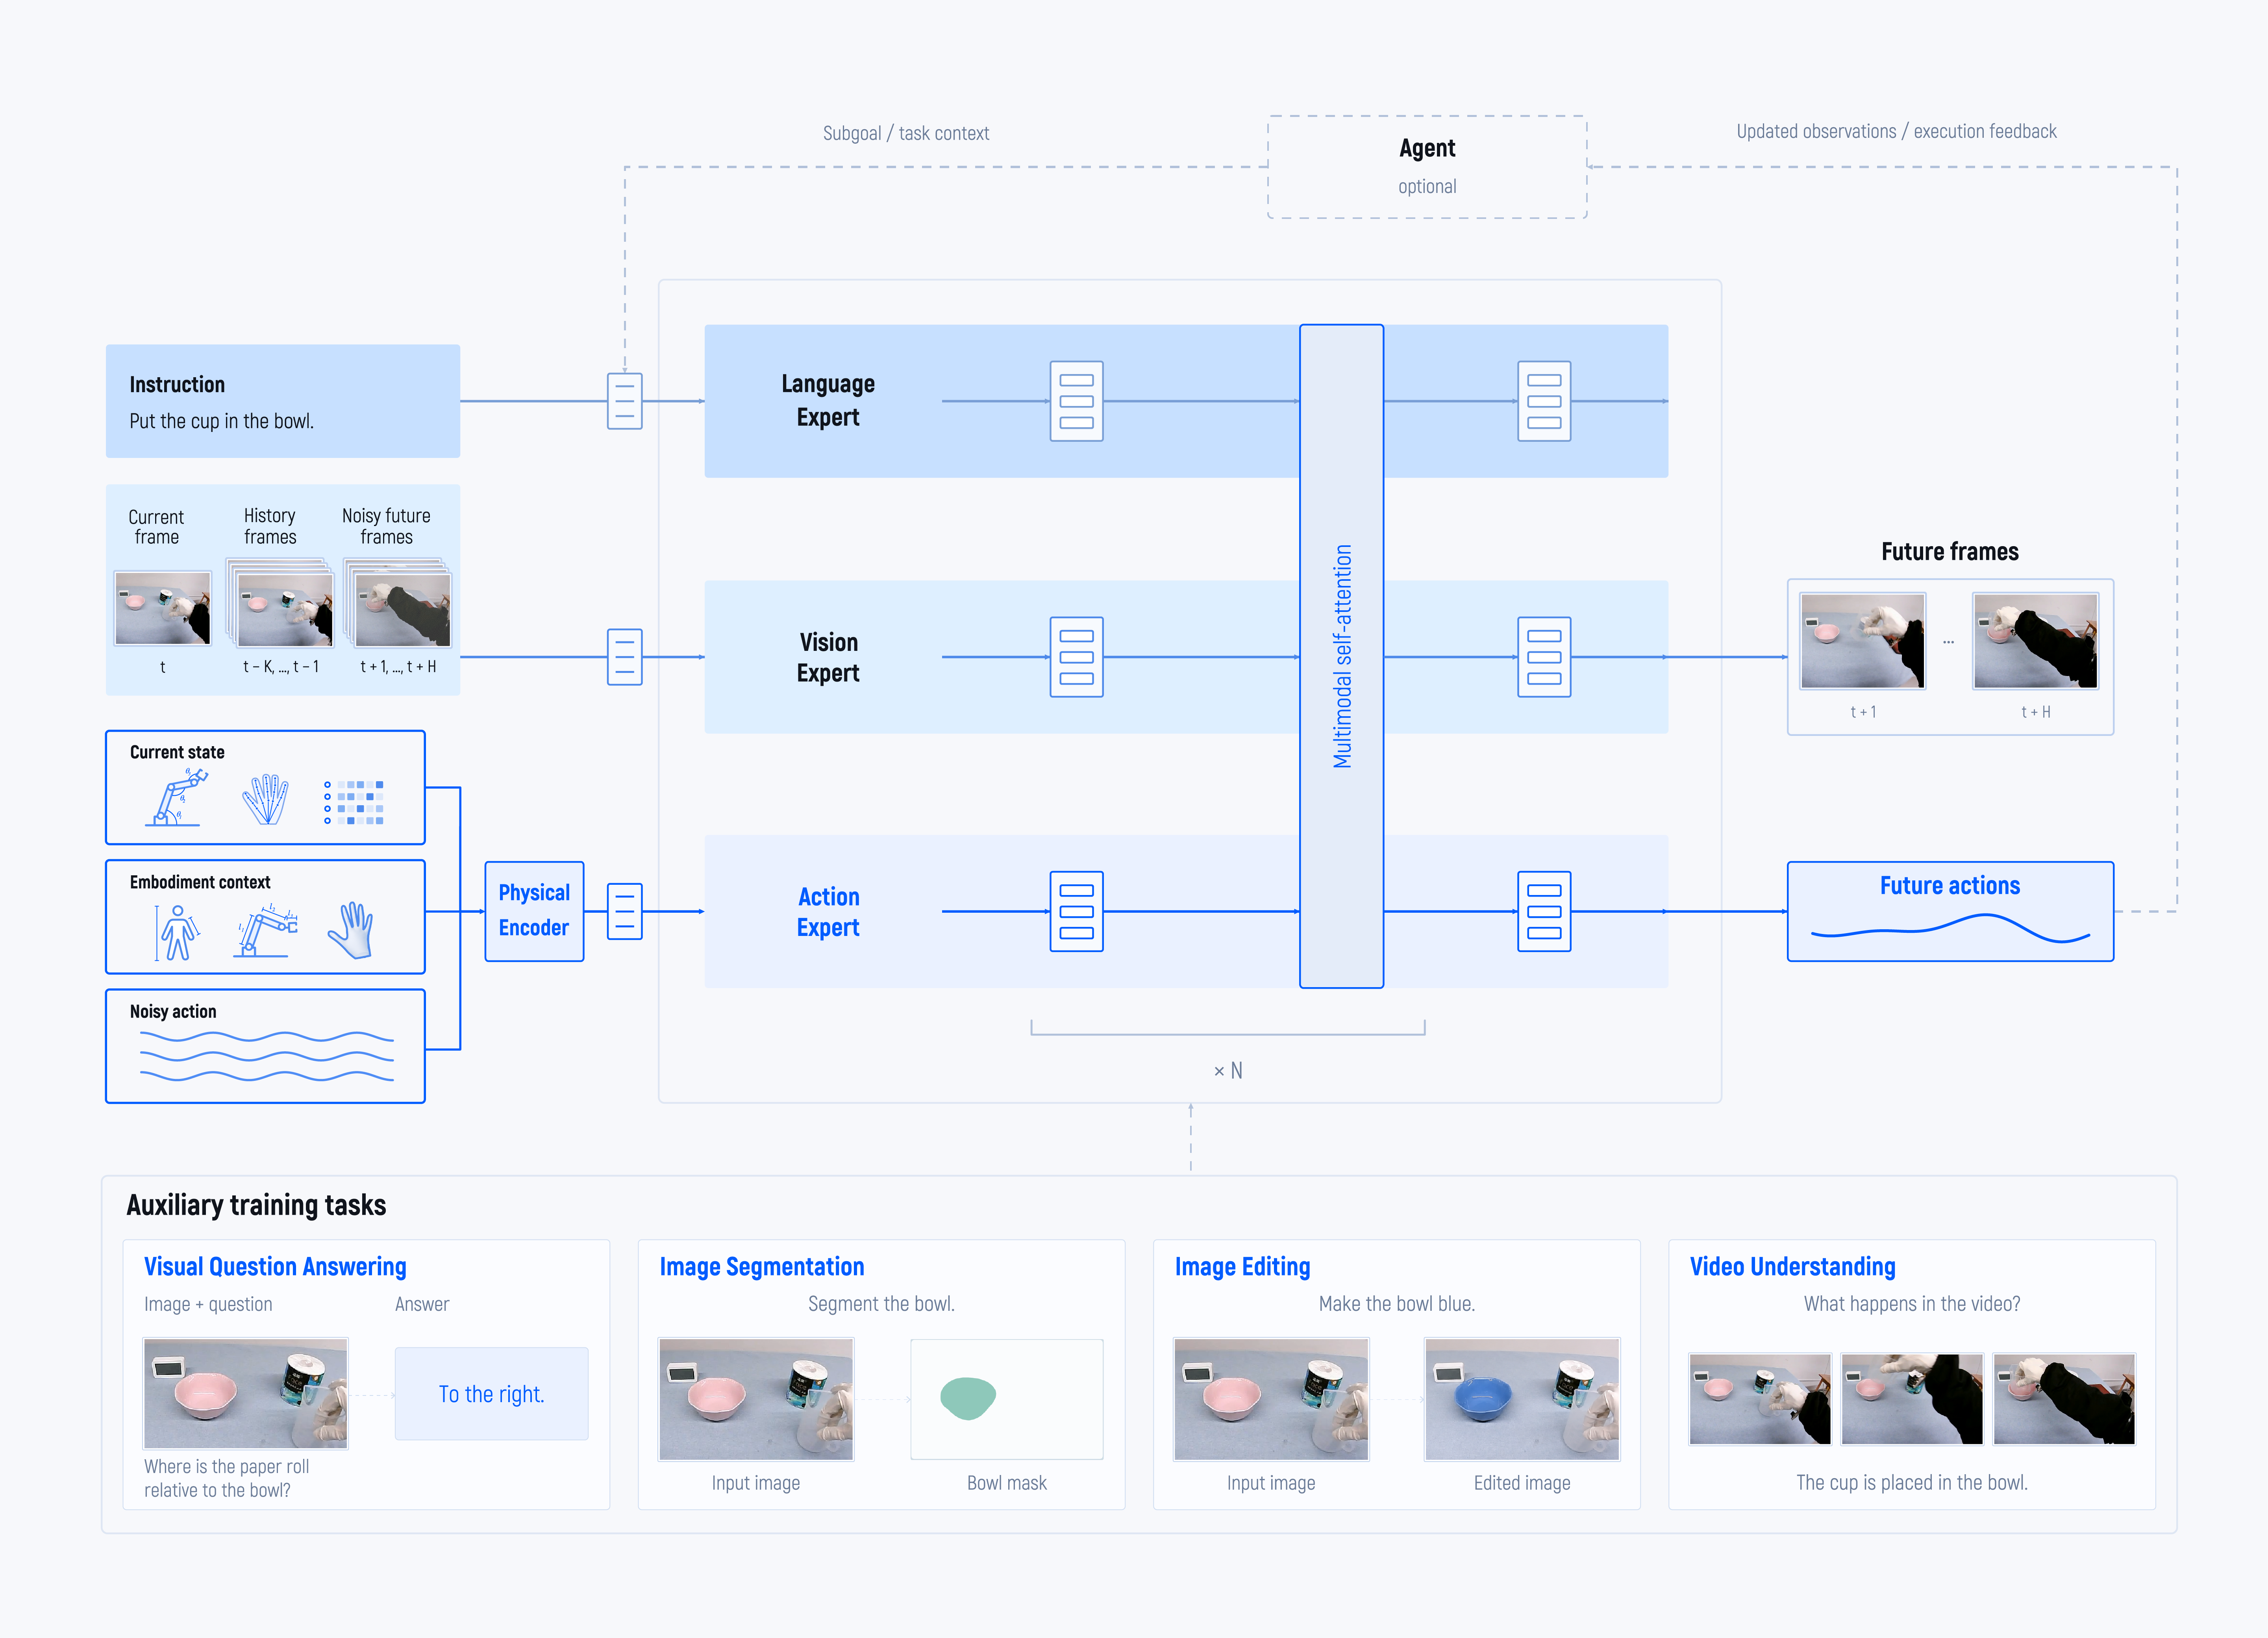
Liber-0 的模型架构。三流处理语言、视觉和动作
这套架构也决定了数据处理方式:视频预测提供“交互之后会变成什么样”的监督,带动作标注的数据再补上“哪些运动产生了这个结果”。此外,团队还混合训练视觉问答、图像分割、图像编辑和视频理解任务,补充物体语义、空间位置和任务进度的信息。
凡淇强调,加入 action 之后,模型仍然保留大量视频训练,“来去让它不去遗忘 language 和 video 的这些能力”。动作学习与视觉学习需要在同一个训练过程中持续进行。
我们追问, 在整个训练过程中,要怎么保留更强的 language following 的能力呢?
凡淇认为,更多带有语言信息的 data,加上更大数据量,能部分解决 language following 的问题。“训练数据量很大之后,其实它的 language following 本身的能力就会很明显的上去。”
“我们之前一开始是每个数据模态单独验证,但是我们发现,把所有模态的数据混起来训,数据量一下子大了很多,即使我不做任何的调整,它的这个生成的能力就强了非常多。很多任务。我们给指令,去看他生成的图片的一些效果,基本上都能有一个比较不错的趋势。”
同时在技术报告里,公司还披露了很多数据构造上的设计思路,包含视觉问答 (VQA)、图像分割、图像编辑、视频理解等。
“像我们有一些 image editing 的原始数据,甚至我们会把一些 segmentation 这种数据也构造成一些 image editing 数据,来原生适配我们现在的生成式的架构。”
“比如说 segmentation数据是一张图里的不同物体分割出来,模型就需要去理解这个物体的语义信息。我们还会专门构造一些 sub task prediction 的数据,它就需要去理解我当前应该干什么,不同阶段应该干什么,action 应该怎么做等等。”
LiberAI团队认为,data还是 scaling 的重要环节。“随着自研手套数据、遥操数据等高质量数据量越来越大,包括action 生成、视频生成在内的很多问题慢慢都会被解决。”
03A
stra如果下场做,也需要吃一遍手套数据的苦
我们也把两个老生常谈的问题抛给了凡淇。Astra会吃掉System 1或者System 0 吗?
他的判断是, Astra的能力非常不错,但对灵巧操作的直接控制能力还是不够,且在非pick and place任务上表现还有很大提升空间。
在由 GPT-6 提出的 60 个任务中,三类任务各 20 个,Liber-0 的 Zero-Shot 成功率分别为 63.5%(PnP) / 34.0%(普通 Non-PnP) / 10.5%(挑战性多步骤、长程 Non-PnP),总体为 36.0%;Astra-only 对应为 8.3% / 5.0% / 1.7%。Liber-0 每个任务测试 10 次,共 600 次;Astra-only 每个任务测试 3 次,共 180 次。
而非pick and place的本质是人的操作直觉,无法用数学、coding来穷尽。
“Astra的思考方式其实是把这个问题抽象成一个偏数学、偏 coding 的一个问题。他首先需要去理解这个环境,比如这个环境里都有哪些物体?目标物体在哪里?我的手在哪里等。在理解这些之后,他就把这个建模成了一个偏数学的一个问题来去解。这样一种范式,我觉得就是其实人并不是这么做的,人并没有把这个问题那么复杂化,人大部分的操作还是偏直觉。”
“比如说我们试想一个日常生活中任务,比如说像做饭煎蛋里面,你要把用铲子给这个蛋翻个面,这个任务里,需要把铲子插到蛋和这个锅的中间,这里面,这个蛋可能还会随着铲子的碰撞而去移动,你都需要根据现实场景里面的触觉或者物体的实时移动,非常快地调整你的动作。”
“像 System 1这种比较偏直觉的生成,需要闭环控制,同时对精细程度有比较高要求的任务,还是需要有一个小脑的系统来去完成的。”
我们又问,如果大模型公司下场训练手套数据呢?那是不是需要更小的数据或者代价?
LiberAI 团队认为, System 1要求实时闭环的反馈,势必没办法通过复杂的推理模型去做,对模型的尺寸、大小、参数量来说也会有上限约束。
凡淇进一步区分了两条路径:如果用 Astra 合成数据,再训练能够快速生成动作的具身模型,仍要回到动作数据和本体适配上;如果希望保留 VLM 的推理范式,把复杂 reasoning 能力直接蒸馏到很小的端侧模型中,他认为难度很大。
这里的判断是复杂推理能力难以在满足实时性的同时完整保留,更强的通用模型,也不能直接省去动作模型所需的数据和硬件适配工作。
如果端侧终将回到一个几十亿的小模型上,大模型公司和具身公司其实又站在了同样的起跑线上。
“我觉得其实还是会回到现在具身在做的,用一个几十亿的模型加上大量的数据,去让它具备这种快速生成 action 的能力。因为具身是一个很复杂的、很长的一个链路,它跟硬件是深度绑定的,你的本体会决定你需要什么样的数据。”
在数据采集回传、硬件和训练的Data Infra的闭环上,凡淇认为,这将是具身公司面对大模型公司的壁垒。
在 LiberAI 的路径里,最核心的壁垒,是离本体最近的那一层动作数据,以及持续把它采出来、用起来的能力。
具身智能的护城河,最终要在与物理世界的一次次交互中建立,把紧贴本体的操作经验积累成难以复制的数据,再将这些数据转化为机器人持续增长的能力。
推荐阅读

×
右键可直接复制图片