 阅读时间大约6分钟(2124字)
2026-11-12 猫的反应这么快,具身智能能学到什么?
来源:具身智能前沿
猫的灵活让人想到一个问题:机器人把短时预估和快速纠错做好,能完成多少操作?
作者:我不是毛毛 出品:具身智能前沿
导读
从猫的灵活得到的一个启发,是把短时预估、及时反馈和动作执行放在一起看。机器人即使能产生正确动作,也可能因为执行太迟而失败。同模型时延实验展示了速度怎样影响任务表现;世界模型的不同用法则提醒我们,预测可以帮助学习、生成动作或比较后果,不能只按“想得远不远”判断价值。
猫只是反应快吗?
猫扑向移动玩具时,很容易让人把它的灵活归结为“反应快”。顺着这个印象往下想,会碰到一个与具身智能有关的问题:很多操作是否不需要复杂推演,只要对眼前变化足够敏感、动作足够及时,就能做得很好?
AI生成猫注视并准备追逐移动玩具的场景示意,非实验照片
猫的动作让人产生这个疑问,但要解释它,得先把“反应”与“预测”的关系看清。
一项发表于2001年的视觉追踪研究,让训练过的猫用眼睛追踪移动目标。目标暂时不可见时,猫仍能继续追踪;研究者对眼睛快速赶上目标的运动分析,也支持对目标运动的预测参与了控制。
这个实验考察的是眼球追踪,不能直接解释扑跳、抓取等全身动作。它提供的线索是:及时利用新信息,与预估接下来一小段变化,可以共同参与行动控制。
对机器人来说,可以先检验其中一环:模型已经能产生动作时,让它更及时地执行,能带来多大收益?
同一个模型,来得及反应就会做得更好吗?
视觉—语言—动作模型,也就是 VLA,会根据图像、指令和机器人状态生成动作。许多 VLA 一次输出一小段未来动作,称为“动作块”。机器人执行这段动作时,环境仍在变化,后续动作也要及时接上。
微软与 UC Berkeley 的《Offload or Overload》研究提供了一组直接对照。研究者微调同一个 π0.5,让双臂 SO-101 抓起胶带、从一只手交到另一只手,再放进盒子。每个计算平台测试20次。
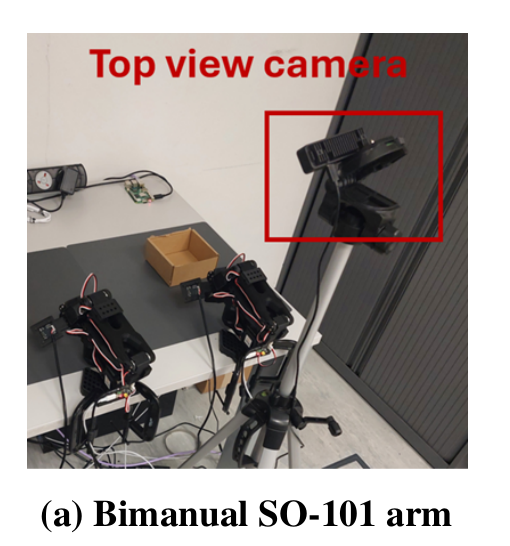
双臂 SO-101 与俯视相机的实验配置,裁自论文设备图来源:Offload or Overload,图1(a)
在 Jetson Orin AGX 上,生成一个动作块约需440毫秒,任务成功率为30%;换到 Jetson Thor,约144毫秒,成功率为80%;A100 服务器约60毫秒,成功率同样为80%。服务器对照的网络往返延迟低于15毫秒,不能直接当作普通公网部署效果。
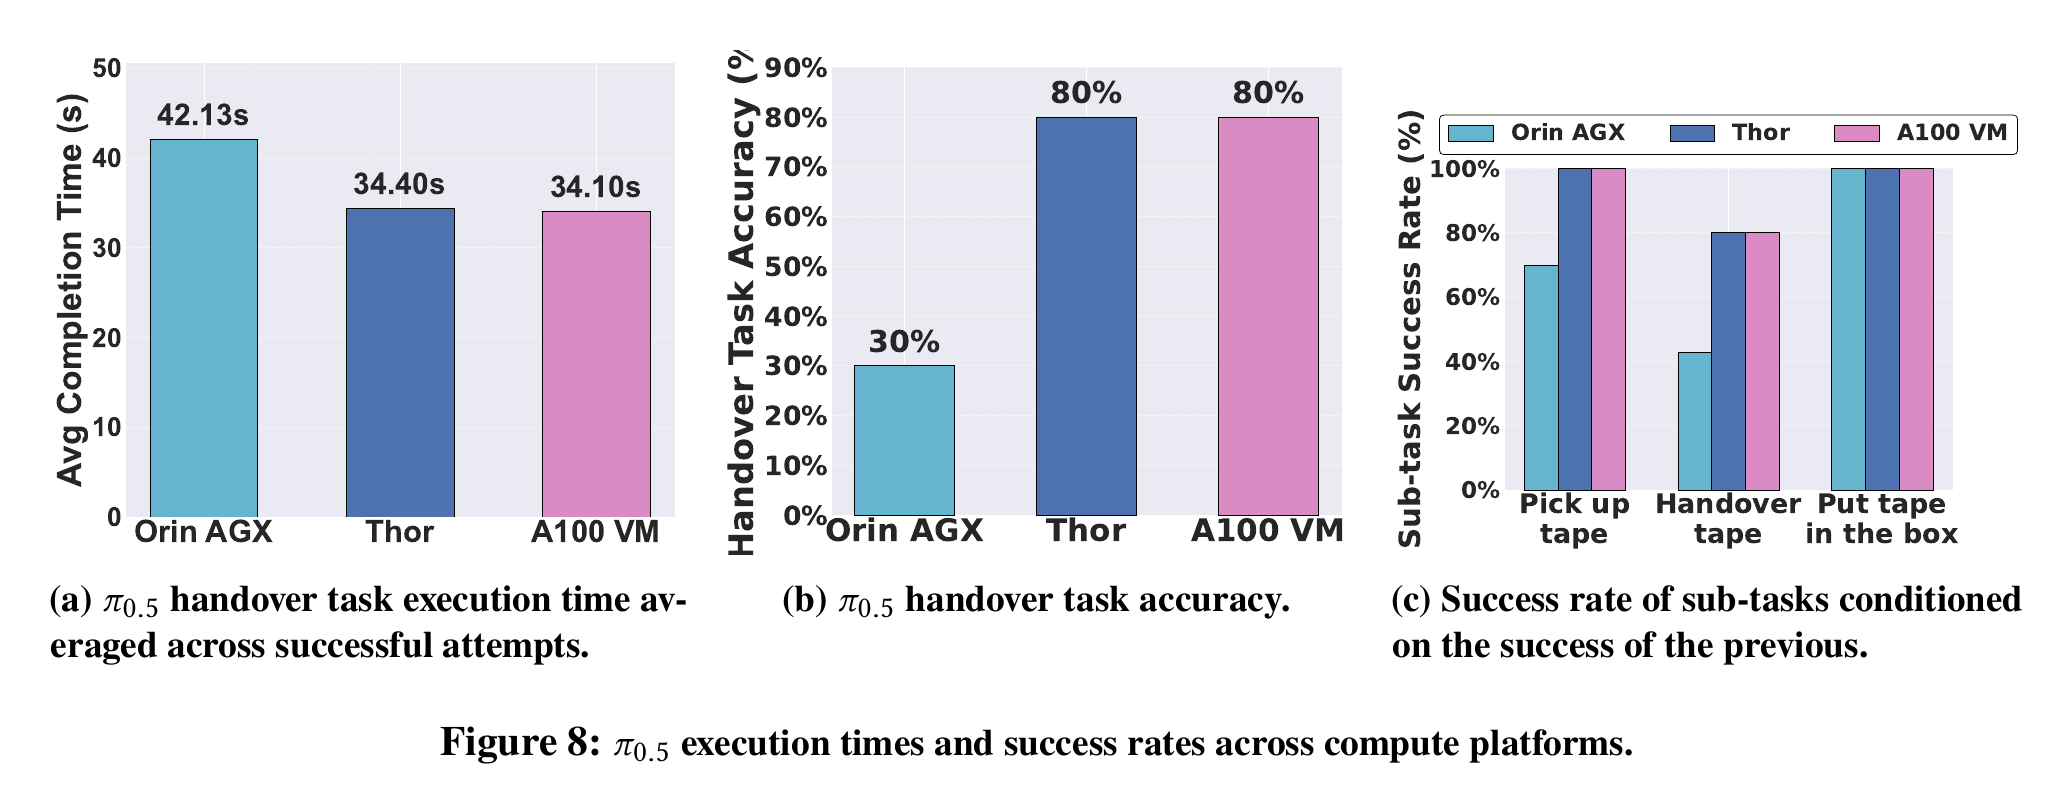
看中间的成功率对照;左图只统计成功试验的完成时间,右图是以上一步成功为条件的分阶段成功率来源:Offload or Overload,图8
作者观察到,慢推理会使旧动作队列耗尽,新动作还没准备好,机器人便出现停顿和抖动。抓取和双臂交接需要较精确的对齐,这些执行问题会影响任务完成。
模型相同,执行系统能否及时、连续地送出动作,仍会改变任务表现。这组比较每个平台只有20次试验,硬件也同时变化;从144毫秒继续降到60毫秒,成功率没有继续提高,不能据此画出一条“越快越好”的普遍规律。
为了更直接地检查时延本身的影响,VLALagBench 固定模型参数,在仿真中人为加入推理延迟。以 π0.5 为例,在目标以每秒0.1米移动、同步执行的设置下,向移动盘子放置物体的成功率,从零注入延迟时的71.5%,降至100毫秒延迟时的40.5%。这里的“同步执行”,是先执行一段动作,再停下来等待下一次推理。每个设置测试200次,等待不占用动作执行次数预算。
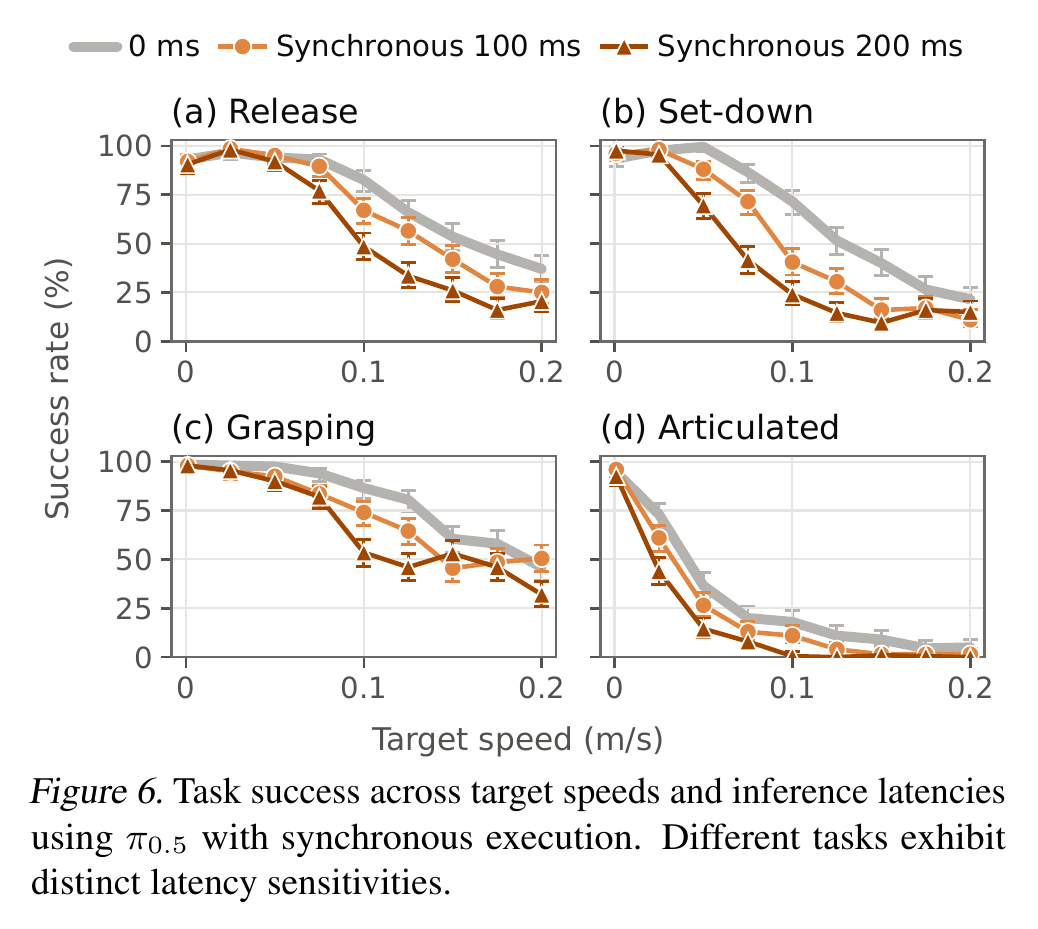
横轴为目标速度,纵轴为成功率;灰线为零注入延迟,橙色两线为100与200毫秒延迟,均采用 π0.5 同步执行来源:VLALagBench,图6
为什么只差100毫秒,也可能改变结果?研究将影响区分为观测过时和动作停顿:前者让机器人依据旧位置行动,后者打断持续追赶或接触。同样是目标以每秒0.1米移动,抓取任务的成功率从86.5%降到74.0%,降幅小于放置任务。时延的代价,取决于目标怎样变化、操作需要多精确,以及动作是否必须连续。
这些实验支持一个有限但实用的判断:机器人表现不好时,值得先检查它是不是反应得太迟,再判断是否缺少更复杂的推理能力。
把预估做短,把纠错做及时
设想一个抓取传送带零件的任务,用它说明短时预估与反馈怎样配合;这不是上述论文的实测案例。
相机看到零件当前的位置,但机械臂运动、夹爪闭合都需要时间。只朝当前坐标伸手,到达时零件可能已经离开。系统可以根据近期运动,估计夹爪到达时零件的位置,再朝那个位置运动。
这份预估不必一次覆盖整个任务。运动中重新观察,发现零件速度变了,便更新后续动作。预测承担的是接下来这一小段时间里的引导,现场反馈不断检查它是否仍然成立。
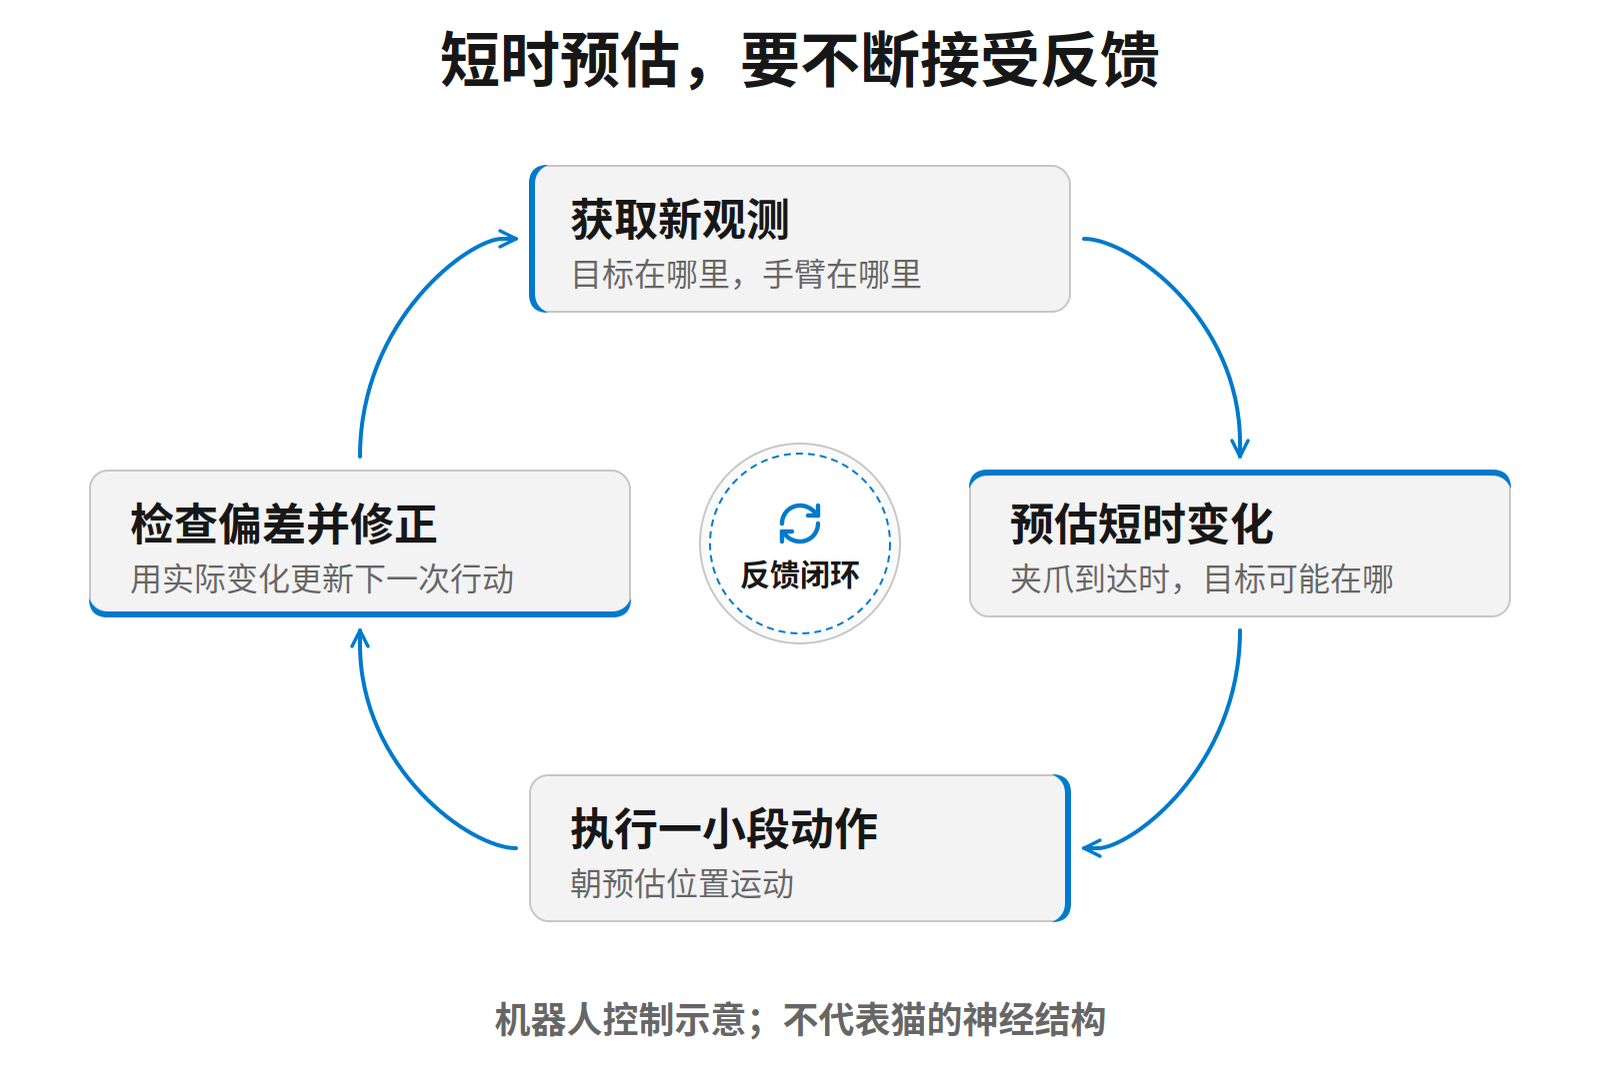
如果零件清晰可见、运动相对稳定、夹爪尚未接触,偏差通常还有修正机会。短时预估配合及时反馈,就可能成为高效操作的有效方案。具体成功率仍需在目标设备与任务上验证。
预测多远,与多久能够得到一次有效反馈有关。更新及时,系统可以不断用现场信息修正短期判断;长时间得不到新信息,就要承担更大的预估误差。
同样,快也要落实到整个过程。相机拍得快,图像在队列里等待,机器人用到的仍是旧信息;模型算完了,机械臂来不及减速、夹爪关不拢,也无法完成抓取。频繁生成新动作,还需要处理前后衔接,避免不断改主意造成抖动。
因此,从猫的灵活联想到机器人,我更关心的是一次变化发生后,系统多久能获得信息、作出调整,并让身体真正响应。单次推理耗时只是其中一环。
那么,世界模型的预测在补什么?
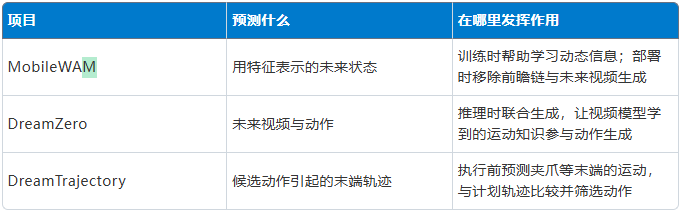
世界模型用环境状态与动作等信息预测后续变化;世界动作模型,也就是 WAM,把世界建模与动作学习结合起来。讨论它们是否值得用,先要区分预测参与了哪个环节。
下面三个项目展示了不同用法,并不是性能排名:
从猫的灵活,重新看行动能力
回到最初的问题,猫的灵活给机器人的启发,可以落实为一组具体的评测问题。
评价一个机器人,可以同时看两件事:面对陌生情况,它能提出怎样的动作;情况发生变化后,它又能多快发现偏差、修正动作,并稳定地执行出来。
对范围明确的操作,我会先检查观测有多旧、动作会不会断,再验证短时预估和反馈更新能做到什么程度。需要加入额外预测模块时,就比较它带来的成功率收益、完成时间和计算成本。
一次预估不够准确,如果还有时间修正,任务仍可能完成;一个判断即使正确,错过了执行时机,也可能失去作用。猫的快速反应,值得带给具身智能的思考,就在这个紧密连接感知、判断和身体行动的时间过程里。
推荐阅读

×
右键可直接复制图片