 阅读时间大约8分钟(2985字)
2026-11-20 苹果 HALO 开源解读:宇树本体、千问模型与三层架构如何拼在一起
来源:豆包
HALO不是一个聊天大模型,是一套从感知、规划到实时执行的整机自主方案。
作者:余柯 出品:机器人产业应用
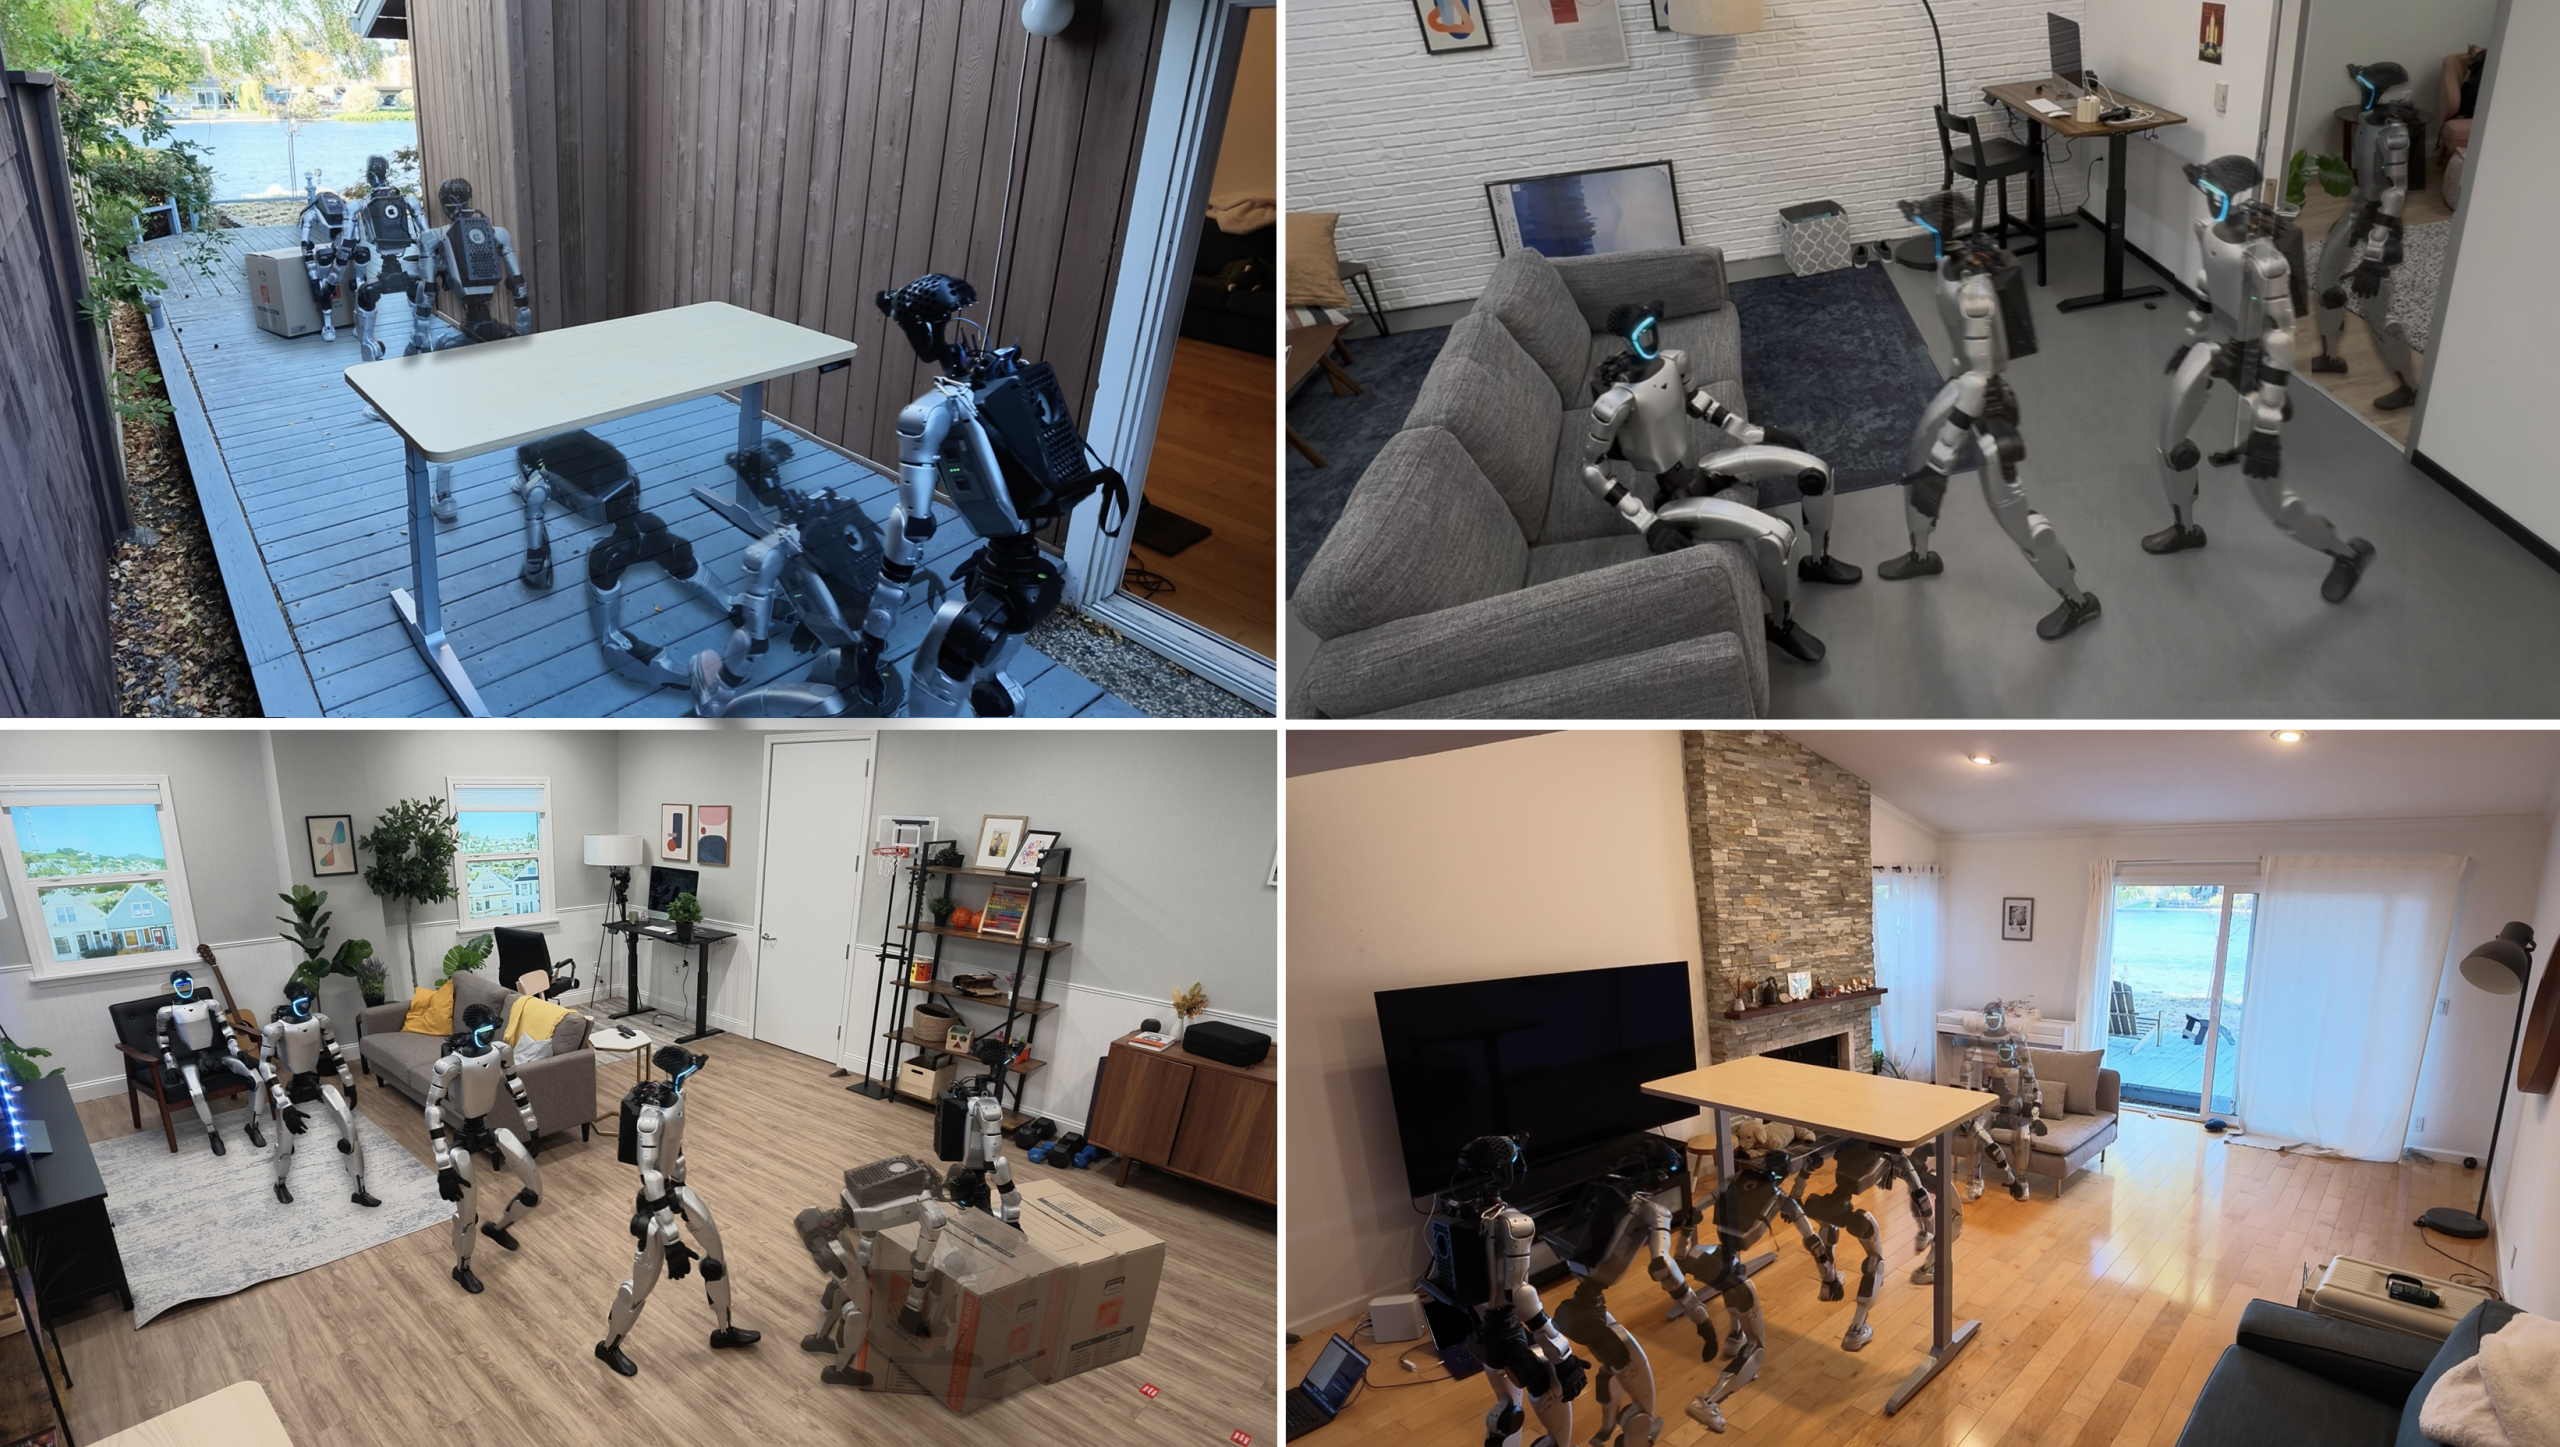
2026年11月4日,苹果研究团队在 arXiv 挂出预印本论文《Perceptive Humanoid Motion from Simulation》,提出一套名为 HALO 的人形机器人自主控制系统,并公开了数据生成、模型训练和部署代码。HALO 要做的事可以概括成一句话:让一台人形机器人拿着自己的第一视角画面,听懂一句自然语言指令,自主判断该往哪走、身体摆成什么姿态,再把动作连续执行出来——不需要预先扫描建图,整套编排和动作推理在机载设备上离线运行。
具体到演示出来的能力,机器人能走向指定的人和物体、在椅子上坐下、侧身穿过半开的门、蹲身或爬行钻过桌底,还能推动箱子;这些技能可以被编排起来,完成一段多步骤的组合任务。验证平台选的是宇树 G1,视觉语言理解借用了千问模型。
这篇工作真正想解决的,是从“听懂一句话”到“身体做出来”之间的衔接:机器人怎么从眼前画面里判断自己在哪、该干什么,语义怎么变成一段段全身动作,动作又怎么落到真实地面和家具旁边。换句话说,HALO 不是一个聊天大模型,也不是单跑在仿真里的运动生成器,而是一套从感知、规划到实时执行的整机自主方案;它的特色在于整套训练数据主要由仿真流水线合成,模型学完后直接迁移到没见过的真实家庭环境里跑。
01
宇树和千问各自提供了什么
身体这一侧用的是宇树 G1,关节执行能力由机器人本体自带。研究团队做了两处改装:头部加装一颗广角相机,负责前向画面输入;背后固定一台 64GB 内存的 Mac mini M4 Pro,任务编排和动作生成都跑在这台机器上,底层动作跟踪仍交给 G1 原厂的 Jetson Orin NX。两台算力各管一摊,通过以太网异步通信。
千问模型在系统里分成两个角色。偏上层的 Qwen3.6-35B-A3B 负责听懂用户请求、把子任务排好顺序;偏下层的 Qwen3.5-2B 参与动作生成,把图像和文字压缩成后续动作网络能使用的特征。
这么拆开看就比较清楚:苹果这篇工作的重心,并不在某一块单独的大模型上,而在把这些现成能力接起来的中间环节——训练数据怎么准备,语义怎么变成全身轨迹,轨迹又怎么落到真实地面和家具旁边。买到同款机器人、装上同款大模型,离复现出这套能力,中间还差着这些环节。
02
三层控制为什么要分开跑
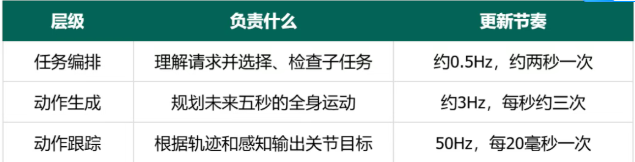
规划下一步往哪儿走,和维持身体不摔倒,容许等待的时间差得很远。判断下一个目标,可以多想一会儿;可一旦迈出去、身体已经倾斜,就不能等着大模型把话说完。HALO 因此把整套控制拆成三个相互配合、各自按不同频率更新的层级。
先看最上层。假设用户让机器人钻到桌子下面,再坐到椅子上,编排器要根据眼前画面把这句话拆成当前能执行的子任务,执行过程中还要判断:这一步是继续、重试,还是切换到下一个步骤。它调用的都是系统里已经有的技能——语言说得再自由,也不会凭空变出一种身体并不具备的能力。
默认编排模型采用 4-bit 量化,通过 MLX 在机器人搭载的 Mac mini 上本地运行,不联网也能工作;需要更强推理时,也可以改走云端模型的 API。Qwen3.6-35B-A3B 总参数约 350 亿,其中每次计算实际激活约 30 亿——后者说的是单次调用的计算规模,不代表模型只需要装下 30 亿参数。
中层再把“坐到椅子上”这样的子任务落成一段连续动作。它用冻结的 Qwen3.5-2B 编码器理解图像和指令,再配合 DiT 解码器生成轨迹。所谓冻结,是指训练动作模型时不动编码器已有参数,只重点训练后面的投影层和动作解码器——这样编码器保留了视觉语言模型在大规模图文数据上学到的通用表征,推理时也只需要跑一遍前向,不占优化状态。
解码器是扩散 Transformer 架构,HALO 用流匹配来训练它。说得通俗一点:模型从一团随机噪声出发,一步步把它雕琢成符合眼前场景和指令的动作序列。每份计划覆盖五秒,共 150 帧;每帧记录 29 个关节角,以及骨盆的位置和朝向,合起来每帧 36 个数值。
最下层负责把参考动作真正落到身体上。跟踪器读取计划、深度图、关节状态和惯性传感器信息,持续输出目标关节位置,再交给底层控制器执行;它跑在机器人机载的 Jetson Orin NX 上,按 50Hz 的实时闭环更新。
03
五秒计划怎样接上眼前的一步
五秒是向前规划的长度。机器人一边走,摄像头视角和身体位置都在变,中层因此大约每三分之一秒就重新规划一次:手里接着执行已有轨迹,同时用新观察修正后面还没发生的动作。
真正棘手的是两份计划交接的瞬间。旧计划刚让左脚抬起来,新计划如果突然换成另一种姿态,关节目标就会跳变,身体很容易晃。HALO 的做法是:把旧计划接下来 0.5 秒、也就是已经执行中的 15 帧动作保留下来,作为新计划不能改动的开头,再往后续写其余部分;训练时也让模型专门学习这种接续方式,保证相邻两段计划接得上。
这等于给正在发生的动作留出连续性,同时让更远处的动作保持可调整。顺着这个设计,三层的频率关系也就清楚了:上层定当前目标,中层不断修订路线和姿态,下层在更密的时间间隔里把计划执行到关节上。
跟踪器还要看得见近处的几何关系。关节传感器能告诉它腿弯了多少,深度图则补上身体周围的距离信息;两者配合,才有机会处理参考轨迹与现场之间的偏差。它的训练分三步走:先按技能家族各自训练 PPO 专家,再做多教师蒸馏,最后用强化学习微调,把能力收拢到一个可以在机载设备上运行的策略里。
04
动作数据怎样在虚拟房间里长出来
要让模型学会从图像和指令生成动作,需要成套样本:机器人看到了什么、收到什么要求、接下来怎么运动。如果每段样本都靠人遥操作采集,扩充数据就得一直投入采集时间,论文里也提到,遥操作和可穿戴设备基本是“花一小时人工换一小时数据”。HALO 尝试把大批样本的生产搬进仿真里,让语料跟着算力扩张,而不是跟着人工时间扩张。
以坐下为例,先把过程拆成行走、转身、落座几段;用 Kimodo 根据文字、路径点和关键姿态生成动作,再做几何检查,评估有没有滑步、浮空、关节超限等问题,从候选里挑出质量较好的动作。随后用 Infinigen 生成室内场景,把动作和目标家具放进去,检查是否发生不该有的碰撞,最后从机器人头部视角渲染出画面。这样一来,同一种技能就能在不同家具布局和外观条件下反复出现。动作生成器学习画面、语言与轨迹的对应,跟踪器则在物理仿真中学习执行;两种学习任务分开,问题也好分别排查:到底是看错了场景,还是身体没跟上计划。
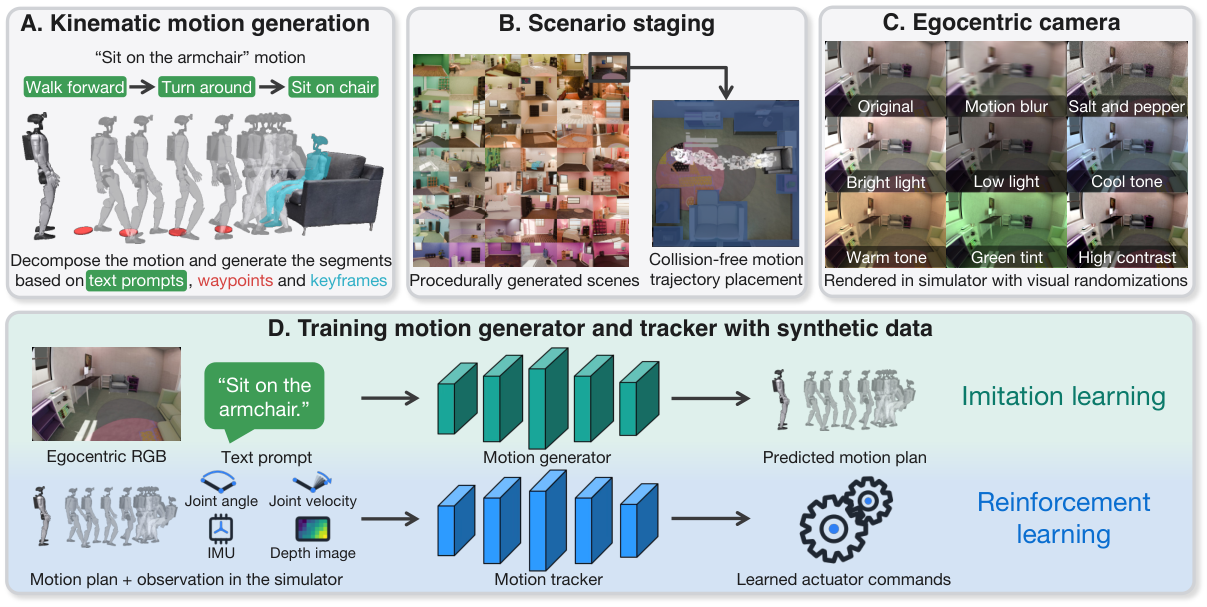
论文用了 1000 个程序生成的室内场景,训练片段合计约 300 小时,共约 16.3 万段。但“仿真生成”并非全程无人参与:部分关键姿态来自真人手机视频,推箱动作使用动捕素材,新任务也需要人工设计。更准确的说法是,它减少了逐条遥操作采集的负担,人的动作示范和任务定义仍然保留在链条里。
这一思路真正改变的,是扩充数据的方式。研究者可以批量改变房间、家具位置和画面条件,让同一技能接受更多样的变化;前提仍是这些变化覆盖了现实中的关键难点——模拟房间造得再多,最终还得回到真实环境里检验。
05
91%的成功率应该怎样读,开放代码之后还有什么门槛
先看真实世界的单项任务测试:六种技能、六个环境,每种技能在每个环境尝试十次,合计 360 次,平均成功率 91%。这些环境没有参与训练,也没有预先扫描或建图。
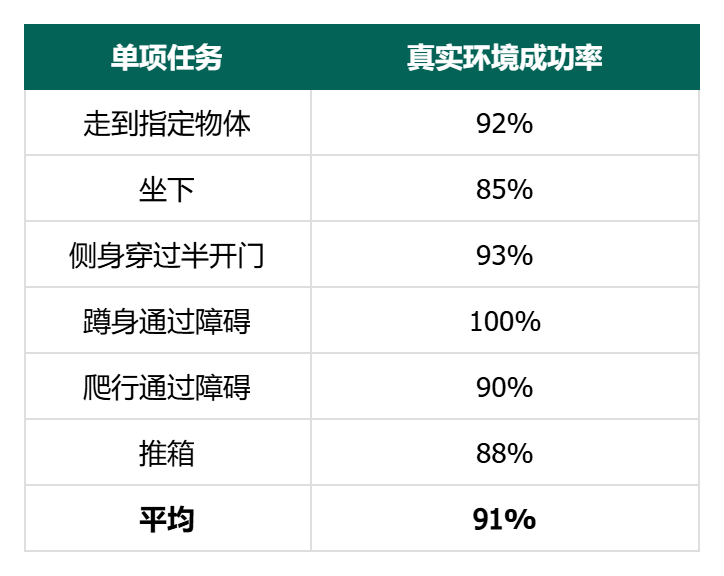
这组测试说明,仿真中学到的视觉与动作关系,能够迁移到没见过的真实场所。但要判断机器人能不能做家务,还要看这些技能串起来是否可靠。
论文另测了三组连续任务,在一个真实环境中各做十次,平均成功率 70%。失败往往出在动作衔接处:钻过桌子之后,下一个目标不在视野里,后续任务就接不上了。
一次任务完成时的朝向、站位和视野,会变成下一次任务的起点。独立测试里能做好的动作,接在另一个动作后面,难度可能已经变了。往后看 HALO 的进展,连续任务、陌生布局和失败恢复,比单独再展示一个漂亮动作更能说明问题。
截至 2026 年 11 月 15 日,官方仓库已公开数据生成、模型训练和部署代码,但没有随仓库放出训练好的动作生成器、跟踪器权重和完整数据集。当前公开的数据生成流程主要覆盖坐下任务,其余演示能力仍需要补齐数据、自行训练。
对研究者来说,公开流程和接口意味着可以检查问题、替换模块、验证自己的想法;但要复现整套演示,数据、算力和机器人调试的门槛仍然不低。Mac mini 上能够运行模型,不代表训练也是在这台小电脑上完成的。
HALO 留下的是一种值得继续检验的分工:通用模型处理语义,专门的动作模型安排身体运动,快速控制器应对执行中的变化,仿真负责扩大训练场景。真正考验这套系统的,是换一间房、换一种摆放,再把几个任务连续做完时,它还能有多稳定。
推荐阅读

×
右键可直接复制图片