 阅读时间大约10分钟(3843字)
2026-11-19 SuperMimic让训练更省算力,后续人形机器人动作跟踪该堆算力还是堆数据?
来源:具身智能研究室
通用动作跟踪的主要瓶颈仍在算力
作者:Yuanxq 出品:具身智能研究室
训练通用全身跟踪策略,各家在算力和数据上的账算得并不一样。 BeyondMimic 先训专家再蒸馏,英伟达的 SONIC 直接把大规模动作库和算力一起拉满,Humanoid-GPT 把多个动作专家蒸馏进同一个策略,最近的 SuperMimic 又用可微世界模型把训练压到了单卡几小时。当训练开销被不断打下来,回到最常用的并行仿真强化学习里,动捕数据到底需要多还是少?下一笔预算该用来扩充动作库,还是增加仿真训练量?
高通 AI 研究团队从改造 PPO 的优势估计入手提出 QTOP,并在 4、12、24 小时的动作数据上训练跟踪器,拟合不同预算下加数据与加算力的收益。在约 700 GPU 小时以内的大部分测试设置里,加倍训练算力比加倍动作数据更能降低跟踪误差。 放到宇树 G1 真机上,相同数据和算力预算下,QTOP 的关键身体点跟踪误差比标准 PPO 低约 8%。
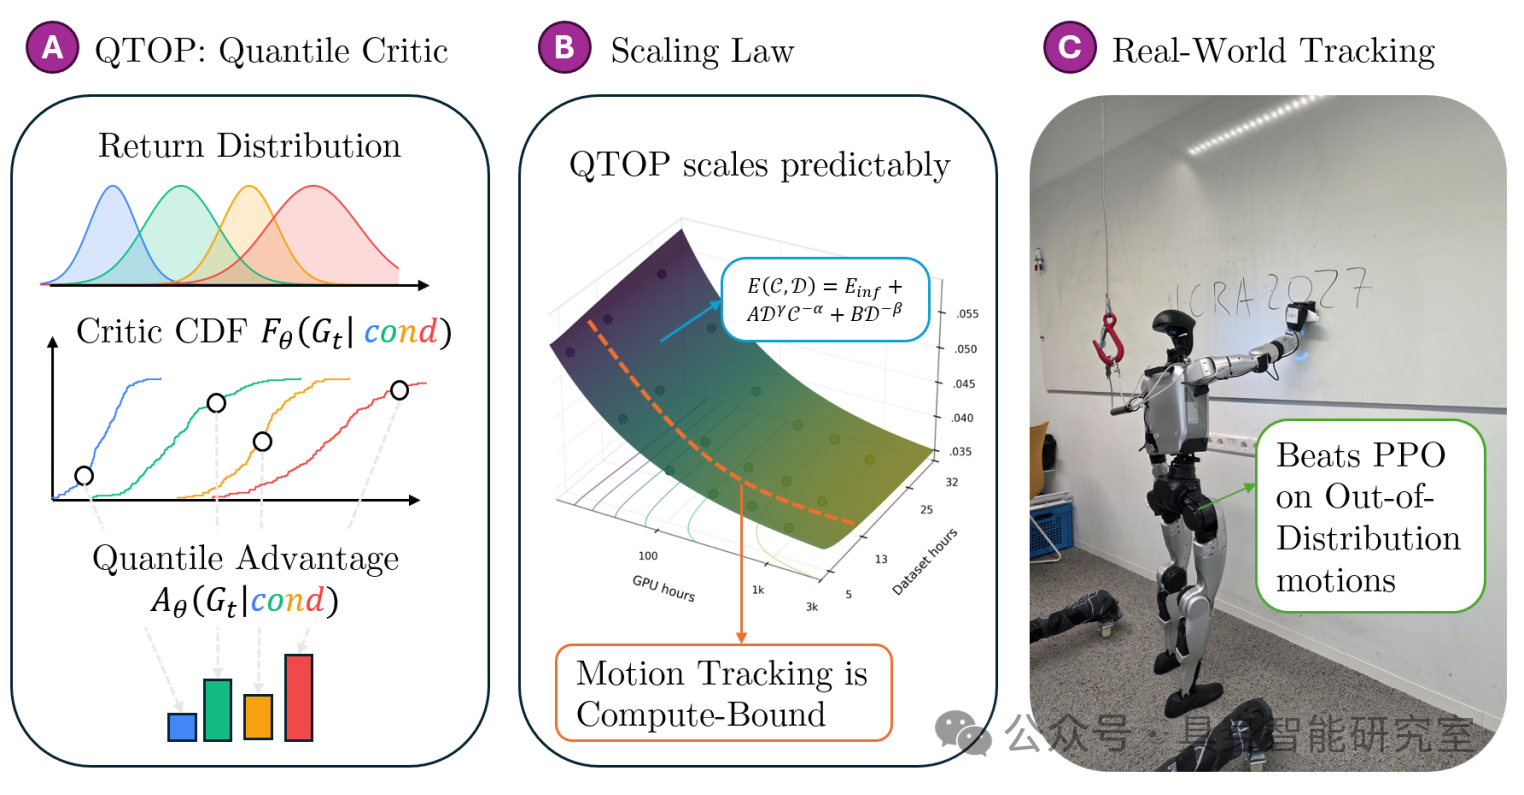
QTOP 用回报分布计算优势,再分别检验数据、算力和训练算法对动作跟踪的影响。
数据和算力分开测
人形动作跟踪的两类资源,其实用在不同地方。动捕数据决定策略有哪些参考动作可以学,GPU 小时决定策略在仿真里能练多久。 同一段动捕可以拿来训练很多轮。增加训练预算后,策略能在更多状态下反复跟踪这段参考,收集自己踩偏、失衡或没及时转身时的反馈。增加数据则给策略更多不同的参考动作,扩展它见过的速度、姿态和接触变化。
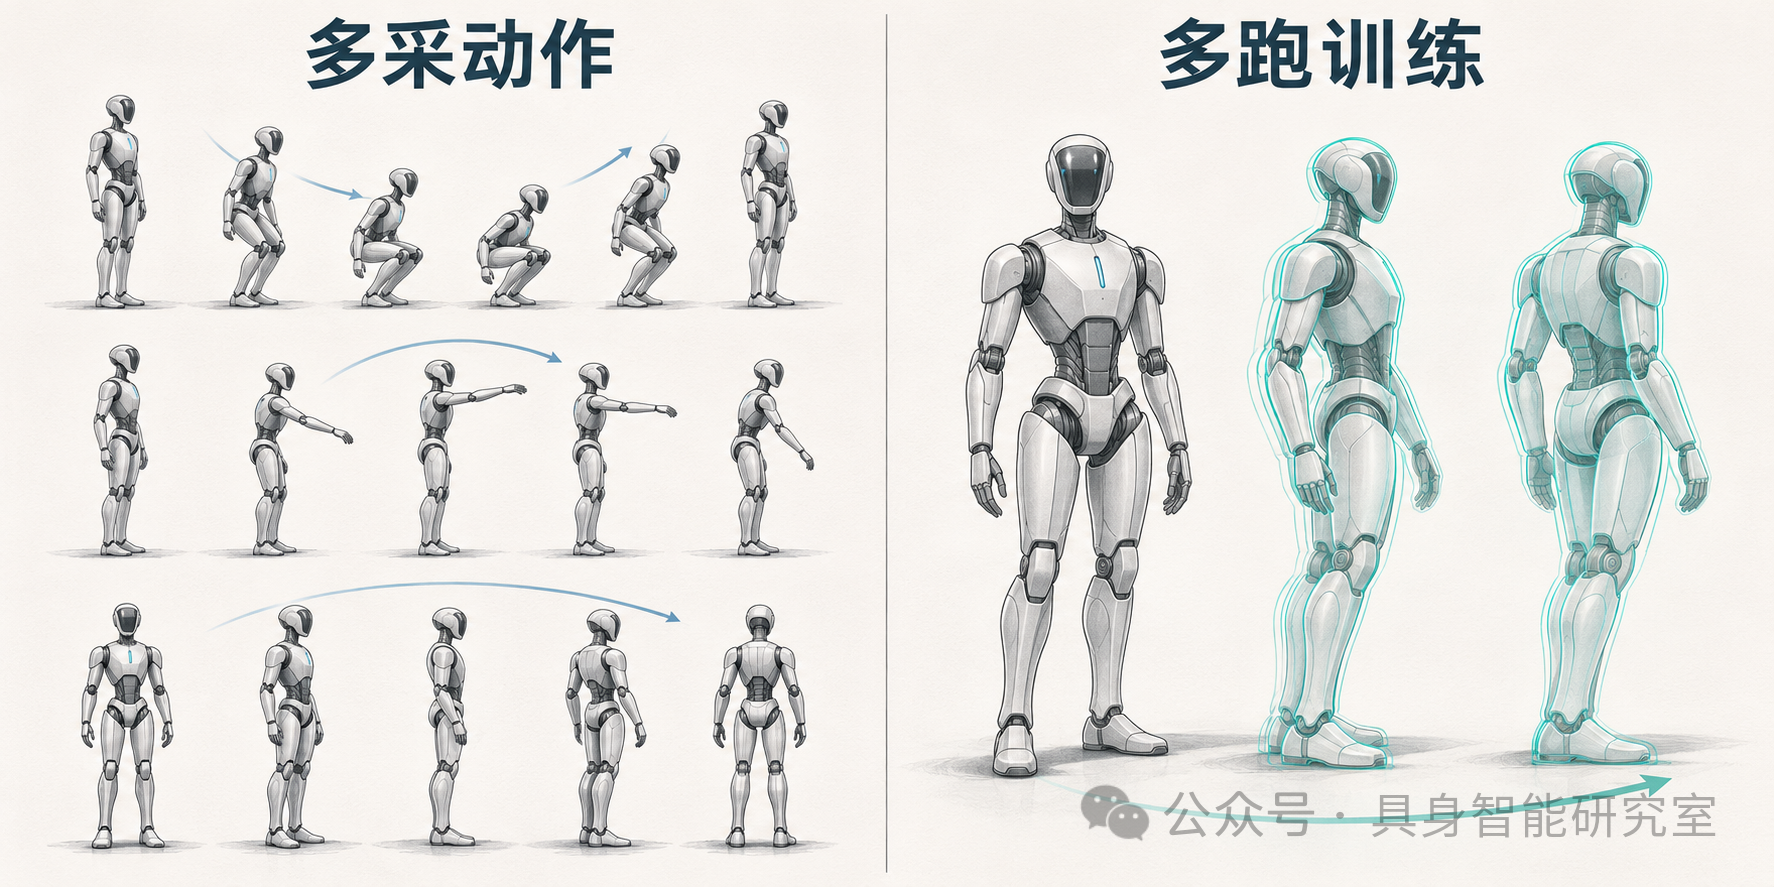
扩充动作库增加参考动作,增加算力则让策略在更多仿真状态中练习同一批动作。
高通固定网络架构和训练算法,才开始动这两个变量。训练数据来自 AMASS 和 LAFAN1,完整集合约 24 小时;4 小时和 12 小时两档则各自从全集中独立抽样三份不同子集,用来排除抽样偏差。每种规模跑三个随机种子,在不同 GPU 小时对应的检查点上,用同一套未参与训练的 MOSAIC 动作测误差。这样既能比较同一批数据多训一段时间的收益,也能比较同样训练时间换成更大数据集的结果。
把所有检查点排在一起,关键是看误差曲线在两个方向上各降多少。固定数据集,从较早的检查点走到较晚的检查点,看的是同一批参考动作还能学到多少。固定 GPU 小时,横向比较三档数据,看的是多见一些动作有没有帮助。两次比较都用训练时没见过的动作来检验,所以额外训练带来的改善,也必须能反映在新动作上。
这里用的核心指标 R-MPKPE,统计骨盆、躯干和四肢共 14 个关键刚体相对于躯干的位置误差,衡量身体各部位有没有跟到对应姿态。
作者用实测网格拟合出一张关于算力与数据量的误差曲面。拟合公式专门引入了数据与算力的交叉项:更多数据能压低理论误差下限,但在算力不足时,动作库越大,多动作混训带来的优化难度反而越高。 从同一个预算起点出发,分别比较数据时长加倍和训练 GPU 小时加倍,右侧热图的红色区域代表加算力比加数据更能降误差。
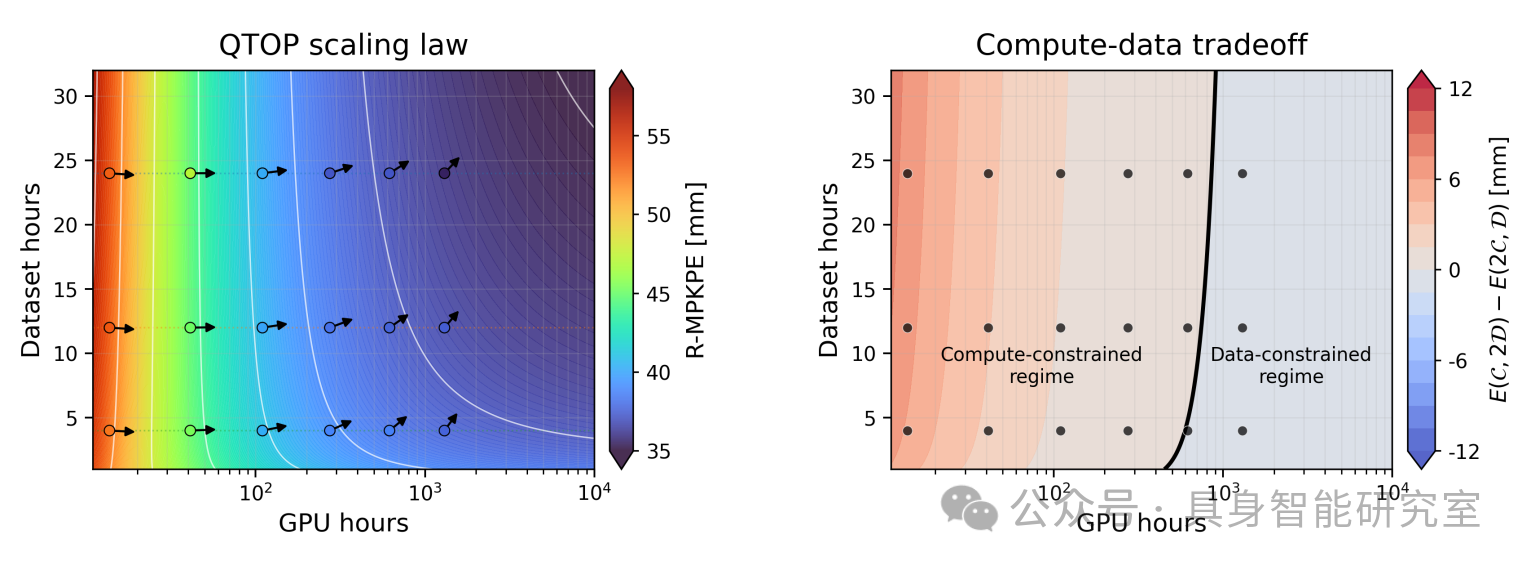
左侧是拟合出的跟踪误差曲面。右侧比较同一起点下,训练算力加倍与动作数据加倍的预测收益。
在论文测到的低到中等算力范围内,直到约 700 GPU 小时,大部分设置都落在加算力更有利的一边。作者还轮流拿掉一种数据规模,只用另外两种拟合,再去预测留出数据规模上的结果,平均绝对误差约 0.9 毫米。这说明拟合关系能在这三档数据之间做预测。整个研究最高测试到约 1300 GPU 小时,作者也指出,算力更充足时,更大数据集的收益仍可能增加。
把整个测试区间压成一个平均数,论文还报告了另一组比较。固定数据规模,看实测区间两端的误差变化,每加倍一次训练算力,误差平均少约 5.59%。固定训练算力,每加倍一次数据时长,误差平均少约 3.31%。这是沿两条不同预算曲线计算出来的平均降幅。前面的热图回答的是从某个起点继续增加哪一种资源,这两个数字回答的是各自走完整段预算区间,平均每翻一番能少多少误差。
作者也折算了 SONIC 已报告的数据作参照:SONIC 在约 2 万 GPU 小时预算下,把动作库从 22 小时扩到 556 小时,数据每翻一番误差仅降 0.53%;而在 2000 至 21000 GPU 小时区间每翻一番算力,误差能降 3.10%。两篇论文的误差定义和预算量级不同,不能直接横比高低,但各自实验内部都是算力收益明显大于数据收益。
这也引出了下一个问题:为什么区区 4 到 24 小时的动作库,几百 GPU 小时都还没训透?根源在于多动作混训时的内部优化损耗——QTOP 正是从 PPO 里负责生成训练信号的 Critic 下手。
把回报放回分布
动作跟踪看起来用的是同一套奖励:机器人跟上参考里的身体位置和朝向,奖励就更高。但直走和一边抬腿一边转身,对控制器提出的要求并不一样;参考动作切换后,机器人会遇到新的支撑脚、关节速度和身体姿态,不同动作能拿到的回报尺度差异很大。
QTOP 沿用了 BeyondMimic 的跟踪设置:29 自由度宇树 G1 控制器以 50 Hz 运行,单回合 500 步(10 秒)。策略只输入当前帧的参考关节位置与速度、躯干朝向误差、本体状态和上一步动作,不拼接未来参考帧,从而避免引入额外的部署延迟。由于看不到后续参考轨迹,即便当前观测相似,后面接上的也可能是完全不同的动作走向与接触状态。
在标准 PPO 中,广义优势估计(GAE)把 Critic 压成一个标量均值,用标量残差驱动更新。高通在同一个模型参数快照上分别计算各段动作的梯度余弦相似度:Actor 的跨动作梯度基本集中在 0 附近,而 Critic 的梯度相似度区间直接散开到 -0.5 至 +0.5。把一段动作的价值估准,往往会把另一段动作的价值改偏;失真的价值残差又会反过来干扰 Actor 更新。
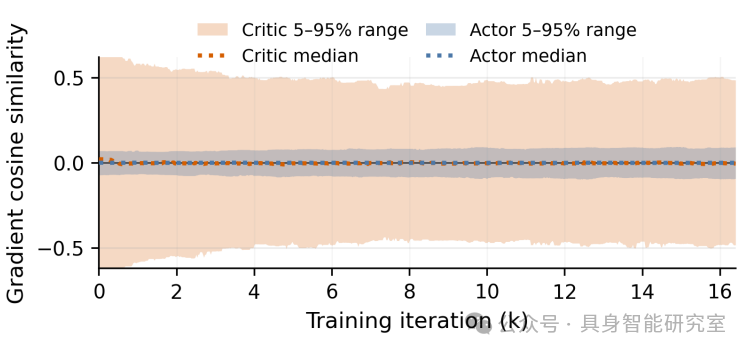
在同一组模型参数下,分别计算各段动作的梯度。Critic 的跨动作梯度差异更大,负相关的一侧也更明显。
QTOP 直接从训练信号的生成方式入手,让 Critic 在一组固定支撑点上输出概率,预测当前观测与参考指令下的局部回报分布。轨迹还没结束时,先用这个分布的数学期望替 PPO 估出剩余回报;等到更新策略时,再通过相邻支撑点线性插值,查出这段回报落在预测分布的哪个分位(0 到 1 之间),并线性映射到 -1 到 1 之间的分位数优势——高于中位数为正,低于中位数为负。同一个 Critic 由此兼顾了标量价值基线,同时把跨动作尺度悬殊的回报残差收束成有界的相对排名。
比如,两次执行都拿到 70 分。对普通直走,70 分可能只在第 20 百分位,这次完成得比预计的差。对复杂转身,70 分可能在第 80 百分位,这次反而做得好。同一个绝对回报,在两个动作对应的分布里可以有相反的训练含义。 分位数优势把这个相对位置带进更新。
论文的做法是先用 GAE 预热 500 次迭代,然后把标准化后的 GAE 优势和分位数优势各取一半。组合后的优势按整批轨迹归一化,再送进原来的 PPO 裁剪目标。实验采用 Muon 优化器。QTOP 改的是训练时怎样评价一段轨迹、怎样给策略更新分配信号。上机时,动作仍由训练好的策略生成。
作者还固定同一个策略和一批来自 32 种动作的轨迹,只替换优势估计方法。跨检查点平均,QTOP 让各动作优势幅值的变异系数下降 68%,Actor 梯度范数的变异系数下降 39%。这两个数字描述的是不同动作对更新的贡献变得更均衡。后面的跟踪误差,才用来检验这种变化能否带来更准的动作。
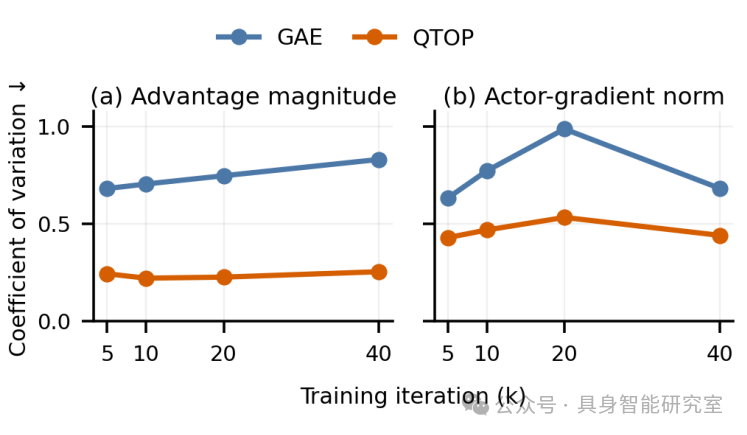
相同轨迹、相同策略检查点,只切换优势估计方法。橙线对应 QTOP。
同预算下怎么比
为了分清是 Muon、分布 Critic 还是分位数优势在起作用,论文在 mjlab 中做了逐项拆解。各方法统一采用约 1150 万参数的 4 层 MLP,固定 200 GPU 小时预算(约合单机 8 张 A100 训练 24 小时)。对照从标准 PPO(Adam)出发,依次换用 Muon 优化器、引入分布 Critic 但仍按均值算 GAE,最后再加入分位数优势;异策略的 SAC 和 FastTD3 也给了同样算力。团队还尝试过绕开 Critic 的多任务算法 MT-GRPO,但它必须跑完 500 步完整回合才能估计回报,计算开销难以承受。
仿真把两类数据留作测试。一组是约 3.1 小时的 MOSAIC 光学动捕,重定向到 G1 后的动作质量相对一致。另一组来自团队自行采集的惯性动捕,动作包括下蹲、跳跃、做饭等。每个策略在 8192 个并行环境里跟踪随机抽取的参考动作。这样既能看收益是否只出现在某一种动捕来源,也能把某几段动作恰好容易跟的影响压低。
以未见过的 MOSAIC 光学动捕为例,按相对躯干的身体关键点误差算,PPO(Adam)是 41.96 毫米,只换 Muon 是 41.70 毫米。用分布 Critic、继续按均值计算 GAE 后,降到 39.53 毫米。加入分位数优势,进一步降到 38.12 毫米。自采惯性动捕也有同样的走势,标准 PPO 的 43.59 毫米降到完整 QTOP 的 37.70 毫米。这组逐项对照把优化器的收益和改优势估计的收益分开了。
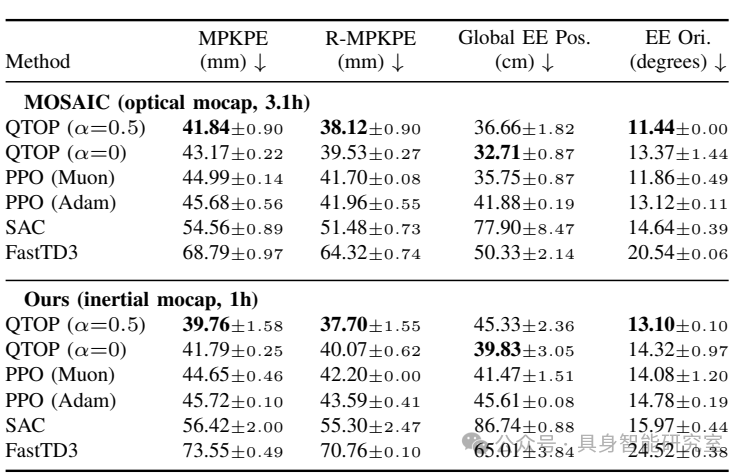
仿真结果包括关键身体点、末端位置和末端朝向误差。各列均为越低越好。
表里还有一个细节。完整 QTOP 在两组数据上的关键点误差和末端朝向误差都最低,全局末端位置误差最低的是只用分布 Critic 均值计算 GAE 的版本。例如,在 MOSAIC 上,完整方法的全局末端位置误差是 36.66 厘米,只用均值的版本是 32.71 厘米。策略的输入是参考指令与本体观测,手脚在世界坐标系下的偏移又会随时间积累。看跟踪表现时,局部姿态和全局位置要分别看。
异策略算法在这类任务上差距明显。SAC 用接近 PPO 的超参数就能启动,但很早进入平台期;FastTD3 本身也带分布 Critic,作者专门调用基于 GPT-5.5 的编程 Agent 跑了 100 轮训练,允许它自动搜超参甚至修改代码实现,最终 R-MPKPE 仍停在 64.32 毫米(QTOP 为 38.12 毫米)。面对长达 500 步、参考指令每步都在切换的连续跟踪,异策略强化学习依然很难训好。
G1 真机跟得更准
高通在宇树 G1 上部署了 PPO 和 QTOP。两个策略都用 24 小时动作数据和约 1000 GPU 小时训练,再用外部工作站以 50 Hz 推理。真机评估用了 32 段未见过的动作,包括不同风格的走路、货架补货、擦白板、打台球和做饭。每段长 5 至 15 秒,从第一帧的参考姿态开始,两种方法各跟踪三次,比较实际姿态和指令之间的误差。
在这组测试中,QTOP 的真机 R-MPKPE 从 PPO 的 37.2 毫米降到 34.2 毫米(低约 8%),所有受驱动关节的平均绝对误差也从 0.0872 弧度降到 0.0814 弧度。
这两个真机指标各自回答一个问题。关键点误差统计训练奖励里选定的身体部位,例如躯干、手臂和腿上的代表性位置。关节误差则覆盖所有受驱动关节,直接比较机器人实际关节角度和参考角度。两项都变小,说明身体部位跟得更准,整体关节动作也有改善。再往前一步,要判断擦白板、补货等任务在不同位置上能完成多少次,还需要专门统计任务结果。
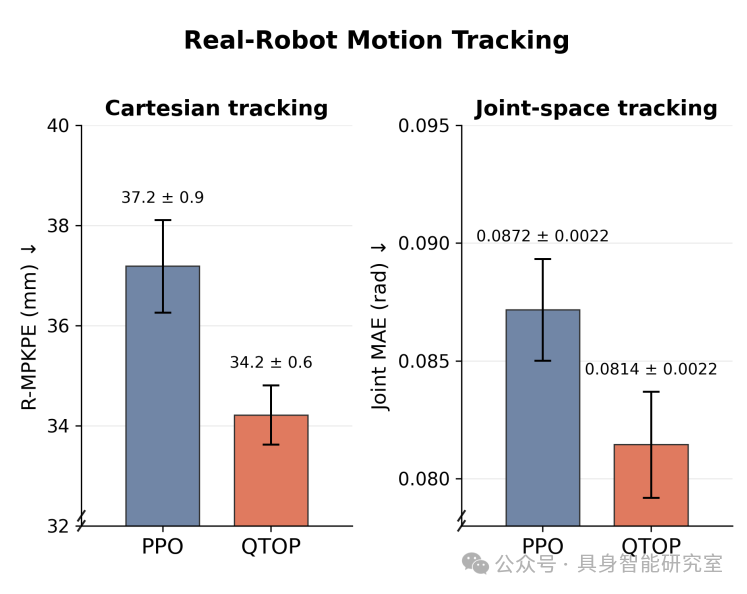
在相同训练数据和算力下,对比两种策略在宇树 G1 上的关键身体点位置误差与关节误差。
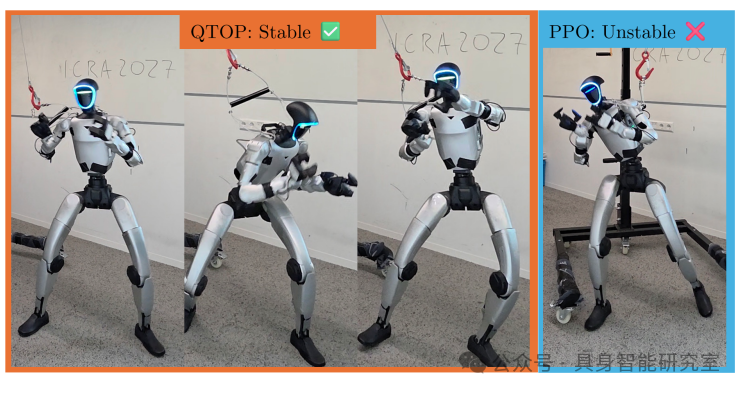
论文还对比了两段分布外真机演示。做武术出拳闪避这类上身高速运动时,PPO 版的 G1 需要多迈几步维持平衡,站位逐渐漂移,QTOP 则能稳在原位跟完动作;擦白板时两者外观差别没那么显眼,但 QTOP 的手部末端落点更准。对于移动操作,手能不能准确定位到接触面,比整段动作看起来顺不顺更直接决定接触成败。
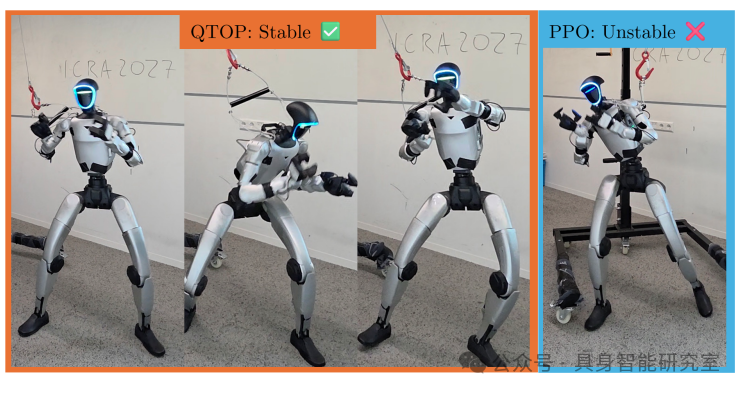
分布外动作的真机示例。PPO 在快动作中多次迈步维持平衡,QTOP 更贴近参考。
回到开头的问题。在 4 至 24 小时动捕数据、千卡时以内的常规训练规模下,通用动作跟踪的主要瓶颈仍在算力:多动作混训的内部冲突还没消化完,单纯扩充动作库收益有限。先把算力用来训透手头的数据,再用 QTOP 这类分布优势方法压低跨动作干扰,同样一笔预算还能在真机上再往前推一步。
推荐阅读

×
右键可直接复制图片