
只看RGB够吗?VLA如何获得真正的3D空间能力
作者:毛不毛 出品:具身智能前沿导读视觉语言动作模型(VLA)继承了多模态大模型强大的开放词表理解能力,但在真实物理世界中,仅...
Nature Machine Intelligence | 从高空摔下来还能继续跑:这款三杆张拉整体机器人重新定义了“抗摔”
这可能是第一个真正实现"抗冲击+自主移动”闭环的张拉整体机器人。
Science Robotics | 别再只谈AI了:人形机器人的未来,归根结底由机械硬件决定
AI只是被硬件物理约束的软件, 人形机器人的未来是由机械硬件决定的。
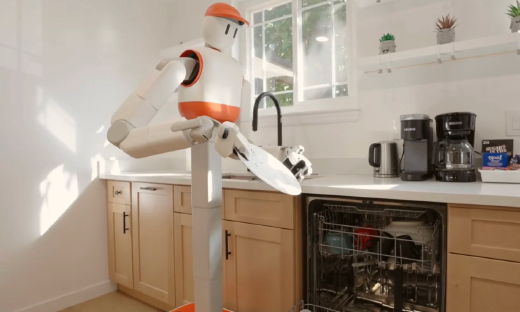
从Sunday Robotics ACT-2预览看家用机器人:双足是"工程税负",还是必经之路?
Sunday没有追逐双足浪潮,而是先解决家庭机器人最核心的问题:把家务做好
从π0.5到星海图G0.5,VLA 为什么又回到了自回归动作路线?
作者:Yuanxq 出品:具身智能研究室让机器人打开抽屉、拿出一袋核桃、倒进空气炸锅,再把抽屉推回去。视频里看起来像一件连贯的...
牛津、NUS提出下一代世界模型方向:心智世界模型来了
出品:机器之心想象这样一个场景:一个杯子被A放进柜子里,B没有看到。问:B下一步会去哪里找杯子?如果世界模型只知道物理事实,预测错B的下一步决策:「杯子现在在柜...
VLA 模型太多了?从 OpenVLA 到 π0.7,一篇看懂 VLA
作者:毛不毛 出品:具身智能前沿导读VLA把图像、语言和机器人状态变成动作,但不同模型并不采用同一种结构:有的让改造后的VLM...
右键可直接复制图片